Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Migrowanie obciążeń z klasycznego środowiska obliczeniowego do bezserwerowych obliczeń. Bezserwerowe obliczenia obsługują automatyczne aprowizowanie, skalowanie, uaktualnienia środowiska uruchomieniowego i optymalizację.
Większość klasycznych obciążeń może migrować z minimalnymi zmianami lub bez zmian w kodzie. Na przykład obciążenia, które wykorzystują df.cache() i df.persist() głównie migrują bez zmian kodu. Ta strona koncentruje się na tych obciążeniach. Niektóre obciążenia zależne od notebooków R lub Scala wymagają klasycznego przetwarzania i nie mogą przejść na serwerless. Aby uzyskać pełną listę bieżących ograniczeń, zobacz Ograniczenia obliczeniowe bezserwerowe.
Migracja za pomocą Genie Migrate for Serverless
Ważna
Ta funkcja jest dostępna w wersji beta. Administratorzy przestrzeni roboczej mogą włączyć ją ze strony Podglądów , wybierając podgląd Agenta Obliczeniowego . Zobacz Zarządzanie wersjami zapoznawczami usługi Azure Databricks.
Genie Migrate for Serverless to agent, który migruje pojedynczy notatnik lub zadanie do obliczeń bezserwerowych. Agent przegląda środowisko obciążenia, biblioteki, konfiguracje Sparka, tagi i kod, a następnie proponuje każdą zmianę jako indywidualną sugestię, którą możesz zaakceptować lub odrzucić. Akceptowane zmiany są wprowadzane i można je cofnąć.
Użyj Genie Code do interaktywnej migracji notatnika lub zadania lub użyj Databricks CLI do migracji zadań w tle, w tym wielu zadań ze skryptu. Zobacz Migrowanie zadań za pomocą Databricks CLI.
Co agent sprawdza i zmienia
| Area | Co robi agent |
|---|---|
| Środowisko i biblioteki | Tłumaczy instalacje bibliotek do specyfikacji środowiska bezserwerowego, w tym instalacje %pip, skrypty inicjalizacyjne klastra, biblioteki klastrów używane w zadaniach oraz odwołania do prywatnego indeksu pakietów. |
| Zmienne środowiskowe | Tłumaczy zmienne środowiskowe klastra na ich odpowiedniki bezserwerowe, zachowując odwołania do sekretów przestrzeni roboczej i pomijając wartości zarządzane przez platformę. |
| Dostęp do danych i pamięci masowej | Przepisuje ścieżki niezgodne z trybem serverless, takie jak dysk lokalny, dbfs:/ i ścieżki montowania, na woluminy Unity Catalog. Agent automatycznie stosuje jednoznaczne poprawki i prosi o wybór woluminu, gdy cel jest niejednoznaczny. |
| Konfiguracje platformy Spark | Klasyfikuje każdą konfigurację Spark, zakomentowuje konfiguracje, które można bezpiecznie usunąć, oraz oznacza i usuwa konfiguracje, których środowisko bezserwerowe nie obsługuje. Obejmuje zarówno konfiguracje dołączone do klastra, jak i konfiguracje w notesie. |
| Kod obciążenia | Przepisuje kod, którego serwerless nie obsługuje, na kompatybilne odpowiedniki, na przykład operacje RDD przepisywane na operacje DataFrame, oraz dostosowuje kod pod zachowanie SQL w trybie ANSI na serwerless. |
| Tagi | Tłumaczy niestandardowe tagi klastrów, takie jak tag centrum kosztów, na ich bezserwerowe odpowiedniki. |
| Tryb wydajności | Sugeruje tryb wydajności w zależności od konfiguracji klastra. Zobacz Wybieranie trybu wydajności. |
Requirements
Zalecany jest dostęp administratora przestrzeni roboczej, aby zapewnić pełną migrację. Dzieje się tak, ponieważ agent analizuje także globalne skrypty inicjalizacyjne na poziomie przestrzeni roboczej, oprócz docelowego obciążenia. Migracja może być możliwa, jeśli masz uprawnienia
CAN MANAGEdo obciążenia roboczego, ale bez uprawnień administratora może to skutkować brakiem bibliotek, ustawień środowiska lub tagów.Potwierdź, że masz dostęp do agenta. Wpisz
/computew Genie Code./computePowinno pojawić się w menu Autouzupełniania. Jeśli się nie pojawi, administrator obszaru roboczego musi włączyć podgląd w Twoim obszarze roboczym.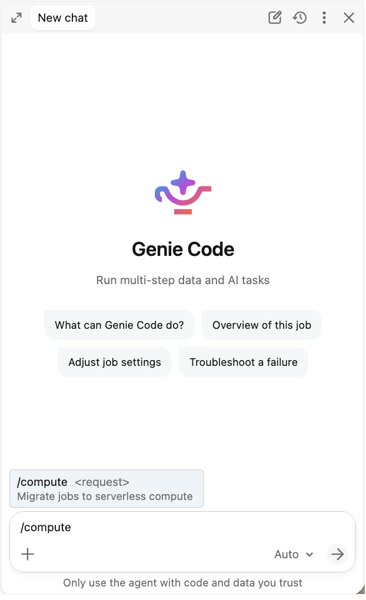
Migracja notatnika
- Otwórz notatnik, który chcesz przenieść.
- Otwórz Genie Code i uruchom
/compute migrate to serverlessz palety/poleceń. - Przejrzyj ustalenia agenta. Agent skanuje środowisko, biblioteki i kod notatnika, proponując zmianę dla każdego elementu, który jej wymaga, na przykład przeniesienie instalacji biblioteki do specyfikacji środowiska lub przepisanie komórki kodu, aby działała bez serwera.
- Akceptuj lub odrzucaj każdą proponowaną zmianę.
- Zastosuj zmiany, które zaakceptowałeś. Są zapisywane bezpośrednio w notatniku.
- Podłącz notebook do serwerless i uruchom go, aby potwierdzić, że zachowuje się zgodnie z oczekiwaniami. Zobacz Weryfikacja migrowanego obciążenia.
Migrowanie zadania
- Otwórz stanowisko, które chcesz przenieść.
- Otwórz Genie Code i uruchom
/compute migrate to serverlessz palety/poleceń. - Agent klonuje Twoje zadanie i próbuje zmigrować sklonowane zadanie do środowiska bezserwerowego.
- Przejrzyj ustalenia agenta. W przypadku zadania wielozadaniowego agent wyszczególnia każde zadanie oraz przypisaną do niego konfigurację klastra, a następnie proponuje zmiany dla każdego z nich, jednocześnie zachowując harmonogram zadania.
- Zaakceptuj lub odrzuć każdą proponowaną zmianę na powierzchni migracji: środowisko i biblioteki, konfiguracje Spark oraz wszelki kod obciążenia, który musi się zmienić.
- Zastosuj zmiany, które zaakceptowałeś. Zasoby obliczeniowe zadania zostały przełączone na tryb bezserwerowy.
- Uruchom zadanie w trybie bezserwerowym i potwierdź wyniki. Zobacz Weryfikacja migrowanego obciążenia.
- Opcjonalnie, jako ostatni krok, agent promuje migrowanego klona. Kopiuje konfigurację klona i notatniki z powrotem na twoje oryginalne zadanie (zachowując ten sam identyfikator zadania, harmonogram i uprawnienia), a następnie usuwa klona. Jeśli pominiesz promowanie, twoje pierwotne zadanie zachowuje swój harmonogram i działa na klasycznych zasobach obliczeniowych. Klon nie ma harmonogramu ani wyzwalaczy, więc działa tylko wtedy, gdy go uruchomisz.
Migruj zadania za pomocą Databricks CLI
Użyj compute-migrations grupy poleceń w Databricks CLI, aby uruchomić Genie Migrate for Serverless na zadaniu w tle, bez otwartej sesji Genie Code. Możesz rozpocząć migracje wielu zadań za pomocą skryptu i przejrzeć każde z nich, gdy będzie gotowe.
Ścieżka Databricks CLI spełnia następujące wymagania:
- Administrator przestrzeni roboczej włączył podgląd Agenta Compute. Bez niej każde
compute-migrationspolecenie kończy się błędem .PERMISSION_DENIED - Databricks CLI w wersji 1.24.0 lub nowszej. Zobacz Instalowanie lub aktualizowanie interfejsu wiersza poleceń Databricks.
-
CAN MANAGEuprawnienie dla każdego zadania, które migrujesz.
Agent tworzy kopię zapasową zadania, a następnie tworzy bezserwerową kopię roboczą. Kopia robocza to nowe zadanie o nazwie [Serverless Migration - <timestamp>] <job name>, które uruchamia kopie notatników i plików zadania. Nie ma harmonogramu ani wyzwalaczy, więc uruchamia się tylko podczas uruchamiania lub gdy Azure Databricks uruchamia go w celu weryfikacji. Twoje pierwotne zadanie nie zostanie zmienione, dopóki nie zatwierdzisz migracji.
Ostrzeżenie
Uruchomienie walidacji nie jest izolowane. Kopia robocza zadania działa na tych samych tabelach, woluminach, punktach kontrolnych i systemach zewnętrznych co oryginalne zadanie. Jeśli zadanie zapisuje do tabel produkcyjnych, wysyła powiadomienia, wywołuje zewnętrzne API lub przesuwa punkty kontrolne streamingu, uruchomienie walidacyjne również to robi. Ustaw run_validation tylko dla zadań, gdzie jedno dodatkowe uruchomienie jest bezpieczne. Nie możesz zmienić tego ustawienia po utworzeniu migracji.
Nie edytuj oryginalnego zadania ani kopii roboczej podczas migracji. Zatwierdzenie migracji zastępuje ustawienia i pliki oryginalnego zadania ustawieniami i plikami kopii roboczej.
Rozpocznij migrację dla zadania:
databricks compute-migrations create -o json --request-id "<uuid>" --json '{
  "asset_type": "JOB",
  "asset_uri": "jobs/<job-id>",
  "auto_approve": false,
  "run_validation": false
}'
Odpowiedź zawiera identyfikator migracji. Użyj nowego
request-iddla każdego zadania i ponownie go wykorzystaj, jeśli spróbujesz ponownie po upływie limitu czasu, aby nie tworzyć duplikatu migracji. Nie możesz zmienićauto_approvemigracji anirun_validationpo jej utworzeniu.Sprawdź stan migracji za pomocą
databricks compute-migrations get <migration-id> -o json. Planowanie i tworzenie kopii roboczej zwykle zajmuje kilka minut. Aby sprawdzić wiele migracji, użyjlist, a następnie potwierdź każdą za pomocągetprzed podjęciem działania.Gdy migracja osiągnie
TRANSLATION_READY, przejrzyj kopię roboczą.migration_report.primary_asset.idto identyfikator zadania kopii roboczej. Porównaj jego ustawienia i kod z oryginalnym zadaniem, a następnie uruchomapprove-migration-translationlubreject-migration-translationz najnowszymgetzadaniem--etag.Jeśli ustawisz
run_validation, Azure Databricks uruchamia kopię roboczą raz i zapisuje wynik wvalidation_report. Migracja przechodzi do tegoMIGRATION_REVIEW, czy uruchomienie się powiedzie, czy nie, więc sprawdźvalidation_report.passedprzed zatwierdzeniem.Gdy migracja osiągnie
MIGRATION_REVIEW, przejrzyj kopię roboczą i wynik walidacji, a następnie uruchomapprove-migration-executionlubreject-migration-executionz z--etagtwojej najnowszejget. Zatwierdzanie stosuje ustawienia i pliki kopii roboczej do oryginalnego zadania, zachowując jego identyfikator zadania, harmonogram i uprawnienia.Gdy migracja osiągnie
MIGRATION_COMPLETE, oryginalne zadanie zostanie zmienione. Zweryfikuj to od razu. Zobacz Zweryfikuj zmigrowane obciążenie.Po weryfikacji oryginalnego zadania usuń zadanie kopii roboczej.
migration_report.secondary_assetsWyświetla notatniki, które uruchamia kopia robocza. Usuń je dopiero po potwierdzeniu, że oryginalne zadanie nie odwołuje się do nich.
Każde polecenie odrzucenia wymaga podania powodu odrzucenia, który przekazujesz po identyfikatorze migracji. Na przykład:
databricks compute-migrations reject-migration-translation <migration-id> "Keep the existing output table names." --etag <etag>
Podaj konkretny powód. Agent poprawia wersję roboczą i zwraca ją do recenzji. Jeśli odrzucasz migrację wielokrotnie, zakończy się ona niepowodzeniem.
Poniższa tabela przedstawia polecenia compute-migrations :
| Command | Description |
|---|---|
create |
Rozpoczyna migrację dla zadania. Kończy się niepowodzeniem z ALREADY_EXISTS, jeśli zadanie ma trwającą migrację lub migrację, która już zakończyła się sukcesem. |
get, list |
Zwraca stan, raporty oraz etag jednej migracji lub wszystkich migracji. |
approve-migration-translation, reject-migration-translation |
Zatwierdza lub odrzuca kopię roboczą w stanie TRANSLATION_READY . Ustawienie auto_approve przy tworzeniu pomija tę recenzję. |
approve-migration-execution, reject-migration-execution |
Zatwierdza lub odrzuca migrację w stanie MIGRATION_REVIEW . Zatwierdzenie zmienia pierwotne zadanie. |
cancel-migration |
Zatrzymuje migrację. Anulowanie nie cofa zmian już zastosowanych do oryginalnego zadania ani skutków ubocznych uruchomienia walidacji. |
delete |
Usuwa rekord migracji. Nie cofa zmian ani nie usuwa roboczej kopii ani kopii zapasowej. Migracja, która zakończyła się niepowodzeniem lub została anulowana, już zwalnia zadanie, więc nie musisz go usuwać przed rozpoczęciem nowej migracji. |
Przekaż --etag z najnowszego get przy każdym poleceniu zatwierdzenia, odrzucenia lub anulowania. Jeśli migracja zmieniła się od momentu jej odczytania, polecenie kończy się niepowodzeniem z ABORTED zamiast działać na stanie, którego nie przejrzałeś. Jeśli agent nie może przenieść zadania, migracja przenosi się do NOT_SUPPORTED lub FAILED, i wyjaśnia state_history dlaczego.
Zweryfikuj migrowane obciążenie
Agent proponuje i wprowadza zmiany, ale nie weryfikuje wyników Twojego obciążenia roboczego. Uruchomienie walidacyjne z Databricks CLI sprawdza tylko to, czy uruchomienie zakończyło się sukcesem. Zawsze uruchamiaj zmigrowane obciążenie w środowisku bezserwerowym i potwierdź wyniki, zanim zaczniesz na nim polegać, zwłaszcza w przypadku obciążeń zapisujących dane do tabel produkcyjnych. Jeśli agent zaproponuje zmianę, która wydaje się nieodpowiednia, odrzuć ją i prześlij nam opinię, abyśmy mogli ulepszyć agenta. Zobacz Przesyłanie opinii o produkcie.
Wskazówka
Podczas walidacji przeniesionego obciążenia uruchamiaj je w trybie optymalizacji wydajności. Uruchamia się szybciej niż w trybie standardowym, więc otrzymujesz szybsze informacje zwrotne po potwierdzeniu wyników. Przełącz się na tryb, który najlepiej pasuje do obciążenia, zanim uruchomisz go w produkcji. Zobacz Wybieranie trybu wydajności.
Gdy agent znajdzie coś, czego nie może bezpiecznie przenieść, zgłasza blokadę i domyślnie się zatrzymuje. Możesz jawnie nakazać, aby pominął niektóre blokady zgodności lub zależności, ale wiąże się to z ryzykiem, że te zależności, przypisanie kosztów lub zachowanie w czasie działania nie zostaną zachowane, a obciążenie robocze może zawieść w środowisku bezserwerowym.
Cofnij zmiany migracji
Zmiany wprowadzane przez agenta są odwracalne.
W przypadku notatnika otwórz go i przywróć wersję z czasów tuż przed migracją. Zobacz Historia wersji w notesach usługi Databricks.
Dla zadania, jeśli nie promowałeś migrowanego klona w Genie Code ani nie zatwierdziłeś migracji za pomocą Databricks CLI, Twoje pierwotne zadanie nigdy nie zostało zmienione. Uruchom go jak wcześniej i usuń klon lub kopię roboczą. W przeciwnym razie przywróć kopię zapasową utworzoną przez agenta przed jakąkolwiek zmianą:
- Otwórz folder kopii zapasowej:
/Workspace/Users/<username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Kopia zapasowa znajduje się w folderze głównym użytkownika, który przeprowadził migrację, co dla Databricks CLI oznacza użytkownika, który ją utworzył. W Genie Code agent pokazuje tę ścieżkę również podczas migracji. Jeśli jest kilka znaczników czasu, wybierz ten z tuż przed migracją. - Otwórz
job.yaml, który przechowuje ustawienia zadania sprzed migracji, i zastosuj te ustawienia ponownie do tego samego zadania za pomocą żądaniaPOST /api/2.2/jobs/reset, które nadpisuje ustawienia zadania tymi, które podasz. Możesz też wkleić je do definicji JSON zadania w interfejsie użytkownika. To przywraca zadanie do klasycznego środowiska obliczeniowego. - Otwórz
mapping.yaml, która wymienia każdy plik zarchiwizowany oraz oryginalną ścieżkę, z której pochodzi. Skopiuj każdy plik kopii zapasowej z powrotem do jego oryginalnej lokalizacji, aby cofnąć zmiany w kodzie. - Uruchom zadanie, aby potwierdzić, że zachowuje się tak, jak się zachowywało przed migracją.
Migracja nigdy nie usuwa tej kopii zapasowej. Zadania, których agent nie zmodyfikował, takie jak zadania pochodzące z repozytorium Git, SQL lub dbt, są rejestrowane w job.yaml, ale ich pliki nie są kopiowane do kopii zapasowej, więc w razie potrzeby przywróć je ze źródła referencyjnego.
Znane ograniczenia
- Za blokujące uznaje się: niestandardowe obrazy, warianty ML Runtime, wersje Databricks Runtime wcześniejsze niż 13, konfiguracje Spark, których nie można bezpiecznie ignorować w środowisku bezserwerowym, oraz zależności, takie jak pakiety egg, pliki JAR i biblioteki Maven. Bloker oznacza, że agent zatrzymuje się zamiast migrować ten element. Możesz albo samodzielnie rozwiązać ten problem i ponownie uruchomić migrację, albo polecić agentowi, aby mimo to przeprowadził migrację, co pozostawi ten element nierozwiązany i może spowodować niepowodzenie działania obciążenia w środowisku bezserwerowym.
- Agent odczytuje skrypty inicjalizacyjne przechowywane w plikach obszaru roboczego lub woluminach usługi Unity Catalog. Skrypty init przechowywane w ABFSS lub DBFS nie mogą być odczytywane i są zgłaszane jako blokery.
- Agent nie sprawdza wszystkich klasycznych atrybutów obliczeniowych. Dostarczanie logów klastra i klucze SSH nie są uwzględniane w modelu, a chociaż system wykrywa w kodzie zadań wiele zależności związanych z punktami montowania DBFS, nie identyfikuje ani nie rozpoznaje wszystkich takich punktów montowania.
- Interfejsy API pamięci podręcznej i punktów kontrolnych, globalne widoki tymczasowe, wywołania do zarządzania punktami montowania DBFS oraz kod w języku Scala lub R są domyślnie bezwzględnymi blokadami. Możesz polecić agentowi, aby kontynuował, ale nienaprawiona funkcjonalność pozostanie bez zmian i może nie działać w środowisku serverless.
- Zlecenia z ponad 10 zadaniami podlegającymi migracji nie mogą być migrowane.
- Agent w Genie Code migruje jedno obciążenie na raz. Aby migrować wiele zadań, utwórz jedną migrację na każde zadanie za pomocą Databricks CLI. Nie ma procesu odkrywania ani zatwierdzania przez administratora na poziomie całej floty.
- Dzięki Databricks CLI agent migruje tylko zadania. Zadanie, które ma zadanie notebooka lub zadanie Python pochodzące ze zdalnego repozytorium Git, nie może zostać zmigrowane.
- Agent proponuje zmiany i stosuje te, które akceptujesz, ale nie weryfikuje poprawności wyników. Zweryfikuj zmigrowane obciążenie robocze przed użyciem go do obsługi danych produkcyjnych.
- Jeśli źródłem referencyjnym Twojego obciążenia roboczego jest pakiet Databricks Asset Bundle lub folder Git, agent wprowadza zmiany bezpośrednio w obiekcie obszaru roboczego. Zsynchronizuj te zmiany z pakietem lub repozytorium, aby kolejne wdrożenie nie nadpisało migracji.
Ręczna migracja do środowiska bezserwerowego
Aby przeprowadzić migrację obciążeń z klasycznego środowiska obliczeniowego do obliczeń bezserwerowych, wykonaj następujące kroki:
- Sprawdź wymagania wstępne: Zweryfikuj, czy Twoje środowisko robocze, sieć i dostęp do pamięci masowej w chmurze spełniają wymagania. Zobacz Wymagania wstępne.
- Aktualizuj kod: Wprowadź wszelkie niezbędne zmiany w kodzie i konfiguracji. Zobacz Aktualizowanie kodu.
- Testuj swoje obciążenia: Zweryfikuj kompatybilność i poprawność przed przełączeniem. Zobacz Testowanie obciążeń.
- Wybierz tryb wydajności: Wybierz tryb wydajności, który najlepiej odpowiada Twoim wymaganiom obciążenia. Zobacz Wybieranie trybu wydajności.
- Migracja etapami: wdrażaj architekturę serverless stopniowo, zaczynając od nowych i niskoryzykownych obciążeń. Zobacz Migrowanie w fazach.
- Monitoruj koszty: Śledź zużycie DBU bezserwerowego i konfiguruj alerty. Zobacz Monitorowanie kosztów.
Prerequisites
Przed rozpoczęciem migracji może być konieczne zaktualizowanie niektórych starszych konfiguracji w obszarze roboczym.
| wymagania wstępne | Action | Szczegóły |
|---|---|---|
| Obszar roboczy jest włączony dla Unity Catalog | Migrowanie z magazynu metadanych Hive w razie potrzeby | Uaktualnij przestrzeń roboczą Azure Databricks do Unity Catalog |
| Skonfigurowano sieć | Zastąp komunikację równorzędną VPC kartami sieciowymi, Private Link lub regułami zapory | Sieć bezserwerowej płaszczyzny obliczeniowej |
| Dostęp do magazynu w chmurze | Zastąp przestarzałe wzorce dostępu do danych zewnętrznymi lokalizacjami Unity Catalog | Połącz się z chmurową pamięcią obiektową za pomocą Unity Catalog |
Upewnij się, że obszar roboczy znajduje się w obsługiwanym regionie.
Aktualizowanie kodu
W poniższych sekcjach wymieniono zmiany kodu i konfiguracji wymagane do wprowadzenia obciążeń zgodnych z bezserwerowymi.
Dostęp do danych
Starsze wzorce dostępu do danych nie są obsługiwane w przypadku bezserwerowych. Zaktualizuj kod, aby zamiast tego używać Unity Catalog.
| Wzorzec klasyczny | Wymiana bezserwerowa | Szczegóły |
|---|---|---|
Ścieżki systemu plików DBFS (dbfs:/...) |
Woluminy katalogu Unity | Czym są woluminy Unity Catalog? |
| Tabele magazynu metadanych Hive | Tabele katalogu Unity (lub Federacja HMS) | Uaktualnij przestrzeń roboczą Azure Databricks do Unity Catalog |
| Poświadczenia konta magazynowego | Lokalizacje zewnętrzne katalogu Unity | Połącz się z chmurową pamięcią obiektową za pomocą Unity Catalog |
| Niestandardowe pliki JAR JDBC | Federacja Lakehouse | Czym jest federacja zapytań? |
Ostrzeżenie
Dostęp do systemu plików DBFS jest ograniczony w przypadku środowisk bezserwerowych. Przed migracją zaktualizuj wszystkie dbfs:/ ścieżki do woluminów Unity Catalog. Aby uzyskać więcej informacji, zobacz Migrowanie plików przechowywanych w systemie plików DBFS.
Przykład: Zamień ścieżki DBFS i odwołania do Hive Metastore
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
Interfejsy API i kod
Niektóre interfejsy API i wzorce kodu nie są obsługiwane w środowiskach bezserwerowych. Zapoznaj się z tą tabelą, aby sprawdzić, czy kod musi zostać zaktualizowany.
| Wzorzec klasyczny | Wymiana bezserwerowa | Szczegóły |
|---|---|---|
API RDD (interfejsy) (sc.parallelize, rdd.map) |
Interfejsy API ramki danych | Porównaj Spark Connect ze Spark Classic |
spark.sparkContext, sqlContext |
Bezpośrednio użyj spark (SparkSession) |
Porównaj Spark Connect ze Spark Classic |
Zmienne Hive (${var}) |
SQL DECLARE VARIABLE lub Python f-strings |
DECLARE VARIABLE |
| Nieobsługiwane konfiguracje platformy Spark | Usuń nieobsługiwane konfiguracje. Serwery bezserwerowe automatycznie dostrajają większość ustawień. | Konfiguracja właściwości Spark dla notebooków i zadań bezserwerowych |
Przykład: Zamień operacje RDD na DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Przykład: Zamień interfejsy API SparkContext
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
Różnice w zachowaniu SQL
Obliczenia bezserwerowe domyślnie włączają tryb ANSI. Databricks Runtime domyślnie włącza tryb ANSI w wersji 17.0 i wyższej. Jeśli klasyczne środowisko obliczeniowe działa we wcześniejszej wersji, niektóre zapytania, które tam się udają, powodują błędy podczas działania na serverless.
Genie Migrate for Serverless automatycznie dostosowuje kod do zachowania w trybie ANSI. Jeśli migrujesz ręcznie, przejrzyj następujące operacje, które najczęściej zmieniają zachowanie:
| Działanie | Klasyczne obliczenia z wyłączonym trybem ANSI | Bezserwerowe obliczenia |
|---|---|---|
Nieprawidłowe rzutowanie, takie jak CAST('abc' AS INT) |
Zwraca NULL |
Zgłasza CAST_INVALID_INPUT |
| Przepełnienie arytmetyczne liczb całkowitych | Owija się dookoła. Na przykład 2147483647 + 1 zwraca wartość -2147483648. |
Zgłasza ARITHMETIC_OVERFLOW |
| Przepełnienie arytmetyki dziesiętnej | Zwraca NULL |
Zgłasza NUMERIC_VALUE_OUT_OF_RANGE |
| Dzielenie według zera | Zwraca NULL |
Zgłasza DIVIDE_BY_ZERO |
| Zdeformowany adres URL w parse_url | Zwraca NULL |
Podwyżki INVALID_URL |
Aby zwrócić NULL zamiast wywołać błąd, zastąp operację jej try_* odpowiednikiem, takie jak try_cast, try_add, try_divide lub try_parse_url. Databricks zaleca takie podejście zamiast wyłączania trybu ANSI, ponieważ tryb ANSI ujawnia problemy z jakością danych, które ukrywa ciche NULL.
Aby wyłączyć tryb ANSI dla castów, arytmetyki i parsowania, ustaw spark.sql.ansi.enabled na false. Obliczenia bezserwerowe stosują reguły ANSI do niejawnych rzutowań podczas wstawiania do tabel niezależnie od tego ustawienia, ponieważ nie można zmienić spark.sql.storeAssignmentPolicy w obliczeniach bezserwerowych. Pełny opis zachowania ANSI można znaleźć w artykule o zgodności z ANSI w Databricks Runtime.
Biblioteki i środowiska
Można zarządzać bibliotekami oraz środowiskami na poziomie obszaru roboczego, używając środowisk podstawowych, oraz na poziomie notesu, korzystając z środowiska bezserwerowego.
| Wzorzec klasyczny | Wymiana bezserwerowa | Szczegóły |
|---|---|---|
| Skrypty inicjalizacyjne | Środowiska bezserwerowe | Konfiguracja środowiska bezserwerowego |
| Biblioteki o zakresie klastra | Biblioteki o zakresie notesu lub środowiskowe | Konfiguracja środowiska bezserwerowego |
| Biblioteki Maven/JAR | Obsługa zadań JAR; PyPI dla notatników | Zadanie JAR dla jobów |
| Kontenery Docker | Środowiska bezserwerowe dla potrzeb biblioteki | Konfiguracja środowiska bezserwerowego |
Przypinanie pakietów Python w requirements.txt dla powtarzalnych środowisk. Zobacz Określanie wersji pakietów w Pythonie.
Streaming
Obciążenia pracy związane z przesyłaniem strumieniowym są obsługiwane w architekturze bezserwerowej, ale niektóre wyzwalacze nie są dostępne. Zaktualizuj kod, aby używał obsługiwanych wyzwalaczy.
| Wyzwalacz Spark | Wsparte | Notatki |
|---|---|---|
Trigger.AvailableNow() |
Yes | Zalecane |
Trigger.Once() |
Yes | Jest to przestarzałe. Użyj Trigger.AvailableNow() zamiast tego. |
Trigger.ProcessingTime(interval) |
Nie. | Zwraca INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
Nie. | Zamiast tego używaj trybu ciągłego w potokach Lakeflow |
Wartość domyślna (nie jest ustawieniem .trigger()) |
Nie. | Pominięcie .trigger() powoduje domyślne ustawienie na ProcessingTime("0 seconds"), która nie jest obsługiwana w środowisku bezserwerowym. Zawsze ustawiaj .trigger(availableNow=True) jawnie. |
W przypadku ciągłego przesyłania strumieniowego należy przeprowadzić migrację do potoków deklaratywnych platformy Spark w trybie ciągłym lub używać zadań harmonogramu ciągłego z programem AvailableNow. W przypadku dużych źródeł ustaw maxFilesPerTrigger lub maxBytesPerTrigger, aby zapobiec błędom braku pamięci.
Przykład: Naprawa wyzwalaczy strumieniowania
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Testowanie obciążeń
- Szybki test kompatybilności: Uruchom obciążenie na klasycznym komputerze z trybem dostępu Standard i Databricks Runtime 14.3 lub nowszym. Jeśli przebieg zakończy się pomyślnie, obciążenie może zostać przeniesione do środowiska bezserwerowego bez żadnych zmian w kodzie.
- Porównanie A/B (zalecane w środowisku produkcyjnym): Uruchamiaj to samo obciążenie w środowisku klasycznym (kontrola) i serverless (eksperyment). Porównaj tabele wyjściowe i zweryfikuj poprawność. Iteruj do momentu dopasowania danych wyjściowych.
- Tymczasowe konfiguracje: Możesz tymczasowo ustawić obsługiwane konfiguracje Spark podczas testów. Usuń je, gdy będą stabilne.
Wybieranie trybu wydajności
Przetwarzanie bezserwerowe i przepływy obsługują dwa tryby wydajności: standardowy i zoptymalizowany pod kątem wydajności. Wybrany tryb wydajności zależy od wymagań dotyczących obciążenia.
| Tryb | dostępność | Firma startupowa | Najlepsze dla |
|---|---|---|---|
| Standard | Zadania, potoki Lakeflow | Zazwyczaj 4-6 minut | Partia wrażliwa na koszty |
| Zoptymalizowane pod kątem wydajności | Zadania, potoki Lakeflow | Zazwyczaj mniej niż minutę | Interakcyjne, wrażliwe na opóźnienia |
Tryb standardowy zużywa mniej DBU niż tryb zoptymalizowany pod względem wydajności, więc kosztuje mniej. Aby porównać tryby i ustawić tryb dla migrowanego zadania lub potoku, zobacz Wybór trybu wydajności dla zadań serwerowych i potoków.
Migrowanie w fazach
- Nowe obciążenia: Uruchamiaj wszystkie nowe notebooki i zadania w trybie serverless.
- Obciążenia niskiego ryzyka: Migruj obciążenia PySpark/SQL już w trybie standardowego dostępu oraz Databricks Runtime 14.3 lub nowszym.
- Złożone obciążenia: Migruj obciążenia wymagające zmian w kodzie (przepisania RDD, aktualizacje DBFS, poprawki wyzwalaczy).
- Pozostałe obciążenia: Przeglądaj okresowo w miarę rozszerzania się możliwości.
Monitorowanie kosztów
Rozliczenia bezserwerowe są oparte na użyciu jednostek DBU, a nie na czasie działania klastra. Przed migracją na dużą skalę zweryfikuj oczekiwania dotyczące kosztów z reprezentatywnymi obciążeniami. Aby zapoznać się z narzędziami i strategiami monitorowania kosztów bezserwerowych, zobacz Monitorowanie kosztów obliczeń bezserwerowych.
Dodatkowe zasoby
- Najlepsze praktyki dla obliczeń bezserwerowych: wskazówki dotyczące optymalizacji obciążeń bezserwerowych
- Ograniczenia obliczeń bezserwerowych: pełna lista obecnych ograniczeń i nieobsługiwanych funkcji
- Konfiguruj środowisko bezserwerowe: Zarządzaj bibliotekami i zależnościami
- Obsługiwane konfiguracje Spark: konfiguracje Spark dostępne w środowisku bezserwerowym
- Spark Connect kontra klasyczny Spark: Różnice behawioralne w architekturze serverless
-
Buforuj ramki danych na bezserwerowych zasobach obliczeniowych: Buforuj ramki danych za pomocą
df.cache()idf.persist() - Bezpieczeństwo sieci bezserwerowej: NCC, Private Link i konfiguracja zapory sieciowej
- Informacje o wersjach bezserwerowego przetwarzania: Śledź nowe możliwości w momencie ich wprowadzania
- Przewodnik aktualizacji katalogu Unity: migracja z Hive Metastore do Unity Catalog
Więcej informacji można również znaleźć w następujących wpisach w blogu:
- Czym jest przetwarzanie bezserwerowe?: Przegląd możliwości bezserwerowych i wyniki klientów
- Ewolucja inżynierii danych: Jak obliczenia serverless przekształcają notebooki i zadania Lakeflow: Jak serverless napędza Lakeflow Jobs i Pipelines