Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Możesz korzystać z programowego dostępu do plików obszarów roboczych przechowywanych w usłudze Azure Databricks. Umożliwia to wykonywanie zadań, takich jak:
- Przechowywanie małych plików danych wraz z notesami i kodem.
- Zapisywanie plików dziennika w katalogach zsynchronizowanych z usługą Git.
- Importowanie modułów przy użyciu ścieżek względnych.
- Tworzenie lub modyfikowanie pliku specyfikacji środowiska.
- Zapisywanie danych wyjściowych z notesów.
- Zapisywanie danych wyjściowych z egzekucji bibliotek, takich jak Tensorboard.
Możesz programowo tworzyć, edytować, zmieniać nazwy i usuwać pliki obszarów roboczych w środowisku Databricks Runtime 11.3 LTS i nowszych wersjach. Ta funkcja jest obsługiwana w przypadku notatników w środowisku Databricks Runtime 16.2 i nowszym oraz w środowisku bezserwerowym 2 i nowszym.
Notatka
Aby wyłączyć zapisywanie do plików obszaru roboczego, ustaw zmienną środowiskową klastra WSFS_ENABLE_WRITE_SUPPORT=false. Aby uzyskać więcej informacji, zobacz Zmienne środowiskowe.
Notatka
W Databricks Runtime 14.0 i wyższych domyślny aktualny katalog roboczy (CWD) dla kodu wykonywanego lokalnie to katalog zawierający notatnik lub skrypt uruchamiany. Jest to zmiana zachowania w wersji Databricks Runtime 13.3 LTS i wcześniejszych. Zobacz Jaki jest domyślny katalog roboczy?.
W środowisku bezserwerowym nie ma gwarancji dostępności katalogu roboczego, więc do wskazywania plików używaj ścieżek bezwzględnych. Zobacz Ograniczenia obliczeń bezserwerowych.
Odczytywanie lokalizacji plików
Użyj poleceń powłoki, aby odczytać lokalizacje plików, na przykład w repozytorium lub w lokalnym systemie plików.
Aby określić lokalizację plików, wprowadź następujące informacje:
%sh ls
-
Pliki nie są w repozytorium: Polecenie zwraca system
/databricks/driverplików . -
Pliki znajdują się w repozytorium: Polecenie zwraca zwirtualizowane repozytorium, takie jak
/Workspace/Repos/name@domain.com/public_repo_2/repos_file_system.
Odczytywanie plików obszaru roboczego danych
Można programowo odczytywać małe pliki danych, takie jak pliki .csv lub .json z kodu w notesach. W poniższym przykładzie użyto biblioteki Pandas do wykonywania zapytań dotyczących plików przechowywanych w katalogu /data względem katalogu głównego repozytorium projektu:
import pandas as pd
df = pd.read_csv("./data/winequality-red.csv")
df
Za pomocą platformy Spark można odczytywać pliki danych. Musisz podać Spark pełną ścieżkę dostępu.
- Pliki obszarów roboczych w folderach Git używają ścieżki
file:/Workspace/Repos/<user-folder>/<repo-name>/path/to/file. - Pliki obszarów roboczych w katalogu osobistym korzystają z ścieżki:
file:/Workspace/Users/<user-folder>/path/to/file.
Możesz skopiować ścieżkę bezwzględną lub względną do pliku z menu rozwijanego obok pliku:
rozwijane menu pliku 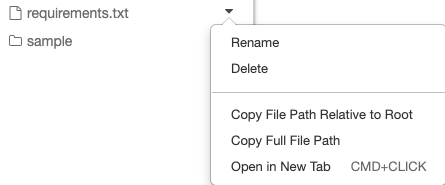
W poniższym przykładzie pokazano użycie {os.getcwd()} w celu uzyskania pełnej ścieżki.
import os
spark.read.format("csv").load(f"file:{os.getcwd()}/my_data.csv")
Notatka
W obszarach roboczych, w których jest wyłączony katalog główny i instalacja systemu plików DBFS, można również użyć dbfs:/Workspace do uzyskiwania dostępu do plików obszaru roboczego za pomocą narzędzi usługi Databricks. Wymaga to środowiska Databricks Runtime 13.3 LTS lub nowszego. Zobacz Wyłączanie dostępu do katalogu głównego systemu plików DBFS i instalacji w istniejącym obszarze roboczym usługi Azure Databricks.
Aby dowiedzieć się więcej o plikach w usłudze Azure Databricks, zobacz Praca z plikami w usłudze Azure Databricks.
Programowe tworzenie, aktualizowanie i usuwanie plików i katalogów
Możesz programowo manipulować plikami obszarów roboczych w usłudze Azure Databricks, podobnie jak w przypadku pracy z plikami w dowolnym standardowym systemie plików.
Notatka
W Databricks Runtime 16.2 lub nowszym oraz w środowisku bezserwerowym 2 i nowszym wszystkie programowe interakcje z plikami są również dostępne dla notebooków. Aby uzyskać informacje na temat konwertowania pliku na notes, zobacz Konwertowanie pliku na notes.
Notatka
Katalog nadrzędny pliku musi już istnieć, zanim do niego zaczniesz pisać. Azure Databricks buforuje operacje zapisu plików i asynchronicznie zapisuje je w obszarze roboczym, więc zapis do ścieżki, której katalog nadrzędny nie istnieje, kończy się błędem AsyncFlushFailedException po wywołaniu operacji zapisu, a nie w chwili jej wykonania. Najpierw utworz katalog nadrzędny, jak pokazano w poniższym przykładzie.
W poniższych przykładach używane są standardowe pakiety i funkcje języka Python do tworzenia plików i katalogów oraz manipulowania nimi.
import os

# Create a new directory

os.mkdir('dir1')

# Create a new file and write to it

with open('dir1/new_file.txt', "w") as f:
    f.write("new content")

# Append to a file

with open('dir1/new_file.txt', "a") as f:
    f.write(" continued")

# Delete a file

os.remove('dir1/new_file.txt')

# Delete a directory

os.rmdir('dir1')
import shutil

# Copy a dashboard

shutil.copy("my-dashboard.lvdash.json", "my-dashboard-copy.lvdash.json")

# Move a query to a shared folder

shutil.move("test-query.dbquery","shared-queries/")
Rozwiąż problem zduplikowanych nazw zasobów
W niektórych przypadkach folder workspace może już zawierać zasoby o tej samej nazwie. Na przykład dwa zapytania SQL mogą obie nazywać się My query. Może się to zdarzyć, gdy zasoby zostały utworzone przed pełnym egzekwowaniem unikalności nazwy.
Gdy folder zawiera zduplikowane nazwy zasobów, oparty na plikach dostęp do folderu zawodzi, choć same zasoby pozostają niezmienione. Mogą wystąpić błędy, takie jak:
-
Name not unique on network(OSError: [Errno 76])—na przykład gdy uruchamiaszlslub inne polecenia w terminalu webowym albo wyświetlasz zawartość folderu z notatnika. -
File name conflictlubRESOURCE_CONFLICT: Duplicate entities detected in the directory— na przykład podczas operacji z folderami Git.
Notatka
Duplikaty nazw nie wpływają na same zasoby. Wciąż możesz otwierać i używać każdego zasobu z przeglądarki obszaru roboczego. Dotknięte są tylko operacje, które docierają do folderu przez system plików — takie jak terminal internetowy, WSFS czy operacje na folderze Git.
Aby znaleźć zasoby z duplikatami nazw, uruchom następujący notes. Skanuje folder i jego podfoldery oraz wyświetla zasoby o tej samej nazwie. Notatnik jest tylko do odczytu i nie zmienia nazw ani nie usuwa żadnych zasobów.
Znajdź zduplikowane zasoby przestrzeni roboczej
Aby rozwiązać duplikaty nazw za pomocą interfejsu workspace:
- W przeglądarce workspace otwórz każdy folder wskazany w notesie.
- Przemianuj lub usuwaj zduplikowane zasoby, aż każdy asset w folderze będzie miał unikalną nazwę.
Po zapewnieniu, że wszystkie nazwy zasobów w folderze są unikalne, dostęp oparty na plikach ponownie działa.