Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Tabele cech mogą być udostępniane na dwa sposoby:
- Udostępnianie modelu: Wdroż model wytrenowany na tabelach cech. Ten sam punkt końcowy jest używany zarówno do wyszukiwania cech, jak i inferencji modelu. Punkt końcowy automatycznie wyszukuje lub oblicza wartości cech, wykorzystując pochodzenie śledzone podczas rejestrowania modelu. Ta funkcja służy do obsługi przewidywań modelu.
-
Udostępnianie cech: Wdróż
FeatureSpecodwołanie, które bezpośrednio odwołuje się do tabel cech, bez modelu. Punkt końcowy zwraca żądane wyniki funkcji. Użyj tej funkcji, gdy aplikacja potrzebuje wartości funkcji, a nie przewidywań modelu. Jeśli ostatecznie używasz funkcji do inferencji modelu, Databricks zaleca bezpośrednie serwowanie modelu.
Oba podejścia obsługują funkcje wstępnie obliczane oraz obliczane na żądanie.
Wymagania
- Databricks Runtime 14.2 ML lub nowszy.
- Aby korzystać z interfejsu API języka Python, Feature Serving wymaga
databricks-feature-engineeringwersji 0.1.2 lub nowszej, która jest wbudowana w środowisko uruchomieniowe Databricks Runtime 14.2 ML. W przypadku wcześniejszych wersji uczenia maszynowego środowiska Databricks Runtime ręcznie zainstaluj wymaganą wersję przy użyciu polecenia%pip install databricks-feature-engineering>=0.1.2. Jeśli używasz notatnika Databricks, musisz ponownie uruchomić jądro Python, uruchamiając to polecenie w nowej komórce:dbutils.library.restartPython(). - Aby korzystać z SDK Databricks, Feature Serving wymaga
databricks-sdkwersji 0.18.0 lub nowszej. Aby ręcznie zainstalować wymaganą wersję, użyj polecenia%pip install databricks-sdk>=0.18.0. Jeśli używasz notatnika Databricks, musisz ponownie uruchomić jądro Python, uruchamiając to polecenie w nowej komórce:dbutils.library.restartPython().
Funkcja usługi Databricks udostępnia interfejs użytkownika i kilka opcji programistycznych do tworzenia, aktualizowania, wykonywania zapytań i usuwania punktów końcowych. Ten artykuł zawiera instrukcje dotyczące każdej z następujących opcji:
- Interfejs użytkownika usługi Databricks
- interfejs API REST
- API Python
- Databricks SDK
Aby korzystać z interfejsu API REST lub zestawu MLflow Deployments SDK, musisz mieć token interfejsu API usługi Databricks.
Ważne
Najlepszym rozwiązaniem w zakresie zabezpieczeń w scenariuszach produkcyjnych usługa Databricks zaleca używanie tokenów OAuth maszyny do maszyny podczas uwierzytelniania w środowisku produkcyjnym.
W przypadku testowania i programowania, Databricks zaleca używanie osobistego tokenu dostępu należącego do głównych podmiotów usługi zamiast użytkowników obszaru roboczego. Aby utworzyć tokeny dla jednostek usługi, zobacz Zarządzanie tokenami dla jednostki usługi.
Uwierzytelnianie dla obsługi funkcji
Aby uzyskać informacje o uwierzytelnianiu, zobacz Autoryzuj dostęp do zasobów Azure Databricks.
Utwórz FeatureSpec
A FeatureSpec to zdefiniowany przez użytkownika zestaw cech i funkcji. Można łączyć cechy i funkcje w obiekcie FeatureSpec.
FeatureSpecs są przechowywane w Unity Catalog i zarządzane przez Unity Catalog oraz wyświetlane w Eksploratorze Katalogu.
Tabele określone w obiekcie FeatureSpec muszą być opublikowane w sklepie z funkcjami online lub w sklepie internetowym innej firmy. Zobacz Repozytoria funkcji online Databricks.
Należy użyć databricks-feature-engineering pakietu, aby utworzyć element FeatureSpec.
Najpierw zdefiniuj funkcję:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
Następnie możesz użyć funkcji w elemencie FeatureSpec:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Określanie wartości domyślnych
Aby określić wartości domyślne dla funkcji, użyj parametru default_values w pliku FeatureLookup. Zobacz następujący przykład:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Jeśli nazwy kolumn funkcji zostaną zmienione przy użyciu parametru rename_outputs , default_values należy użyć nazw funkcji o zmienionej nazwie.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Dodaj zależności w Python
Jeśli funkcja zdefiniowana przez użytkownika (UDF) importuje pakiety Python, zadeklaruj je podczas tworzenia .FeatureSpec Parametr extra_pip_requirements wymaga databricks-feature-engineering w wersji 0.17.0 lub nowszej. Feature Serving automatycznie instaluje pakiety MLflow i databricks-feature-lookup.
Na przykład, jeśli UDF w Twojej specyfikacji cech importuje NumPy, dodaj do specyfikacji taki wymóg:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Użyj main.default.customer_features_with_dependencies jako nazwy specyfikacji przy tworzeniu endpointu.
Każdy wpis w extra_pip_requirements musi być ciągiem wymagań PyPI, takim jak numpy==1.26.4, lub ścieżką do pliku .whl w woluminie Unity Catalog. Na przykład użyj /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl w przypadku koła, które zostało przesłane. Twórca punktów końcowych musi mieć READ VOLUME dane na woluminie oraz USE CATALOGUSE SCHEMA na swoim katalogu nadrzędnym i schemacie.
Dla pakietów z prywatnego repozytorium skonfiguruj domyślne repozytorium pakietów w przestrzeni roboczej. Nie umieszczaj opcji polecenia pip, na przykład --index-url, w extra_pip_requirements.
Zależności w klauzuli ENVIRONMENT funkcji UDF w katalogu Unity mają zastosowanie do wykonywania kodu SQL w trybie offline. Feature Serving nie kopiuje ich automatycznie. Zadeklaruj każdy pakiet wymagany przez funkcje UDF, w tym funkcje UDF w funkcjach nadrzędnych, w sekcji wymagań specyfikacji funkcji.
Jeśli wdrożenie punktu końcowego się nie powiedzie, sprawdź dzienniki kompilacji pod kątem błędów podczas instalacji pakietów, konfliktów wersji lub problemów z dostępem do pakietu wheel. Zobacz Monitorowanie jakości modelu i kondycji punktu końcowego.
Dla przykładu z CustomUDF i FeatureViewSource, zobacz funkcje Serve CustomUDF i ich zależności. Informacje o zależnościach dotyczących udostępniania modeli można znaleźć w sekcji Niestandardowe zależności funkcji UDF.
Tworzenie punktu końcowego
Element FeatureSpec definiuje punkt końcowy. Aby uzyskać więcej informacji, zobacz Utwórz punkty końcowe obsługujące niestandardowy model, dokumentację interfejsu API Python lub dokumentację zestawu SDK usługi Databricks.
Uwaga
W przypadku obciążeń, które są wrażliwe na opóźnienia lub wymagają dużej liczby zapytań na sekundę, usługa Model Serving oferuje optymalizację tras na niestandardowych punktach końcowych modelu, zobacz Optymalizacja tras na niestandardowych punktach końcowych.
Zestaw SDK usługi Databricks — Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
API Python
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
interfejs API REST
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Aby wyświetlić punkt końcowy, kliknij pozycję Serwowanie na lewym pasku bocznym interfejsu Databricks. Gdy stan jest gotowy, punkt końcowy jest gotowy do odpowiadania na zapytania. Aby dowiedzieć się więcej na temat obsługi modelu, zobacz Obsługa modelu.
Zapisz wzbogaconą ramkę danych w tabeli wnioskowania
W przypadku punktów końcowych utworzonych od lutego 2025 r. można skonfigurować model obsługujący punkt końcowy, aby rejestrować rozszerzoną ramkę danych zawierającą wyszukane wartości funkcji i zwracane wartości funkcji. Ramka danych jest zapisywana w tabeli wnioskowania dla obsługiwanego modelu.
Aby uzyskać instrukcje dotyczące ustawiania tej konfiguracji, zobacz Rejestrowanie funkcji wyszukiwania ramek danych w tabelach inferencyjnych.
Aby uzyskać informacje o tabelach inferencji, zobacz Rejestrowanie żądań i odpowiedzi dla punktów końcowych obsługujących modele (starsza wersja).
Uzyskiwanie punktu końcowego
Aby uzyskać metadane i stan punktu końcowego, możesz użyć zestawu SDK usługi Databricks lub interfejsu API Python.
Zestaw SDK usługi Databricks — Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
API Python
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Pobieranie schematu punktu końcowego
Aby uzyskać schemat punktu końcowego, możesz użyć zestawu SDK usługi Databricks lub interfejsu API REST. Aby uzyskać więcej informacji na temat schematu punktu końcowego, zobacz Pobieranie schematu punktu końcowego obsługującego model.
Zestaw SDK usługi Databricks — Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
interfejs API REST
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Wykonywanie zapytań względem punktu końcowego
Do wykonywania zapytań dotyczących punktu końcowego można użyć interfejsu API REST, zestawu SDK wdrożeń MLflow lub interfejsu użytkownika obsługującego.
Poniższy kod pokazuje, jak skonfigurować poświadczenia i utworzyć klienta podczas korzystania z zestawu MLflow Deployments SDK.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Uwaga
Zalecana praktyka bezpieczeństwa w przypadku uwierzytelniania za pomocą zautomatyzowanych narzędzi, systemów, skryptów i aplikacji to użycie osobistych tokenów dostępu należących do pryncypałów usługi zamiast użytkowników obszaru roboczego, co zaleca Databricks. Aby utworzyć tokeny dla jednostek usługi, zobacz Zarządzanie tokenami dla jednostki usługi.
Wykonywanie zapytań dotyczących punktu końcowego przy użyciu interfejsów API
Ta sekcja zawiera przykłady wykonywania zapytań dotyczących punktu końcowego przy użyciu interfejsu API REST lub zestawu SDK wdrożeń MLflow.
Zestaw SDK wdrożeń MLflow
Ważne
W poniższym przykładzie użyto predict() API z SDK wdrożeniowego MLflow. Ten interfejs API jest eksperymentalny , a definicja interfejsu API może ulec zmianie.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
interfejs API REST
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Wykonywanie zapytań dotyczących punktu końcowego przy użyciu interfejsu użytkownika
Możesz wykonać zapytanie dotyczące punktu końcowego obsługującego bezpośrednio z poziomu interfejsu użytkownika obsługującego. Interfejs użytkownika zawiera wygenerowane przykłady kodu, których można użyć do wykonywania zapytań dotyczących punktu końcowego.
Na lewym pasku bocznym obszaru roboczego Azure Databricks kliknij pozycję Serwowanie.
Kliknij punkt końcowy, który chcesz zapytać.
W prawym górnym rogu ekranu kliknij pozycję Punkt końcowy zapytania.
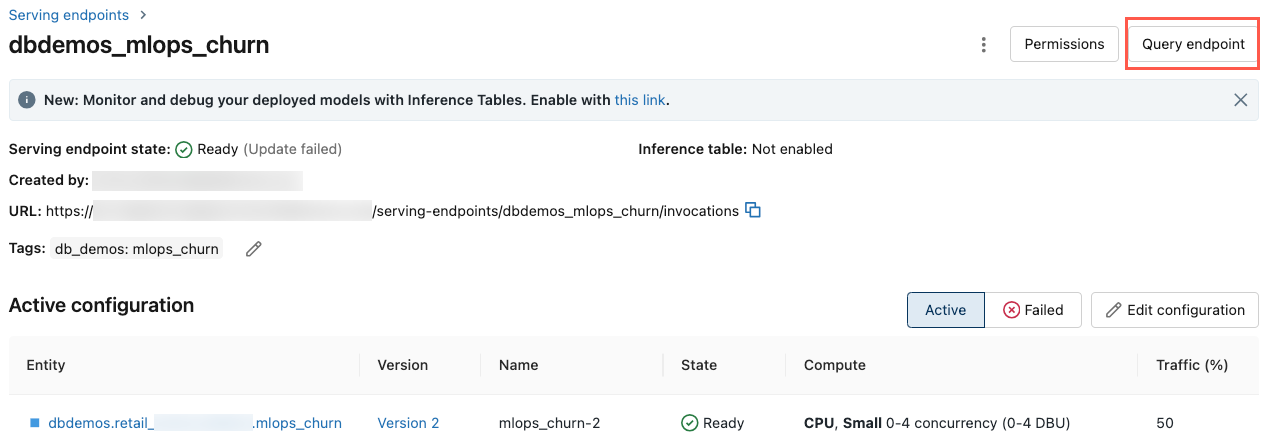
W polu Żądanie wpisz treść żądania w formacie JSON.
Kliknij pozycję Wyślij żądanie.
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
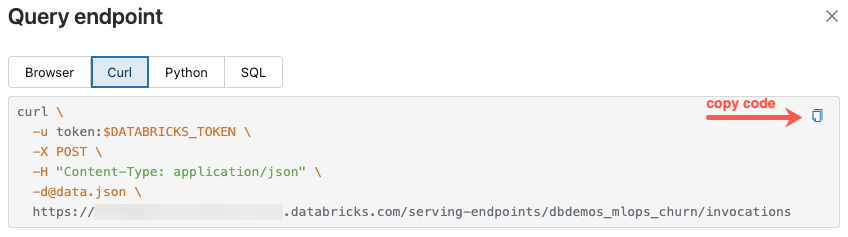
Okno dialogowe Query endpoint zawiera wygenerowany przykładowy kod w pliku curl, Python i SQL. Kliknij karty, aby wyświetlić i skopiować przykładowy kod.
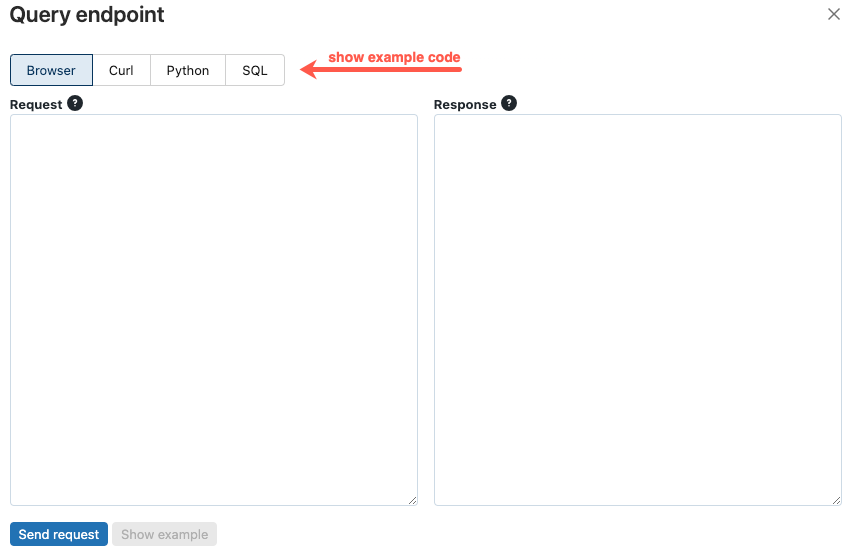
Aby skopiować kod, kliknij ikonę kopiowania w prawym górnym rogu pola tekstowego.
Aktualizowanie punktu końcowego
Ważne
Aby zmodyfikować konfigurację punktu końcowego obsługi funkcji (na przykład poprzez zmianę FeatureSpec lub rozmiaru obciążenia), zawsze używaj interfejsów API aktualizacji opisanych w tej sekcji. Nie usuwaj i nie twórz ponownie punktu końcowego, aby zastosować zmiany. Usunięcie aktywnego punktu końcowego powoduje natychmiastowe przestoje i przerywa wszystkie aplikacje, które wysyłają do niego zapytania.
Punkt końcowy można zaktualizować przy użyciu interfejsu API REST, SDK Databricks lub interfejsu użytkownika.
Aktualizowanie punktu końcowego przy użyciu interfejsów API
Zestaw SDK usługi Databricks — Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
interfejs API REST
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Aktualizowanie punktu końcowego przy użyciu interfejsu użytkownika
Wykonaj następujące kroki, aby użyć interfejsu użytkownika Serving UI:
- Na lewym pasku bocznym obszaru roboczego Azure Databricks kliknij pozycję Serwowanie.
- W tabeli kliknij nazwę punktu końcowego, który chcesz zaktualizować. Zostanie wyświetlony ekran punktu końcowego.
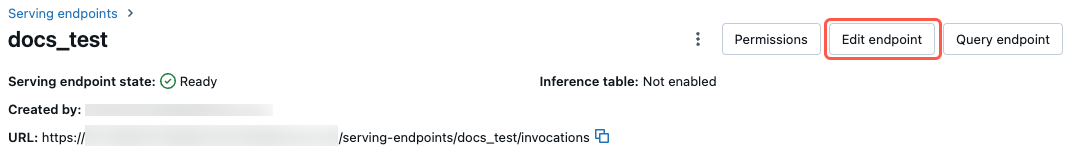
- W prawym górnym rogu ekranu kliknij pozycję Edytuj punkt końcowy.
- W oknie dialogowym Edytowanie obsługującego punktu końcowego zmodyfikuj ustawienia punktu końcowego zgodnie z potrzebami.
- Kliknij przycisk Aktualizuj, aby zapisać zmiany.
Usuń punkt końcowy
Ostrzeżenie
Ta akcja jest nieodwracalna. Usunięcie punktu końcowego obsługującej funkcję powoduje natychmiastowe przestoje dla wszystkich aplikacji, które wysyłają do niego zapytania. Jeśli chcesz zmienić konfigurację punktu końcowego, użyj polecenia Aktualizuj punkt końcowy zamiast usuwać i ponownie utworzyć punkt końcowy.
Punkt końcowy można usunąć przy użyciu interfejsu API REST, pakietu SDK Databricks, interfejsu API języka Python lub interfejsu użytkownika.
Usuwanie punktu końcowego przy użyciu interfejsów API
Zestaw SDK usługi Databricks — Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
API Python
fe.delete_feature_serving_endpoint(name="customer-features")
interfejs API REST
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
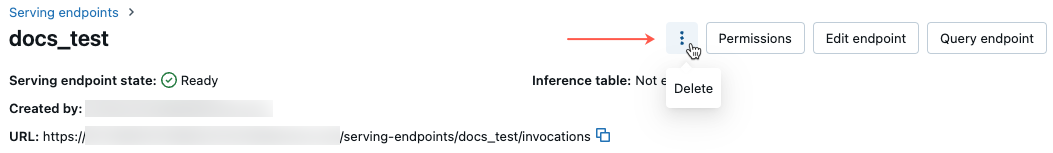
Usuwanie punktu końcowego przy użyciu interfejsu użytkownika
Wykonaj następujące kroki, aby usunąć punkt końcowy przy użyciu interfejsu użytkownika usługi:
- Na lewym pasku bocznym obszaru roboczego Azure Databricks kliknij pozycję Serwowanie.
- W tabeli kliknij nazwę punktu końcowego, który chcesz usunąć. Zostanie wyświetlony ekran punktu końcowego.
- W prawym górnym rogu ekranu kliknij ikonę menu kebab i wybierz pozycję Usuń.
Monitorowanie kondycji punktu końcowego
Aby uzyskać informacje o dziennikach i metrykach dostępnych dla punktów końcowych obsługujących funkcje, zobacz Monitorowanie jakości modelu i kondycji punktu końcowego.
Kontrola dostępu
Aby uzyskać informacje o uprawnieniach do punktów końcowych obsługujących funkcje, zobacz Zarządzanie uprawnieniami w punkcie końcowym obsługującym model.
Przykładowy notatnik
W tym notesie przedstawiono, jak korzystać z SDK Databricks do utworzenia punktu końcowego obsługi funkcji za pomocą Databricks Online Feature Store.