Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Azure Blob Storage to rozwiązanie magazynu obiektów dla chmury firmy Microsoft. Jest ona przeznaczona do przechowywania ogromnych ilości danych bez struktury, takich jak tekst, dane binarne, dokumenty, pliki multimedialne i kopie zapasowe aplikacji. Jako podstawowa usługa Azure Storage usługa Blob Storage zapewnia wiele funkcji niezawodności, aby zapewnić dostępność i trwałość danych zarówno podczas planowanych, jak i nieplanowanych zdarzeń.
W przypadku korzystania z platformy Azure niezawodność jest wspólną odpowiedzialnością. Firma Microsoft oferuje szereg możliwości wspierania odporności systemów i odzyskiwania. Odpowiadasz za zrozumienie, jak te możliwości działają w ramach wszystkich używanych usług oraz za wybór tych, które są potrzebne do osiągnięcia Twoich celów biznesowych i celów dotyczących niezawodności.
W tym artykule opisano, jak zapewnić odporność usługi Blob Storage na różne potencjalne awarie i problemy, w tym przejściowe błędy, awarie stref dostępności i awarie regionów. W tym artykule opisano również, jak można używać kopii zapasowych do odzyskiwania po innych typach problemów, oraz wyróżnia niektóre kluczowe informacje o umowie dotyczącej poziomu usług (SLA) usługi Blob Storage.
Uwaga / Notatka
Usługa Blob Storage jest częścią platformy Azure Storage. Niektóre możliwości usługi Blob Storage są wspólne dla wielu usług Azure Storage. W tym artykule używamy usługi Azure Storage do odwoływania się do tych funkcji.
Zalecenia dotyczące wdrażania produkcyjnego
Aby dowiedzieć się, jak wdrożyć usługę Blob Storage w celu obsługi wymagań dotyczących niezawodności rozwiązania i jak niezawodność wpływa na inne aspekty architektury, zobacz Najlepsze rozwiązania dotyczące architektury dla usługi Blob Storage w strukturze Azure Well-Architected Framework.
Omówienie architektury niezawodności
Usługa Azure Storage oferuje kilka opcji nadmiarowości, które ułatwiają ochronę danych przed różnymi typami awarii. Każda opcja zapewnia określony poziom nadmiarowości danych, dzięki czemu można wybrać poziom, który najlepiej odpowiada wymaganiom aplikacji.
Magazyn lokalnie nadmiarowy (LRS) replikuje dane w ramach kont magazynu do co najmniej jednej strefy dostępności platformy Azure znajdującej się w wybranym regionie podstawowym. Chociaż nie ma możliwości wyboru preferowanej strefy dostępności, Azure może przenieść lub rozwinąć konta LRS między strefami, aby poprawić równoważenie obciążenia. Nie ma gwarancji, że dane są rozproszone pomiędzy strefami. Aby uzyskać więcej informacji na temat availability zones, zobacz Co to są Strefy dostępności?

Magazyn strefowo nadmiarowy (ZRS), magazyn geograficznie nadmiarowy (GRS) i magazyn geograficznie nadmiarowy (GZRS) zapewniają dodatkową ochronę. W tym artykule opisano szczegółowo te opcje.
Odporność na błędy przejściowe
Błędy przejściowe to krótkotrwałe, sporadyczne awarie w komponentach. Występują one często w środowisku rozproszonym, takich jak chmura, i są one normalną częścią operacji. Błędy przejściowe naprawiają się po krótkim czasie. Ważne jest, aby aplikacje mogły obsługiwać błędy przejściowe, zwykle ponawiając próby żądań, których dotyczy problem.
Wszystkie aplikacje hostowane w chmurze powinny postępować zgodnie ze wskazówkami dotyczącymi obsługi błędów przejściowych platformy Azure podczas komunikowania się z dowolnymi interfejsami API hostowanymi w chmurze, bazami danych i innymi składnikami. Aby uzyskać więcej informacji, zobacz Zalecenia dotyczące obsługi błędów przejściowych.
Aby skutecznie zarządzać błędami przejściowymi podczas korzystania z usługi Blob Storage, zaimplementuj następujące zalecenia:
Użyj bibliotek klienckich usługi Azure Storage, które zawierają wbudowane zasady ponawiania prób z wykładniczym wydłużaniem odstępów i losowym rozrzutem. Zestawy SDK .NET, Java, Python i JavaScript automatycznie obsługują ponawianie prób w przypadku błędów przejściowych. Aby uzyskać więcej informacji na temat opcji konfiguracji ponawiania prób, zobacz Implementowanie zasad ponawiania za pomocą platformy .NET.
Skonfiguruj odpowiednie wartości limitu czasu dla operacji na obiektach blob w zależności od rozmiaru obiektu blob i warunków sieciowych. Większe obiekty blob wymagają dłuższych limitów czasu, ale mniejsze operacje mogą szybko wykrywać błędy przy użyciu krótszych wartości.
Odporność na błędy strefy dostępności
Strefy dostępności są fizycznie oddzielnymi grupami centrów danych w regionie świadczenia usługi Azure. Gdy jedna strefa ulegnie awarii, usługi mogą przejść w tryb failover do jednej z pozostałych stref.
Usługa Blob Storage zapewnia solidną obsługę stref dostępności dzięki konfiguracjom ZRS, które automatycznie rozmieszczają dane w wielu strefach dostępności w obrębie regionu. W przeciwieństwie do magazynu lokalnie nadmiarowego (LRS) magazyn strefowo nadmiarowy (ZRS) gwarantuje synchroniczną replikację Twoich danych obiektów blob przez platformę Azure między wieloma strefami dostępności. ZRS zapewnia, że dane pozostają dostępne nawet wtedy, gdy w jednej ze stref wystąpi awaria.
Nadmiarowość strefowa jest włączona na poziomie konta magazynowego i dotyczy wszystkich kontenerów obiektów blob na tym koncie. Nie można ustawić różnych poziomów nadmiarowości dla poszczególnych kontenerów. Konfiguracja nadmiarowości jest stosowana do całego konta magazynu. Gdy strefa dostępności powoduje awarię, usługa Azure Storage automatycznie kieruje żądania do stref w dobrej kondycji bez konieczności interwencji użytkownika lub aplikacji.
Poniższy diagram przedstawia przykładową architekturę ZRS wykorzystującą trzy strefy dostępności. ZRS może korzystać z co najmniej trzech stref dostępności.

Requirements
Obsługa regionów: Konta usługi Azure Storage strefowo nadmiarowe można wdrażać w dowolnym regionie obsługującym strefy dostępności.
Typy kont magazynowe: Nadmiarowość strefy jest dostępna zarówno dla typów kont ogólnego przeznaczenia w warstwie Standardowa, jak i Blokowej pamięci masowej dla obiektów blob w warstwie Premium. Blokowe obiekty blob, uzupełnialne obiekty blob i stronicowe obiekty blob obsługują konfiguracje strefowo nadmiarowe, ale typ używanego konta magazynu określa, które możliwości są dostępne. Aby uzyskać więcej informacji, zobacz Obsługiwane typy kont magazynu.
Koszt
Po włączeniu magazynu strefowo nadmiarowego (ZRS) płacisz za inną stawkę niż magazyn lokalnie nadmiarowy (LRS) ze względu na dodatkową replikację i obciążenie magazynu.
Aby uzyskać więcej informacji, zobacz Cennik usługi Blob Storage.
Konfiguruj obsługę stref dostępności
Utwórz konto magazynu obiektów blob z nadmiarowością strefową. Aby utworzyć nowe konto magazynu danych z nadmiarowością ZRS, zobacz Tworzenie konta magazynu danych i wybierz ZRS, magazyn geograficznie nadmiarowy strefowo (GZRS) lub magazyn geograficznie nadmiarowy strefowo z dostępem do odczytu (RA-GZRS) jako opcję nadmiarowości podczas tworzenia konta.
Zmień typ replikacji. Aby dowiedzieć się, jak zmienić istniejące konto magazynu na magazyn strefowo nadmiarowy (ZRS) oraz o opcjach konfiguracji i wymaganiach, zobacz Zmienianie sposobu replikacji konta magazynu.
Wyłącz strefową nadmiarowość. Przekonwertuj konta magazynu ZRS z powrotem na konfigurację niezonową, taką jak magazyn lokalnie nadmiarowy (LRS), przy użyciu tego samego procesu zmiany konfiguracji nadmiarowości.
Zachowanie, gdy wszystkie strefy są w dobrej kondycji
W tej sekcji opisano, czego można oczekiwać, gdy konto usługi Blob Storage skonfigurowano z nadmiarowością strefową, a wszystkie strefy dostępności są sprawne.
Routing ruchu między strefami: Usługa Azure Storage z magazynem strefowo nadmiarowym (ZRS) automatycznie dystrybuuje żądania między klastrami magazynu w wielu strefach dostępności. Dystrybucja ruchu jest niewidoczna dla aplikacji i nie wymaga konfiguracji po stronie klienta.
Replikacja danych między strefami: ZRS synchronicznie replikuje operacje zapisu w co najmniej trzech strefach dostępności w regionie. Operacja zapisu nie zostanie ukończona, dopóki Azure Storage zapisze dane we wszystkich wymaganych replikach w tych strefach. Ta synchroniczna replikacja zapewnia silną spójność i zero utraty danych podczas awarii strefy.
Zachowanie podczas awarii strefy
W tej sekcji opisano, czego można oczekiwać, gdy konto magazynu obiektów blob jest skonfigurowane pod kątem ZRS i dojdzie do awarii strefy dostępności.
- Wykrywanie i reagowanie: Firma Microsoft automatycznie wykrywa błędy strefy i inicjuje procesy odzyskiwania. Dla kont magazynu strefowo nadmiarowego (ZRS) nie jest wymagana żadna akcja klienta. Jeśli strefa stanie się niedostępna, Azure podejmuje aktualizacje sieciowe, takie jak przeadresowanie DNS.
- Powiadomienie: firma Microsoft nie powiadamia cię automatycznie, gdy strefa nie działa. Można jednak użyć Azure Resource Health do monitorowania kondycji pojedynczego zasobu i można skonfigurować Resource Health alerty w celu powiadamiania o problemach. Możesz również użyć usługi Azure Service Health , aby zrozumieć ogólną kondycję usługi, w tym wszelkie błędy strefy, i skonfigurować alerty usługi Service Health w celu powiadamiania o problemach.
Aktywne żądania: Żądania w locie mogą zostać porzucone podczas procesu odzyskiwania i należy je ponowić. Aplikacje powinny implementować logikę ponawiania prób w celu obsługi tych tymczasowych przerw.
Oczekiwana utrata danych: Brak utraty danych podczas awarii strefy, ponieważ dane są synchronicznie replikowane w wielu strefach przed zakończeniem operacji zapisu.
Oczekiwany przestój: Niewielka ilość przestojów, zazwyczaj kilka sekund, może wystąpić podczas automatycznego odzyskiwania, ponieważ ruch jest przekierowywany do stref w dobrej kondycji. Podczas projektowania aplikacji dla ZRS stosuj rozwiązania dotyczące obsługi błędów przejściowych, w tym wdrażanie zasad ponawiania prób z wykładniczo wydłużanym czasem oczekiwania.
Przekierowywanie ruchu: Jeśli strefa dostępności przejdzie w tryb offline, platforma Azure inicjuje zmiany sieci, takie jak ponowne określanie punktu w systemie nazw domen (DNS). Te aktualizacje zapewniają, że ruch jest przekierowywany do pozostałych stref dostępności w dobrej kondycji. Usługa utrzymuje pełną funkcjonalność przy użyciu stref ocalałych i nie wymaga interwencji klienta.
Odzyskiwanie strefy
Gdy strefa dostępności, która uległa awarii, zostanie przywrócona, usługa Azure Storage automatycznie przywraca normalne działanie i ponownie ustanawia replikację między co najmniej trzema strefami dostępności. Usługa automatycznie zapewnia spójność danych, synchronizując wszystkie operacje, które wystąpiły w okresie awarii.
Testowanie pod kątem niepowodzeń strefy
Gdy używasz magazynu nadmiarowego między strefami (ZRS), usługa Azure Storage automatycznie zarządza replikacją, kierowaniem ruchem i reakcjami na niedostępność stref. Ponieważ ta funkcja jest w pełni zarządzana, nie trzeba inicjować ani weryfikować procesów awarii strefy dostępności.
Odporność na awarie całego regionu
Usługa Azure Storage, w tym Azure Blob Storage, Azure Files, Azure Table Storage i Azure Queue Storage, udostępnia szereg funkcji nadmiarowości geograficznej i trybu failover, które spełniają różne wymagania.
Ważne
Magazyn z georedundancją (GRS) działa tylko w sparowanych regionach platformy Azure. Jeśli region konta magazynu nie jest sparowany, rozważ użycie niestandardowych rozwiązań wieloregionowych w celu zapewnienia odporności.
Przechowywanie geo-nadmiarowe dla sparowanych regionów
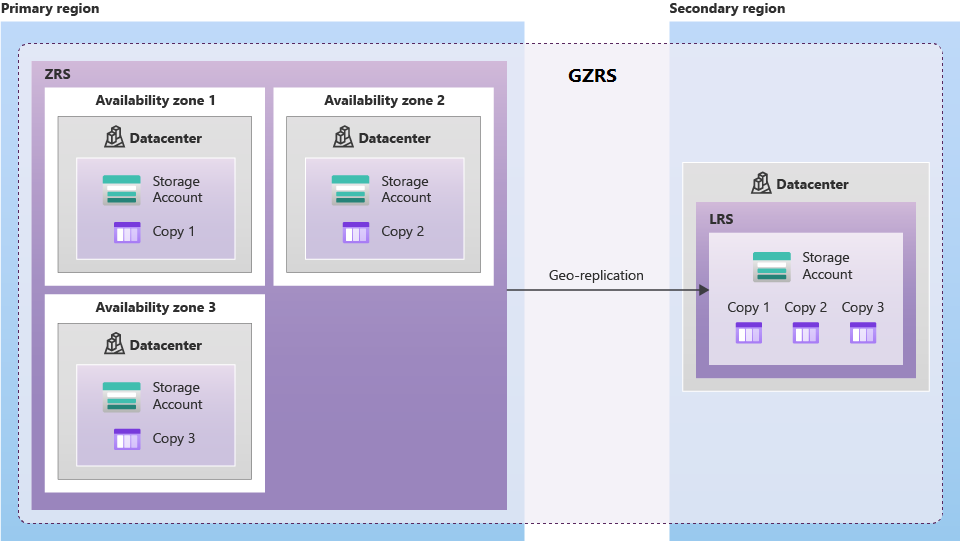
Usługa Azure Storage udostępnia kilka typów grs w sparowanych regionach. Niezależnie od typu magazynu GRS, którego używasz, usługa zawsze replikuje dane w regionie pomocniczym przy użyciu magazynu lokalnie nadmiarowego (LRS). Takie podejście zapewnia ochronę przed awariami sprzętu w regionie pomocniczym.
GRS obsługuje planowane i nieplanowane przełączenia awaryjne do regionu sparowanego platformy Azure w przypadku awarii w regionie podstawowym. Replika GRS asynchronicznie replikuje dane z regionu podstawowego do sparowanego regionu.
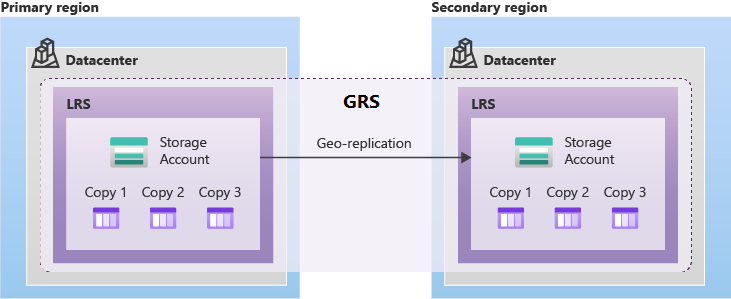
Magazyn geostrefowo nadmiarowy (GZRS) replikuje dane w wielu strefach dostępności w regionie podstawowym oraz do regionu sparowanego.
Na poniższym diagramie przedstawiono przykładową architekturę GZRS, która używa trzech stref dostępności w regionie podstawowym. GZRS może korzystać z trzech lub większej liczby stref dostępności w regionie podstawowym.
Magazyn geograficznie nadmiarowy dostępny do odczytu (RA-GRS) i magazyn geograficznie nadmiarowy z dostępem do odczytu (RA-GZRS) rozszerza magazyn geograficznie nadmiarowy (GRS) i magazyn geograficznie nadmiarowy (GZRS) z dodatkową korzyścią dostępu do odczytu do pomocniczego punktu końcowego. Te opcje są idealne dla aplikacji zaprojektowanych pod kątem wysokiej dostępności aplikacji krytycznych dla działania firmy. W mało prawdopodobnym przypadku awarii podstawowego punktu końcowego aplikacje skonfigurowane pod kątem dostępu do odczytu do regionu pomocniczego mogą nadal działać.


Typy przełączania awaryjnego
Usługa Azure Storage obsługuje trzy typy trybu failover w różnych scenariuszach.
Nieplanowane przełączenie awaryjne zarządzane przez klienta: Odpowiadasz za zainicjowanie odzyskiwania, jeśli w regionie podstawowym wystąpi awaria usługi magazynowania obejmująca cały region.
Planowane przełączenie awaryjne zarządzane przez klienta: Odpowiadasz za zainicjowanie odzyskiwania, jeśli w innym elemencie rozwiązania wystąpi awaria w regionie podstawowym i musisz przełączyć całe rozwiązanie na region zapasowy. Użyj planowanego przełączenia awaryjnego, gdy magazyn danych pozostaje operacyjny w regionie podstawowym, ale musisz przenieść całe rozwiązanie do regionu pomocniczego, na przykład podczas ćwiczeń odzyskiwania danych po awarii mających na celu zapewnienie zgodności z wymaganiami audytu i inspekcji.
Przełączenie awaryjne zarządzane przez firmę Microsoft: W wyjątkowych okolicznościach firma Microsoft może zainicjować przełączenie awaryjne dla wszystkich kont magazynu z geograficzną nadmiarowością (GRS) w regionie. Jednak tryb failover zarządzany przez firmę Microsoft jest ostatecznością i powinien być wykonywany tylko po dłuższym okresie awarii. Nie należy polegać na zarządzanym przez Microsoft mechanizmie awaryjnego przełączania.
Konta GRS mogą korzystać z dowolnego z poniższych typów przełączania awaryjnego. Nie musisz wstępnie konfigurować konta magazynowego, aby z wyprzedzeniem korzystać z dowolnego typu przełączania awaryjnego.
Requirements
Obsługa regionów: Konfiguracje geograficznie nadmiarowe usługi Azure Storage używają sparowanych regionów platformy Azure na potrzeby replikacji regionów pomocniczych. Region pomocniczy jest automatycznie określany na podstawie wybranego regionu podstawowego i nie można go dostosować. Pełną listę sparowanych regionów platformy Azure można znaleźć na liście regionów platformy Azure.
Jeśli region konta magazynu nie jest sparowany, rozważ użycie niestandardowych rozwiązań wieloregionowych w celu zapewnienia odporności.
Typy kont magazynu: Geograficznie nadmiarowa pamięć masowa (GRS) i inicjowane przez klienta przełączenie awaryjne oraz powrót po awarii są dostępne we wszystkich sparowanych regionach platformy Azure, które obsługują konta typu Azure Storage ogólnego przeznaczenia w wersji 2.
Rozważania
Podczas implementowania Blob Storage w wielu regionach należy wziąć pod uwagę następujące kluczowe czynniki:
Opóźnienie replikacji asynchronicznej: Replikacja danych do regionu pomocniczego jest asynchroniczna, co oznacza, że występuje opóźnienie między tym, kiedy dane są zapisywane w regionie podstawowym i gdy staną się dostępne w regionie pomocniczym. To opóźnienie może spowodować potencjalną utratę danych, jeśli wystąpi awaria regionu podstawowego przed zreplikowanie ostatnich danych. Utrata danych jest mierzona przez cel punktu odzyskiwania (RPO). Można oczekiwać, że opóźnienie replikacji będzie krótsze niż 15 minut, ale jest to wartość szacunkowa i nie jest gwarantowana.
Możesz sprawdzić właściwość Czas ostatniej synchronizacji, aby dowiedzieć się, ile danych może zostać utraconych, jeśli dojdzie do nieplanowanego przełączenia awaryjnego konta magazynowego.
Dostęp do regionu pomocniczego: W przypadku konfiguracji magazynu geograficznie nadmiarowego (GRS) i magazynu geograficznie nadmiarowego (GZRS) region pomocniczy nie jest dostępny do odczytu do czasu przejścia w tryb failover.
Konfiguracje magazynu geograficznie nadmiarowego z dostępem do odczytu (RA-GRS) i magazynu geograficznie nadmiarowego z dostępem do odczytu (RA-GZRS) zapewniają dostęp do odczytu do regionu pomocniczego podczas normalnych operacji, ale ze względu na opóźnienie replikacji asynchronicznej mogą zwracać nieco nieaktualne dane.
Ograniczenia funkcji: Niektóre funkcje usługi Azure Storage nie są obsługiwane lub mają ograniczenia dotyczące korzystania z magazynu geograficznie nadmiarowego (GRS) ani trybu failover zarządzanego przez klienta. Przed wdrożeniem nadmiarowości geograficznej przejrzyj zgodność funkcjonalności.
Koszt
Wieloregionowe konfiguracje kont usługi Azure Storage powodują dodatkowe koszty związane z replikacją między regionami oraz przechowywaniem danych w regionie dodatkowym. Opłaty za transfer danych między regionami platformy Azure są naliczane na podstawie standardowych stawek przepustowości między regionami.
Aby uzyskać więcej informacji, zobacz Cennik usługi Blob Storage.
Konfigurowanie obsługi wielu regionów
Utwórz nowe konto magazynu danych z geograficzną nadmiarowością (GRS). Aby utworzyć konto GRS, zobacz Tworzenie konta magazynu i podczas tworzenia konta wybierz opcję GRS, magazyn geograficznie nadmiarowy z dostępem do odczytu (RA-GRS), magazyn geograficznie nadmiarowy strefowo (GZRS) lub magazyn geograficznie nadmiarowy strefowo z dostępem do odczytu (RA-GZRS).
Włącz nadmiarowość geograficzną na istniejącym koncie magazynowym. Aby przekonwertować istniejące konto magazynu na magazyn geograficznie nadmiarowy (GRS), zobacz Zmienianie sposobu replikacji konta magazynu.
Ostrzeżenie
Po ponownym skonfigurowaniu konta na potrzeby nadmiarowości geograficznej może upłynąć dużo czasu, zanim istniejące dane w nowym regionie podstawowym będą w pełni kopiowane do nowego regionu pomocniczego.
Aby uniknąć znacznej utraty danych, sprawdź wartość właściwości Czas ostatniej synchronizacji przed rozpoczęciem nieplanowanego przełączenia awaryjnego. Aby ocenić potencjalną utratę danych, porównaj czas ostatniej synchronizacji z ostatnim zapisem danych w nowym regionie podstawowym.
Wyłącz nadmiarowość geograficzną. Przekonwertuj konta GRS z powrotem na konfiguracje z jednym regionem, takie jak magazyn lokalnie nadmiarowy (LRS) lub magazyn strefowo nadmiarowy (ZRS), korzystając z tego samego procesu zmiany konfiguracji nadmiarowości.
Zachowanie, gdy wszystkie regiony są w dobrej kondycji
W tej sekcji opisano, czego można oczekiwać, gdy konto magazynu jest skonfigurowane na potrzeby nadmiarowości geograficznej, a wszystkie regiony działają.
Routing ruchu między regionami: Usługa Azure Storage używa podejścia aktywnego pasywnego, w którym wszystkie operacje zapisu i większość operacji odczytu są kierowane do regionu podstawowego.
W przypadku konfiguracji magazynu geograficznie nadmiarowego z dostępem do odczytu (RA-GRS) oraz magazynu geograficznie strefowo nadmiarowego z dostępem do odczytu (RA-GZRS) aplikacje mogą opcjonalnie odczytywać dane z regionu pomocniczego, uzyskując dostęp do pomocniczego punktu końcowego. Takie podejście wymaga jawnej konfiguracji aplikacji i nie jest automatyczne. Ponadto ze względu na opóźnienie replikacji asynchronicznej dane w regionie pomocniczym mogą być nieco nieaktualne.
Replikacja danych między regionami: Operacje zapisu są najpierw zatwierdzane w regionie podstawowym przy użyciu następujących skonfigurowanych typów nadmiarowości:
- Magazynowanie lokalnie nadmiarowe (LRS) dla magazynowania geograficznie nadmiarowego (GRS) i RA-GRS
- Magazyn strefowo nadmiarowy (ZRS) dla magazynu geograficznie nadmiarowego (GZRS) i RA-GZRS
Po pomyślnym zakończeniu operacji w regionie podstawowym dane są asynchronicznie replikowane do regionu dodatkowego, gdzie są przechowywane z użyciem mechanizmu LRS.
Asynchroniczny charakter replikacji między regionami oznacza, że zazwyczaj występuje opóźnienie między czasem zapisywania danych w regionie podstawowym a dostępnością w regionie pomocniczym. Czas replikacji można monitorować przy użyciu właściwości Czas ostatniej synchronizacji.
Zachowanie podczas awarii regionu
W tej sekcji opisano, czego oczekiwać po skonfigurowaniu konta magazynowego dla nadmiarowości geograficznej w przypadku awarii w regionie podstawowym.
Przełączenie awaryjne zarządzane przez klienta (nieplanowane): Użyj nieplanowanego przełączenia awaryjnego, gdy pamięć masowa w regionie podstawowym jest niedostępna.
Wykrywanie i reagowanie: W mało prawdopodobnym przypadku niedostępności konta magazynu w regionie podstawowym można rozważyć zainicjowanie nieplanowanego trybu failover zarządzanego przez klienta. Aby podjąć tę decyzję, należy wziąć pod uwagę następujące czynniki:
Czy usługa Azure Resource Health wskazuje problemy z dostępem do konta magazynu w Twoim regionie podstawowym
Czy firma Microsoft zaleca przeprowadzenie przejścia w tryb failover do innego regionu
Ostrzeżenie
Nieplanowane przejście w tryb failover może spowodować utratę danych. Przed zainicjowaniem trybu failover zarządzanego przez klienta zdecyduj, czy przywrócenie usługi uzasadnia ryzyko utraty danych.
Powiadomienie: Firma Microsoft nie powiadamia cię automatycznie, gdy region nie działa. Można jednak użyć Azure Resource Health do monitorowania kondycji pojedynczego zasobu i można skonfigurować Resource Health alerty w celu powiadamiania o problemach. Możesz również użyć Azure Service Health, aby zrozumieć ogólną kondycję usługi, w tym wszelkie błędy regionu, i skonfigurować alerty usługi Service Health w celu powiadamiania o problemach.
Aktywne żądania: Podczas procesu failover punkty końcowe konta przechowywania podstawowego i pomocniczego stają się tymczasowo niedostępne dla operacji zarówno odczytu, jak i zapisu. Wszystkie aktywne żądania mogą zostać porzucone, a aplikacje klienckie muszą ponowić próbę po zakończeniu pracy w trybie failover.
Oczekiwana utrata danych: Utrata danych jest powszechna podczas nieplanowanego trybu failover z powodu opóźnienia replikacji asynchronicznej, co oznacza, że ostatnie zapisy mogą nie być replikowane. Możesz sprawdzić właściwość Czas ostatniej synchronizacji , aby dowiedzieć się, ile danych może zostać utraconych podczas nieplanowanego przejścia w tryb failover. Oczekiwana utrata danych jest często określana jako cel punktu odzyskiwania (RPO). Zazwyczaj można oczekiwać, że RPO będzie poniżej 15 minut, ale ten czas nie jest gwarantowany.
Oczekiwany przestój: Oczekiwany przestój jest często określany jako cel czasu odzyskiwania (RTO). Proces failover zarządzany przez klienta zazwyczaj kończy się w ciągu 60 minut, w zależności od wielkości konta i stopnia złożoności.
Przekierowywanie ruchu: Po zakończeniu pracy w trybie failover platforma Azure automatycznie aktualizuje punkty końcowe konta magazynu, aby aplikacje nie musiały być ponownie skonfigurowane. Jeśli aplikacja przechowuje buforowane wpisy systemu nazw domen (DNS), może być konieczne wyczyszczenie pamięci podręcznej w celu zapewnienia, że aplikacja wysyła ruch do nowego regionu podstawowego.
Konfiguracja po przełączeniu awaryjnym: Po zakończeniu nieplanowanego przełączenia awaryjnego konto magazynu w regionie docelowym używa warstwy magazynowania lokalnie nadmiarowego (LRS). Jeśli chcesz ponownie włączyć replikację geograficzną, musisz ponownie włączyć magazyn z geograficzną nadmiarowością (GRS) i poczekać, aż dane zostaną zreplikowane do nowego regionu pomocniczego.
Aby uzyskać więcej informacji na temat inicjowania trybu failover zarządzanego przez klienta, zobacz Jak działa tryb failover zarządzany przez klienta (nieplanowany) i Inicjowanie trybu failover konta magazynu.
Przełączenie awaryjne zarządzane przez klienta (planowane): Użyj planowanego przełączenia awaryjnego, gdy pamięć masowa pozostaje operacyjna w regionie podstawowym, ale z innego powodu musisz przełączyć całe rozwiązanie awaryjnie do regionu pomocniczego. Na przykład inna usługa platformy Azure może mieć problem i musisz przełączyć się na korzystanie z regionu pomocniczego dla całego rozwiązania. Możesz też użyć planowanego przejścia w tryb failover do przeprowadzenia próbnego odzyskiwania po awarii na potrzeby zgodności i inspekcji.
Wykrywanie i reagowanie: Odpowiadasz za podjęcie decyzji o przejściu w tryb failover. Zazwyczaj podejmujesz tę decyzję, jeśli konieczne jest przełączenie w tryb failover między regionami, nawet jeśli konto magazynu jest w dobrej kondycji. Na przykład możesz wyzwolić przełączenie awaryjne, gdy wystąpi poważna awaria innego składnika aplikacji, której nie można naprawić w regionie podstawowym.
Powiadomienie: Firma Microsoft nie powiadamia cię automatycznie, gdy region nie działa. Można jednak użyć Azure Resource Health do monitorowania kondycji pojedynczego zasobu i można skonfigurować Resource Health alerty w celu powiadamiania o problemach. Możesz również użyć Azure Service Health, aby zrozumieć ogólną kondycję usługi, w tym wszelkie błędy regionu, i skonfigurować alerty usługi Service Health w celu powiadamiania o problemach.
Aktywne żądania: Podczas procesu failover punkty końcowe konta przechowywania podstawowego i pomocniczego stają się tymczasowo niedostępne dla operacji zarówno odczytu, jak i zapisu. Wszystkie aktywne żądania mogą zostać porzucone, a aplikacje klienckie muszą ponowić próbę po zakończeniu pracy w trybie failover.
Oczekiwana utrata danych: Utraty danych nie należy się spodziewać, ponieważ proces failover kończy się dopiero po zsynchronizowaniu wszystkich danych, co daje wskaźnik RPO równy zero.
Oczekiwany przestój: Proces failover zwykle trwa do 60 minut, co oznacza, że oczekiwany czas odzyskiwania również wynosi 60 minut, w zależności od rozmiaru konta i złożoności. Podczas procesu trybu failover punkty końcowe konta magazynu podstawowego i pomocniczego stają się tymczasowo niedostępne zarówno dla operacji odczytu, jak i zapisu.
Przekierowywanie ruchu: Po zakończeniu pracy w trybie failover platforma Azure automatycznie aktualizuje punkty końcowe konta magazynu, aby aplikacje nie musiały być ponownie skonfigurowane. Jeśli aplikacja przechowuje wpisy DNS w pamięci podręcznej, może być konieczne wyczyszczenie pamięci podręcznej w celu zapewnienia, że aplikacja wysyła ruch do nowego regionu podstawowego.
Konfiguracja po przejściu w tryb failover: Po zakończeniu planowanego przejścia w tryb failover konto magazynu w regionie docelowym będzie nadal replikowane geograficznie i pozostaje w warstwie GRS.
Aby uzyskać więcej informacji na temat inicjowania trybu failover zarządzanego przez klienta, zobacz Jak działa tryb failover zarządzany przez klienta (planowany) i Inicjowanie trybu failover konta magazynu.
Tryb failover zarządzany przez firmę Microsoft: W rzadkim przypadku poważnej awarii, w której firma Microsoft ustali, że region podstawowy jest trwale nieodwracalny, może zostać zainicjowane automatyczne przejście w tryb failover do regionu pomocniczego. Firma Microsoft obsługuje cały proces i nie jest wymagana żadna akcja klienta. Czas, który upłynął przed przejściem w tryb failover, zależy od ważności awarii i czasu wymaganego do oceny sytuacji.
- Powiadomienie: Firma Microsoft nie powiadamia cię automatycznie, gdy region nie działa. Można jednak użyć Azure Resource Health do monitorowania kondycji pojedynczego zasobu i można skonfigurować Resource Health alerty w celu powiadamiania o problemach. Możesz również użyć Azure Service Health, aby zrozumieć ogólną kondycję usługi, w tym wszelkie błędy regionu, i skonfigurować alerty usługi Service Health w celu powiadamiania o problemach.
Ważne
Użyj opcji failover zarządzanej przez klienta, aby opracowywać, testować i implementować plany odzyskiwania po awarii. Nie należy polegać na trybie failover zarządzanym przez firmę Microsoft, który może być używany tylko w ekstremalnych okolicznościach. Przełączenie awaryjne zarządzane przez firmę Microsoft prawdopodobnie zostanie zainicjowane w całym regionie. Nie można go zainicjować dla poszczególnych kont przechowywania, subskrypcji ani klientów. Przełączenie awaryjne może wystąpić w różnym czasie dla różnych usług Azure. Zalecamy korzystanie z trybu failover zarządzanego przez klienta.
Odzyskiwanie regionów
Proces powrotu po awarii różni się znacznie między scenariuszami trybu failover zarządzanymi przez firmę Microsoft i zarządzanymi przez klienta.
Przełączenie awaryjne zarządzane przez klienta (nieplanowane): Po nieplanowanym przełączeniu awaryjnym konto magazynowe jest skonfigurowane do korzystania z magazynu lokalnie nadmiarowego (LRS). Aby powrócić do działania po awarii, należy ponownie ustanowić relację geograficznie nadmiarowego magazynu (GRS) i poczekać na zreplikowanie danych.
Przełączenie awaryjne zarządzane przez klienta (planowane): Po planowanym przełączeniu awaryjnym konto magazynowe pozostaje replikowane geograficznie. Możesz zainicjować kolejne przełączenie awaryjne zarządzane przez klienta, aby powrócić do pierwotnego regionu podstawowego. Mają zastosowanie te same zagadnienia dotyczące trybu failover.
Przełączenie awaryjne zarządzane przez firmę Microsoft: Jeśli firma Microsoft inicjuje przełączenie awaryjne, prawdopodobnie wystąpiła poważna awaria w regionie podstawowym, a przywrócenie regionu podstawowego może nie być możliwe. Wszelkie harmonogramy i plany przywracania działania zależą od skali regionalnej katastrofy oraz działań naprawczych. Aby uzyskać szczegółowe informacje, należy monitorować komunikację usługi Azure Service Health.
Testowanie pod kątem błędów regionów
Możesz symulować regionalne błędy w celu przetestowania procedur odzyskiwania po awarii.
Planowane testy przełączenia awaryjnego: W przypadku kont magazynu z replikacją geograficzną (GRS) można wykonywać operacje planowanego przełączenia awaryjnego podczas okien konserwacyjnych, aby przetestować kompletny proces przełączenia awaryjnego i powrotu do regionu podstawowego. Planowane przełączenie awaryjne nie wymaga utraty danych, ale wiąże się z przerwą w działaniu zarówno podczas przełączenia awaryjnego, jak i przełączenia powrotnego.
Testowanie pomocniczego punktu końcowego: W przypadku konfiguracji magazynu geograficznie nadmiarowego z dostępem do odczytu (RA-GRS) oraz magazynu geograficznie i strefowo nadmiarowego z dostępem do odczytu (RA-GZRS) regularnie testuj operacje odczytu przy użyciu pomocniczego punktu końcowego, aby upewnić się, że aplikacja może pomyślnie odczytywać dane z regionu pomocniczego.
Niestandardowe rozwiązania wieloregionowe zapewniające odporność
Możliwości trybu failover między regionami usługi Azure Storage mogą być nieodpowiednie z następujących powodów:
Twoje konto magazynu znajduje się w regionie niepowiązanym.
Cele czasu pracy firmy nie są spełnione przez czas odzyskiwania lub utratę danych, które zapewniają wbudowane opcje trybu failover.
Musisz przejść w tryb failover do regionu, który nie jest parą regionu podstawowego.
Potrzebna jest aktywna/aktywna konfiguracja w różnych regionach.
Ta sekcja zawiera ogólne omówienie niektórych podejść do rozważenia. Kompleksowy przegląd topologii wdrażania w wielu regionach dla Azure Storage wykracza poza zakres tego artykułu.
Usługę Azure Storage można wdrożyć w wielu regionach przy użyciu oddzielnych kont magazynu w każdym regionie. Takie podejście zapewnia elastyczność wyboru regionów, możliwość korzystania z niepairowanych regionów i bardziej szczegółową kontrolę nad czasem replikacji i spójnością danych. Podczas implementowania wielu kont magazynu w różnych regionach należy skonfigurować replikację danych między regionami, zaimplementować zasady równoważenia obciążenia i trybu failover oraz zapewnić spójność danych w różnych regionach.
Replikacja obiektów zapewnia dodatkową opcję replikacji danych między regionami, która zapewnia asynchroniczne kopiowanie blokowych obiektów blob między kontami magazynu. W przeciwieństwie do wbudowanych opcji magazynowania geograficznie nadmiarowego, które korzystają ze stałych par regionów, replikacja obiektów pozwala replikować dane między kontami magazynu w dowolnym regionie platformy Azure, w tym w regionach niesparowanych. Takie podejście zapewnia pełną kontrolę nad regionami źródłowymi i docelowymi, zasadami replikacji oraz konkretnymi kontenerami i prefiksami obiektów blob, które mają być replikowane.
Replikację obiektów można skonfigurować tak, aby replikowała wszystkie obiekty blob w kontenerze lub ich określone podzbiory na podstawie prefiksów i tagów obiektów blob. Replikacja jest asynchroniczna i występuje w tle. Można skonfigurować wiele zasad replikacji, a nawet łańcuchowo połączyć replikację między wieloma kontami magazynów, aby utworzyć zaawansowane topologie obejmujące wiele regionów.
Replikacja obiektów nie jest obsługiwana przez wszystkie konta magazynowe. Na przykład nie działa z kontami magazynu korzystającymi z hierarchicznych przestrzeni nazw (nazywanych również kontami usługi Azure Data Lake Storage Gen2).
Aby uzyskać więcej informacji, zobacz Replikacja obiektów dla blokowych obiektów blob i Konfigurowanie funkcji replikacji obiektów.
Kopia zapasowa i przywracanie
Usługa Blob Storage udostępnia wiele mechanizmów ochrony danych, które uzupełniają nadmiarowość w celu uzyskania kompleksowych strategii tworzenia kopii zapasowych. Wbudowana nadmiarowość usługi chroni przed awariami infrastruktury, a dodatkowe możliwości tworzenia kopii zapasowych chronią przed przypadkowym usunięciem, uszkodzeniem i złośliwymi działaniami.
Przywracanie do punktu w czasie (PITR) umożliwia przywrócenie danych blokowych obiektów blob do wcześniejszego stanu w ramach skonfigurowanego okresu przechowywania wynoszącego maksymalnie 365 dni. Firma Microsoft w pełni zarządza tą funkcją. Zapewnia również precyzyjne opcje odzyskiwania na poziomie kontenera lub obiektu blob. Dane PITR są przechowywane w tym samym regionie co konto źródłowe i są dostępne nawet w przypadku awarii regionalnych, jeśli używasz konfiguracji z redundancją geograficzną.
Przechowywanie wersji obiektów blob automatycznie utrzymuje poprzednie wersje obiektów blob podczas ich modyfikowania lub usuwania. Każda wersja jest przechowywana jako oddzielny obiekt i można uzyskać do nich dostęp niezależnie. Wersje są przechowywane w tym samym regionie co bieżący obiekt blob i używają tej samej konfiguracji nadmiarowości co konto magazynu.
Usuwanie miękkie stanowi zabezpieczenie przed przypadkowym usunięciem obiektów blob i kontenerów, zachowując usunięte dane przez konfigurowalny okres. Dane usunięte nietrwale pozostają na tym samym koncie magazynu i w tym samym regionie, dzięki czemu można je natychmiast odzyskać. W przypadku kont z georedundancją dane usunięte nietrwale są również replikowane do regionu pomocniczego.
Migawki obiektów blob to kopie obiektów blob tylko do odczytu, utworzone w określonym momencie, których można używać na potrzeby tworzenia kopii zapasowych i odzyskiwania danych. Migawki są przechowywane na tym samym koncie magazynowym i korzystają z tych samych ustawień nadmiarowości oraz replikacji geograficznej co bazowy obiekt blob.
W przypadku wymagań dotyczących tworzenia kopii zapasowych między regionami rozważ użycie usługi Azure Backup dla obiektów blob, która zapewnia scentralizowane zarządzanie kopiami zapasowymi i może przechowywać dane kopii zapasowej w regionach innych niż dane źródłowe. Ta usługa zapewnia operacyjne kopie zapasowe oraz kopie zapasowe przechowywane w magazynie, które mają konfigurowalne zasady przechowywania i opcje przywracania. Aby uzyskać więcej informacji, zobacz artykuł Omówienie funkcji tworzenia kopii zapasowych obiektów blob.
W przypadku większości rozwiązań nie należy polegać wyłącznie na kopiach zapasowych. Zamiast tego skorzystaj z innych możliwości opisanych w tym przewodniku, aby spełnić wymagania dotyczące odporności. Jednak kopie zapasowe chronią przed pewnymi zagrożeniami, których nie zapewniają inne podejścia. Aby uzyskać więcej informacji, zobacz Co to jest nadmiarowość, replikacja i kopia zapasowa?.
Umowa dotycząca poziomu usług
Umowa dotycząca poziomu usług (SLA) dla usługi Azure Storage opisuje oczekiwaną dostępność usługi oraz warunki, które muszą zostać spełnione, aby osiągnąć te oczekiwania dotyczące dostępności. Umowa SLA dotycząca dostępności, dla której kwalifikujesz się, zależy od warstwy magazynowania i używanego typu replikacji. Aby uzyskać więcej informacji, zobacz Umowy SLA dla usług online.