Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
W tym artykule opisano:
- Typy danych monitorowania, które można zbierać dla tej usługi.
- Sposoby analizowania tych danych.
Uwaga
Jeśli znasz już tę usługę i/lub Azure Monitor i chcesz tylko dowiedzieć się, jak analizować dane monitorowania, zobacz sekcję Analiza pod koniec tego artykułu.
Jeśli masz krytyczne aplikacje i procesy biznesowe korzystające z zasobów platformy Azure, musisz monitorować i otrzymywać alerty dla systemu. Usługa Azure Monitor zbiera i agreguje metryki i dzienniki z każdego składnika systemu. Usługa Azure Monitor zapewnia wgląd w dostępność, wydajność i odporność oraz powiadamia o problemach. Do konfigurowania i wyświetlania danych monitorowania można użyć witryny Azure Portal, programu PowerShell, interfejsu wiersza polecenia platformy Azure, interfejsu API REST lub bibliotek klienckich.
- Aby uzyskać więcej informacji na temat usługi Azure Monitor, zobacz Omówienie usługi Azure Monitor.
- Aby uzyskać więcej informacji o monitorowaniu zasobów platformy Azure ogólnie, zobacz Monitorowanie zasobów platformy Azure za pomocą usługi Azure Monitor.
Ostrzeżenie
Usługa Application Insights dla zestawu SDK usługi Service Fabric nie jest już obsługiwana.
Monitorowanie usługi Azure Service Fabric
Usługa Azure Service Fabric ma następujące warstwy, które można monitorować:
- Monitorowanie aplikacji: aplikacje uruchamiane na węzłach. Aplikacje można monitorować przy użyciu klucza usługi Application Insights lub zestawu SDK, usługi EventStore albo rejestrowania w ASP.NET Core.
- Monitorowanie platformy (klastra): metryki klienta, dzienniki i zdarzenia dla platformy lub węzłów klastra, w tym metryki kontenerów. Metryki i dzienniki różnią się w przypadku węzłów systemu Linux lub Windows.
- Monitorowanie infrastruktury (wydajności): Kondycja usługi i liczniki wydajności dla infrastruktury usługi.
Możesz monitorować sposób używania aplikacji, akcje wykonywane przez platformę usługi Service Fabric, wykorzystanie zasobów z licznikami wydajności oraz ogólną kondycję klastra. Dzienniki Azure Monitor i Application Insights oferują wbudowaną integrację z usługą Service Fabric.
- Aby dowiedzieć się o najlepszych praktykach, zobacz Najlepsze praktyki monitorowania i diagnostyki dla usługi Azure Service Fabric.
- Samouczek pokazujący, jak wyświetlać zdarzenia i raporty kondycji usługi Service Fabric, wykonywać zapytania przy użyciu interfejsów API usługi EventStore oraz monitorować liczniki wydajności, znajduje się tutaj: Samouczek: monitorowanie klastra usługi Service Fabric na platformie Azure.
- Aby dowiedzieć się, jak skonfigurować dzienniki usługi Azure Monitor do monitorowania kontenerów systemu Windows koordynowanych przez usługę Service Fabric, zobacz Samouczek: monitorowanie kontenerów systemu Windows w usłudze Service Fabric przy użyciu dzienników usługi Azure Monitor.
Service Fabric Explorer
Service Fabric Explorer, aplikacja komputerowa dla systemów Windows, macOS i Linux, to narzędzie o otwartym kodzie źródłowym do inspekcji klastrów usługi Azure Service Fabric i zarządzania nimi. Aby włączyć automatyzację, każda akcja, którą można wykonać za pomocą narzędzia Service Fabric Explorer, można również wykonać za pomocą programu PowerShell lub interfejsu API REST.
Monitorowanie aplikacji
Monitorowanie aplikacji śledzi sposób użycia funkcji i składników aplikacji. Chcesz monitorować swoje aplikacje, aby upewnić się, że problemy mające wpływ na użytkowników są wykrywane. Odpowiedzialność za monitorowanie aplikacji zależy od użytkowników tworzących aplikację i jej usługi, ponieważ jest ona unikatowa dla logiki biznesowej aplikacji. Monitorowanie aplikacji może być przydatne w następujących scenariuszach:
- Ile ruchu doświadcza moja aplikacja? — Czy musisz skalować usługi, aby sprostać wymaganiom użytkowników lub usunąć potencjalne wąskie gardło w aplikacji?
- Czy moje wywołania między usługami są zakończone powodzeniem i śledzone?
- Jakie działania są podejmowane przez użytkowników mojej aplikacji? - Zbieranie danych telemetrycznych może prowadzić przyszłe opracowywanie funkcji i lepszą diagnostykę błędów aplikacji
- Czy moja aplikacja zgłasza nieobsługiwane wyjątki?
- Co się dzieje w ramach usług uruchomionych wewnątrz moich kontenerów?
Doskonałym rozwiązaniem w zakresie monitorowania aplikacji jest to, że deweloperzy mogą używać dowolnych narzędzi i struktur, ponieważ znajduje się ona w kontekście aplikacji. Więcej informacji o rozwiązaniu Azure do monitorowania aplikacji za pomocą usługi Azure Monitor Application Insights można znaleźć w artykule Analiza zdarzeń za pomocą usługi Application Insights.
Mamy również samouczek pokazujący, jak skonfigurować to dla aplikacji .NET. W tym samouczku omówiono sposób instalowania odpowiednich narzędzi, przykładu pisania niestandardowych danych telemetrycznych w aplikacji oraz wyświetlania diagnostyki aplikacji i telemetrii w witrynie Azure Portal.
Rejestrowanie aplikacji
Instrumentacja kodu to nie tylko sposób uzyskiwania szczegółowych informacji o użytkownikach, ale także jedyny sposób, w jaki możesz wiedzieć, czy coś jest nie tak w aplikacji, oraz do diagnozowania tego, co należy naprawić. Chociaż technicznie można połączyć debuger z usługą produkcyjną, nie jest to powszechna praktyka. Dlatego posiadanie szczegółowych danych instrumentacji jest ważne.
Niektóre produkty automatycznie instrumentują twój kod. Chociaż te rozwiązania mogą działać dobrze, instrumentacja ręczna jest prawie zawsze wymagana do konkretnej logiki biznesowej. W końcu musisz mieć wystarczającą ilość informacji, aby śledczo debugować aplikację. Aplikacje usługi Service Fabric można instrumentować przy użyciu dowolnej platformy rejestrowania. W tej sekcji opisano kilka różnych podejść do instrumentowania kodu oraz wskazano, kiedy wybrać jedno podejście zamiast innego.
Application Insights SDK: Application Insights oferuje rozbudowaną integrację z Service Fabric od razu po wdrożeniu. Użytkownicy mogą dodać pakiety NuGet usługi AI Service Fabric i otrzymywać dane oraz dzienniki, które są tworzone i zbierane oraz które można wyświetlać w portalu Azure. Ponadto zachęcamy użytkowników do dodawania własnych danych telemetrycznych w celu diagnozowania i debugowania aplikacji oraz śledzenia najczęściej używanych usług i części aplikacji. Klasa TelemetryClient w pakiecie SDK zapewnia wiele sposobów śledzenia telemetrii w aplikacjach. Aby uzyskać więcej informacji, zobacz temat Analiza zdarzeń i wizualizacja przy użyciu usługi Application Insights.
Zapoznaj się z przykładem, jak dodać instrumentację i usługę Application Insights do aplikacji, w naszym samouczku dotyczącym monitorowania i diagnozowania aplikacji platformy .NET.
EventSource: Podczas tworzenia rozwiązania usługi Service Fabric na podstawie szablonu w programie Visual Studio jest generowana klasa pochodna EventSource (ServiceEventSource lub ActorEventSource). Zostanie utworzony szablon, w którym można dodawać zdarzenia dla aplikacji lub usługi. Nazwa EventSourcemusi być unikatowa i należy ją zmienić z domyślnego ciągu szablonu MyCompany-<solution>-<project>. Posiadanie wielu definicji EventSource, które używają tej samej nazwy, powoduje problem w czasie wykonywania. Każde zdefiniowane zdarzenie musi mieć unikatowy identyfikator. Jeśli identyfikator nie jest unikatowy, wystąpi błąd środowiska uruchomieniowego. Niektóre organizacje wstępnie przypisują zakresy wartości identyfikatorom, aby uniknąć konfliktów między odrębnymi zespołami programistycznymi. Aby uzyskać więcej informacji, zobacz blog Vance’a lub dokumentację MSDN.
Rejestrowanie w ASP.NET Core: Ważne jest, aby dokładnie zaplanować sposób instrumentacji kodu. Odpowiedni plan instrumentacji może pomóc uniknąć potencjalnej destabilizacji bazy kodu, a następnie konieczności ponownej instrumentacji kodu. Aby zmniejszyć ryzyko, możesz wybrać bibliotekę do instrumentacji, taką jak Microsoft.Extensions.Logging, która jest częścią Microsoft ASP.NET Core. ASP.NET Core ma interfejs ILogger, którego można używać z dostawcą wybranym przez siebie, jednocześnie minimalizując wpływ na istniejący kod. Możesz użyć kodu w programie ASP.NET Core w systemach Windows i Linux oraz w pełnym programie .NET Framework, aby kod instrumentacji był ustandaryzowany.
Przykłady dotyczące korzystania z tych sugestii można znaleźć w temacie Dodawanie rejestrowania w aplikacji usługi Service Fabric.
Monitorowanie platformy (klastra)
Użytkownik ma kontrolę nad tym, jakie dane telemetryczne pochodzą z aplikacji, ponieważ użytkownik pisze sam kod, ale co z diagnostyką z platformy Service Fabric? Jednym z celów usługi Service Fabric jest zapewnienie odporności aplikacji na awarie sprzętowe. Cel ten jest osiągany dzięki zdolności usług systemowych platformy do wykrywania problemów z infrastrukturą i szybkiego przełączania obciążeń awaryjnie na inne węzły w klastrze. Ale w tym konkretnym przypadku co zrobić, jeśli same usługi systemowe mają problemy? Lub jeśli podczas próby wdrożenia lub przeniesienia obciążenia roboczego zostaną naruszone zasady rozmieszczania usług? Service Fabric udostępnia diagnostykę tych i innych elementów, dzięki czemu jesteś informowany o działaniach zachodzących w klastrze. Oto przykładowe scenariusze monitorowania klastra:
Aby uzyskać więcej informacji na temat monitorowania platformy (klastra), zobacz artykuł Monitorowanie klastra.
Zdarzenia usługi Service Fabric
Service Fabric udostępnia od razu pełny zestaw zdarzeń diagnostycznych, do których można uzyskać dostęp za pośrednictwem EventStore lub kanału zdarzeń operacyjnych udostępnianego przez platformę. Te zdarzenia usługi Service Fabric ilustrują działania wykonywane przez platformę na różnych elementach, takich jak węzły, aplikacje, usługi i partycje. Te same zdarzenia są dostępne w klastrach systemów Windows i Linux.
Kanały zdarzeń usługi Service Fabric: W systemie Windows zdarzenia usługi Service Fabric są dostępne za pośrednictwem jednego dostawcy ETW przy użyciu odpowiedniego zestawu
logLevelKeywordFilters, służącego do wyboru między kanałami Operational oraz Data & Messaging. W ten sposób wydzielamy wychodzące zdarzenia usługi Service Fabric, aby w razie potrzeby można je było filtrować. W systemie Linux zdarzenia usługi Service Fabric przechodzą przez narzędzie LTTng i są umieszczane w jednej tabeli usługi Storage, z której można je filtrować zgodnie z potrzebami. Te kanały zawierają wyselekcjonowane zdarzenia ustrukturyzowane, które mogą służyć do lepszego zrozumienia stanu klastra. Diagnostyka jest domyślnie włączana podczas tworzenia klastra, co powoduje utworzenie tabeli w usłudze Azure Storage, do której są wysyłane zdarzenia z tych kanałów, aby można było później wykonywać na nich zapytania.EventStore to funkcja, która wyświetla zdarzenia platformy w narzędziu Service Fabric Explorer oraz programowo za pomocą interfejsu API REST biblioteki klienta Service Fabric Client Library. Możesz zobaczyć podgląd stanu tego, co dzieje się w klastrze, dla każdego węzła, każdej usługi i każdej aplikacji, a także wyszukiwać na podstawie czasu zdarzenia. Interfejsy API EventStore są dostępne tylko w przypadku klastrów systemu Windows uruchomionych na platformie Azure. Na komputerach z systemem Windows te zdarzenia są rejestrowane w Dzienniku zdarzeń, dzięki czemu można wyświetlać zdarzenia usługi Service Fabric w Podglądzie zdarzeń.
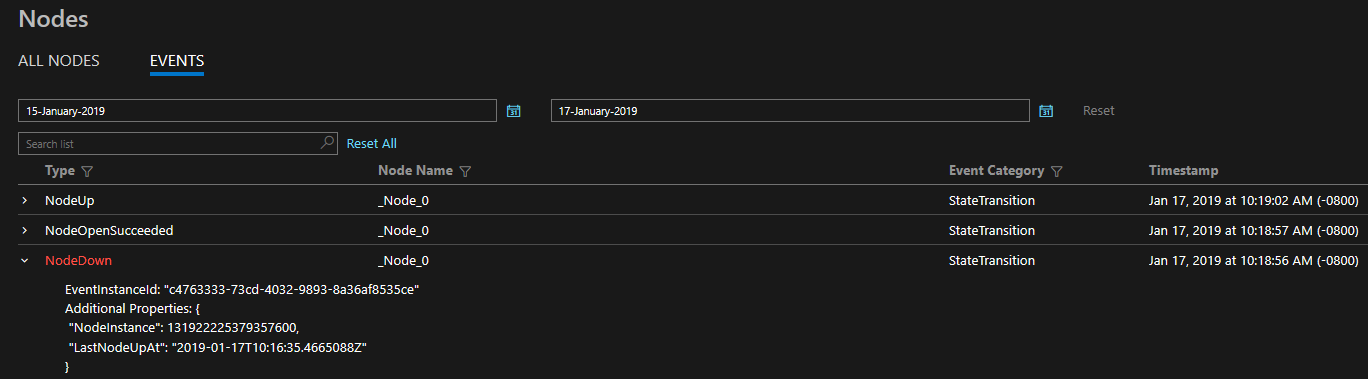
Dostarczane dane diagnostyczne mają domyślnie postać obszernego zestawu zdarzeń. Te zdarzenia usługi Service Fabric ilustrują działania wykonywane przez platformę na różnych elementach, takich jak węzły, aplikacje, usługi, partycje itp. W ostatnim scenariuszu powyżej, jeśli węzeł przestałby działać, platforma wygenerowałaby zdarzenie NodeDown, a wybrane narzędzie do monitorowania mogłoby natychmiast Cię o tym powiadomić. Inne typowe przykłady to ApplicationUpgradeRollbackStarted lub PartitionReconfigured podczas przełączenia awaryjnego. Te same zdarzenia są dostępne w klastrach systemów Windows i Linux.
Zdarzenia są wysyłane za pośrednictwem kanałów standardowych w systemach Windows i Linux i mogą być odczytywane przez dowolne narzędzie do monitorowania, które je obsługuje. Rozwiązanie usługi Azure Monitor to dzienniki usługi Azure Monitor. Możesz dowiedzieć się więcej o naszej integracji dzienników usługi Azure Monitor, która obejmuje niestandardowy pulpit operacyjny dla klastra oraz kilka przykładowych zapytań, na podstawie których można tworzyć alerty. Więcej zagadnień związanych z monitorowaniem klastra jest dostępnych w sekcji Generowanie zdarzeń i dzienników na poziomie platformy.
Monitorowanie kondycji
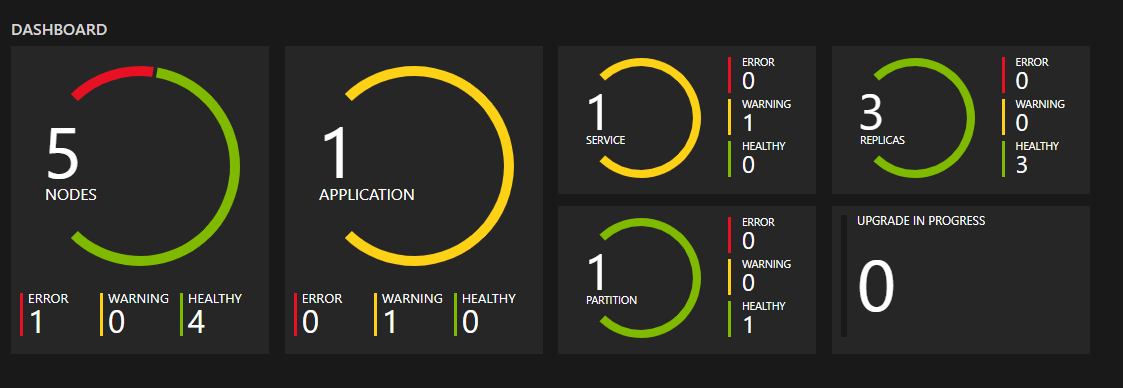
Platforma Service Fabric zawiera model kondycji, który zapewnia rozszerzone raportowanie kondycji dla stanu jednostek w klastrze. Każdy węzeł, aplikacja, usługa, partycja, replika lub wystąpienie ma stale aktualizowalny stan kondycji. Stan kondycji może mieć wartość "OK", "Ostrzeżenie" lub "Błąd". Zdarzenia Service Fabric można traktować jak czasowniki wykonywane przez klaster na różnych elementach, a kondycję każdego elementu jak przymiotnik. Za każdym razem, gdy stan danej encji ulegnie zmianie, zostanie również wygenerowane zdarzenie. Dzięki temu możesz skonfigurować zapytania i alerty dotyczące zdarzeń kondycji w wybranym narzędziu do monitorowania, podobnie jak w przypadku każdego innego zdarzenia.
Ponadto umożliwiamy użytkownikom nawet nadpisywanie wartości zdrowia encji. Jeśli aplikacja jest w trakcie uaktualniania, a testy walidacyjne kończą się niepowodzeniem, możesz zgłosić do Service Fabric Health za pomocą interfejsu Health API, że aplikacja nie jest już zdrowa, a usługa Service Fabric automatycznie wycofa uaktualnienie! Aby dowiedzieć się więcej o modelu kondycji, zapoznaj się z wprowadzeniem do monitorowania kondycji w usłudze Service Fabric
Watchdogs
Zazwyczaj watchdog to oddzielna usługa, która monitoruje stan i obciążenie we wszystkich usługach, wysyła żądania ping do punktów końcowych i zgłasza nieoczekiwane problemy ze stanem w klastrze. Może to pomóc w zapobieganiu błędom, które mogą nie być wykrywane tylko na podstawie wydajności pojedynczej usługi. Watchdogi to również dobre miejsce do umieszczania kodu wykonującego działania naprawcze, które nie wymagają interakcji użytkownika, takie jak czyszczenie plików logów w pamięci masowej w określonych odstępach czasu. Jeśli szukasz w pełni zaimplementowanej usługi watchdog typu open source dla usługi Service Fabric, która zawiera łatwy w użyciu model rozszerzania usługi watchdog i działa zarówno w klastrach systemu Windows, jak i Linux, zobacz projekt FabricObserver. FabricObserver to oprogramowanie gotowe do produkcji. Zachęcamy do wdrożenia FabricObserver w klastrach testowych i produkcyjnych oraz do dostosowywania go do swoich potrzeb — zarówno za pomocą modelu wtyczek, jak i przez utworzenie jego własnego rozgałęzienia i napisanie własnych wbudowanych obserwatorów. Poprzednie (wtyczki) jest zalecanym podejściem.
Monitorowanie infrastruktury (wydajności)
Po omówieniu diagnostyki w aplikacji i na platformie jak wiemy, że sprzęt działa zgodnie z oczekiwaniami? Monitorowanie podstawowej infrastruktury jest kluczowym elementem zrozumienia stanu klastra i wykorzystania zasobów. Mierzenie wydajności systemu zależy od wielu czynników, które mogą być subiektywne w zależności od obciążeń. Te czynniki są zwykle mierzone za pomocą liczników wydajności. Te liczniki wydajności mogą pochodzić z różnych źródeł, w tym systemu operacyjnego, platformy .NET Framework lub samej platformy Usługi Service Fabric. Niektóre scenariusze, w których byłyby przydatne, to
- Czy wydajnie używam sprzętu? Czy chcesz korzystać ze swojego sprzętu przy 90% obciążeniu CPU czy przy 10%? Jest to przydatne podczas skalowania klastra lub optymalizowania procesów aplikacji.
- Czy mogę proaktywnie przewidywać problemy z infrastrukturą? — wiele problemów jest poprzedzonych nagłymi zmianami (spadkami) wydajności, dzięki czemu można używać liczników wydajności, takich jak użycie operacji we/wy sieci i procesora CPU w celu proaktywnego przewidywania i diagnozowania problemów.
Listę liczników wydajności, które powinny być zbierane na poziomie infrastruktury, można znaleźć w artykule Metryki wydajności.
Użyj dzienników Azure Monitor do monitorowania zdarzeń na poziomie klastra. Po skonfigurowaniu agenta usługi Azure Monitor i reguł zbierania danych z obszarem roboczym można zbierać następujące dane:
- Metryki wydajności, takie jak wykorzystanie procesora.
- Liczniki wydajności .NET, takie jak użycie procesora na poziomie procesu.
- Liczniki wydajności usługi Service Fabric, takie jak liczba wyjątków zgłaszanych przez usługę Reliable Services.
- Metryki kontenera, takie jak wykorzystanie procesora.
Typy zasobów
Platforma Azure używa koncepcji typów zasobów i identyfikatorów, aby zidentyfikować wszystko w subskrypcji. Typy zasobów są również częścią identyfikatorów zasobów dla każdego zasobu uruchomionego na platformie Azure. Na przykład jednym z typów zasobów dla maszyny wirtualnej jest Microsoft.Compute/virtualMachines. Aby uzyskać listę usług i odpowiadających im typów zasobów, zobacz Dostawcy zasobów.
Usługa Azure Monitor podobnie dzieli podstawowe dane monitorowania na metryki i dzienniki na podstawie typów zasobów, zwanych również przestrzeniami nazw. Różne metryki i dzienniki są dostępne dla różnych typów zasobów. Usługa może być skojarzona z więcej niż jednym typem zasobu.
Aby uzyskać więcej informacji na temat typów zasobów w usłudze Azure Service Fabric, zobacz informacje referencyjne o danych monitorowania usługi Service Fabric.
Magazyn danych
W przypadku usługi Azure Monitor:
- Dane metryk są przechowywane w bazie danych metryk usługi Azure Monitor.
- Dane dziennika są przechowywane w magazynie dzienników usługi Azure Monitor. Log Analytics to narzędzie w witrynie Azure Portal, które może wykonywać zapytania dotyczące tego magazynu.
- Dziennik aktywności platformy Azure to oddzielny magazyn z własnym interfejsem w witrynie Azure Portal.
Opcjonalnie możesz kierować dane metryk i dziennika aktywności do magazynu logów usługi Azure Monitor. Następnie możesz użyć usługi Log Analytics, aby wykonać zapytanie o dane i skorelować je z innymi danymi dziennika.
Wiele usług może używać ustawień diagnostycznych do wysyłania danych metryk i dzienników do innych lokalizacji przechowywania poza usługą Azure Monitor. Przykłady obejmują usługę Azure Storage, hostowane systemy partnerów oraz systemy partnerów spoza platformy Azure przy użyciu usługi Event Hubs.
Aby uzyskać szczegółowe informacje na temat sposobu przechowywania danych przez usługę Azure Monitor, zobacz temat platforma danych usługi Azure Monitor.
Metryki platformy usługi Azure Monitor
Usługa Azure Monitor udostępnia metryki platformy dla wielu usług. Aby uzyskać listę wszystkich metryk, które można zbierać dla wszystkich zasobów w usłudze Azure Monitor, zobacz Obsługiwane metryki w usłudze Azure Monitor.
Ta usługa nie zbiera metryk platformy.
Metryki nieoparte na usłudze Azure Monitor
Ta usługa udostępnia inne metryki, które nie są uwzględnione w bazie danych metryk usługi Azure Monitor.
Metryki systemu operacyjnego gościa
Metryki systemu operacyjnego gościa działającego w węzłach klastra usługi Service Fabric muszą być zbierane za pośrednictwem co najmniej jednego agenta działającego w systemie operacyjnym gościa. Metryki systemu gościa obejmują liczniki wydajności, które monitorują procent użycia procesora przez system gościa lub użycie pamięci; metryki te są często wykorzystywane do automatycznego skalowania lub generowania alertów.
Najlepszym rozwiązaniem jest użycie i skonfigurowanie agenta usługi Azure Monitor w celu wysyłania metryk wydajności systemu operacyjnego gościa za pośrednictwem niestandardowego interfejsu API metryk do bazy danych metryk usługi Azure Monitor. Metryki systemu operacyjnego gościa można wysyłać do dzienników usługi Azure Monitor przy użyciu tego samego agenta. Następnie możesz wykonywać zapytania dotyczące tych metryk i dzienników przy użyciu usługi Log Analytics.
Uwaga
Agent usługi Azure Monitor zastępuje rozszerzenie Diagnostyka Azure i agenta Log Analytics na potrzeby routingu w systemie operacyjnym gościa. Aby uzyskać więcej informacji, zobacz Omówienie agentów usługi Azure Monitor.
Dzienniki zasobów usługi Azure Monitor
Dzienniki zasobów zapewniają wgląd w operacje wykonywane przez zasób platformy Azure. Dzienniki są generowane automatycznie, ale należy skierować je do dzienników usługi Azure Monitor, aby je zapisać lub wysłać do nich zapytanie. Dzienniki są zorganizowane w kategorie. Dana przestrzeń nazw może mieć wiele kategorii dzienników zasobów, które można zebrać.
Ta usługa nie zbiera dzienników zasobów, ale informacje na ich temat można znaleźć w artykule Dane monitorowania z zasobów platformy Azure.
Dzienniki i zdarzenia usługi Service Fabric
Usługa Service Fabric może zbierać następujące dzienniki:
- W przypadku klastrów systemu Windows skonfiguruj monitorowanie klastrów za pomocą agenta Azure Monitor i reguł zbierania danych.
- W przypadku klastrów systemu Linux dzienniki usługi Azure Monitor są również zalecanym narzędziem do monitorowania platformy Azure i infrastruktury. Diagnostyka platformy systemu Linux wymaga innej konfiguracji. Aby uzyskać więcej informacji, zobacz Zdarzenia klastra systemu Linux w usłudze Service Fabric w dzienniku Syslog.
- Agent usługi Azure Monitor można skonfigurować tak, aby wysyłał dzienniki systemu operacyjnego gościa do dzienników usługi Azure Monitor, w których można wykonywać zapytania za pomocą usługi Log Analytics.
- Możesz zapisywać dzienniki kontenera Service Fabric w stdout lub stderr, aby były dostępne w Azure Monitor Logs.
- Możesz skonfigurować rozwiązanie do monitorowania kontenerów w usłudze Azure Monitor Logs, aby wyświetlać zdarzenia kontenerów.
Inne rozwiązania do logowania
Chociaż oba zalecane przez nas rozwiązania, dzienniki usługi Azure Monitor i Application Insights, mają wbudowaną integrację z usługą Service Fabric, wiele zdarzeń jest zapisywanych za pośrednictwem dostawców ETW i można je rozszerzyć o inne rozwiązania do rejestrowania. Należy również przyjrzeć się platformie Elastic Stack (zwłaszcza jeśli rozważasz uruchomienie klastra w środowisku offline), Dynatrace lub dowolnej innej platformie, którą preferujesz. Listę zintegrowanych partnerów można znaleźć w artykule Partnerzy monitorowania usługi Azure Service Fabric.
Kluczowe kwestie dla dowolnej wybranej platformy powinny obejmować, jak wygodne jest korzystanie z interfejsu użytkownika, możliwości wykonywania zapytań, dostępnych wizualizacji niestandardowych i pulpitów nawigacyjnych oraz dodatkowych narzędzi, które zapewniają w celu ulepszenia środowiska monitorowania.
Dziennik aktywności platformy Azure
Dziennik aktywności zawiera zdarzenia na poziomie subskrypcji, które śledzą operacje dla każdego zasobu platformy Azure widoczne spoza tego zasobu; na przykład utworzenie nowego zasobu lub uruchomienie maszyny wirtualnej.
Zbieranie: Zdarzenia dziennika aktywności są generowane automatycznie i gromadzone w oddzielnym magazynie do wyświetlania w portalu Azure.
Routing: Możesz wysyłać dane dziennika aktywności do dzienników usługi Azure Monitor, aby analizować je wraz z innymi danymi dzienników. Dostępne są również inne lokalizacje, takie jak Azure Storage, Azure Event Hubs i niektórzy partnerzy monitorowania firmy Microsoft. Aby uzyskać więcej informacji na temat tego, jak kierować dziennik aktywności, zobacz Omówienie dziennika aktywności platformy Azure.
Analizowanie danych monitorowania
Istnieje wiele narzędzi do analizowania danych monitorowania.
Narzędzia usługi Azure Monitor
Usługa Azure Monitor obsługuje następujące podstawowe narzędzia:
Eksplorator metryk — narzędzie w portalu Azure, które umożliwia wyświetlanie i analizowanie metryk zasobów platformy Azure. Aby uzyskać więcej informacji, zobacz Analizowanie metryk za pomocą eksploratora metryk usługi Azure Monitor.
Log Analytics — narzędzie w portalu Azure, które umożliwia wykonywanie zapytań względem danych dziennika i analizowanie ich przy użyciu języka zapytań Kusto (KQL). Aby uzyskać więcej informacji, zobacz Rozpocznij pracę z zapytaniami dzienników w usłudze Azure Monitor.
Dziennik aktywności, który ma interfejs użytkownika w portalu Azure do wyświetlania i podstawowego przeszukiwania. Aby przeprowadzić bardziej szczegółową analizę, musisz kierować dane do dzienników usługi Azure Monitor i uruchamiać bardziej złożone zapytania w usłudze Log Analytics.
Narzędzia, które umożliwiają bardziej złożoną wizualizację, obejmują:
- Pulpity, które umożliwiają łączenie różnych rodzajów danych w jednym widoku w portalu Azure.
- Skoroszyty, raporty, które można dostosować i tworzyć w portalu Azure. Skoroszyty mogą zawierać tekst, metryki i zapytania dziennika.
- Grafana, otwarte narzędzie platformowe, które doskonale sprawdza się w pulpitach operacyjnych. Za pomocą narzędzia Grafana można tworzyć pulpity nawigacyjne zawierające dane z wielu źródeł innych niż usługa Azure Monitor.
- Power BI, usługa analityki biznesowej, która udostępnia interaktywne wizualizacje w oparciu o różne źródła danych. Usługę Power BI można skonfigurować tak, aby automatycznie importować dane dziennika z usługi Azure Monitor, aby korzystać z tych wizualizacji.
Przegląd typowych scenariuszy analizy monitorowania w usłudze Service Fabric znajduje się w artykule Diagnozowanie typowych scenariuszy w usłudze Service Fabric.
Narzędzia eksportu usługi Azure Monitor
Dane z usługi Azure Monitor można pobrać do innych narzędzi przy użyciu następujących metod:
Metryki: Użyj interfejsu REST API metryk, aby wyodrębniać dane dotyczące metryk z bazy danych metryk usługi Azure Monitor. Interfejs API obsługuje wyrażenia filtrów w celu uściślinia pobranych danych. Aby uzyskać więcej informacji, zobacz informacje referencyjne dotyczące interfejsu API REST usługi Azure Monitor.
Dzienniki: Użyj interfejsu API REST lub powiązanych bibliotek klienckich.
Inną opcją jest eksport danych obszaru roboczego.
Aby rozpocząć pracę z interfejsem API REST usługi Azure Monitor, zobacz Przewodnik po interfejsie API REST usługi Azure Monitor.
Zapytania usługi Kusto
Dane monitorowania można analizować w magazynie Azure Monitor Logs / Log Analytics za pomocą języka zapytań Kusto (KQL).
Ważne
Po wybraniu pozycji Dzienniki z menu usługi w portalu zostanie otwarte narzędzie Log Analytics z zakresem zapytania ustawionym na bieżącą usługę. Ten zakres oznacza, że zapytania dziennika będą zawierać tylko dane z tego typu zasobu. Jeśli chcesz uruchomić zapytanie zawierające dane z innych usług platformy Azure, wybierz pozycję Dzienniki z menu usługi Azure Monitor . Aby uzyskać szczegółowe informacje, zobacz Zakres zapytań dzienników i zakres czasu w usłudze Azure Monitor Log Analytics.
Aby uzyskać listę typowych zapytań dla dowolnej usługi, zobacz interfejs zapytań usługi Log Analytics.
Przykładowe zapytania
Następujące zapytania zwracają zdarzenia usługi Service Fabric, w tym akcje wykonywane na węzłach. Informacje o innych przydatnych zapytaniach znajdziesz w artykule Service Fabric Events.
Zwracanie zdarzeń operacyjnych zarejestrowanych w ostatniej godzinie:
ServiceFabricOperationalEvent
| where TimeGenerated > ago(1h)
| join kind=leftouter ServiceFabricEvent on EventId
| project EventId, EventName, TaskName, Computer, ApplicationName, EventMessage, TimeGenerated
| sort by TimeGenerated
Zwróć raporty stanu z wartością HealthState == 3 (Error) i wyodrębnij więcej właściwości z pola EventMessage:
ServiceFabricOperationalEvent
| join kind=leftouter ServiceFabricEvent on EventId
| extend HealthStateId = extract(@"HealthState=(\S+) ", 1, EventMessage, typeof(int))
| where TaskName == 'HM' and HealthStateId == 3
| extend SourceId = extract(@"SourceId=(\S+) ", 1, EventMessage, typeof(string)),
         Property = extract(@"Property=(\S+) ", 1, EventMessage, typeof(string)),
         HealthState = case(HealthStateId == 0, 'Invalid', HealthStateId == 1, 'Ok', HealthStateId == 2, 'Warning', HealthStateId == 3, 'Error', 'Unknown'),
         TTL = extract(@"TTL=(\S+) ", 1, EventMessage, typeof(string)),
         SequenceNumber = extract(@"SequenceNumber=(\S+) ", 1, EventMessage, typeof(string)),
         Description = extract(@"Description='([\S\s, ^']+)' ", 1, EventMessage, typeof(string)),
         RemoveWhenExpired = extract(@"RemoveWhenExpired=(\S+) ", 1, EventMessage, typeof(bool)),
         SourceUTCTimestamp = extract(@"SourceUTCTimestamp=(\S+)", 1, EventMessage, typeof(datetime)),
         ApplicationName = extract(@"ApplicationName=(\S+) ", 1, EventMessage, typeof(string)),
         ServiceManifest = extract(@"ServiceManifest=(\S+) ", 1, EventMessage, typeof(string)),
         InstanceId = extract(@"InstanceId=(\S+) ", 1, EventMessage, typeof(string)),
         ServicePackageActivationId = extract(@"ServicePackageActivationId=(\S+) ", 1, EventMessage, typeof(string)),
         NodeName = extract(@"NodeName=(\S+) ", 1, EventMessage, typeof(string)),
         Partition = extract(@"Partition=(\S+) ", 1, EventMessage, typeof(string)),
         StatelessInstance = extract(@"StatelessInstance=(\S+) ", 1, EventMessage, typeof(string)),
         StatefulReplica = extract(@"StatefulReplica=(\S+) ", 1, EventMessage, typeof(string))
Pobierz zdarzenia operacyjne usługi Service Fabric zagregowane przy użyciu określonej usługi i węzła:
ServiceFabricOperationalEvent
| where ApplicationName  != "" and ServiceName != ""
| summarize AggregatedValue = count() by ApplicationName, ServiceName, Computer
Powiadomienia
Alerty usługi Azure Monitor proaktywnie powiadamiają o znalezieniu określonych warunków w danych monitorowania. Alerty umożliwiają identyfikowanie i rozwiązywanie problemów w systemie przed ich zauważeniem przez klientów. Aby uzyskać więcej informacji, zobacz alerty usługi Azure Monitor.
Istnieje wiele źródeł typowych alertów dotyczących zasobów platformy Azure. Przykłady typowych alertów dla zasobów platformy Azure można znaleźć w artykule Przykładowe zapytania alertów dziennika. Witryna Azure Monitor Baseline Alerts (AMBA) oferuje częściowo zautomatyzowaną metodę wdrażania ważnych alertów dotyczących metryk platformy, pulpitów i wytycznych. Witryna ma zastosowanie do stale powiększającego się podzestawu usług platformy Azure, w tym wszystkich usług, które są częścią strefy docelowej platformy Azure (ALZ).
Wspólny schemat alertów standaryzuje sposób korzystania z powiadomień o alertach usługi Azure Monitor. Aby uzyskać więcej informacji, zobacz wspólny schemat alertów.
Typy alertów
Możesz otrzymywać alerty dotyczące dowolnej metryki lub źródła danych dziennika na platformie danych usługi Azure Monitor. Istnieje wiele różnych typów alertów w zależności od usług, które monitorujesz i zbieranych danych monitorowania. Różne typy alertów mają różne zalety i wady. Aby uzyskać więcej informacji, zobacz Wybierz odpowiedni typ alertu monitorowania.
Poniższa lista zawiera opis typów alertów usługi Azure Monitor, które można utworzyć:
- Alerty metryczne oceniają metryki zasobów w regularnych odstępach czasu. Metryki mogą być metrykami platformy, metrykami niestandardowymi, dziennikami z usługi Azure Monitor przekonwertowanym na metryki lub metrykami usługi Application Insights. Alerty metryk mogą również uwzględniać wiele warunków i dynamiczne progi.
- Alerty dzienników pozwalają użytkownikom używać zapytania usługi Log Analytics do oceniania dzienników zasobów z określoną wcześniej częstotliwością.
- Alerty dziennika aktywności są wyzwalane, gdy wystąpi nowe zdarzenie dziennika aktywności, które odpowiada zdefiniowanym warunkom. Alerty usługi Resource Health i alerty usługi Service Health to alerty dziennika aktywności, które zgłaszają kondycję usługi i zasobów.
Niektóre usługi platformy Azure obsługują także alerty inteligentnego wykrywania, alerty Prometheus lub zalecane reguły alertów.
W przypadku niektórych usług można monitorować na dużą skalę, stosując tę samą regułę alertu metryk do wielu zasobów tego samego typu znajdujących się w tym samym regionie platformy Azure. Poszczególne powiadomienia są wysyłane dla każdego monitorowanego zasobu. Aby uzyskać informacje o obsługiwanych usługach i chmurach platformy Azure, zobacz Monitorowanie wielu zasobów za pomocą jednej reguły alertu.
Reguły alertów usługi Service Fabric
W poniższej tabeli wymieniono niektóre reguły alertów dla usługi Service Fabric. Te alerty są tylko przykładami. Alerty można skonfigurować dla dowolnej metryki, wpisu dziennika lub wpisu dziennika aktywności wymienionych w informacjach referencyjnych dotyczących danych monitorowania usługi Service Fabric lub na liście zdarzeń usługi Service Fabric.
| Typ alertu | Warunek | Opis |
|---|---|---|
| Zdarzenie węzła | Węzeł ulegnie awarii | ServiceFabricOperationalEvent gdzie EventID >= 25622 i EventID <= 25626. Te identyfikatory zdarzeń znajdują się w informacjach referencyjnych dotyczących zdarzeń węzła. |
| Zdarzenie aplikacji | Cofnięcie aktualizacji aplikacji | ServiceFabricOperationalEvent, gdzie EventID == 29623 lub EventID == 29624. Te identyfikatory zdarzeń można znaleźć w informacjach referencyjnych dotyczących zdarzeń aplikacji. |
| Kondycja zasobów | Usługa aktualizacji nieosiągalna/niedostępna | Klaster przechodzi do stanu UpgradeServiceUnreachable. |
Zalecenia doradcy
W przypadku niektórych usług, jeśli podczas operacji na zasobach wystąpią krytyczne warunki lub nadchodzące zmiany, w portalu na stronie usługi Overview zostanie wyświetlony alert. Więcej informacji i zalecane sposoby rozwiązania alertu można znaleźć w Zaleceniach usługi Advisor w sekcji Monitorowanie w menu po lewej stronie. Podczas normalnych operacji nie są wyświetlane żadne zalecenia doradcy.
Aby uzyskać więcej informacji o usłudze Azure Advisor, zobacz Omówienie usługi Azure Advisor.
Zalecana konfiguracja
Teraz, po przejściu do każdego obszaru monitorowania i przykładowych scenariuszy, poniżej przedstawiono podsumowanie narzędzi do monitorowania platformy Azure i skonfigurowanie potrzebne do monitorowania wszystkich powyższych obszarów.
- Monitorowanie aplikacji przy użyciu Application Insights
- Monitorowanie klastra przy użyciu Azure Monitor agenta i reguł zbierania danych.
- Monitorowanie infrastruktury przy użyciu Azure Monitor agenta i reguł zbierania danych.
Powiązana zawartość
- Zobacz dokument referencyjny danych monitorowania usługi Service Fabric, aby uzyskać informacje referencyjne dotyczące metryk, dzienników i innych ważnych wartości tworzonych dla usługi Service Fabric.
- Zobacz Monitorowanie zasobów platformy Azure za pomocą usługi Azure Monitor, aby uzyskać ogólne informacje na temat monitorowania zasobów platformy Azure.
- Zobacz listę zdarzeń usługi Service Fabric.