Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Note
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
O Pesquisa de IA do Azure suporta dois modelos de preços, cada um desenhado para diferentes padrões de carga de trabalho:
Dedicado: Preço fixo medido por Unidades de Pesquisa (SUs). Selecionas um nível de serviço e és faturado à hora com base nas unidades provisionadas.
Serverless (pré-visualização): Preços com base no consumo, medidos em Unidades de Cálculo por hora (UC/h) e por GB por mês para armazenamento indexado.
Importante
O nível Serverless Developer está atualmente em pré-visualização. Esta pré-visualização é fornecida sem um acordo de nível de serviço e não é recomendada para cargas de trabalho em produção. Certas funcionalidades podem não ser suportadas ou podem ter capacidades limitadas. Para mais informações, consulte Termos Suplementares de Utilização para Microsoft Azure Previews.
A faturação do escalão Serverless Developer teve início em 13 de setembro de 2026. As cobranças pelo uso a partir dessa data aparecem na sua fatura Azure. Não é cobrado pelo uso antes de 13 de setembro de 2026.
A camada Serverless Developer não suporta migração para ou de outras categorias de preços e algumas funcionalidades disponíveis noutros níveis não são suportadas durante a Pré-visualização Pública. Os limites de serviço, funcionalidades suportadas e detalhes de preços podem mudar antes da disponibilidade geral.
Durante a pré-visualização, o modelo de preços Serverless é suportado apenas em regiões específicas.
Para mais informações sobre diferenças entre modelo de preços e nível de serviço, consulte Escolha um modelo de preços e um nível de serviço.
Como o custo é determinado no modelo Serverless
Os modelos de preços Dedicated e Serverless contabilizam o trabalho no serviço de pesquisa de forma diferente. Os serviços dedicados executam consultas, indexação e processamento de resultados em capacidade provisionada que já adquiriste. Os serviços serverless medem a computação, memória e I/O de disco que estas operações consomem e convertem esse uso em Unidades de Cálculo (CUs). Como resultado, a otimização de desempenho afeta diretamente o custo do Serverless.
Os custos da computação serverless dependem da execução da carga de trabalho:
- Consultas e indexação consomem computação, medida em Unidades de Cálculo por hora (/h).
- Os índices ativos consomem computação com base no uso de recursos e no tempo que permanecem ativos.
- Um índice mantém-se ativo durante 10 minutos após a sua última consulta ou pedido de indexação antes de ficar inativo.
- Índices inativos não têm custo mínimo ou reservado de computação. A utilização de computação para índices inativos é reduzida para zero. Não existe uma carga mínima de cálculo quando um índice está inativo.
- O armazenamento é faturado separadamente com base no tamanho do índice no disco e continua independentemente de um índice estar em uso ou não.
- A recuperação agêntica consome recursos de computação para consultas de pesquisa e para a orquestração efetuada no serviço de pesquisa.
As taxas de armazenamento só param quando apagas o índice.
Para ver a divisão de custos e as taxas de utilização para o seu ciclo de faturação atual, consulte o separador Escala + Custo no seu portal Azure.
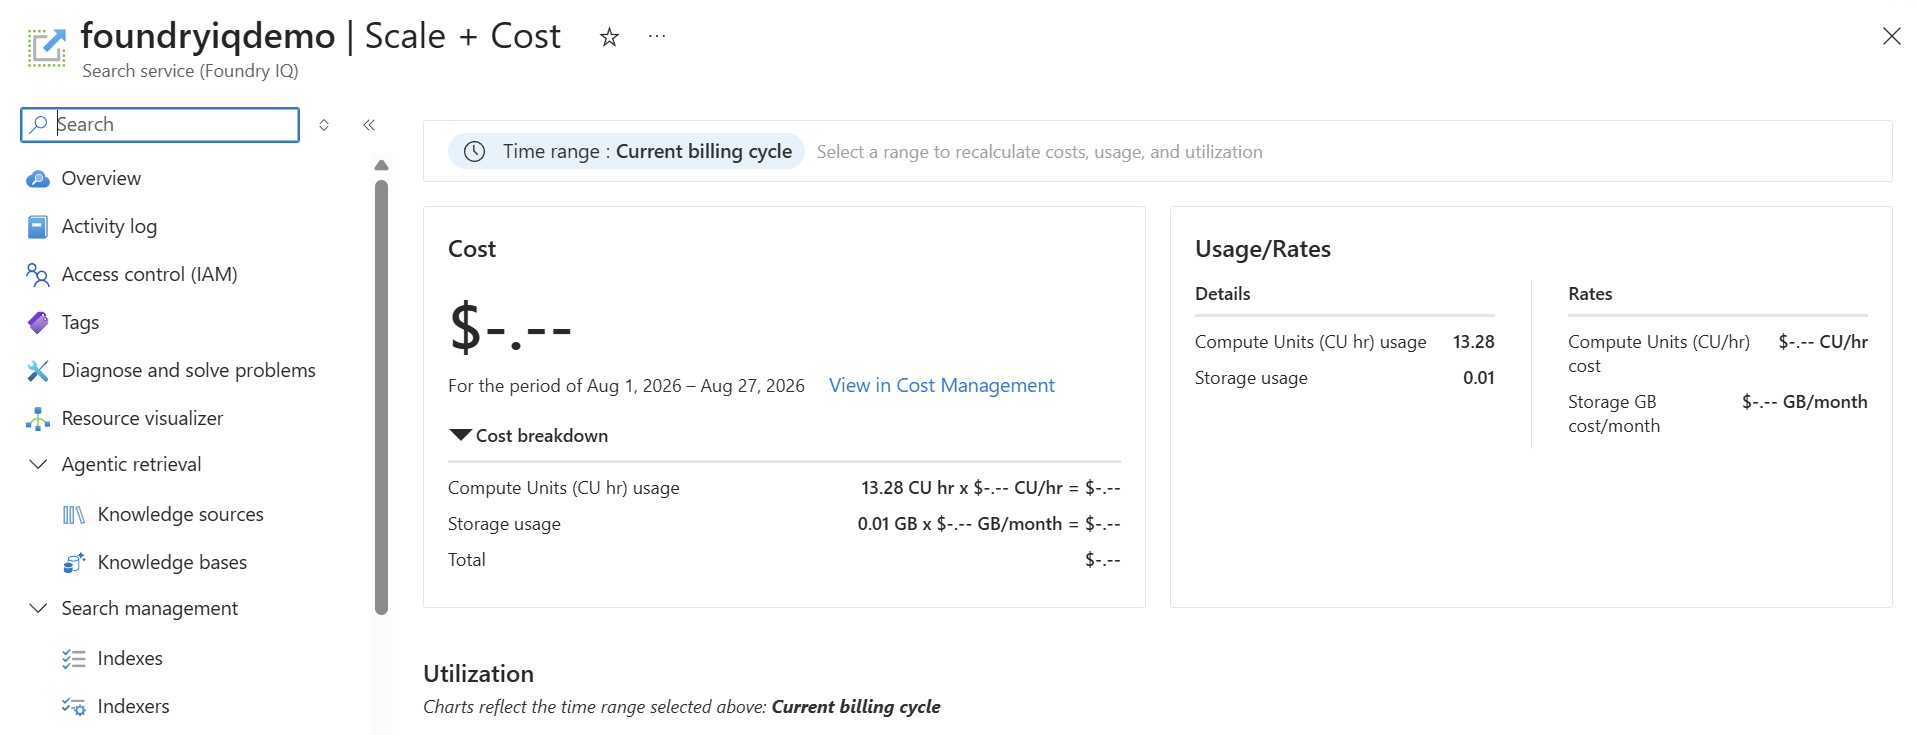
Como o tamanho do índice afeta a utilização do cálculo
Enquanto um índice está ativo, o Pesquisa de IA do Azure avalia dois recursos finitos para determinar o seu uso computacional:
- Tamanho total do índice: O espaço total que o índice ocupa no disco, incluindo texto, metadados e vetores.
- Tamanho do índice vetorial: A memória usada pelo índice vetorial. A memória é mais exigente em recursos do que o disco, pelo que o tamanho do índice vetorial tem um peso maior quando convertido para CUs.
O Pesquisa de IA do Azure não soma em conjunto os dois montantes de CU resultantes. A utilização de computação baseia-se no montante que for mais elevado. Por exemplo, o tamanho do índice vetorial pode determinar a utilização do cálculo mesmo quando o tamanho total do índice no disco é relativamente pequeno.
Para reduzir a utilização de computação do índice ativo, identifique qual o recurso que gera a maior quantidade de CU. Depois reduz o tamanho total do índice, o tamanho do índice vetorial, ou ambos. O armazenamento indexado continua a ser uma taxa separada por GB/mês.
O modelo de preços Serverless é mais rentável para cargas de trabalho com tráfego variável, intermitente ou imprevisível, onde a capacidade provisionada seria subutilizada.
Importante
As cobranças de CU sem servidor abrangem o trabalho realizado no serviço de pesquisa, incluindo consultas, indexação, processamento de resultados e orquestração da recuperação por agentes. Chamadas de modelo e outros trabalhos realizados fora do serviço de pesquisa continuam a utilizar os seus contadores de faturação existentes. Exemplos incluem classificação semântica, reescrita de consultas agenticas, extração de imagem e execução de competências.
Compreender Unidades de Computação (CUs)
Uma Unidade de Computação () representa os recursos medidos do sistema necessários para realizar operações de pesquisa e indexação no modelo Serverless. O custo da unidade de computação (CU) é determinado principalmente pela utilização da CPU, da memória e da E/S e, secundariamente, pela dimensão do índice e da carga útil do documento, sendo a utilização faturada como Unidade de Computação por hora (CU/h).
O custo de computação varia em função de:
- Complexidade da consulta
- Tamanho do índice (GB) e estrutura
- Tamanho da carga útil (KB) do documento
- Número de campos e resultados recuperados
Diferentes operações têm perfis de custos distintos:
- Consulta: De baixo custo. Recuperar um único documento pelo seu ID é a operação mais eficiente.
- Pesquisa por palavras-chave: Baixo custo. A pesquisa de texto utiliza índices invertidos, otimizados para velocidade e baixo uso de computação.
- Pesquisa vetorial: Alto custo. As consultas vetoriais são computacionalmente dispendiosas porque exigem cálculos de similaridade entre embeddings de alta dimensão. Comparados com a pesquisa por palavras-chave, consomem significativamente mais computação.
- Pesquisa híbrida: Combina o custo da pesquisa por palavras-chave e da pesquisa vetorial, uma vez que ambos os pipelines são executados para cada consulta, além de uma pequena sobrecarga adicional da Reciprocal Rank Fusion (RRF) para combinar os resultados.
Monitorizar a utilização de computação
Monitorizar o consumo de computação ajuda-o a identificar operações dispendiosas, otimizar padrões de consulta e estimar custos. O custo em Unidade de Computação (CU) de cada pedido é devolvido no cabeçalho de resposta HTTP x-ms-azs-compute-units-consumed sob a forma de um número em vírgula flutuante. Use este cabeçalho para identificar operações dispendiosas e otimizar padrões de consulta. Pode acompanhar o custo em CU de cada pedido ao inspecionar os cabeçalhos de resposta HTTP e os eventos de operação no Azure Monitor. Para mais orientações sobre os tipos de dados de monitorização disponíveis e métodos para analisar esses dados, consulte Monitor Pesquisa de IA do Azure.
-
Cabeçalho:
x-ms-azs-compute-units-consumed: <value> - Valor: Um número em ponto flutuante que representa as CUs consumidas.
Example:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
Neste exemplo, o pedido consumiu 12,45 unidades de cálculo. Pode usar este valor para identificar operações de alto custo e comparar o custo relativo de diferentes padrões de consulta.
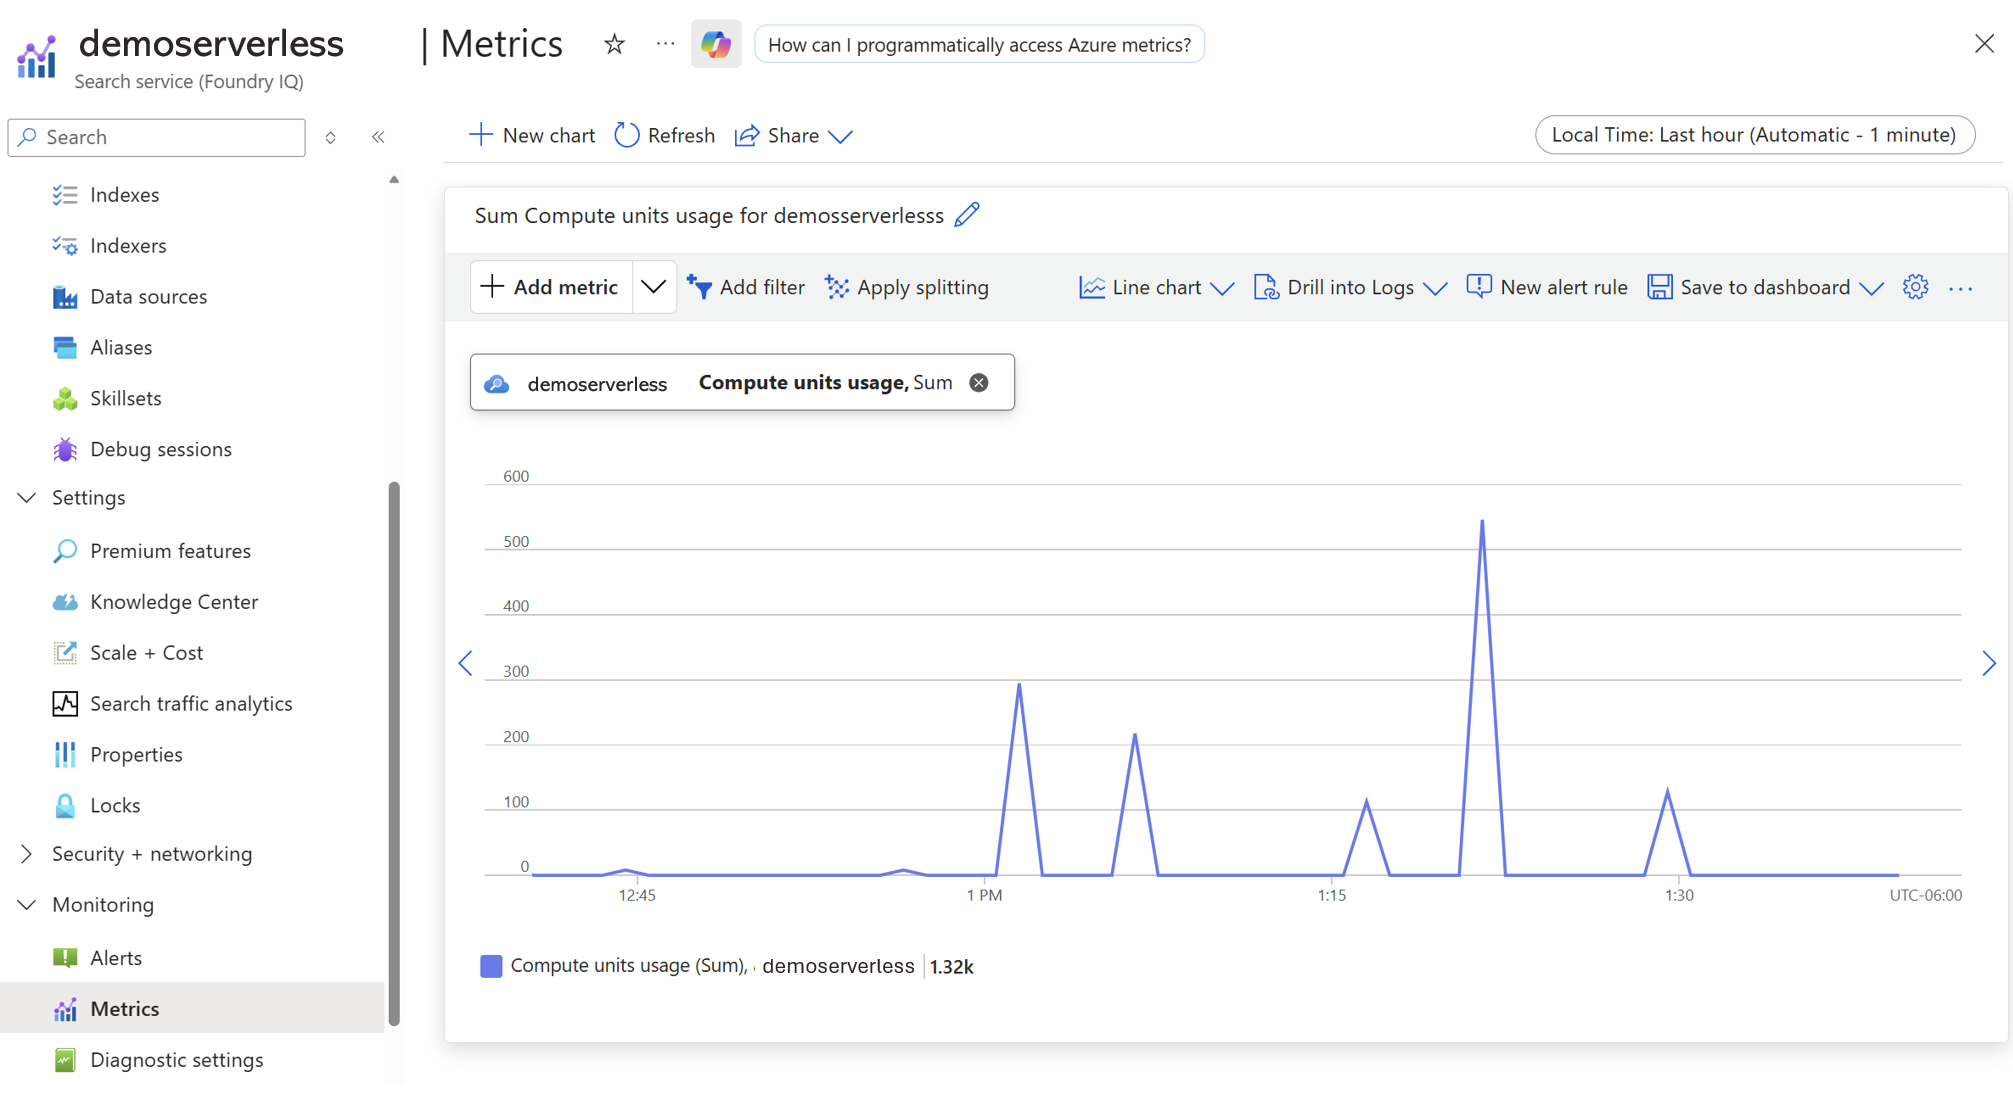
Para rever o consumo histórico de computação de um serviço de pesquisa serverless, utilize as métricas do Azure Monitor no portal Azure:
- Aceda ao serviço de busca.
- Selecione Métricas.
- Selecionar + Adicionar métrica.
- Da lista de métricas, selecione Computar unidades de uso.
- Use o gráfico para analisar tendências de utilização e identificar períodos de aumento do consumo computacional.
Monitorizar o uso agregado ajuda-o a compreender os custos globais do serviço e a identificar cargas de trabalho que consomem mais recursos computacionais. Para descrições das métricas de monitorização disponíveis, consulte Referência de Dados de Monitorização. Pode utilizar os registos do Azure Monitor para monitorizar a utilização agregada de CU ao longo do tempo e correlacioná-la com o volume de consultas e as alterações na carga de trabalho.
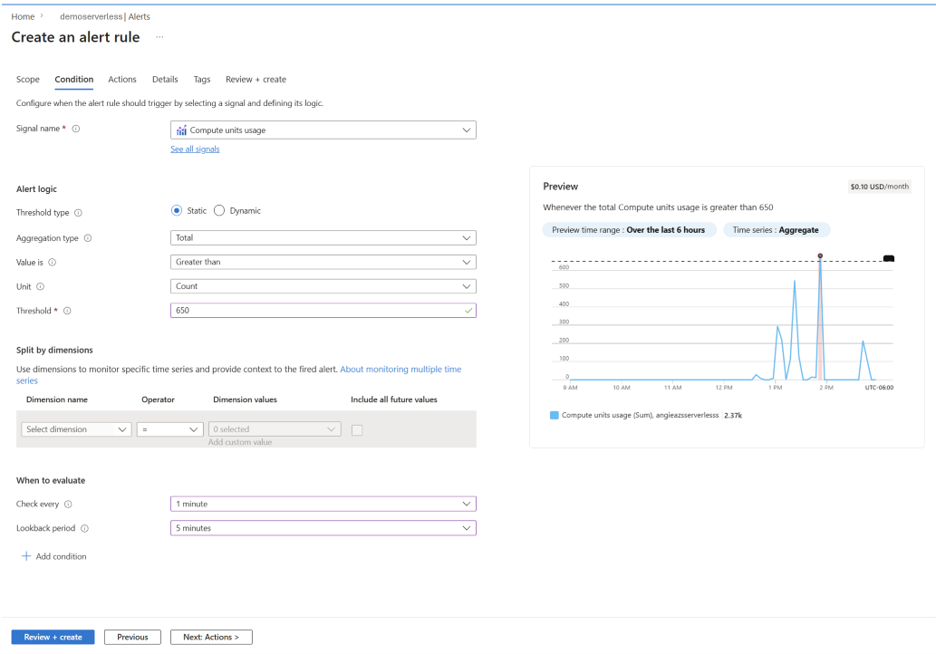
Configurar alertas para utilização de computação
Pode criar uma regra de alerta para ser notificado quando o consumo de cálculo atingir um limiar especificado no portal Azure.
- Vá a Alertas no seu serviço de pesquisa.
- Selecione + Criar regra de alerta.
- Em Condição, escolha utilização das unidades de computação como sinal.
- Defina a lógica do alerta. Por exemplo, ativar quando o uso total é superior a um valor especificado.
- Configure Ações, como email, SMS ou notificações de webhook.
- Conclua os passos restantes e selecione Rever + criar.
Os alertas ajudam-no a responder proativamente a picos inesperados de utilização e a gerir custos.
Estimar custos sem servidor
A calculadora de preços do Azure e as orientações de planeamento de capacidade baseadas em unidades de pesquisa (SU) não se aplicam a serviços que utilizam o modelo de preços sem servidor.
Para estimar os custos do serverless:
- Dados amostrais representativos do índice.
- Executa cargas de trabalho típicas de indexação e consulta.
- Regista o
x-ms-azs-compute-units-consumedvalor devolvido para cada operação. - Use métricas do Azure Monitor para medir o uso agregado ao longo do tempo.
- Extrapola custos com base no tráfego de produção esperado.
Use o separador Escala + Custo no portal do Azure para ver o seu consumo atual e estimar custos.
Como o mesmo pedido executado contra os mesmos dados geralmente produz um consumo computacional semelhante, cargas de trabalho representativas podem fornecer uma base fiável para a estimativa de custos.
A utilização de serverless é medida continuamente e agregada para efeitos de faturação. O consumo de computação é monitorizado ao longo de cada minuto e emitido apenas quando os recursos de computação são utilizados.
Ao estimar custos, utilize valores de cobrança por pedido para compreender o custo das operações individuais e métricas do Azure Monitor para compreender os padrões globais de consumo de serviços.
Use ambas as fontes de dados em conjunto para compreender os custos: os dados de cobrança por pedido ajudam a avaliar operações individuais, enquanto as métricas do Azure Monitor ajudam a compreender o consumo agregado de serviços ao longo do tempo. Para uma visão completa dos custos, considere também as funcionalidades que são faturadas separadamente das Unidades de Cálculo.
A faturação baseia-se no uso agregado de computação em vez de pedidos individuais. A utilização é medida em intervalos de um minuto e arredondada ao múltiplo de 0,25 CU por minuto mais próximo. Estes intervalos de utilização de um minuto acumulam-se ao longo de uma hora para determinar a quantidade faturável em CU/hora. Internamente, a utilização é agregada de milésimos de unidade de computação (mCU) em unidades de computação (CU) e convertida na utilização horária comunicada para faturação.
Diferentes operações consomem diferentes quantidades de cálculo. Em geral:
- As pesquisas por palavras-chave normalmente utilizam menos recursos computacionais.
- As pesquisas vetoriais normalmente consomem mais recursos computacionais do que as pesquisas por palavras-chave.
- As pesquisas híbridas combinam execução por palavras-chave e pesquisa vetorial, pelo que normalmente consomem mais recursos computacionais do que qualquer uma das técnicas isoladamente.
O consumo real de computação depende de fatores como complexidade da consulta, tamanho do índice, volume de dados, configuração vetorial e número de resultados retornados. Monitorizar as cobranças de pedidos e métricas agregadas de utilização pode ajudá-lo a identificar oportunidades de otimização e a prever melhor os custos de produção.
Reduzir os custos de computação através da otimização
Consultas eficientes e design de índices reduzem o consumo de computação e reduzem os custos.
Otimize o seu esquema
O seu esquema de índice determina os custos de computação e armazenamento de base:
- Limite os atributos do campo: Ative apenas os atributos (pesquisáveis, filtráveis, utilizáveis em facetas, ordenáveis) quando necessário. Cada atributo aumenta o tamanho do índice e o custo de indexação.
- Simplificar tipos complexos: Mapeie estruturas JSON aninhadas para campos ou coleções simples sempre que possível.
-
Defina retrievable=false para campos usados apenas para filtragem ou ordenação: Se um campo for usado para filtragem ou ordenação, mas não precisar de ser devolvido nos resultados, mantenha-o indexado e defina
retrievable=falsepara reduzir o armazenamento em disco e o custo de armazenamento por GB/mês. - Use campos apenas recuperáveis sempre que possível: Por exemplo, campos usados apenas para exibição (como URLs de imagens) não devem ser pesquisáveis.
- Reduzir as dimensões vetoriais: Vetores de dimensão superior aumentam o custo de armazenamento e consulta. Utilize modelos de incorporação mais pequenos ou quantização, quando adequado.
- Minimizar o tamanho da carga útil do documento antes de indexar: Documentos maiores custam mais a indexar. Remova campos desnecessários, corte texto longo e remova o HTML antes de enviar documentos para o índice.
Otimizar pedidos de indexação
A forma como envia dados para o índice afeta tanto o custo como o rendimento:
Use lotes maiores sempre que possível: A indexação por lote reduz a sobrecarga por pedido ao amortizar os custos de rede e processamento em mais documentos. Em geral, lotes de até ~1.000 documentos ou ~16 MB são mais eficientes em termos de CU do que muitos pedidos pequenos. No entanto, o tamanho ideal do lote depende da tua carga de trabalho. Teste para equilibrar a taxa de transferência, a latência e a fiabilidade.
Indexe apenas dados novos ou alterados: Evite a reindexação total sempre que possível. Enviar apenas adições e atualizações reduz o número de documentos processados, reduzindo o custo de computação e melhorando a velocidade de ingestão.
Evite a extração de imagens, a menos que seja necessário: A extração de imagem acrescenta trabalho extra de processamento e pode tornar-se um fator de custos separado. Ative-o apenas para documentos ou fluxos de trabalho que realmente necessitem de conteúdo de imagens.
Tenha em conta o crescimento do tamanho dos índices: Sempre que possível, crie índices mais pequenos. À medida que um índice cresce, os custos de indexação aumentam porque é necessário armazenar e manter mais dados, e as operações exigem mais cálculo. Para conjuntos de dados muito grandes, considere particionar dados em múltiplos índices para ajudar a gerir o desempenho e os custos. Embora os custos aumentem com o tamanho do índice, o aumento é sublinear. Índices maiores custam mais por operação, mas não proporcionalmente mais.
Para mais orientações, consulte Dicas para melhor desempenho em Pesquisa de IA do Azure.
Otimizar as operações do indexador
O uso de computação do indexador serverless depende do trabalho realizado durante cada execução do indexador. Para fontes orientadas a linhas, use o número de documentos processados como indicador do volume de carga de trabalho. Para fontes baseadas em ficheiros como Armazenamento de Blobs do Azure e Azure Data Lake Storage Gen2, monitorize a quantidade de dados de origem processados. O uso real do cálculo também depende das cargas úteis do documento, estrutura do índice, enriquecimento e outros processos realizados durante a execução.
Para reduzir o uso de cálculo do indexador:
Use deteção de alterações e indexação incremental: Processe apenas dados novos ou alterados em vez de indexar repetidamente a fonte de dados completa.
Agendas indexadoras de tamanho adequado: Escolha um calendário que cumpra os requisitos de atualização dos seus dados. Utilize a telemetria da Unidade de Computação para avaliar o efeito da frequência de agendamento.
Reduzir o conteúdo desnecessário dos documentos: Remover o conteúdo que não precisa de ser indexado e excluir ficheiros ou tipos de ficheiros que não são necessários.
Defina cuidadosamente as competências de enriquecimento: Execute competências apenas em campos e documentos que necessitem de enriquecimento, e evite gerar resultados que não sejam usados a jusante. As competências faturáveis podem implicar encargos de transação separados.
Monitorizar execuções falhadas e repetidas: Um indexador pode consumir computação para trabalho concluído antes de falhar. Analise o histórico de execução e a utilização de Unidades de Computação para identificar falhas recorrentes e padrões de novas tentativas.
Otimize as suas consultas
O desenho de consultas é um dos principais fatores de custo variável:
Usar
$selectpara limitar campos devolvidos: Isto reduz o tamanho da carga útil e o cálculo necessários para a serialização.GET /docs?search=test&$select=id,title,urlUse
searchFieldspara limitar onde o texto é pesquisado: Restringa a correspondência no tempo de consulta aos campos que importam para o cenário. Cada campo adicional pesquisável aumenta a carga de consulta e pode aumentar as CU/h.Prefira correspondência exata ou pesquisas simples por palavra‑chave: As consultas difusas, com carateres universais, regex e do tipo prefixo podem forçar varrimentos abrangentes do índice e consumir significativamente mais CU/h. Use-as apenas quando precisar de comportamento de correspondência parcial e escolha correspondência exata ou consultas-chave mais simples sempre que possível.
Use consultas em vez de pesquisas sempre que possível: Recuperar um documento por ID é mais eficiente do que executar uma consulta de pesquisa. Se souber o ID do documento, use uma pesquisa em vez de uma consulta de pesquisa. As consultas são mais eficientes porque recuperam um documento diretamente por chave, enquanto as consultas de pesquisa invocam todo o pipeline de consultas (análise sintática, percurso de índice, pontuação e classificação), o que aumenta o custo de cálculo.
Evite a paginação profunda (
$skip): Valores elevados$skipaumentam o cálculo porque o motor tem de processar, pontuar e classificar os resultados que precedem a página solicitada. Por exemplo,$skip=5000exige que o motor processe pelo menos 5.000 resultados que não são devolvidos. Esta escolha consome unidades de computação extra (CUs) e pode aumentar o custo. Em vez disso, use filtros para restringir o resultadosete$toplimitar o número de resultados devolvidos. Tamanho$topcorreto para a sua aplicação ou interface. Embora$topnão altere quantos documentos correspondentes são pontuados, um valor menor reduz o número de resultados que têm de ser recolhidos, ordenados e serializados. Solicite apenas tantos resultados quanto a sua aplicação precisar e evite padrões de paginação que exijam que o motor processe grandes quantidades de resultados não utilizados.Minimize a contagem e o âmbito das facetas: Peça apenas as facetas que são exibidas na sua interface e mantenha cada valor de faceta
counto mais baixo possível. As facetas requerem agregações para cada consulta e contagens elevadas aumentam os custos computacionais.Utilização
search.inpara filtragem: Ao filtrar por uma lista de IDs ou valores, use asearch.infunção em vez de múltiplasorcondições (por exemplo,id eq '1' or id eq '2'). Esta abordagem é mais eficiente e reduz a sobrecarga de computação. Também deve evitar marcar campos de alta cardinalidade (aqueles com um elevado número de valores distintos, como IDs únicos ou descrições em texto livre) como filtráveis ou passíveis de facetação, a menos que tal seja necessário, pois isso aumenta o tamanho do índice e o custo da consulta.
Otimize os seus pedidos administrativos
Para além das operações de consulta e indexação, o Pesquisa de IA do Azure inclui operações administrativas ao nível de objeto e de serviço (como a recuperação de esquemas de índice ou estatísticas de serviço). Estes pedidos têm um custo fixo por pedido. Embora cada pedido seja barato, chamadas repetidas ou desnecessárias podem acumular-se ao longo do tempo e aumentar o uso total de computação.
- Evite pedidos administrativos excessivos: Cache metadados, como esquemas de índice, do lado do cliente em vez de os recuperar repetidamente. Por exemplo, buscar o esquema de índice antes de cada operação de escrita introduz custos desnecessários. No modelo Serverless, este padrão aumenta diretamente as cobranças de cálculo, enquanto nos serviços dedicados, o impacto é frequentemente ocultado por uma faturação horária fixa.
Otimizar custos de vetores
As cargas de trabalho vetoriais são tipicamente o componente de maior custo na procura do modelo de preços Serverless, pois impactam tanto as Unidades de Cálculo (consultas e indexação) como o armazenamento (tamanho do vetor no disco). Para reduzir custos, otimize tanto a forma como os vetores são armazenados como a forma como são consultados.
Otimizar o armazenamento vetorial e o esquema
Os campos vetoriais podem aumentar significativamente o tamanho do índice e o custo de indexação. Use as seguintes técnicas para reduzir a sobrecarga de armazenamento:
Use compressão para reduzir o tamanho do vetor: Aplique quantização para reduzir a pegada de armazenamento com impacto mínimo na relevância. Por exemplo, a quantização escalar pode reduzir o armazenamento vetorial até 4× com impacto mínimo na qualidade da pesquisa.
Desativar o armazenamento para vetores quando não for necessário: Definir stored=false nos campos vetoriais se só precisares de vetores para pesquisa, não para recuperação. Isto evita armazenar os vetores originais no índice, reduzindo o custo de armazenamento sem afetar o comportamento das consultas.
Use dimensões de embedding mais pequenas sempre que possível: Vetores de dimensão superior aumentam tanto o custo de armazenamento como de consulta. Para cargas de trabalho não críticas, use modelos de embedding mais pequenos (por exemplo, dimensões 384 ou 768 em vez de 1536) para reduzir custos.
Otimizar a execução de consultas vetoriais
As consultas vetoriais são intensivas em computação porque requerem cálculos de similaridade sobre estruturas de dados de alta dimensão.
Use a pesquisa híbrida seletivamente: as consultas híbridas executam tanto a recuperação por palavras-chave como por vetor. Use apenas quando necessário para maior relevância.
Redução de maxTextRecallSize para consultas híbridas: A definição
hybridSearch.maxTextRecallSizecontrola quantos resultados classificados segundo o BM25 são fornecidos ao Reciprocal Rank Fusion. O valor padrão é 1.000 (intervalo de 1 a 10.000). O consumo computacional escala aproximadamente de forma linear com este valor, por isso reduzi-lo é uma das alavancas de custo mais diretas para cargas de trabalho híbridas.Valores em torno de 500 reduzem frequentemente de forma significativa o custo computacional, com pouca perda de relevância.
Descer mais pode excluir correspondências de palavras-chave que a pesquisa vetorial não deteta, como termos exatos, IDs e acrónimos.
Controla os candidatos vetoriais separadamente, com k em cada consulta vetorial.
Teste as consultas representativas e compare a relevância, a latência e o
x-ms-azs-compute-units-consumedcabeçalho antes de escolher um valor.Aplique filtros antes das consultas vetoriais: Reduza o conjunto de candidatos antes da pesquisa vetorial para reduzir a quantidade de dados processados. Veja como funciona a filtragem em consultas vetoriais.
Reduza custos minimizando o uso
O modelo Serverless cobra apenas pelos recursos consumidos. Quando não há pedidos, o uso de computação diminui em conformidade.
Para minimizar os custos de utilização:
- Faz consultas apenas quando necessário.
- Evite pedidos redundantes ou demasiado frequentes.
- Monitorizar a utilização e ajustar as cargas de trabalho conforme a procura.
Dica
A mesma consulta pode ter diferentes perfis de latência e de CU, consoante o serviço esteja ativo ou inativo. Após um período sem tráfego de leitura ou escrita, o uso de computação no modelo de preços Serverless cai para zero. O pedido seguinte pode ter maior latência e consumir mais CUs enquanto os caminhos de dados aquecem. Índices maiores geralmente demoram mais tempo a aquecer do que índices mais pequenos, pelo que os efeitos de arranque a frio são frequentemente mais notórios em serviços maiores.
Otimize os custos de armazenamento
O armazenamento é faturado por GB/mês com base no tamanho do índice no disco, que pode exceder o tamanho dos dados brutos. Para reduzir os custos de armazenamento:
- Remover índices não utilizados.
- Minimizar campos armazenados.
- Projetar esquemas tendo em mente a sobrecarga de armazenamento.
- Use sugestores seletivamente porque podem aumentar drasticamente o tamanho do armazenamento.
Para técnicas específicas de vetores (compressão, poda e definições de armazenamento), veja Otimizar para armazenamento e processamento vetorial.
Para mais orientações sobre compensações de desempenho em armazenamento e consultas, consulte Dicas para melhor desempenho em Pesquisa de IA do Azure.