Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
dbt (Data Build Tool) je vývojové prostředí, které umožňuje datovým analytikům a datovým inženýrům transformovat data jednoduchým zápisem příkazů select. dbt zpracovává přeměnu těchto příkazů select na tabulky a zobrazení. dbt zkompiluje váš kód do nezpracovaného SQL a potom tento kód spustí v zadané databázi v Azure Databricks. dbt podporuje vzory kódování na základě spolupráce a osvědčené postupy, jako je správa verzí, dokumentace a modularita.
dbt neextrahuje ani nenačítá data. dbt se zaměřuje pouze na krok transformace a využívá architekturu „transformace po načtení“. dbt předpokládá, že už máte kopii dat v databázi.
Tento článek se zaměřuje na dbt Cloud. dbt Cloud je vybaven podporou na klíč pro plánování úloh, CI/CD, obsluhou dokumentace, monitorováním a upozorňováním a integrovaným vývojovým prostředím (IDE).
K dispozici je také místní verze dbt s názvem dbt Core. dbt Core umožňuje psát kód dbt v textovém editoru nebo integrovaném vývojovém prostředí podle vašeho výběru na místním vývojovém počítači a pak spustit dbt z příkazového řádku. dbt Core obsahuje rozhraní příkazového řádku dbt (CLI). Rozhraní dbt CLI je zdarma a open-source. Další informace najdete v tématu Připojení k dbt Core.
Protože dbt Cloud a dbt Core můžou používat hostovaná úložiště Git (například na GitHubu, GitLabu nebo BitBucketu), můžete pomocí dbt Cloudu vytvořit projekt dbt a pak ho zpřístupnit uživatelům dbt Cloud a dbt Core. Další informace naleznete v tématu Vytvoření projektu dbt a Použití existujícího projektu na webu dbt.
Obecný přehled dbt najdete v následujícím videu YouTube (26 minut).
Připojení k dbt Cloudu pomocí Partnerského připojení
Tato část popisuje, jak připojit Databricks SQL Warehouse ke službě Dbt Cloud pomocí Partnerského připojení a pak udělit ke svým datům přístup ke čtení dbt Cloudu.
Rozdíly mezi standardními připojeními a dbt Cloud
Pokud se chcete připojit ke cloudu dbt pomocí Partnerského připojení, postupujte podle kroků v části Připojení k partnerům pro přípravu dat pomocí Partner Connect. Připojení dbt Cloud se liší od standardních připojení pro přípravu a transformaci dat následujícími způsoby:
- Kromě aplikačního objektu služby a osobního přístupového tokenu vytvoří Partner Connect ve výchozím nastavení SQL Warehouse (dříve koncový bod SQL) pojmenovaný DBT_CLOUD_ENDPOINT.
Postup připojení
Pokud se chcete připojit ke službě dbt Cloud pomocí Partnerského připojení, postupujte takto:
Připojte se k partnerům přípravy dat pomocí Partner Connect.
Po připojení k dbt Cloudu se zobrazí řídicí panel dbt Cloud. Pokud chcete prozkoumat projekt dbt Cloud, vyberte v řádku nabídek vedle loga dbt název účtu dbt v prvním rozevíracím seznamu, pokud se nezobrazí, a pak v druhé rozevírací nabídce vyberte projekt Zkušební verze Partnerského připojení Databricks , pokud se nezobrazí.
Návod
Pokud chcete zobrazit nastavení projektu, klikněte na nabídku Tři pruhy nebo hamburger, klikněte na Projekty nastavení > účtu a klikněte na název projektu. Chcete-li zobrazit nastavení připojení, klikněte na odkaz vedle připojení. Chcete-li změnit nastavení, klepněte na tlačítko Upravit.
Pokud chcete zobrazit informace o osobním přístupovém tokenu Azure Databricks pro tento projekt, klikněte na ikonu "osoba" v řádku nabídek, klikněte na Profil > Přihlašovací údaje > Databricks Partner Connect Trial a klikněte na název projektu. Pokud chcete provést změnu, klikněte na Upravit.
Postup, jak udělit dbt Cloud oprávnění pro čtení vašich dat
Partner Connect poskytuje oprávnění pro vytvoření instančního objektu DBT_CLOUD_USER pouze ve výchozím katalogu. Podle těchto kroků ve svém pracovním prostoru Azure Databricks udělte služebnímu principálu DBT_CLOUD_USER přístup ke čtení dat, která zvolíte.
Varování
Tyto kroky můžete přizpůsobit tak, aby dbt Cloud získal další přístup mezi katalogy, databázemi a tabulkami v rámci vašeho pracovního prostoru. Jako osvědčený postup zabezpečení však Databricks důrazně doporučuje udělit přístup pouze k jednotlivým tabulkám, které potřebujete, aby služební účet DBT_CLOUD_USER mohl s těmito tabulkami pracovat, a pouze přístup pro čtení k těmto tabulkám.
Klikněte na
 Katalog na bočním panelu
V rozevíracím seznamu v pravém horním rohu vyberte SQL Warehouse (DBT_CLOUD_ENDPOINT).
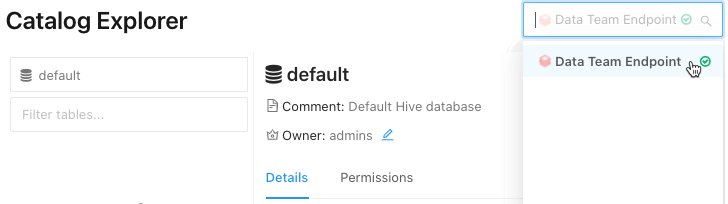
- V části Průzkumník katalogu vyberte katalog, který obsahuje databázi pro vaši tabulku.
- Vyberte databázi, která obsahuje vaši tabulku.
- Vyberte svou tabulku.
Návod
Pokud v seznamu nevidíte katalog, databázi nebo tabulku, zadejte do polí Vybrat katalog, Vybrat databázi nebo Filtrovat tabulky , abyste seznam zúžili.

Klikněte na Oprávnění.
Klikněte na Udělit.
Pokud chcete přidat více uživatelů nebo skupin, vyberte DBT_CLOUD_USER. Toto je instanční objekt služby Azure Databricks, který pro vás Partner Connect vytvořil v předchozí části.
Návod
Pokud DBT_CLOUD_USER nevidíte, začněte psát
DBT_CLOUD_USERdo pole Typ, abyste přidali více uživatelů nebo skupin , dokud se nezobrazí v seznamu, a pak ho vyberte.Udělení přístupu pro čtení pouze výběrem
SELECTaREAD METADATA.Klikněte na OK.
Opakujte kroky 4 až 9 pro každou další tabulku, ke které chcete udělit přístup ke čtení dbt Cloudu.
Řešení potíží s připojením dbt Cloud
Pokud někdo odstraní projekt v dbt Cloudu pro tento účet a vy kliknete na dlaždici dbt , zobrazí se chybová zpráva s oznámením, že projekt nebyl nalezen. Chcete-li tento problém vyřešit, klepněte na tlačítko Odstranit připojení a potom začněte od začátku tohoto postupu vytvořit připojení znovu.
Ruční připojení ke službě dbt Cloud
Tato část popisuje, jak připojit cluster Azure Databricks nebo databricks SQL Warehouse v pracovním prostoru Azure Databricks ke službě Dbt Cloud.
Důležité
Databricks doporučuje připojení ke službě SQL Warehouse. Pokud nemáte nárok na přístup k Sql Databricks nebo pokud chcete spouštět modely Pythonu, můžete se místo toho připojit ke clusteru.
Požadavky
Cluster nebo SQL Warehouse ve vašem pracovním prostoru Azure Databricks.
Podrobnosti o připojení pro váš cluster nebo SQL warehouse, konkrétně název hostitele serveru , port a hodnoty cesty HTTP .
Osobní přístupový token Azure Databricks nebo token Microsoft Entra ID (dříve Azure Active Directory). Chcete-li vytvořit osobní token pro přístup, postupujte podle pokynů v tématu Vytváření osobních tokenů pro uživatele pracovního prostoru.
Poznámka:
Jako bezpečnostní opatření při ověřování pomocí automatizovaných nástrojů, systémů, skriptů a aplikací doporučuje Databricks používat osobní přístupové tokeny, které patří služebním subjektům, místo uživatelů pracovního prostoru. Pokud chcete vytvořit tokeny pro instanční objekty, přečtěte si téma Správa tokenů instančního objektu.
Pokud chcete připojit dbt Cloud k datům spravovaným katalogem Unity, dbt verze 1.1 nebo vyšší.
Kroky v tomto článku vytvoří nové prostředí, které používá nejnovější verzi dbt. Informace o upgradu verze dbt pro existující prostředí najdete v dokumentaci k upgradu na nejnovější verzi dbt v cloudu .
Krok 1: Registrace do dbt Cloudu
Přejděte do dbt Cloudu – Zaregistrujte se a zadejte svůj e-mail, jméno a informace o společnosti. Vytvořte heslo a klikněte na Vytvořit můj účet.
Krok 2: Vytvoření projektu dbt
V tomto kroku vytvoříte projekt dbt, který obsahuje připojení ke clusteru Azure Databricks nebo SQL Warehouse, úložišti, které obsahuje váš zdrojový kód, a jedno nebo více prostředí (například testovací a produkční prostředí).
Klikněte na ikonu nastavení a potom klikněte na Nastavení účtu.
Klikněte na Nový projekt.
Do pole Název zadejte jedinečný název projektu a klikněte na tlačítko Pokračovat.
V rozevírací nabídce Vyberte výpočetní připojení Azure Databricks nebo vytvořte nové připojení:
Klikněte na Přidat nové připojení.
Průvodce Přidat nové připojení se otevře v nové záložce.
Klikněte na Databricks a potom klikněte na Další.
Poznámka:
Databricks doporučuje používat
dbt-databricks, který podporuje Unity Catalog místodbt-spark. Nové projekty ve výchozím nastavení používajídbt-databricks. Pokud chcete migrovat existující projekt dodbt-databricks, přečtěte si téma Migrace z dbt-spark do dbt-databricks v dokumentaci dbt.V části Nastavení pro název hostitele serveru zadejte hodnotu názvu hostitele serveru z požadavků.
Do pole Cesta HTTP zadejte hodnotu cesty HTTP z požadavků.
Pokud je váš pracovní prostor s povoleným katalogem Unity, zadejte v části Nepovinná nastavení název katalogu pro dbt, který se má použít.
Klikněte na Uložit.
Vraťte se do průvodce novým projektem a v rozevírací nabídce Připojení vyberte připojení, které jste právě vytvořili.
V části Přihlašovací údaje pro vývoj zadejte pro token osobní přístupový token nebo token Microsoft Entra ID z požadavků.
Zadejte název schématu, ve kterém má dbt vytvořit tabulky a zobrazení.
Klikněte na test připojení.
Pokud se test úspěšně dokončí, klikněte na uložit.
Další informace naleznete v tématu Připojení k rozhraní DATAbricks ODBC na webu dbt.
Návod
Chcete-li zobrazit nebo změnit nastavení pro tento projekt nebo úplně odstranit projekt, klikněte na ikonu nastavení, klikněte na položku > nastavení účtu a klikněte na název projektu. Chcete-li změnit nastavení, klepněte na tlačítko Upravit. Chcete-li projekt odstranit, klepněte na tlačítko Upravit > odstranit projekt.
Pokud chcete zobrazit nebo změnit hodnotu osobního přístupového tokenu Azure Databricks pro tento projekt, klikněte na ikonu Osoba, klikněte na > profilu a klikněte na název projektu. Pokud chcete provést změnu, klikněte na Upravit.
Po připojení ke clusteru Azure Databricks nebo službě Databricks SQL Warehouse postupujte podle pokynů na obrazovce a nastavte úložiště a potom klikněte na Pokračovat.
Po nastavení úložiště postupujte podle pokynů na obrazovce a pozvěte uživatele a klikněte na Tlačítko Dokončit. Nebo klikněte na Přeskočit a dokončit.
Návod
V této části použijete projekt dbt Cloud k práci s některými ukázkovými daty. V této části se předpokládá, že jste projekt už vytvořili a máte otevřené integrované vývojové prostředí dbt Cloud pro tento projekt.
Krok 1: Vytvoření a spuštění modelů
V tomto kroku použijete prostředí DBT Cloud IDE k vytvoření a spuštění modelů, což jsou select příkazy, které vytvoří nové zobrazení (výchozí) nebo novou tabulku v databázi na základě existujících dat ve stejné databázi. Tento postup vytvoří model založený na ukázkové diamonds tabulce z ukázkových datových sad.
Návod
Pokud má váš pracovní prostor pro Unity Catalog povolený bezserverový sklad SQL, Databricks doporučuje materializovat produkční modely, které musí být průběžně aktuální, jako materializované pohledy nebo streamingové tabulky, nikoli jako tabulky nebo pohledy. Tyto materializace se obnovují postupně místo toho, aby se při každém spuštění přepočítaval celý výsledek. Viz Krok 4: Udržujte modely aktuální pomocí materializovaných pohledů a streamovacích tabulek.
K vytvoření této tabulky použijte následující kód.
DROP TABLE IF EXISTS diamonds;

CREATE TABLE diamonds USING CSV OPTIONS (path "/databricks-datasets/Rdatasets/data-001/csv/ggplot2/diamonds.csv", header "true")
Tento postup předpokládá, že tato tabulka již byla vytvořena v databázi vašeho pracovního prostoru default .
Otevřete projekt a v horní části uživatelského rozhraní klikněte na Vývoj .
Klikněte na Inicializovat projekt dbt.
Klikněte na Commit and sync, zadejte zprávu pro potvrzení a poté klikněte na Commit.
Klikněte na Vytvořit větev, zadejte název větve a potom klikněte na Odeslat.
Vytvořte první model: Klikněte na Vytvořit nový soubor.
V textovém editoru zadejte následující příkaz SQL. Tento příkaz vybere z tabulky
diamondspro každý diamant pouze údaje o karátu, brusu, barvě a čistotě. Blokconfigdává dbt pokyn k vytvoření tabulky v databázi na základě tohoto příkazu.{{ config( materialized='table', file_format='delta' ) }}select carat, cut, color, clarity from diamondsNávod
Další
configmožnosti, jako jemergepostupná strategie, najdete v části Konfigurace Databricks v dokumentaci dbt.Klikněte na Uložit jako.
Jako název souboru zadejte
models/diamonds_four_cs.sqla klepněte na tlačítko Vytvořit.Vytvoření druhého modelu: V pravém horním rohu klikněte na
 (Vytvořit nový soubor).
V textovém editoru zadejte následující příkaz SQL. Tento příkaz vybere jedinečné hodnoty ze
colorssloupce vdiamonds_four_cstabulce a seřadí výsledky podle abecedy jako první po poslední. Vzhledem k tomu, že neexistuje žádnýconfigblok, tento model dává dbt pokyn k vytvoření zobrazení v databázi na základě tohoto příkazu.select distinct color from diamonds_four_cs sort by color ascKlikněte na Uložit jako.
Jako název souboru zadejte
models/diamonds_list_colors.sqla klepněte na tlačítko Vytvořit.Vytvoření třetího modelu: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující příkaz SQL. Tento výpis zprůměruje ceny diamantů podle barvy a výsledky seřadí podle průměrné ceny od nejvyšší po nejnižší. Tento model dává dbt pokyn k vytvoření zobrazení v databázi na základě tohoto příkazu.
select color, avg(price) as price
from diamonds
group by color
order by price desc
Klikněte na Uložit jako.
Jako název souboru zadejte
models/diamonds_prices.sqla klikněte na Vytvořit.Spusťte modely: Na příkazovém řádku spusťte
dbt runpříkaz s cestami ke třem předchozím souborům.defaultV databázi dbt vytvoří jednu tabulku s názvemdiamonds_four_csa dvě zobrazení s názvemdiamonds_list_colorsadiamonds_prices. Dbt získá tyto názvy zobrazení a tabulky z jejich souvisejících.sqlnázvů souborů.dbt run --model models/diamonds_four_cs.sql models/diamonds_list_colors.sql models/diamonds_prices.sql... ... | 1 of 3 START table model default.diamonds_four_cs.................... [RUN] ... | 1 of 3 OK created table model default.diamonds_four_cs............... [OK ...] ... | 2 of 3 START view model default.diamonds_list_colors................. [RUN] ... | 2 of 3 OK created view model default.diamonds_list_colors............ [OK ...] ... | 3 of 3 START view model default.diamonds_prices...................... [RUN] ... | 3 of 3 OK created view model default.diamonds_prices................. [OK ...] ... | ... | Finished running 1 table model, 2 view models ... Completed successfully Done. PASS=3 WARN=0 ERROR=0 SKIP=0 TOTAL=3Spuštěním následujícího kódu SQL zobrazte informace o nových zobrazeních a vyberte všechny řádky z tabulky a zobrazení.
Pokud se připojujete ke clusteru, můžete tento kód SQL spustit z poznámkového bloku připojeného ke clusteru a zadat SQL jako výchozí jazyk poznámkového bloku. Pokud se připojujete ke službě SQL Warehouse, můžete tento kód SQL spustit z dotazu.
SHOW views IN default+-----------+----------------------+-------------+ | namespace | viewName | isTemporary | +===========+======================+=============+ | default | diamonds_list_colors | false | +-----------+----------------------+-------------+ | default | diamonds_prices | false | +-----------+----------------------+-------------+SELECT * FROM diamonds_four_cs+-------+---------+-------+---------+ | carat | cut | color | clarity | +=======+=========+=======+=========+ | 0.23 | Ideal | E | SI2 | +-------+---------+-------+---------+ | 0.21 | Premium | E | SI1 | +-------+---------+-------+---------+ ...SELECT * FROM diamonds_list_colors+-------+ | color | +=======+ | D | +-------+ | E | +-------+ ...SELECT * FROM diamonds_prices+-------+---------+ | color | price | +=======+=========+ | J | 5323.82 | +-------+---------+ | I | 5091.87 | +-------+---------+ ...
Krok 2: Vytvoření a spuštění složitějších modelů
V tomto kroku vytvoříte složitější modely pro sadu souvisejících tabulek dat. Tyto datové tabulky obsahují informace o fiktivní sportovní lize tří týmů, které hrají sezónu šesti her. Tento postup vytvoří tabulky dat, vytvoří modely a spustí modely.
Spuštěním následujícího kódu SQL vytvořte potřebné tabulky dat.
Pokud se připojujete ke clusteru, můžete tento kód SQL spustit z poznámkového bloku připojeného ke clusteru a zadat SQL jako výchozí jazyk poznámkového bloku. Pokud se připojujete ke službě SQL Warehouse, můžete tento kód SQL spustit z dotazu.
Tabulky a pohledy v tomto kroku začínají znakem
zzz_, aby bylo možné je identifikovat jako součást tohoto příkladu. Tento vzor nemusíte dodržovat pro vlastní tabulky a zobrazení.DROP TABLE IF EXISTS zzz_game_opponents; DROP TABLE IF EXISTS zzz_game_scores; DROP TABLE IF EXISTS zzz_games; DROP TABLE IF EXISTS zzz_teams; CREATE TABLE zzz_game_opponents ( game_id INT, home_team_id INT, visitor_team_id INT ) USING DELTA; INSERT INTO zzz_game_opponents VALUES (1, 1, 2); INSERT INTO zzz_game_opponents VALUES (2, 1, 3); INSERT INTO zzz_game_opponents VALUES (3, 2, 1); INSERT INTO zzz_game_opponents VALUES (4, 2, 3); INSERT INTO zzz_game_opponents VALUES (5, 3, 1); INSERT INTO zzz_game_opponents VALUES (6, 3, 2); -- Result: -- +---------+--------------+-----------------+ -- | game_id | home_team_id | visitor_team_id | -- +=========+==============+=================+ -- | 1 | 1 | 2 | -- +---------+--------------+-----------------+ -- | 2 | 1 | 3 | -- +---------+--------------+-----------------+ -- | 3 | 2 | 1 | -- +---------+--------------+-----------------+ -- | 4 | 2 | 3 | -- +---------+--------------+-----------------+ -- | 5 | 3 | 1 | -- +---------+--------------+-----------------+ -- | 6 | 3 | 2 | -- +---------+--------------+-----------------+ CREATE TABLE zzz_game_scores ( game_id INT, home_team_score INT, visitor_team_score INT ) USING DELTA; INSERT INTO zzz_game_scores VALUES (1, 4, 2); INSERT INTO zzz_game_scores VALUES (2, 0, 1); INSERT INTO zzz_game_scores VALUES (3, 1, 2); INSERT INTO zzz_game_scores VALUES (4, 3, 2); INSERT INTO zzz_game_scores VALUES (5, 3, 0); INSERT INTO zzz_game_scores VALUES (6, 3, 1); -- Result: -- +---------+-----------------+--------------------+ -- | game_id | home_team_score | visitor_team_score | -- +=========+=================+====================+ -- | 1 | 4 | 2 | -- +---------+-----------------+--------------------+ -- | 2 | 0 | 1 | -- +---------+-----------------+--------------------+ -- | 3 | 1 | 2 | -- +---------+-----------------+--------------------+ -- | 4 | 3 | 2 | -- +---------+-----------------+--------------------+ -- | 5 | 3 | 0 | -- +---------+-----------------+--------------------+ -- | 6 | 3 | 1 | -- +---------+-----------------+--------------------+ CREATE TABLE zzz_games ( game_id INT, game_date DATE ) USING DELTA; INSERT INTO zzz_games VALUES (1, '2020-12-12'); INSERT INTO zzz_games VALUES (2, '2021-01-09'); INSERT INTO zzz_games VALUES (3, '2020-12-19'); INSERT INTO zzz_games VALUES (4, '2021-01-16'); INSERT INTO zzz_games VALUES (5, '2021-01-23'); INSERT INTO zzz_games VALUES (6, '2021-02-06'); -- Result: -- +---------+------------+ -- | game_id | game_date | -- +=========+============+ -- | 1 | 2020-12-12 | -- +---------+------------+ -- | 2 | 2021-01-09 | -- +---------+------------+ -- | 3 | 2020-12-19 | -- +---------+------------+ -- | 4 | 2021-01-16 | -- +---------+------------+ -- | 5 | 2021-01-23 | -- +---------+------------+ -- | 6 | 2021-02-06 | -- +---------+------------+ CREATE TABLE zzz_teams ( team_id INT, team_city VARCHAR(15) ) USING DELTA; INSERT INTO zzz_teams VALUES (1, "San Francisco"); INSERT INTO zzz_teams VALUES (2, "Seattle"); INSERT INTO zzz_teams VALUES (3, "Amsterdam"); -- Result: -- +---------+---------------+ -- | team_id | team_city | -- +=========+===============+ -- | 1 | San Francisco | -- +---------+---------------+ -- | 2 | Seattle | -- +---------+---------------+ -- | 3 | Amsterdam | -- +---------+---------------+Vytvoření prvního modelu: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující příkaz SQL. Tento příkaz vytvoří tabulku, která obsahuje podrobnosti o jednotlivých hrách, jako jsou názvy týmů a skóre. Blok
configdává dbt pokyn k vytvoření tabulky v databázi na základě tohoto příkazu.-- Create a table that provides full details for each game, including -- the game ID, the home and visiting teams' city names and scores, -- the game winner's city name, and the game date.{{ config( materialized='table', file_format='delta' ) }}-- Step 4 of 4: Replace the visitor team IDs with their city names. select game_id, home, t.team_city as visitor, home_score, visitor_score, -- Step 3 of 4: Display the city name for each game's winner. case when home_score > visitor_score then home when visitor_score > home_score then t.team_city end as winner, game_date as date from ( -- Step 2 of 4: Replace the home team IDs with their actual city names. select game_id, t.team_city as home, home_score, visitor_team_id, visitor_score, game_date from ( -- Step 1 of 4: Combine data from various tables (for example, game and team IDs, scores, dates). select g.game_id, go.home_team_id, gs.home_team_score as home_score, go.visitor_team_id, gs.visitor_team_score as visitor_score, g.game_date from zzz_games as g, zzz_game_opponents as go, zzz_game_scores as gs where g.game_id = go.game_id and g.game_id = gs.game_id ) as all_ids, zzz_teams as t where all_ids.home_team_id = t.team_id ) as visitor_ids, zzz_teams as t where visitor_ids.visitor_team_id = t.team_id order by game_date descKlikněte na Uložit jako.
Jako název souboru zadejte
models/zzz_game_details.sqla klepněte na tlačítko Vytvořit.Vytvoření druhého modelu: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující příkaz SQL. Tento příkaz vytvoří zobrazení, které vypisuje bilanci výher a proher týmu za sezónu.
-- Create a view that summarizes the season's win and loss records by team.

-- Step 2 of 2: Calculate the number of wins and losses for each team.
select
  winner as team,
  count(winner) as wins,
  -- Each team played in 4 games.
  (4 - count(winner)) as losses
from (
  -- Step 1 of 2: Determine the winner and loser for each game.
  select
    game_id,
    winner,
    case
      when
        home = winner
          then
            visitor
      else
        home
    end as loser
  from zzz_game_details
)
group by winner
order by wins desc
Klikněte na Uložit jako.
Jako název souboru zadejte
models/zzz_win_loss_records.sqla klepněte na tlačítko Vytvořit.Spusťte modely: Na příkazovém řádku spusťte
dbt runpříkaz s cestami ke dvěma předchozím souborům.defaultV databázi (jak je uvedeno v nastavení projektu), dbt vytvoří jednu tabulku s názvemzzz_game_detailsa jedno zobrazení s názvemzzz_win_loss_records. Dbt získá tyto názvy zobrazení a tabulky z jejich souvisejících.sqlnázvů souborů.dbt run --model models/zzz_game_details.sql models/zzz_win_loss_records.sql... ... | 1 of 2 START table model default.zzz_game_details.................... [RUN] ... | 1 of 2 OK created table model default.zzz_game_details............... [OK ...] ... | 2 of 2 START view model default.zzz_win_loss_records................. [RUN] ... | 2 of 2 OK created view model default.zzz_win_loss_records............ [OK ...] ... | ... | Finished running 1 table model, 1 view model ... Completed successfully Done. PASS=2 WARN=0 ERROR=0 SKIP=0 TOTAL=2Spuštěním následujícího kódu SQL zobrazte informace o novém zobrazení a vyberte všechny řádky z tabulky a zobrazení.
Pokud se připojujete ke clusteru, můžete tento kód SQL spustit z poznámkového bloku připojeného ke clusteru a zadat SQL jako výchozí jazyk poznámkového bloku. Pokud se připojujete ke službě SQL Warehouse, můžete tento kód SQL spustit z dotazu.
SHOW VIEWS FROM default LIKE 'zzz_win_loss_records';+-----------+----------------------+-------------+ | namespace | viewName | isTemporary | +===========+======================+=============+ | default | zzz_win_loss_records | false | +-----------+----------------------+-------------+SELECT * FROM zzz_game_details;+---------+---------------+---------------+------------+---------------+---------------+------------+ | game_id | home | visitor | home_score | visitor_score | winner | date | +=========+===============+===============+============+===============+===============+============+ | 1 | San Francisco | Seattle | 4 | 2 | San Francisco | 2020-12-12 | +---------+---------------+---------------+------------+---------------+---------------+------------+ | 2 | San Francisco | Amsterdam | 0 | 1 | Amsterdam | 2021-01-09 | +---------+---------------+---------------+------------+---------------+---------------+------------+ | 3 | Seattle | San Francisco | 1 | 2 | San Francisco | 2020-12-19 | +---------+---------------+---------------+------------+---------------+---------------+------------+ | 4 | Seattle | Amsterdam | 3 | 2 | Seattle | 2021-01-16 | +---------+---------------+---------------+------------+---------------+---------------+------------+ | 5 | Amsterdam | San Francisco | 3 | 0 | Amsterdam | 2021-01-23 | +---------+---------------+---------------+------------+---------------+---------------+------------+ | 6 | Amsterdam | Seattle | 3 | 1 | Amsterdam | 2021-02-06 | +---------+---------------+---------------+------------+---------------+---------------+------------+SELECT * FROM zzz_win_loss_records;+---------------+------+--------+ | team | wins | losses | +===============+======+========+ | Amsterdam | 3 | 1 | +---------------+------+--------+ | San Francisco | 2 | 2 | +---------------+------+--------+ | Seattle | 1 | 3 | +---------------+------+--------+
Krok 3: Vytvoření a spuštění testů
V tomto kroku vytvoříte testy, což jsou tvrzení, která činíte o svých modelech. Když tyto testy spustíte, dbt vám řekne, jestli každý test v projektu projde nebo selže.
Existují dva typy testů. Testy schématu, napsané v YAML, vrací počet záznamů, které neprojdou podmínku. Je-li toto číslo nulové, projdou všechny záznamy, a tím pádem projdou i testy. Datové testy jsou specifické dotazy, které musí vrátit nulové záznamy, aby prošly.
Vytvořte testy schématu: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující obsah. Tento soubor obsahuje testy schématu, které určují, zda zadané sloupce mají jedinečné hodnoty, nemají hodnotu null, mají pouze zadané hodnoty nebo kombinaci.
version: 2

models:
  - name: zzz_game_details
    columns:
      - name: game_id
        tests:
          - unique
          - not_null
      - name: home
        tests:
          - not_null
          - accepted_values:
              values: ['Amsterdam', 'San Francisco', 'Seattle']
      - name: visitor
        tests:
          - not_null
          - accepted_values:
              values: ['Amsterdam', 'San Francisco', 'Seattle']
      - name: home_score
        tests:
          - not_null
      - name: visitor_score
        tests:
          - not_null
      - name: winner
        tests:
          - not_null
          - accepted_values:
              values: ['Amsterdam', 'San Francisco', 'Seattle']
      - name: date
        tests:
          - not_null
  - name: zzz_win_loss_records
    columns:
      - name: team
        tests:
          - unique
          - not_null
          - relationships:
              to: ref('zzz_game_details')
              field: home
      - name: wins
        tests:
          - not_null
      - name: losses
        tests:
          - not_null
Klikněte na Uložit jako.
Jako název souboru zadejte
models/schema.ymla klepněte na tlačítko Vytvořit.Vytvoření prvního testu dat: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující příkaz SQL. Tento soubor obsahuje datový test, který určuje, jestli se některé hry nestaly mimo pravidelnou sezónu.
-- This season's games happened between 2020-12-12 and 2021-02-06.
-- For this test to pass, this query must return no results.

select date
from zzz_game_details
where date < '2020-12-12'
or date > '2021-02-06'
Klikněte na Uložit jako.
Jako název souboru zadejte
tests/zzz_game_details_check_dates.sqla klepněte na tlačítko Vytvořit.Vytvoření druhého testu dat: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující příkaz SQL. Tento soubor obsahuje datový test, který určuje, jestli byly nějaké skóre záporné nebo jakékoli hry byly svázané.
-- This sport allows no negative scores or tie games.
-- For this test to pass, this query must return no results.

select home_score, visitor_score
from zzz_game_details
where home_score < 0
or visitor_score < 0
or home_score = visitor_score
Klikněte na Uložit jako.
Jako název souboru zadejte
tests/zzz_game_details_check_scores.sqla klepněte na tlačítko Vytvořit.Vytvoření třetího testu dat: V pravém horním rohu klikněte na
(Vytvořit nový soubor).V textovém editoru zadejte následující příkaz SQL. Tento soubor obsahuje datový test, který určuje, jestli některé týmy měly negativní záznamy o výhrách nebo ztrátách, měly více záznamů o výhrách nebo ztrátách než hry, nebo hrály více her, než bylo povoleno.
-- Each team participated in 4 games this season.
-- For this test to pass, this query must return no results.

select wins, losses
from zzz_win_loss_records
where wins < 0 or wins > 4
or losses < 0 or losses > 4
or (wins + losses) > 4
Klikněte na Uložit jako.
Jako název souboru zadejte
tests/zzz_win_loss_records_check_records.sqla klepněte na tlačítko Vytvořit.Spusťte testy: Na příkazovém řádku spusťte
dbt testpříkaz.
Krok 4: Udržujte modely aktuální pomocí materializovaných pohledů a streamovacích tabulek
Když musí model zůstat aktuální s novými daty, materializujte jej jako materializovaný pohled nebo streamovanou tabulku místo tabulky či pohledu. Materializovaný pohled postupně obnovuje výsledky svého dotazu, takže Azure Databricks aktualizuje pouze to, co se změnilo, místo aby při každém spuštění přepočítal celý výsledek, což činí materializované pohledy vhodnými pro agregace a data podávaná na dashboardy. Tabulka streamování postupně přijímá pouze připojená nebo streamovaná zdrojová data, například soubory, které přicházejí do cloudového úložiště, aniž by znovu zpracovávala již přečtené řádky. Obě jsou podpořeny potrubími Lakeflow a jsou doporučenými materializacemi pro výrobní transformace, které musí být aktuální.
Poznámka:
Tento krok vyžaduje pracovní prostor s povoleným katalogem Unity Catalog a serverless SQL datovým skladem. Materializace materialized_view je zabudována do dbt, zatímco streaming_table je zajištěna dbt-databricks adaptérem.
Vytvořte model materializovaného pohledu: Klikněte na
(Vytvořit nový soubor) v pravém horním rohu.V textovém editoru zadejte následující příkaz SQL. Jedná se o stejnou agregaci jako v pohledu
diamonds_prices, aleconfigblok instruuje dbt, aby vytvořil materializovaný pohled. Na rozdíl od pohledu, který přepočítává každý dotaz, materializovaný pohled předpočítává výsledek a aktualizuje jej postupně.{{ config( materialized='materialized_view' ) }}select color, avg(price) as price from diamonds group by color order by price descKlikněte na Uložit jako.
Jako název souboru zadejte
models/diamonds_prices_mv.sqla klepněte na tlačítko Vytvořit.Vytvořte model streamovací tabulky: Klikněte na
(Vytvořit nový soubor) v pravém horním rohu.V textovém editoru zadejte následující příkaz SQL. Blok
configinstruuje dbt, aby vytvořil streamovací tabulku, která postupně spotřebovává zdrojovýdiamondsCSV soubor. Funkceread_filess tabulkovou hodnotou čte soubor a klíčové slovoSTREAMzpracovává pouze nově příchozí data při každé obnově.{{ config( materialized='streaming_table' ) }}select * from stream read_files( '/databricks-datasets/Rdatasets/data-001/csv/ggplot2/diamonds.csv', format => 'csv', header => true )Klikněte na Uložit jako.
Jako název souboru zadejte
models/diamonds_raw_stream.sqla klepněte na tlačítko Vytvořit.Spusťte modely: Na příkazovém řádku spusťte
dbt runpříkaz s cestami ke dvěma předchozím souborům.dbt run --model models/diamonds_prices_mv.sql models/diamonds_raw_stream.sql
Při aktualizaci těchto modelů mějte na paměti následující chování:
- Změna dotazu streamovací tabulky nezpracuje znovu data, která už byla načtena. DBT používá
CREATE OR REFRESH, které aplikuje aktualizovaný dotaz pouze na budoucí řádky. Pro přepracování dostupných zdrojových dat spusťte .--full-refresh - Změna konfigurace materializovaného zobrazení vyžaduje, aby jej dbt odstranil a znovu vytvořil, s výjimkou změn plánu.
- Tagy, které nastavíte pomocí
databricks_tags, po jejich použití nelze přes dbt odstranit. Pro odstranění tagu použijte přímo Azure Databricks nebo post-hook.
Úplný seznam podporovaných konfigurací, jako jsou plánované obnovy, dělení na oddíly a filtry řádků, najdete v části Materializovaná zobrazení a streamovací tabulky v dokumentaci dbt.
Krok 5: Uklidit
Tabulky a zobrazení, které jste vytvořili v tomto příkladu, můžete odstranit spuštěním následujícího kódu SQL.
Pokud se připojujete ke clusteru, můžete tento kód SQL spustit z poznámkového bloku připojeného ke clusteru a zadat SQL jako výchozí jazyk poznámkového bloku. Pokud se připojujete ke službě SQL Warehouse, můžete tento kód SQL spustit z dotazu.
DROP TABLE zzz_game_opponents;
DROP TABLE zzz_game_scores;
DROP TABLE zzz_games;
DROP TABLE zzz_teams;
DROP TABLE zzz_game_details;
DROP VIEW zzz_win_loss_records;

DROP MATERIALIZED VIEW diamonds_prices_mv;
DROP TABLE diamonds_raw_stream;
DROP TABLE diamonds;
DROP TABLE diamonds_four_cs;
DROP VIEW diamonds_list_colors;
DROP VIEW diamonds_prices;
Poznámka:
Pokud jste nedokončili krok 4, vynechte příkazy DROP MATERIALIZED VIEW diamonds_prices_mv a DROP TABLE diamonds_raw_stream
Další kroky
- Přečtěte si další informace o modelech dbt.
- Naučte se testovat projekty dbt.
- Naučte se používat jinja , jazyk šablon, pro programování SQL v projektech dbt.
- Seznamte se s osvědčenými postupy dbt.
- Zjistěte více o materializacích, které udržují vaše data aktuální. Viz Použití samostatných materializovaných zobrazení a použití samostatných streamovacích tabulek.