Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Důležité
Překlady mimo angličtinu jsou k dispozici pouze pro usnadnění. Projděte si EN-US verzi tohoto dokumentu s konečnou verzí.
Co je poznámka transparentnosti?
Systém AI zahrnuje nejen technologii, ale také lidi, kteří ji budou používat, osoby, které ho budou ovlivněny, a prostředí, ve kterém je nasazené. Vytvoření systému, který je vhodný pro zamýšlený účel, vyžaduje pochopení, jak technologie funguje, její schopnosti a omezení a jak dosáhnout nejlepšího výkonu.
Microsoft poskytuje poznámky k průhledu, které vám pomůžou pochopit, jak naše technologie AI funguje. Patří sem volby, které mohou vlastníci systému ovlivnit výkon a chování systému a význam myšlení celého systému, včetně technologií, lidí a prostředí. Poznámky k transparentnosti můžete použít při vývoji nebo nasazení vlastního systému nebo je můžete sdílet s lidmi, kteří budou váš systém používat nebo budou ovlivněni.
Poznámky k transparentnosti jsou součástí širšího úsilí o Microsoft, aby se naše principy umělé inteligence zavedly do praxe. Další informace najdete v tématu Microsoft principy AI.
Základy funkce Document Intelligence
Úvod
Funkce Document Intelligence je přístupná prostřednictvím sady rozhraní API a umožňuje vývojářům snadno extrahovat text, strukturu a pole ze svých dokumentů. Skládá se z funkcí, jako jsou:
- Čtení pro účely extrakce textu
- Rozložení a obecné dokumenty pro strukturální přehledy a obecné klíčové hodnoty, stejně jako entity, jako jsou názvy, místa a věci.
- Předem připravené modely pro konkrétní typy dokumentů, jako jsou faktury, účtenky, vizitky, W2 a ID.
- Vlastní modely pro vytváření modelů specifických pro vaše typy dokumentů
Funkce Document Intelligence podporuje jeden nebo více jazyků a národních prostředí pro každou z funkcí, jak je uvedeno v článku Podporované jazyky .
Klíčové termíny
| Termín | Definice |
|---|---|
| Číst | Tato funkce extrahuje textové řádky, slova a jejich umístění z obrázků a dokumentů spolu s dalšími informacemi, jako jsou zjištěné jazyky. |
| Rozložení | Tato funkce extrahuje text, značky výběru a strukturu tabulky (čísla řádků a sloupců přidružená k textu). Viz Rozložení funkce Document Intelligence. |
| Obecné dokumenty | Analyzujte dokumenty a přidružujte hodnoty ke klíčům a položkám k tabulkám, které zjistí. Další informace naleznete v tématu Obecné dokumenty funkce Document Intelligence. |
| Předem připravené modely | Předem vytvořené modely jsou modely specifické pro dokumenty pro jedinečné typy formulářů. Tyto modely před použitím nevyžadují vlastní trénování. Například předem vytvořený model faktury extrahuje klíčová pole z faktur. Další informace najdete v tématu Předem připravený model faktury funkce Document Intelligence. |
| Vlastní modely | Funkce Document Intelligence umožňuje trénovat vlastní model přizpůsobený vašim formulářům a dokumentům. Tento model extrahuje text, klíčové- a hodnotové páry, výběrové značky a tabulková data. Vlastní modely je možné vylepšit pomocí lidské zpětné vazby použitím lidské kontroly, aktualizace popisků a opětovného trénování modelu pomocí rozhraní API. |
| Hodnota spolehlivosti | Všechny operace "Získání výsledků analýzy" vrací hodnoty spolehlivosti v rozmezí 0 až 1 pro všechna extrahovaná slova a mapování klíč-hodnota. Tato hodnota představuje odhad služby, kolikrát správně extrahuje slovo ze 100 nebo kolikrát správně mapuje páry klíč-hodnota. Například slovo, které je správně extrahováno v 82 % případů, má hodnotu spolehlivosti 0,82. |
| Doplňkové funkce | Funkce Document Intelligence nabízí sadu doplňkových funkcí, které rozšiřují výsledky tak, aby zahrnovaly další prvky z dokumentů. Některé funkce doplňku účtují dodatečné náklady a v závislosti na scénáři extrakce dokumentů je možné je povolit a zakázat. V současné době nabízíme možnosti extrakce vysoce rozlišení, vzorců, stylůFont, čárových kódů, jazyků, klíčovaných hodnot a dotazových polí. Další informace najdete v tématu Možnosti doplňku Document Intelligence. |
Schopnosti
Chování systému
Azure Document Intelligence in Foundry Tools je cloudový nástroj ve Foundry Tools vytvořený pomocí optického rozpoznávání znaků (OCR), Analýza textu a Custom Text z Foundry Tools. Vlastní modely aktuálně používají model GPT-3.5 služby OpenAI Azure. OCR slouží k extrakci písma a ručně psaných textových dokumentů. Funkce Document Intelligence používá technologii OCR k detekci a extrahování informací z formulářů a dokumentů podporovaných umělou inteligencí k zajištění větší struktury a informací pro extrakci textu.
Případy použití
Zamýšlené použití
Funkce Document Intelligence zahrnují funkce, které zákazníkům z různých odvětví umožňují extrahovat data z jejich dokumentů. Následující scénáře jsou příklady vhodných případů použití:
Závazky z obchodního styku: Společnost může zvýšit efektivitu svých účetních pomocí předem připraveného modelu faktury a vlastních formulářů, aby urychlila zadávání dat faktury za účasti člověka. Předem připravený model faktury může extrahovat klíčová pole, jako jsou faktura celkem a dodací adresa.
Zpracování pojistných formulářů: Zákazník může model vytrénovat pomocí vlastních formulářů k extrakci klíčových párů z pojistných formulářů a poté data vloží do svého obchodního toku za účelem zlepšení přesnosti a efektivity procesu. Pro své jedinečné formuláře můžou zákazníci vytvořit vlastní model, který extrahuje klíčové hodnoty pomocí vlastních formulářů. Tyto extrahované hodnoty se pak stanou použitelnými daty pro různé pracovní postupy v rámci své firmy.
Zpracování bankovního formuláře: Banka může pomocí předem vytvořeného modelu ID a vlastních formulářů urychlit zadávání dat pro dokumentaci ke "známému zákazníkovi" nebo urychlit zadávání dat pro paket hypotéky. Pokud banka vyžaduje, aby zákazníci v rámci procesu odeslali osobní identifikaci, může předem připravený model ID extrahovat klíčové hodnoty, jako je název a číslo dokumentu, zrychlit celkový čas zadávání dat.
Automatizace robotických procesů (RPA): Pomocí vlastního modelu extrakce můžou zákazníci extrahovat konkrétní data potřebná z různých typů dokumentů. Extrahovaný pár klíč-hodnota se pak dá zadat do různých systémů, jako jsou databáze nebo systémy CRM, prostřednictvím RPA a nahradit ruční zadávání dat. Zákazníci můžou také pomocí vlastního klasifikačního modelu kategorizovat dokumenty na základě jejich obsahu a zařazovat je do správného umístění. Například uspořádaná sada dat extrahovaných z vlastního modelu může být základním prvním krokem k dokumentaci scénářů RPA pro firmy, které pravidelně zpracovávají velké objemy dokumentů.
Důležité informace o výběru jiných případů použití
Při výběru případu použití zvažte následující faktory:
Pečlivě zvažte použití lidské kontroly, když jsou zahrnuta citlivá data nebo scénáře: Je důležité zahrnout člověka do smyčky pro ruční kontrolu, když pracujete se scénáři s vysokými sázkami (např. ovlivňujícími následná práva uživatele) nebo citlivými daty. Modely strojového učení nejsou dokonalé. Pečlivě zvažte, kdy zahrnout krok ruční kontroly pro určité pracovní postupy. Například ověření identity na vstupním portu, jako jsou letiště, by mělo zahrnovat lidský dohled.
Pečlivě zvažte použití k udělování nebo zamítání výhod: Technologie dokumentové inteligence nebyla navržena ani vyhodnocena pro udělení nebo odepření výhod a použití v těchto případech může mít nechtěné důsledky. Mezi tyto scénáře patří:
- Zdravotní pojištění: To by zahrnovalo použití zdravotních záznamů a lékařských předpisů jako základ pro rozhodnutí o pojistné odměně nebo odepření.
- Schválení půjčky: Patří sem žádosti o nové půjčky nebo refinanční poskytování stávajících úvěrů.
Pečlivě zvažte podporované typy dokumentů a národní prostředí: Předem připravené modely mají předdefinovaný seznam podporovaných polí a jsou sestaveny pro konkrétní národní prostředí. Nezapomeňte pečlivě zkontrolovat oficiálně podporovaná jazyková nastavení a typy dokumentů, abyste zajistili nejlepší výsledky. Podívejte se například na předdefinované zeměpisné lokace pro účtenky Document Intelligence.
-
Právní a regulační aspekty: Organizace musí vyhodnotit potenciální specifické právní a regulační povinnosti při používání jakýchkoli nástrojů a řešení foundry, které nemusí být vhodné pro použití v každém odvětví nebo scénáři. Nástroje nebo řešení Foundry navíc nejsou určené a nesmí být používány způsoby zakázanými v příslušných podmínkách služeb a příslušných kodexech chování.
Omezení
Technická omezení, provozní faktory a rozsahy
Předem připravená omezení modelu
Předem vytvořené modely funkce Document Intelligence se používají ke zpracování konkrétních typů dokumentů a jsou předem natrénované na tisících formulářů. Tato funkce umožňuje vývojářům začít a získávat výsledky během několika minut bez nutnosti trénovacích dat ani popisků. U předem připravených modelů je důležité si všimnout seznamu vstupních požadavků, podporovaných typů dokumentů a národních prostředí pro každý předem připravený model pro optimální výsledky. Podívejte se například na předem připravené požadavky na zadávání faktur.
Omezení vlastního modelu
Vlastní modely Document Intelligence se trénují pomocí vlastních trénovacích dat, aby model mohl trénovat na konkrétní formuláře a dokumenty. Tato funkce je silně závislá na způsobu označování dat a také na typu trénovací sady dat, kterou zadáte. U vlastních modelů je důležité si uvědomit omezení velikosti trénovacích datových sady, omezení stránek dokumentu a minimálního počtu vzorků potřebných pro každý typ dokumentu. Vlastní modely v současnosti používají model GPT-3.5 služby Azure OpenAI. Další informace o modelech Azure OpenAI najdete v Azure Poznámka k transparentnosti OpenAI.
Stránka Omezení služby obsahuje další informace o kvótách a omezeních služby Document Intelligence pro všechny cenové úrovně. Obsahuje také omezení modelu a osvědčené postupy pro použití modelu a zabránění omezování požadavků.
Podpora funkcí
Seznam různých operací, které můžou provádět modely Document Intelligence, najdete v tabulce Funkce analýzy .
Výkon systému
Přesnost
Text se skládá z řádků a slov na základní úrovni a entit, jako jsou názvy, ceny, částky, názvy společností a produkty na úrovni porozumění dokumentu.
přesnost na úrovni slov
Oblíbená míra přesnosti pro OCR je míra chyb slov (WER) nebo počet nesprávně zobrazených slov v extrahovaných výsledcích. Čím nižší je WER, tím vyšší je přesnost.
WER je definován jako:
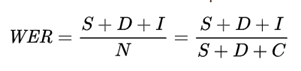
Kde:
| Termín | Definice | Příklad |
|---|---|---|
| S | Počet nesprávných slov ("nahrazeno") ve výstupu | "Samet" se extrahuje jako "Veivet", protože "l" je zjištěn jako "i". |
| D | Počet chybějících ("odstraněných") slov ve výstupu | Text "Název společnosti: Microsoft", nelze extrahovat, protože je ručně psaný nebo obtížně čitelný. |
| I | Počet neexistentních ("vložených") slov ve výstupu. | "Slovo 'Department' se nesprávně segmentuje do tří slov jako 'Dep artm ent.' V tomto případě je výsledkem jedno odstraněné slovo a tři vložená slova." |
| C | Počet správně extrahovaných slov ve výstupu | Všechna slova, která byla správně extrahována. |
| N | Počet celkových slov v referenci (N=S+D+C) s výjimkou I, protože tato slova v původní referenci chyběla a byla nesprávně považována za přítomná. | Představte si obrázek s větou "Microsoft, centrála v Redmondu, WA oznámila nový produkt s názvem Samet pro finanční oddělení." Předpokládejme, že výstup OCR je " , headquartered in Redmond, WA oznámil nový produkt s názvem Veivet for finance dep artm ents." V tomto případě S (Samet) = 1, D (Microsoft) = 1, I (dep artm ents) = 3, C (11) a N = S + D + C = 13. Proto WER = (S + D + I) / N = 5 / 13 = 0,38 nebo 38% (z 100). |
Použití hodnoty spolehlivosti
Jak je popsáno v předchozí části, služba poskytuje hodnotu spolehlivosti pro každé předpovězené slovo ve výstupu OCR. Zákazníci tuto hodnotu používají ke kalibraci svých vlastních prahových hodnot pro obsah a scénáře, aby směrovali obsah pro přímé zpracování nebo předání do procesu s lidským zapojením. Výsledné měření určují přesnost specifickou pro konkrétní scénář.
Dopad na výkon systému OCR se může lišit podle scénářů, ve kterých se používá technologie OCR. Probereme si několik příkladů, které ilustrují tento koncept.
- Dodržování předpisů v lékařském zařízení: V tomto prvním příkladu potřebuje nadnárodní farmaceutická společnost s různorodým portfoliem patentů, zařízení, léků a ošetření analyzovat informace o popiscích výrobků kompatibilní s FDA a dokumenty výsledků analýzy. Společnost může preferovat nižší práh důvěryhodnosti pro zapojení člověka do procesu, protože náklady na nesprávně extrahovaná data mohou mít značný dopad na spotřebitele a pokuty od regulačních agentur.
- Zpracování obrázků a dokumentů: V tomto druhém příkladu společnost provádí zpracování pojistných a úvěrových aplikací. Zákazník, který používá technologii OCR, může preferovat prahovou hodnotu střední spolehlivosti, protože automatizovaná extrakce textu je sloučena do navazujícího procesu s dalšími vstupy informací a začleněním člověka do procesu pro celkovou kontrolu aplikací.
- Moderování obsahu: U velkého objemu dat katalogu elektronického obchodování importovaných od dodavatelů ve velkém měřítku může zákazník preferovat prahovou hodnotu s vysokou mírou spolehlivosti s vysokou přesností, protože i malé procento nepravdě označeného obsahu může generovat spoustu režijních nákladů na týmy a dodavatele lidské kontroly.
Přesnost na úrovni dokumentů a entit
Na úrovni dokumentu, například v případě faktury nebo potvrzení, může být chyba pouze jednoho znaku v celém dokumentu nevýznamná. Pokud je ale tato chyba v textu, který představuje placenou částku, může se celá faktura nebo účtenka označit jako nesprávná.
Další užitečnou metrikou je míra chyb entit (EER). Jedná se o procento nesprávně extrahovaných entit, jako jsou názvy, ceny, částky a telefonní čísla, z celkového počtu odpovídajících entit v jednom nebo více dokumentech. Například pro celkem 30 slov představujících 10 názvů se 2 nesprávná slova z 30 rovná 0,06 (6%) WER. Pokud jsou však 2 ze 10 názvů nesprávné, chybovost názvů EER je 0,20 (20%), což je mnohem vyšší než WER.
Měření WER i EER je užitečné cvičení, které vám pomůže získat úplný přehled o přesnosti porozumění dokumentům.
Osvědčené postupy pro zlepšení výkonu systému
Zvažte následující body týkající se omezení a výkonu:
Služba podporuje obrázky a dokumenty. Povolená omezení počtu stránek, velikostí obrázků, velikostí papíru a velikostí souborů najdete v tématu Co je funkce Document Intelligence?
- Mnoho proměnných může ovlivnit přesnost výsledků OCR, na kterých závisí funkce Document Intelligence. Mezi tyto proměnné patří kvalita skenování dokumentu, rozlišení, kontrast, podmínky světla, otočení a atributy textu, jako je velikost, barva a hustota. Doporučujeme například, aby obrázek byl alespoň 50 × 50 pixelů. Projděte si specifikace produktů a otestujte službu na dokumentech a ověřte, jestli je vhodná pro vaši situaci.
- Všimněte si omezení jednotlivých služeb, pokud jde o aktuálně podporované vstupy, jazyky a národní prostředí a typy dokumentů. Podívejte se například na podporované jazyky rozložení.
Osvědčené postupy pro zlepšení kvality vlastního modelu
Když používáte vlastní model Document Intelligence, poskytnete vlastní trénovací data, aby model mohl trénovat na konkrétní formuláře a dokumenty. Následující seznam používá typ vlastního modelu formuláře ke sdílení úvodních tipů pro zlepšení kvality modelu.
- U vyplněných formulářů použijte příklady, které mají vyplněná všechna pole.
- Používejte formuláře s reálnými hodnotami, které očekáváte pro každé pole.
- Pokud mají obrázky formulářů nižší kvalitu, použijte větší datovou sadu (například 10 až 15 obrázků).
Úplný průvodce a požadavky na vstup najdete v tématu Vytvoření trénovací sady dat pro vlastní model.
Vyhodnocení funkce Document Intelligence
Výkon funkce Document Intelligence se bude lišit v závislosti na reálných řešeních, pro která je implementovaná. Aby se zajistil optimální výkon ve svých scénářích, měli by zákazníci provádět vlastní hodnocení. Služba poskytuje hodnotu spolehlivosti v rozsahu od 0 do 1 pro každé extrahované slovo a mapování klíč-hodnota. Zákazníci by měli spustit pilotní nasazení nebo testování konceptu představující případ použití, aby pochopili rozsah hodnot spolehlivosti a kvalitu extrakce z funkce Document Intelligence. Pak mohou odhadnout prahové hodnoty spolehlivosti pro výsledky, které mají být odeslány pro přímé zpracování (STP) nebo zkontrolovány člověkem. Zákazník může například odeslat výsledky s hodnotami spolehlivosti většími nebo rovnou 80 pro přímé zpracování a použít kontrolu lidí na výsledky s hodnotami spolehlivosti menšími než 0,80.
Vyhodnocení a integrace funkce Document Intelligence pro vaše použití
Microsoft vám chce pomoct zodpovědně vyvíjet a nasazovat řešení, která používají funkci Document Intelligence. Přijímáme principiální přístup k prosazování osobní agentury a důstojnosti tím, že bereme v úvahu nestrannost, spolehlivost a bezpečnost systémů AI, ochranu osobních údajů a zabezpečení, inkluzi, transparentnost a lidskou odpovědnost. Tyto aspekty jsou v souladu s naším závazkem k vývoji zodpovědné umělé inteligence.
Až budete připraveni nasadit produkty nebo funkce využívající AI, následující aktivity vám pomůžou nastavit úspěch:
Seznamte se s tím, co může dělat: Plně vyhodnoťte potenciál funkce Document Intelligence, abyste porozuměli jeho schopnostem a omezením. Porozumíte tomu, jak bude fungovat ve vašem konkrétním scénáři a kontextu. Pokud například používáte předem vytvořený model faktury, otestujte jej pomocí faktur z vašich obchodních procesů, abyste mohli analyzovat a porovnat výsledky s existujícími metrikami procesů.
Respektujte právo jednotlivce na ochranu osobních údajů: Shromážděte pouze údaje a informace od jednotlivců pro zákonné a oprávněné účely. K tomuto účelu používejte pouze data a informace, se kterými souhlasíte.
Právní kontrola: Získejte odpovídající právní kontrolu, zejména pokud ji plánujete používat v citlivých nebo vysoce rizikových aplikacích. Porozumíte omezením, která byste mohli potřebovat pro práci, a zodpovědnost za řešení jakýchkoli problémů, které by mohly v budoucnu nastat.
Human-in-the-loop: Udržujte člověka ve smyčce a zahrňte lidský dohled jako konzistentní oblast vzorů, která se má prozkoumat. To znamená, že zajišťuje nepřetržitý lidský dohled nad produktem nebo funkcí umělé inteligence a udržováním role lidí při rozhodování. Ujistěte se, že v řešení můžete mít zásah člověka v reálném čase, abyste zabránili poškození. Zapojení člověka do procesu umožňuje spravovat situace, kdy Document Intelligence nepracuje podle očekávání.
Zabezpečení: Ujistěte se, že je vaše řešení zabezpečené a že má odpovídající kontrolní mechanismy pro zachování integrity obsahu a zabránění neoprávněnému přístupu.
Doporučení pro zachování ochrany osobních údajů
Úspěšný přístup k ochraně osobních údajů umožňuje jednotlivcům používat informace a poskytuje kontroly a ochranu, aby zachovaly své soukromí.
- Pokud je funkce Document Intelligence součástí řešení určeného k začlenění identifikovatelných osobních údajů (PII), pečlivě se zamyslete nad tím, jestli a jak tato data zaznamenávat. Dodržujte příslušné vnitrostátní a regionální předpisy týkající se ochrany osobních údajů a citlivých údajů.
- Správci ochrany osobních údajů by měli zvážit zásady uchovávání informací o extrahovaném textu a hodnotách a podkladových dokumentech nebo obrázcích těchto dokumentů. Zásady uchovávání informací budou svázané s zamýšleným použitím každé aplikace.
Další informace o zodpovědné umělé inteligenci
- Principy AI společnosti Microsoft
- Microsoft zdroje pro zodpovědné využívání umělé inteligence
- Microsoft Azure Studijní kurzy týkající se zodpovědné umělé inteligence