Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
V tomto kurzu použijete notebooky s prostředím Spark runtime k transformaci a přípravě surových dat ve vašem lakehouse.
Požadavky
Než začnete, musíte dokončit předchozí kurzy v této sérii:
- Vytvoření datového lakehouse
- Příjem dat do datového lakehousu
- Ujistěte se, že ve vašem jezeře jsou povolená schémata lakehouse .
Příprava dat
Podle předchozích kroků kurzu máte nezpracovaná data ingestována ze zdroje do sekce Soubory v datovém lakehouse. Teď můžete tato data transformovat a připravit je na vytváření tabulek Delta.
Stáhněte si poznámkové bloky ze složky Zdrojový kód kurzu Lakehouse.
V prohlížeči přejděte do vašeho pracovního prostoru Fabric na portálu Fabric.
Vyberte Importovat>poznámkový blok>z tohoto počítače.
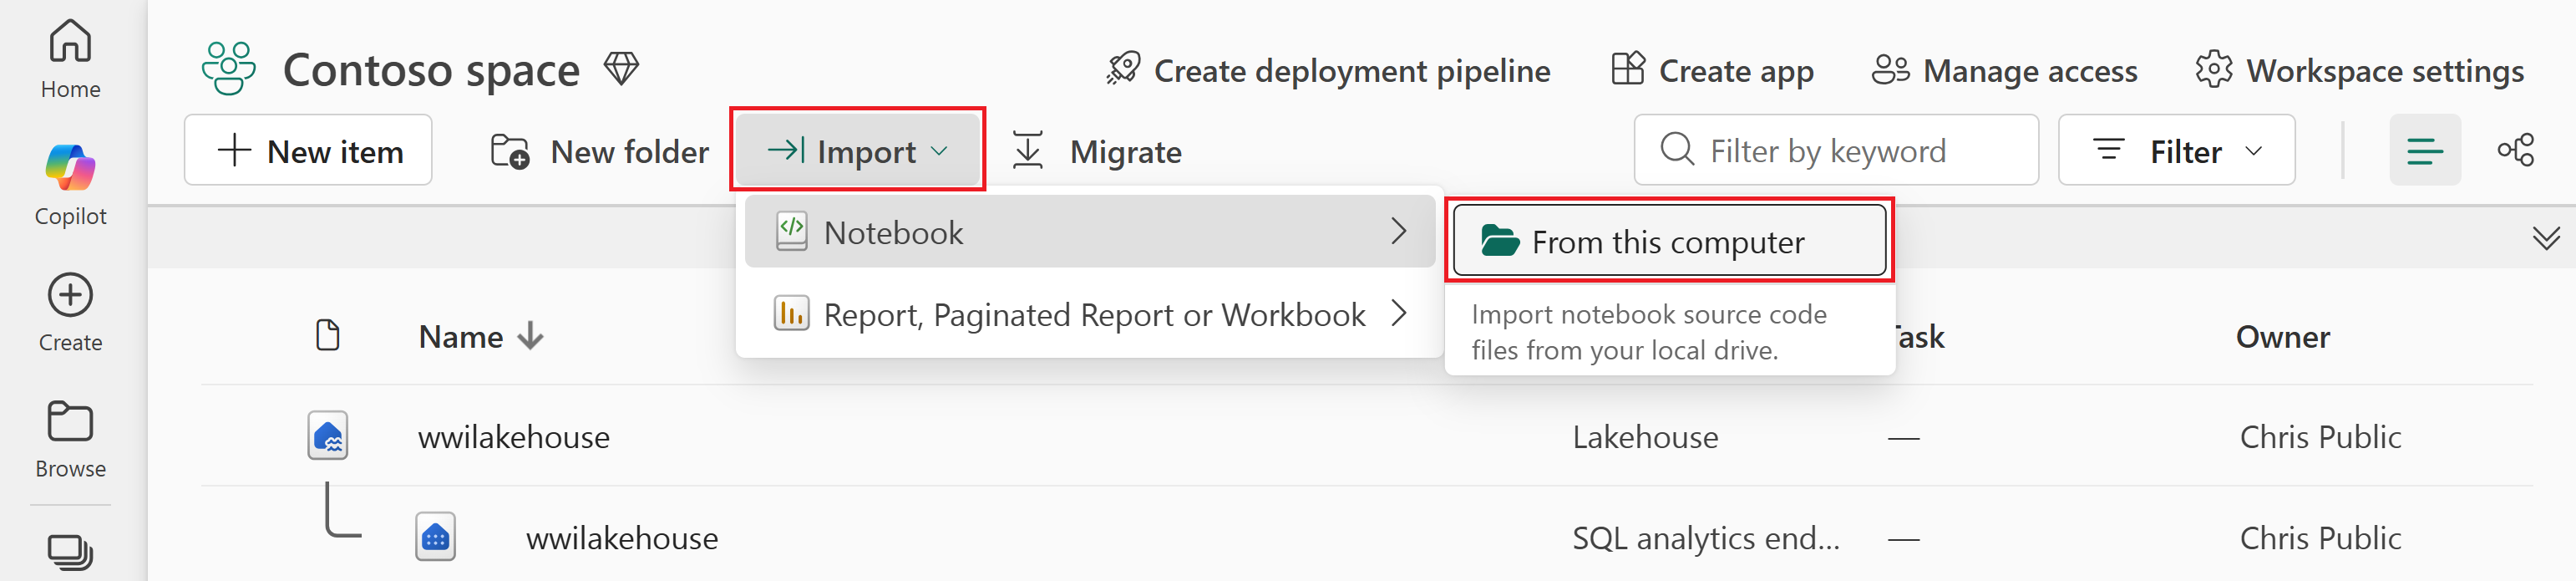
V podokně Stavu importu, které se otevře na pravé straně obrazovky, vyberte Nahrát.
Vyberte jenom notebook, který odpovídá vašemu preferovanému programovacímu jazyku.
-
PySpark (
Prepare and transform data - PySpark.ipynb) -
Spark SQL (
Prepare and transform data - Spark SQL.ipynb)
-
PySpark (
Vyberte Otevřít. V pravém horním rohu okna prohlížeče se zobrazí oznámení o stavu importu.
Po úspěšném importu přejděte do zobrazení položek pracovního prostoru a ověřte importovaný poznámkový blok.
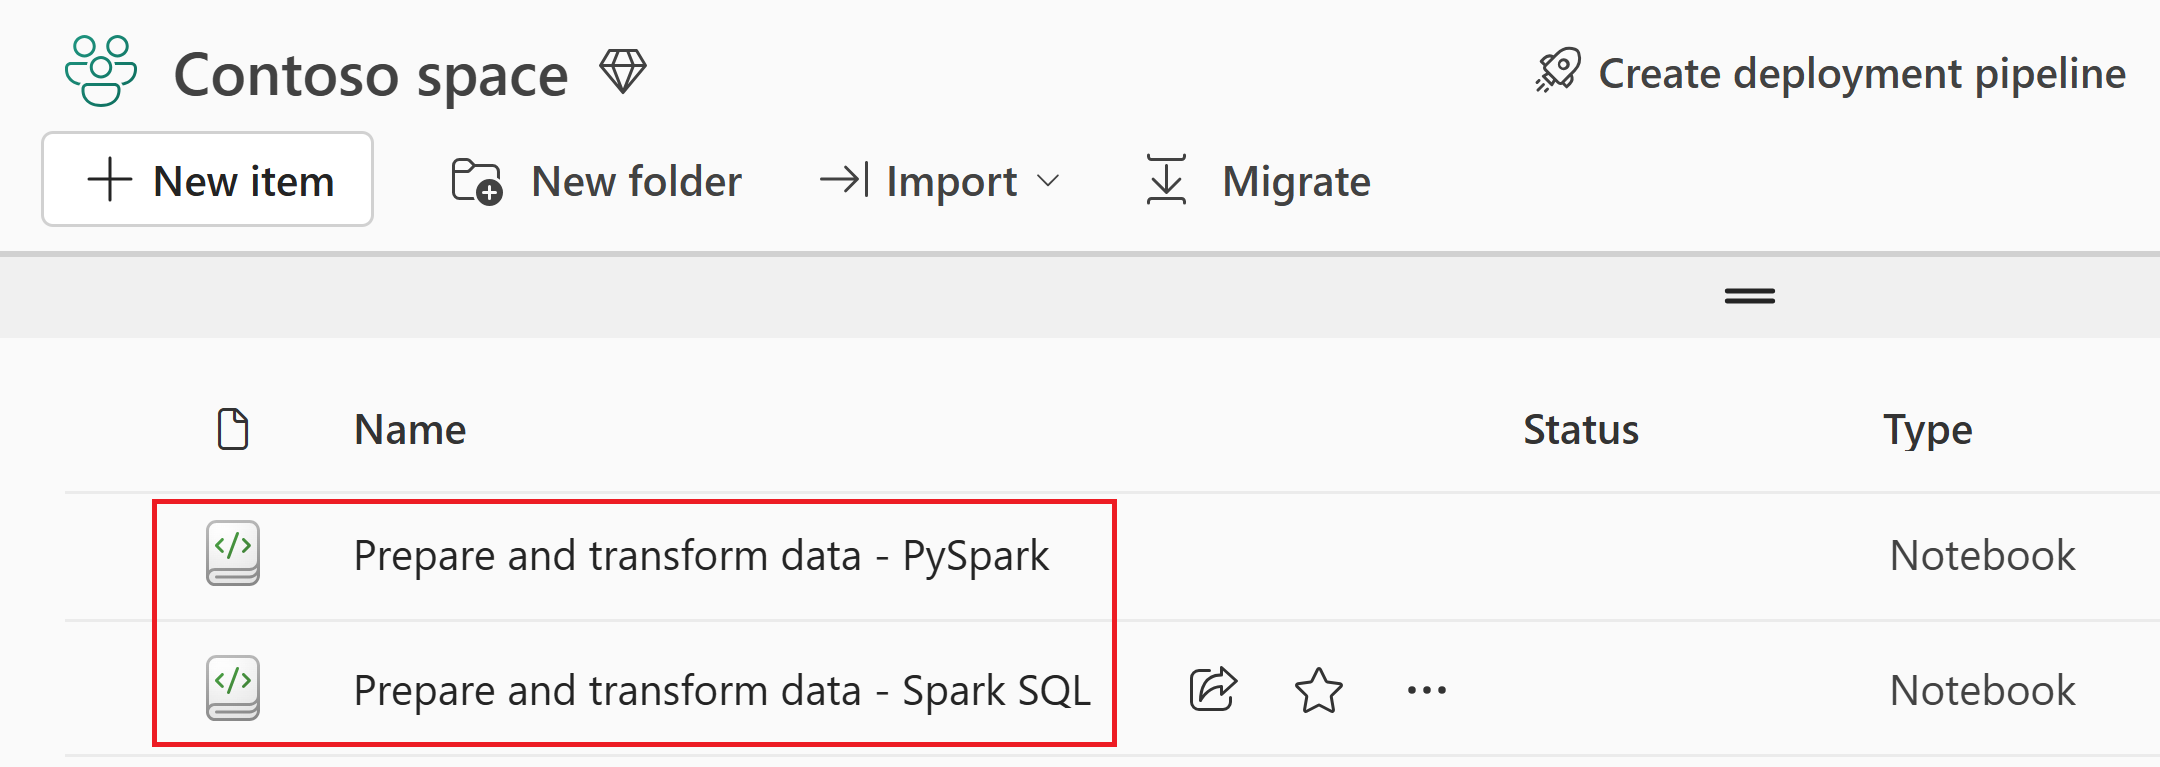
Vyberte wwilakehouse a otevřete ho, aby poznámkový blok, který otevřete, byl k němu propojený.
V horní navigační nabídce vyberte Otevřít poznámkový blok>Existující poznámkový blok.
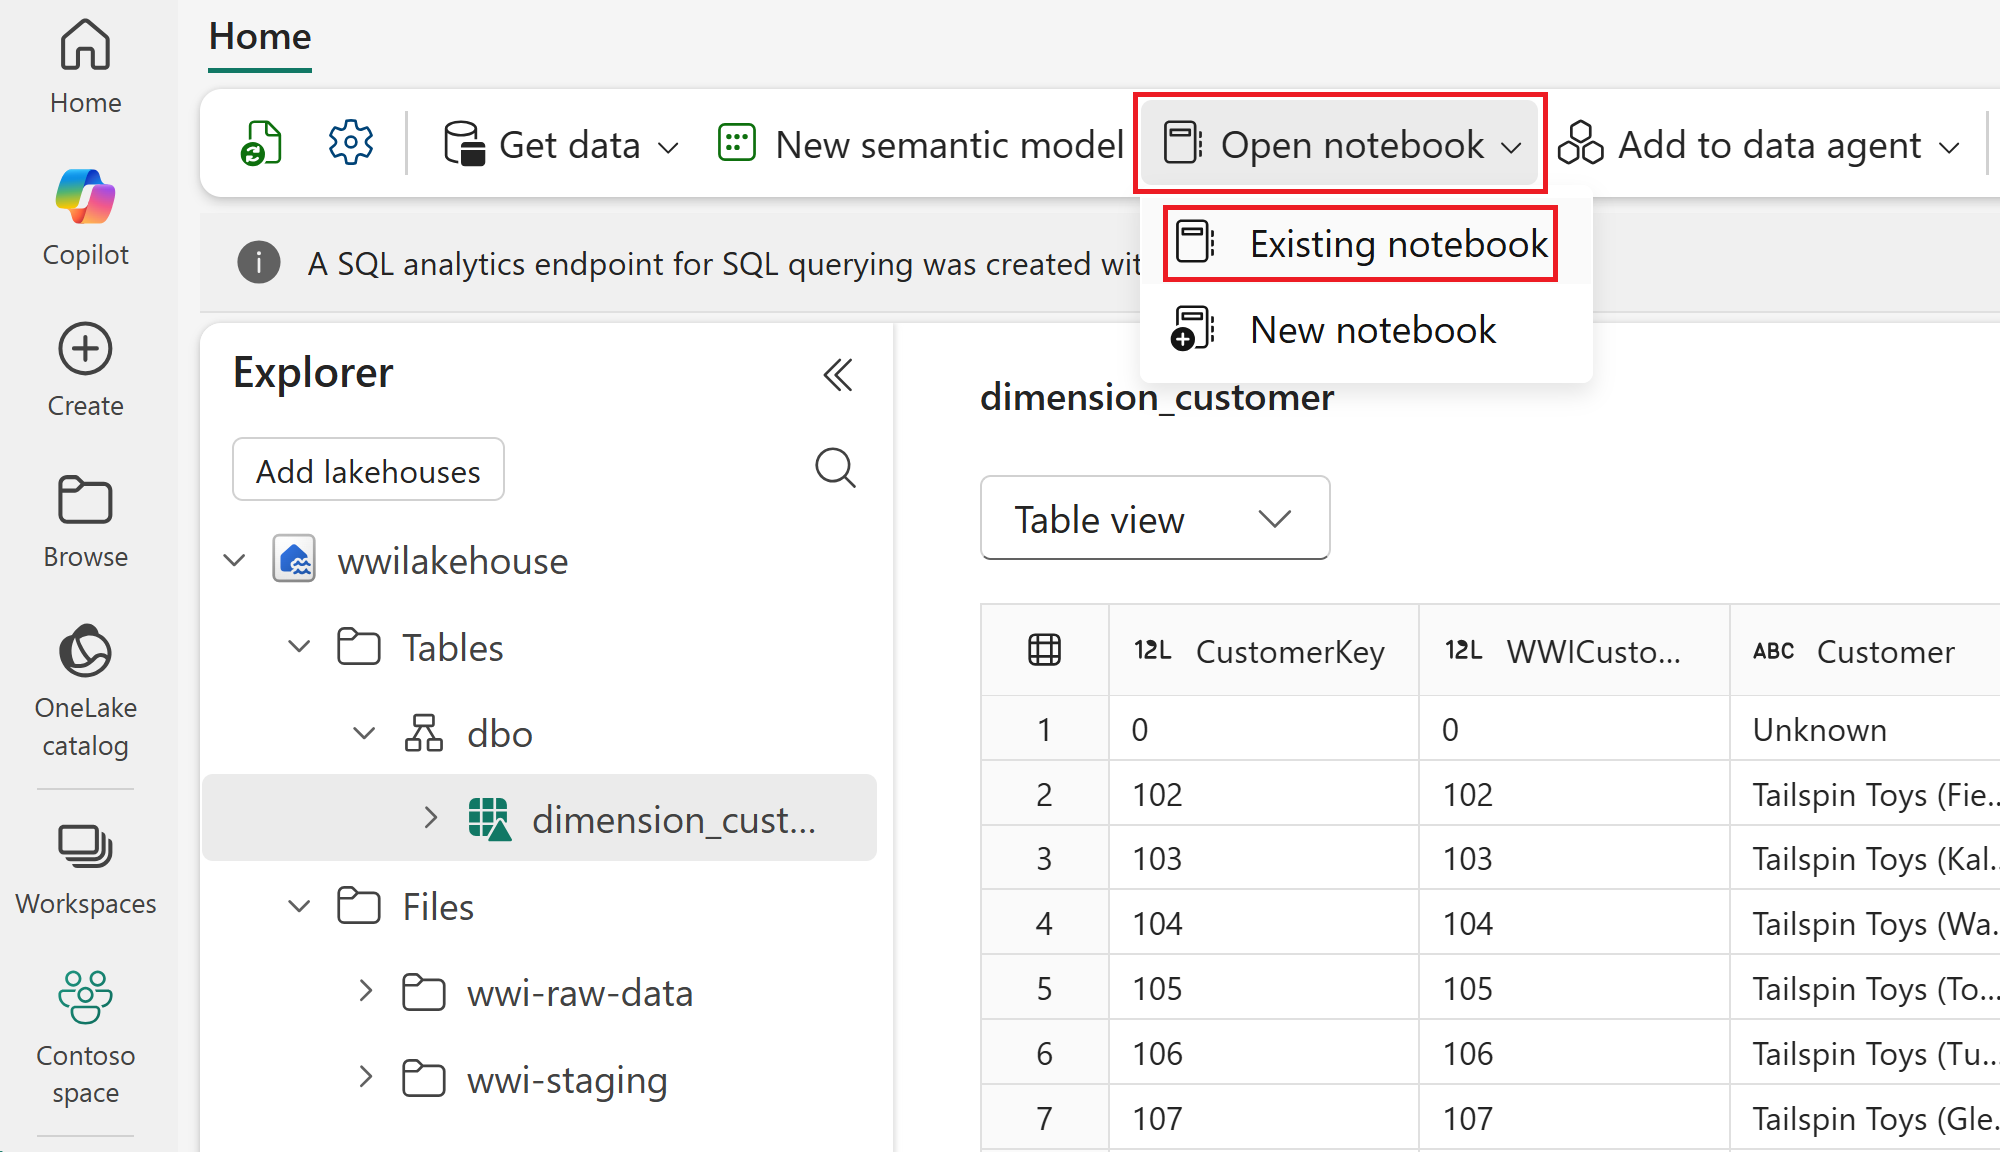
Vyberte importovaný poznámkový blok pro PySpark nebo Spark SQL a vyberte Otevřít. Poznámkový blok je již propojen s vaším otevřeným lakehousem, jak je znázorněno v Průzkumníku.


Teď jste připraveni spustit buňky poznámkového bloku, které vytvářejí a transformují tabulky Delta.
V následujících částech spusťte postupně buňky poznámkového bloku. Pokud chcete buňku spustit, vyberte ikonu Spustit , která se zobrazí nalevo od buňky při najetí myší. Můžete také vybrat Spustit vše na pásu karet nahoře (Domů) aby se spustily všechny buňky postupně.
Důležité
Tento kurz vyžaduje povolení schémat lakehouse. Pokud schémata nejsou povolená, kód v tomto kurzu nebude fungovat podle očekávání.
V importovaném poznámkovém bloku uvidíte oddíly Cesta 1 i Cesta 2 . Pro účely tohoto kurzu použijte cestu 1 (povolená schémata lakehouse) a ignorujte cestu 2 (schémata lakehouse nejsou povolená).
Vytvoření tabulek Delta
V této části spustíte buňky poznámkového bloku a vytvoříte tabulky Delta z nezpracovaných dat.
Tabulky následují podle hvězdicového schématu, což je běžný vzor pro uspořádání analytických dat:
-
Tabulka faktů (
fact_sale) obsahuje měřitelné události firmy – v tomto případě jednotlivé prodejní transakce s množstvími, cenami a ziskem. -
Tabulky dimenzí (
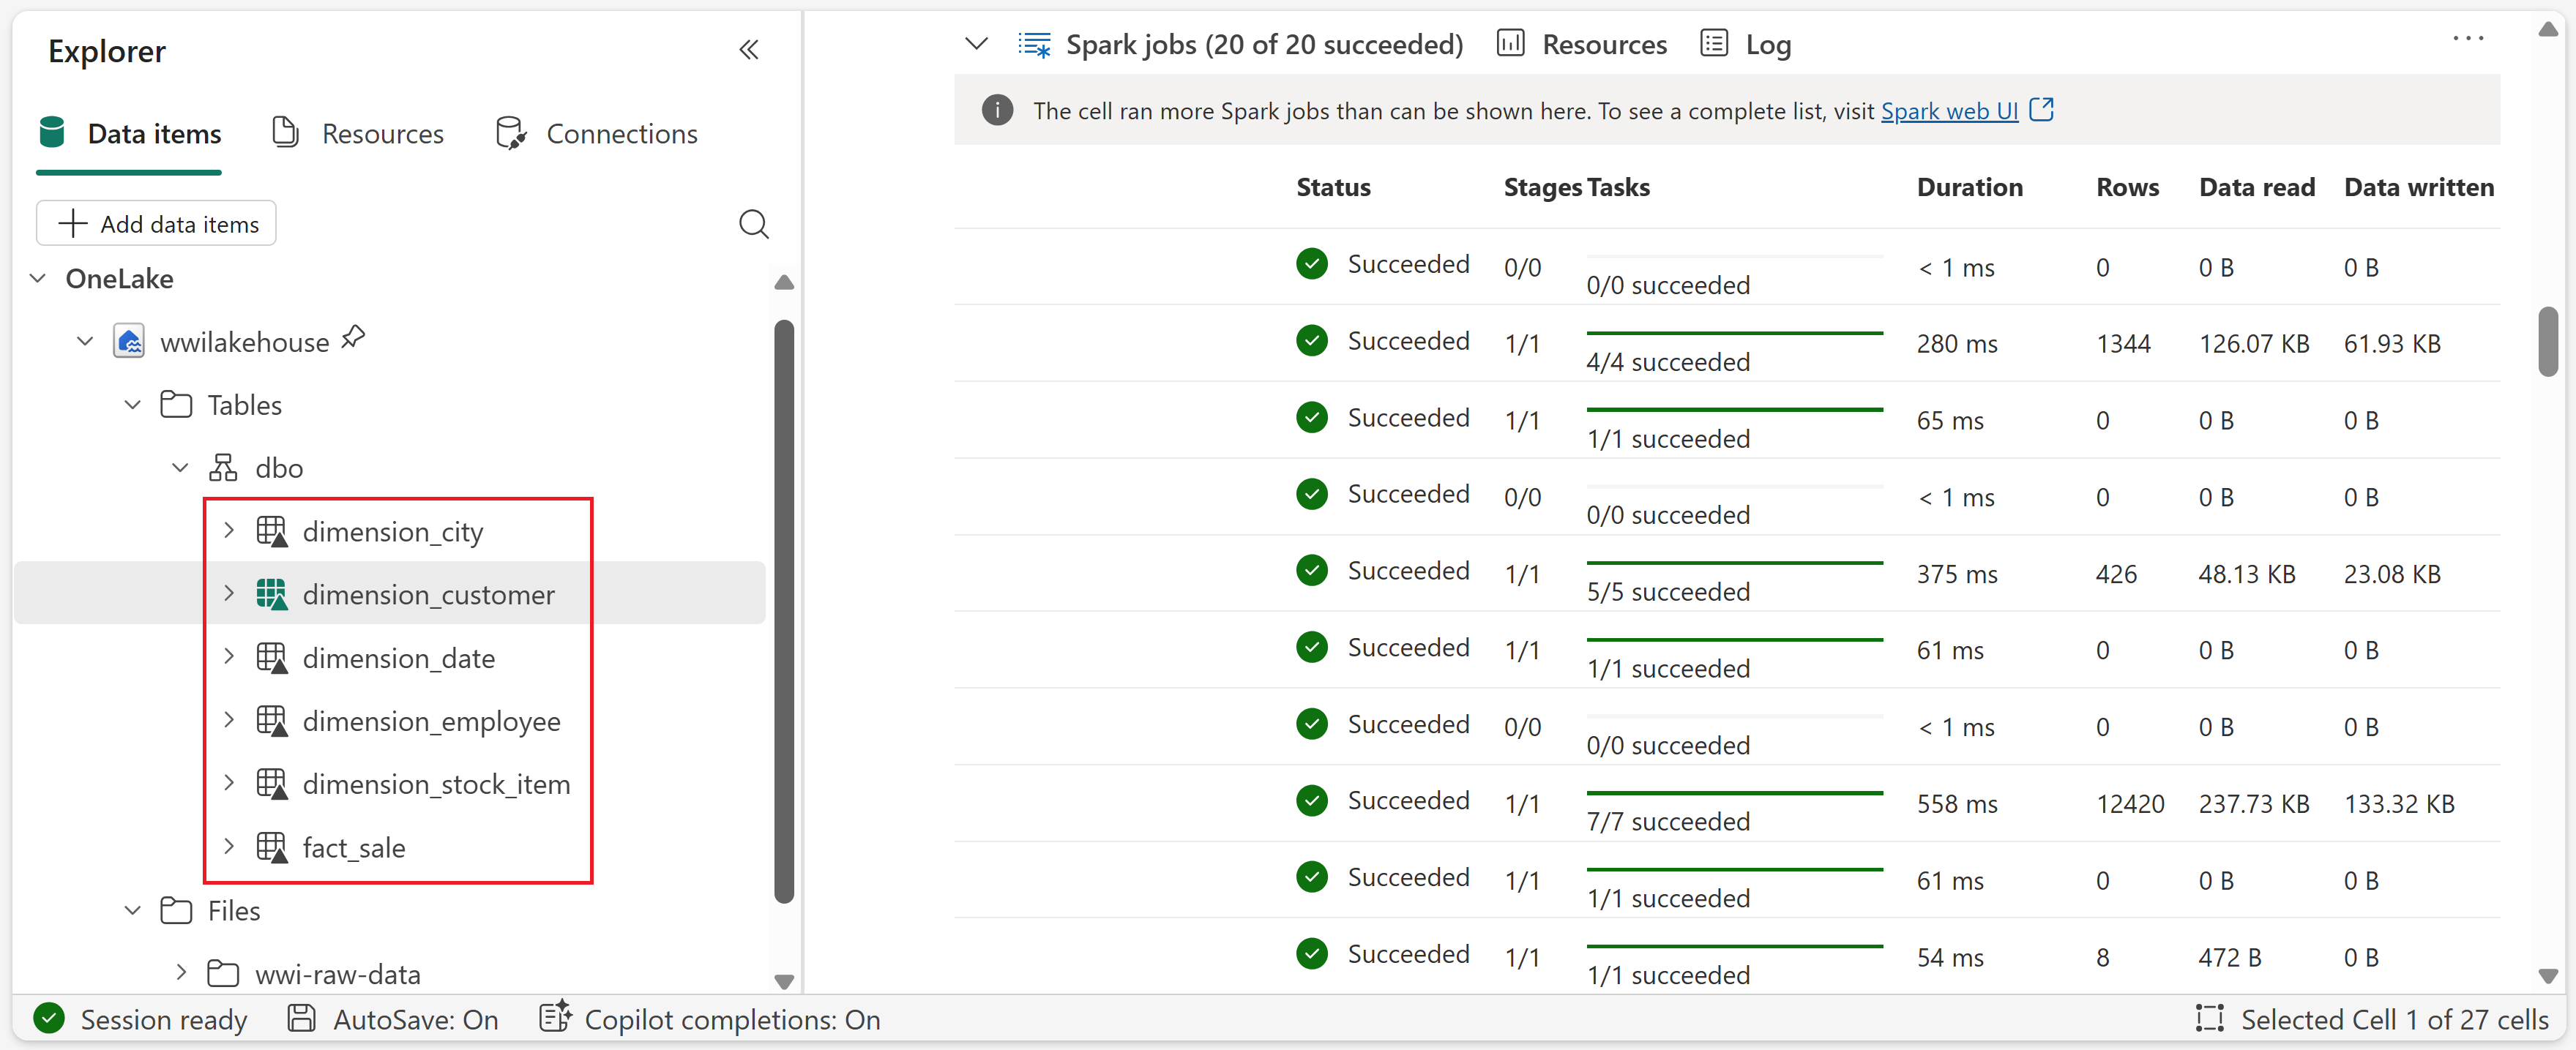
dimension_city,dimension_customer,dimension_date,dimension_employee,dimension_stock_item) obsahují popisné atributy, které poskytují kontext faktům, například kde došlo k prodeji, kdo ho provedl, a kdy.
Na této stránce kurzu vyberte kartu, která odpovídá importovanému poznámkovému bloku, a pro všechny kroky dál použijte stejnou kartu. Karty (záložky) jsou v tomto článku, ne v poznámkovém bloku.
Buňka 1 – Konfigurace relace Sparku Tato buňka umožňuje dvě funkce infrastruktury, které optimalizují způsob zápisu a čtení dat v následujících buňkách. Pořadí V optimalizuje rozložení souborů parquet pro rychlejší čtení a lepší kompresi. Optimalizace zápisu snižuje počet zapsaných souborů a zvyšuje velikost jednotlivých souborů.
Spusťte tuto buňku a počkejte, dokud nebude dokončena, než přejdete k dalšímu kroku.
Buňka 2 - Fakt - Prodej. Tato buňka čte nezpracovaná parquetová data ze
Files/wwi-raw-data/full/fact_sale_1y_full, přidá sloupce dílčích částí kalendářního data (Rok, Čtvrtletí a Měsíc) a zapíšefact_salejako Delta tabulku rozdělenou podle Roku a Čtvrtletí.Spusťte tuto buňku a počkejte, dokud nebude dokončena, než přejdete k dalšímu kroku.
from pyspark.sql.functions import col, year, month, quarter table_name = 'fact_sale' df = spark.read.format("parquet").load('Files/wwi-raw-data/full/fact_sale_1y_full') df = df.withColumn('Year', year(col("InvoiceDateKey"))) df = df.withColumn('Quarter', quarter(col("InvoiceDateKey"))) df = df.withColumn('Month', month(col("InvoiceDateKey"))) df.write.mode("overwrite").format("delta").partitionBy("Year","Quarter").save("Tables/dbo/" + table_name)Buňka 3 – rozměry. Tato buňka čte pět dimenzí parquetových datových sad a zapisuje je jako tabulky Delta (
dimension_city,dimension_customer,dimension_date,dimension_employee, adimension_stock_item) v částiTables/dbo/....Spusťte tuto buňku a počkejte, dokud nebude dokončena, než přejdete k dalšímu kroku.
def loadFullDataFromSource(table_name): df = spark.read.format("parquet").load('Files/wwi-raw-data/full/' + table_name) df = df.drop("Photo") df.write.mode("overwrite").format("delta").save("Tables/dbo/" + table_name) full_tables = [ 'dimension_city', 'dimension_customer', 'dimension_date', 'dimension_employee', 'dimension_stock_item' ] for table in full_tables: loadFullDataFromSource(table)Pokud chcete ověřit vytvořené tabulky, klikněte pravým tlačítkem myši na wwilakehouse lakehouse v průzkumníku a pak vyberte Aktualizovat. Zobrazí se tabulky.

Transformace dat pro obchodní agregace
V této části budete pokračovat ve stejném poznámkovém bloku a spuštěním dalších buněk vytvoříte agregační tabulky z tabulek Delta, které jste vytvořili v předchozí části.
Ujistěte se, že je poznámkový blok stále propojený s wwilakehouse.
Buňka 4 – Načtení zdrojových tabulek pro transformaci (pouze PySpark). Pokud používáte poznámkový blok PySpark, spusťte tuto buňku a načtěte tabulky Delta do datových rámců pro následující kroky agregace.
Spusťte tuto buňku a počkejte, dokud nebude dokončena, než přejdete k dalšímu kroku.
Buňka 5 - Vytvořit
aggregate_sale_by_date_city. Tato buňka spojí data o prodeji, datu a městě a pak vytvoří agregační tabulku na úrovni města.Spusťte tuto buňku a počkejte, dokud nebude dokončena, než přejdete k dalšímu kroku.
sale_by_date_city = ( df_fact_sale.alias("sale") .join(df_dimension_date.alias("date"), df_fact_sale.InvoiceDateKey == df_dimension_date.Date, "inner") .join(df_dimension_city.alias("city"), df_fact_sale.CityKey == df_dimension_city.CityKey, "inner") .select("date.Date", "date.CalendarMonthLabel", "date.Day", "date.ShortMonth", "date.CalendarYear", "city.City", "city.StateProvince", "city.SalesTerritory", "sale.TotalExcludingTax", "sale.TaxAmount", "sale.TotalIncludingTax", "sale.Profit") .groupBy("date.Date", "date.CalendarMonthLabel", "date.Day", "date.ShortMonth", "date.CalendarYear", "city.City", "city.StateProvince", "city.SalesTerritory") .sum("sale.TotalExcludingTax", "sale.TaxAmount", "sale.TotalIncludingTax", "sale.Profit") .withColumnRenamed("sum(TotalExcludingTax)", "SumOfTotalExcludingTax") .withColumnRenamed("sum(TaxAmount)", "SumOfTaxAmount") .withColumnRenamed("sum(TotalIncludingTax)", "SumOfTotalIncludingTax") .withColumnRenamed("sum(Profit)", "SumOfProfit") .orderBy("date.Date", "city.StateProvince", "city.City") ) sale_by_date_city.write.mode("overwrite").format("delta").option("overwriteSchema", "true").save("Tables/dbo/aggregate_sale_by_date_city")Buňka 6 - Vytvořit
aggregate_sale_by_date_employee. Tato buňka spojí data o prodejích, datech a zaměstnancích a pak vytvoří agregační tabulku na úrovni zaměstnance.Spusťte tuto buňku a počkejte, dokud nebude dokončena, než přejdete k dalšímu kroku.
spark.sql(""" CREATE OR REPLACE TEMPORARY VIEW sale_by_date_employee AS SELECT DD.Date, DD.CalendarMonthLabel , DD.Day, DD.ShortMonth Month, CalendarYear Year , DE.PreferredName, DE.Employee , SUM(FS.TotalExcludingTax) SumOfTotalExcludingTax , SUM(FS.TaxAmount) SumOfTaxAmount , SUM(FS.TotalIncludingTax) SumOfTotalIncludingTax , SUM(FS.Profit) SumOfProfit FROM delta.`Tables/dbo/fact_sale` FS INNER JOIN delta.`Tables/dbo/dimension_date` DD ON FS.InvoiceDateKey = DD.Date INNER JOIN delta.`Tables/dbo/dimension_employee` DE ON FS.SalespersonKey = DE.EmployeeKey GROUP BY DD.Date, DD.CalendarMonthLabel, DD.Day, DD.ShortMonth, DD.CalendarYear, DE.PreferredName, DE.Employee ORDER BY DD.Date ASC, DE.PreferredName ASC, DE.Employee ASC """) sale_by_date_employee = spark.sql("SELECT * FROM sale_by_date_employee") sale_by_date_employee.write.mode("overwrite").format("delta").option("overwriteSchema", "true").save("Tables/dbo/aggregate_sale_by_date_employee")Pokud chcete ověřit vytvořené tabulky, klikněte pravým tlačítkem myši na wwilakehouse lakehouse v průzkumníku a pak vyberte Aktualizovat. Zobrazí se agregační tabulky.
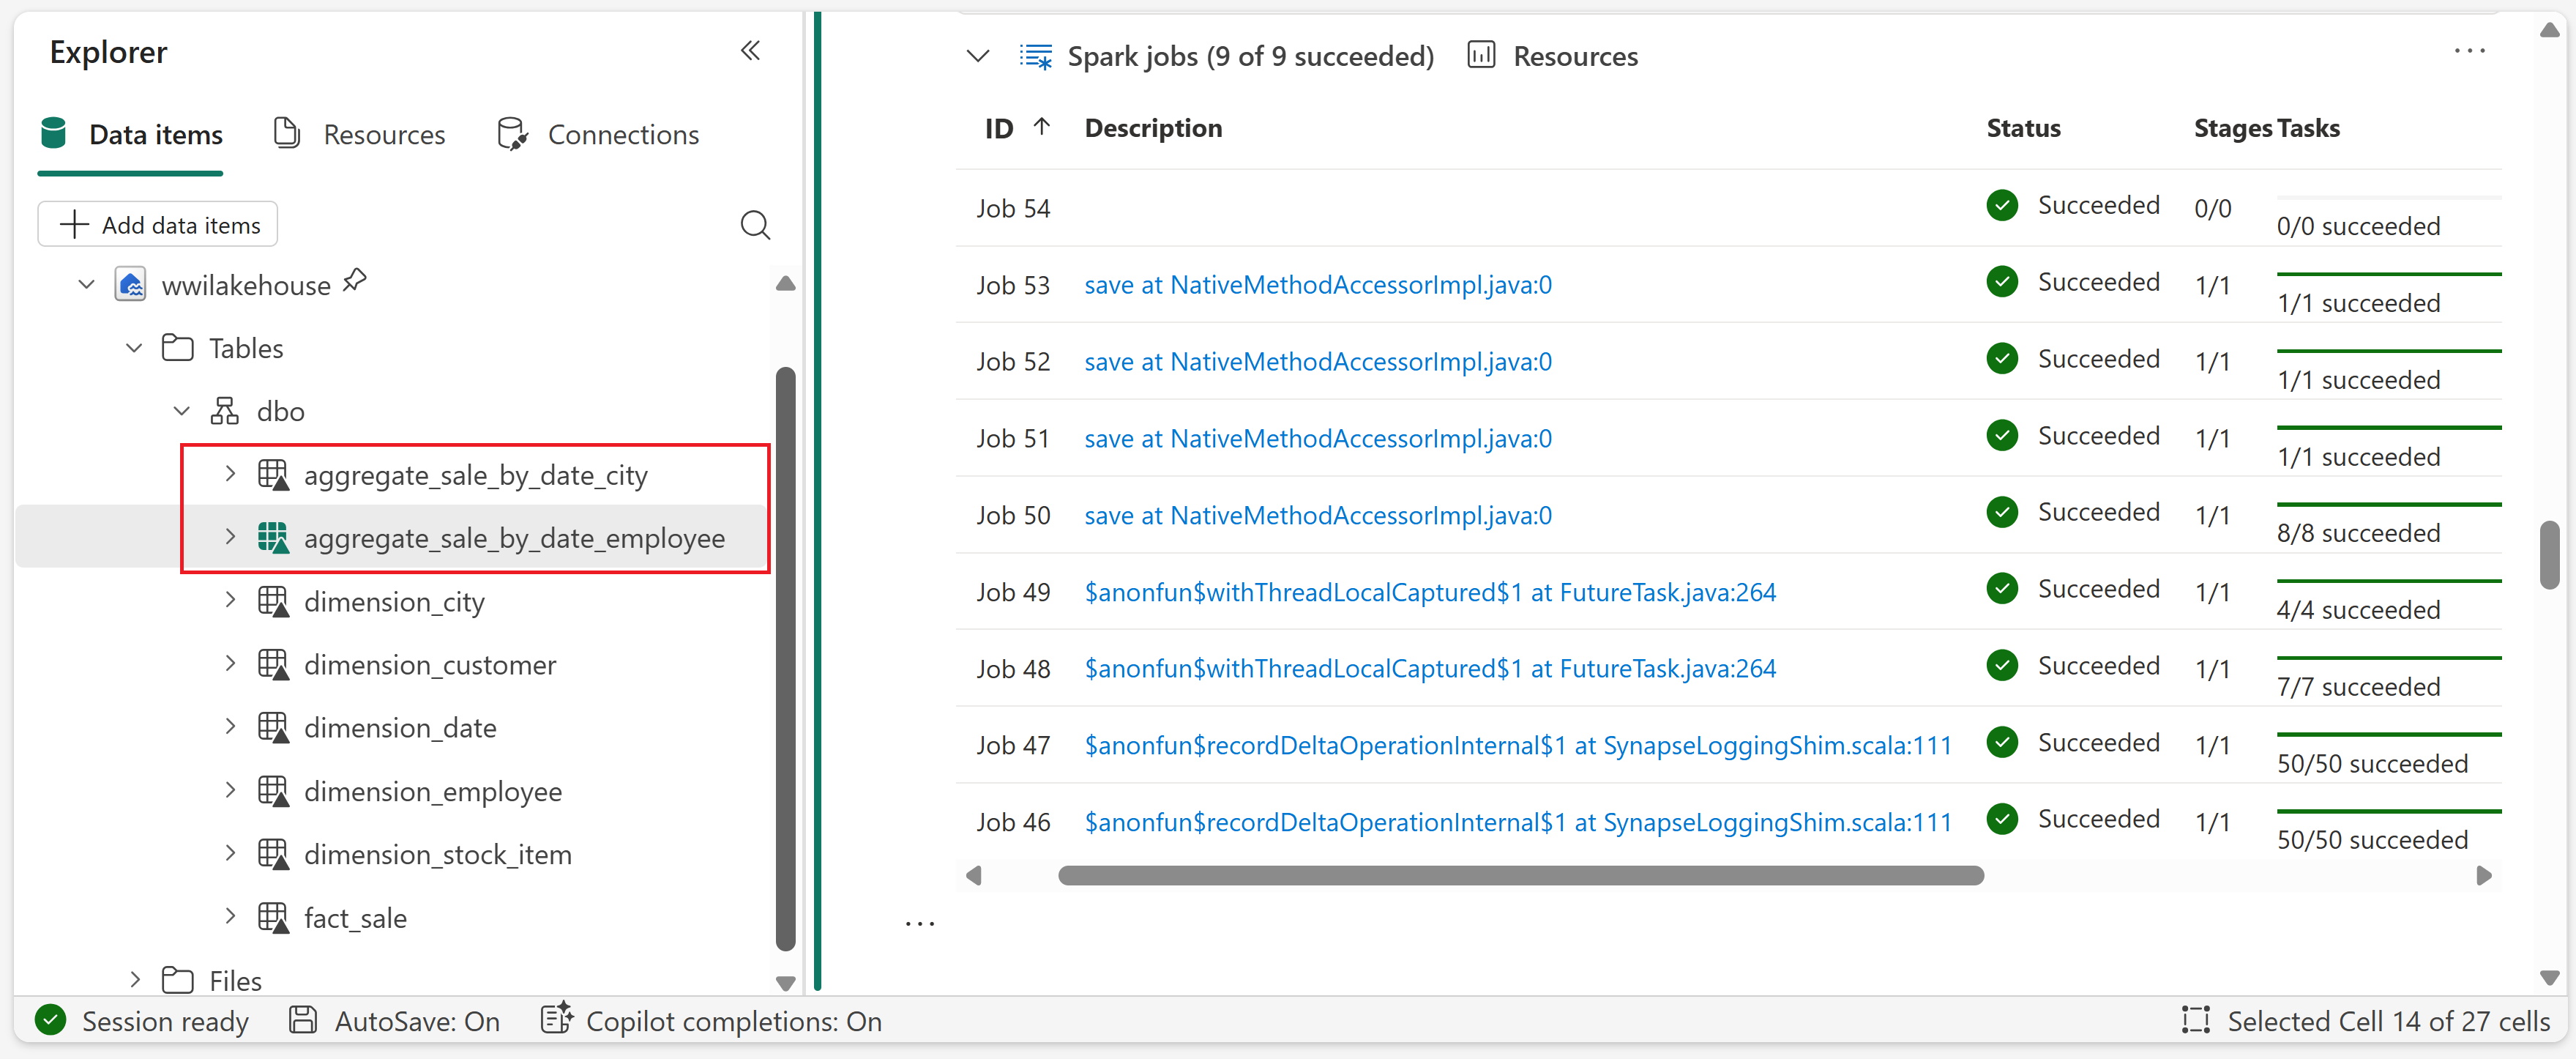

Tento tutoriál zapisuje data jako soubory Delta Lake. Fabric automaticky vyhledá a zaregistruje tyto tabulky v metastoru, takže nemusíte spouštět samostatné CREATE TABLE příkazy.