Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
Gælder for:✅ Warehouse i Microsoft Fabric
Vigtig
Denne funktion er i prøveversion.
I Fabric data warehouse kan T-SQL-udviklere kalde Fabric brugerdatafunktioner fra T-SQL-forespørgsler. En T-SQL-proxyfunktion i et lager kalder den refererede Python-funktion i et offentliggjort element med brugerdatafunktioner.
Brug denne integration til at udvide T-SQL med genanvendelig Python-logik til scenarier såsom:
- Brug af specialiserede PyPI-pakker til rumlige, numeriske eller data science-arbejdsbelastninger.
- Implementering af brugerdefineret forretningslogik i Python.
- Kalder eksterne API'er.
- Interaktion med andre Fabric-elementer og Azure-tjenester, såsom lagre, søhuse, SQL-databaser eller en Cosmos-database.
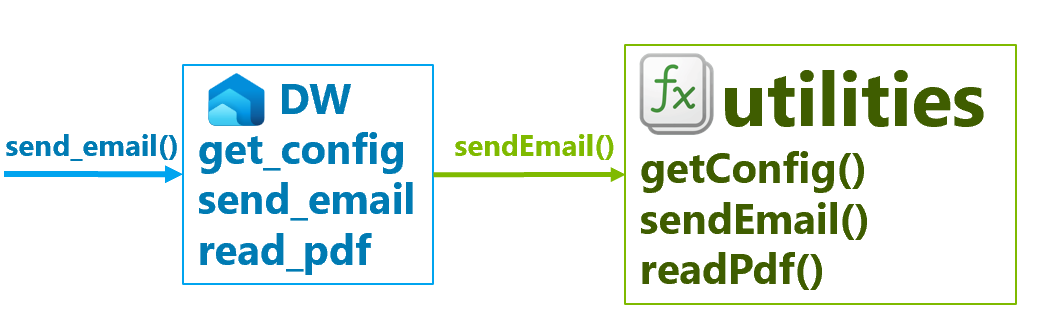
Denne artikel viser, hvordan man refererer til en publiceret brugerdatafunktion fra Fabric data warehouse og bruger den i T-SQL-forespørgsler.
Forudsætninger
For at bruge brugerdatafunktioner fra Fabric data warehouse skal du:
Et stoflager.
Et udgivet user data-funktionselement, der indeholder den Python-funktion, du vil aktivere.
Læseadgang til funktionen for brugerdata og tilladelse til at påkalde de publicerede funktioner.
Tilladelse til at oprette en funktion i mållageret.
En Python-funktion, der følger programmeringsmodellen for brugerdatafunktioner. For syntakskrav, understøttede input- og outputtyper samt brug af dekoratorer, se oversigt over Fabric user data function programming model.
Hvis du skal oprette et nyt element med brugerdatafunktioner, skal du også have en Fabric-kapacitet i et understøttet område og et Fabric-arbejdsområde tildelt den kapacitet. For detaljer, se Oprette en brugerdatafunktion i Fabric and Service detaljer og begrænsninger for Fabric brugerdatafunktioner.
Opret og publicér en brugerdatafunktion
Før du kan kalde en brugerdatafunktion fra et lager, skal du oprette og publicere funktionen i et user data functions item. For komplette trin og eksempler på Python-funktioner, se Opret et element for brugerdatafunktioner i Fabric.
En Python-brugerdatafunktion, som du kunne oprette, vises i følgende eksempel:
import fabric.functions as fn

udf = fn.UserDataFunctions()

@udf.function()
def hello_fabric(name: str) -> str:
    # Your function logic here
    return name
Du bruger navnet på en user data function item til at binde en T-SQL proxy-funktion til Python-funktionen.
Opret en T-SQL-proxyfunktion
Opret en T-SQL-funktion i dit lager og bind den til den publicerede Python-funktion ved at bruge klausulenAS EXTERNAL FUNCTION.
CREATE OR ALTER FUNCTION dbo.hello_fabric
AS EXTERNAL FUNCTION FunctionSetName.hello_fabric;
Erstat FunctionSetName med navnet på dit user data-funktionselement, og erstat hello_fabric med navnet på den publicerede Python-funktion.
Tip
Du kan generere kaldekoden ud fra brugerdatafunktionernes oplevelse og bruge den som udgangspunkt for warehouse-proxyfunktionen.
Som standard udleder CREATE FUNCTION-sætningen parameterlisten og returtypen fra definitionen af den fjerne Fabric User Data Function (UDF). Du kan tilsidesætte den udledte returtype ved at specificere den eksplicit i funktionsdefinitionen. At angive returtypen er nyttigt, når du vil eksponere en mere præcis returtype end den type, der udledes fra den fjernfunktionelle metadata.
CREATE OR ALTER FUNCTION dbo.hello_fabric
RETURNS VARCHAR(100)
AS EXTERNAL FUNCTION FunctionSetName.hello_fabric;
For eksempel udledes en Python-returværdi str typisk som VARCHAR(MAX), men hvis funktionen altid returnerer en værdi med en kendt maksimal længde, kan du eksplicit definere returtypen som VARCHAR(100) eller en anden passende længde for at give mere præcis metadata og typeinformation.
Brug proxyfunktioner i T-SQL-forespørgsler
Efter du har oprettet proxy-funktionen, kald den fra T-SQL ligesom enhver anden brugerdefineret funktion.
Brug proxyfunktionen i forespørgselsudtryk såsom:
-
SELECTlister. -
WHEREklausuler. -
GROUP BYklausuler. - Udtryk i
UPDATEogINSERTudsagn.
Følgende mønster viser, hvordan man kalder en proxyfunktion fra en forespørgsel:
SELECT dbo.<proxy_function_name>(<arguments>) AS function_result;
For avancerede Python-mønstre, understøttede typer, forbindelser og kontekstobjekter, se oversigt over Fabric brugerdatafunktionsprogrammeringsmodel.
Konfigurer batch-tilstand udførelse
Fabric data warehouse kan udføre eksterne brugerdatafunktioner i batch-tilstand.
Batch-tilstand udførelse sender flere funktionskald i en enkelt forespørgsel til den eksterne Fabric User Data Function (UDF)-tjeneste, hvilket reducerer netværksoverhead og anmodningsforsinkelse. En batch kan indeholde op til 900 funktionskald.
Batch-tilstand bruges typisk, når den samme funktion anvendes på værdier fra en eller flere tabellkolonner, hvilket gør det muligt for forespørgselsprocessoren at evaluere mange rækker i et enkelt fjernkald i stedet for at sende en separat anmodning for hver række. Denne metode kan markant forbedre forespørgselsydelsen, især for store datasæt og høj-latens eksterne funktionskald.
For eksempel, når en forespørgsel anvender en brugerdatafunktion på hver værdi i en kolonne, kan Fabric data warehouse gruppere inputværdierne i batches og indsende dem sammen til fjernbehandling. Den fjernservice returnerer en tilsvarende batch af resultater, som derefter integreres i forespørgselsudførelsespipelinen.
For at aktivere batch-tilstand for en brugerdatafunktion:
- Åbn elementet User data functions .
- Gå tilBiblioteksadministrationsindstillinger>.
- Tænd for forhåndsvisningsfunktioner.
Sæt max_batch_size=900 i dekoratoren @udf.function() til at tillade lageret at sende op til 900 inputrækker i hver kald:
Bemærkning
Argumentet max_batch_size er kun tilgængeligt, når batch-mode forhåndsvisningen er aktiveret.
import fabric.functions as fn

udf = fn.UserDataFunctions()

@udf.function(max_batch_size=900)
def normalizeText(value: str) -> str:
    return value.strip().lower()
Efter du har oprettet en T-SQL proxy-funktion, der refererer til en batch-aktiveret brugerdatafunktion (UDF), registrerer Fabric data warehouse automatisk batchkonfigurationen, inklusive den maksimale batchstørrelse defineret af fjernfunktionen. Når forespørgselsmønsteret understøtter batching, grupperer forespørgselsprocessoren flere funktionskald i batches og sender dem til fjerntjenesten til udførelse i stedet for at udsende individuelle anmodninger for hver række.
Lister brugerdatafunktioner i et lager
Brugerdatafunktioner, du opretter med AS EXTERNAL FUNCTION , vises i sys.objects sammen med objekttypen XF.
For at liste brugerdatafunktioner i et lager, filtrer sys.objects efter type = 'XF'.
SELECT SCHEMA_NAME(schema_id) AS schema_name, name, object_id, type, type_desc
FROM sys.objects
WHERE type = 'XF';
For at liste både almindelige skalarfunktioner (FN) og brugerdatafunktioner (XF) sammen med deres parameter- og returtypesignaturer, brug sys.parameters og sys.types:
WITH metadata AS
(
    SELECT o.schema_id, o.object_id, o.name, p.parameter_id, p.name AS parameter_name, t.name AS type_name
    FROM sys.objects AS o
    INNER JOIN sys.parameters AS p
        ON p.object_id = o.object_id
    INNER JOIN sys.types AS t
        ON t.user_type_id = p.user_type_id
    WHERE o.type IN ('FN', 'XF')
),
signature AS
(
    SELECT SCHEMA_NAME(schema_id) AS schema_name,
           name,
           ANY_VALUE(
               CASE WHEN parameter_id = 0 THEN type_name END
           ) AS return_type,
           CONCAT(
               SCHEMA_NAME(schema_id),
               '.',
               name,
               '(',
               STRING_AGG(
                   CASE
                       WHEN parameter_id > 0
                       THEN CONCAT(parameter_name, ' ', type_name)
                   END,
                   ', '
               ) WITHIN GROUP (ORDER BY parameter_id),
               ') -> ',
               MAX(CASE WHEN parameter_id = 0 THEN type_name END)
           ) AS signature
    FROM metadata
    GROUP BY schema_id, object_id, name
)
SELECT *
FROM signature;
Bemærkninger
- T-SQL-proxyfunktionen afhænger af det publicerede element og funktionsnavn for brugerdatafunktioner. Hvis du omdøber eller sletter Python-funktionen, så opdater warehouse-proxyfunktionen derefter.
- Brugerdatafunktionernes programmeringsmodel definerer de understøttede input- og outputtyper. Verdsig, at Python-parameteren og returannotationerne understøtter de værdier, dine T-SQL-forespørgsler sender.
- Brugerdatafunktioner har servicebegrænsninger for anmodningspayload-størrelse, eksekveringstimeout, svarstørrelse, biblioteksstørrelse og logretention. For aktuelle grænser, se Servicedetaljer og begrænsninger for Fabric-brugerdatafunktioner.
- Parameternavne skal bruge camelCase og indeholde typeannotationer. Funktioner dekoreret med
@udf.function()skal også angive en returtype. For de komplette syntaksregler, se oversigt over Fabric user data function programming model. - For indbyggede teksttransformationsfunktioner, der ikke kræver brugerdefineret Python-kode, se Brug AI-funktioner (forhåndsvisning).
Eksempler
Følgende scenarier viser almindelige måder at udvide Fabric data warehouse med brugerdatafunktioner.
A. Udvid T-SQL med IP-adresseparsing
Brug en Python-brugerdatafunktion, når din warehouse-forespørgsel har brug for funktionalitet, som ikke er tilgængelig som en indbygget T-SQL-funktion. For eksempel kan du bruge en IP-adressepakke til at returnere subnettet for en IP-adresse. Du kan anvende denne funktion i batches, når en forespørgsel behandler IP-adresser fra mange rækker. For konfigurationstrin, se Konfigurér batch-tilstand.
Bemærkning
Hvis funktionen bruger en pakke, der ikke er en del af Python-standardbiblioteket, skal pakken tilføjes i Library Management, før du offentliggør user data-funktionselementet. Dette eksempel bruger netaddr pakken.
Definér og publicér Python-funktionen i et element i brugerdatafunktioner:
from netaddr import IPNetwork
import fabric.functions as fn

udf = fn.UserDataFunctions()

@udf.function(max_batch_size=900)
def ipSubnet(ipAddress: str, prefixLength: int = 24) -> str:
    return str(IPNetwork(f"{ipAddress}/{prefixLength}").cidr)
Opret en T-SQL proxy-funktion i warehouse, der refererer til den publicerede Python-funktion:
CREATE OR ALTER FUNCTION dbo.ip_subnet
AS EXTERNAL FUNCTION inet.ipSubnet;
Kald proxyfunktionen fra en warehouse-forespørgsel:
SELECT dbo.ip_subnet('192.168.1.25', 24) AS subnet;
Forventet resultat:192.168.1.0/24
B. Kald et eksternt offentligt API
Brug en brugerdatafunktion, når en warehouse-forespørgsel skal kalde et eksternt API som en del af en databerigelsesarbejdsgang.
I SQL database in Fabric, Azure SQL Database og Azure SQL Managed Instance, sys.sp_invoke_external_rest_endpoint kalder de et HTTPS REST-endpoint. I Fabric data warehouse kan en brugerdatafunktion levere et alternativt mønster ved at indpakke et HTTPS-kald i Python og eksponere det for T-SQL via en proxyfunktion.
Forsigtighed
At kalde et eksternt endpoint kan overføre data uden for dit lager. Brug godkendte endpoints, undgå at sende følsomme data medmindre de er autoriserede, og følg organisationens sikkerheds- og compliance-krav.
Bemærkning
Tilføj nødvendige tredjepartsbiblioteker, såsom requests, i biblioteksadministration , før funktionen offentliggøres.
Definer og publicér Python-funktionen i et element med brugerdatafunktioner. Dette eksempel bruger parameternavne, der ligner :sys.sp_invoke_external_rest_endpoint
import json
import requests
import fabric.functions as fn

udf = fn.UserDataFunctions()

@udf.function()
def invokeExternalRestEndpoint(
    url: str,
    method: str = "GET",
    payload: str | None = None,
    headers: str | None = None,
    timeout: int = 30
) -> str:
    requestHeaders = json.loads(headers) if headers else None
    requestPayload = payload if payload else None

    response = requests.request(
        method=method,
        url=url,
        data=requestPayload,
        headers=requestHeaders,
        timeout=timeout
    )
    response.raise_for_status()
    return response.text
Opret en T-SQL-proxyfunktion i lageret:
CREATE OR ALTER FUNCTION dbo.invoke_external_rest_endpoint
AS EXTERNAL FUNCTION api.invokeExternalRestEndpoint;
Kald proxyfunktionen fra en warehouse-forespørgsel:
SELECT dbo.invoke_external_rest_endpoint(
    'https://ipapi.co/8.8.8.8/country_name/',
    'GET',
    NULL,
    NULL,
    30
) AS response;
C. Brug en konfigurerbar opbevaringsperiode
Brug en brugerdatafunktion, når warehouse-forespørgsler har brug for centralt administrerede konfigurationsværdier fra et Fabric-variabelbibliotek. For eksempel gemmer du en opbevaringsperiode i variabelbiblioteket, henter den via en proxyfunktion og bruger den som talargumentet for DATEADD T-SQL-funktionen.
Før du udgiver funktionen, tilføj en forbindelse fra brugerdatafunktionerne til variabelbiblioteket og noter forbindelsesaliaset. Variabelbiblioteket i dette eksempel indeholder en RETENTION_DAYS værdi som 90.
Definér og publicér Python-funktionen i et element i brugerdatafunktioner:
import fabric.functions as fn

udf = fn.UserDataFunctions()

@udf.connection(argName="varLib", alias="WarehouseConfig")
@udf.function()
def getRetentionDays(varLib: fn.FabricVariablesClient) -> int:
    variables = varLib.getVariables()
    return int(variables["RETENTION_DAYS"])
Erstat WarehouseConfig med aliaset for din variable biblioteksforbindelse.
Opret en T-SQL-proxyfunktion i lageret:
CREATE OR ALTER FUNCTION dbo.get_retention_days
AS EXTERNAL FUNCTION config.getRetentionDays;
På en persistent T-SQL-forbindelse hentes den konfigurerede værdi én gang og gemmes ved at bruge sp_set_session_context:
DECLARE @retention_days int = dbo.get_retention_days();

EXECUTE sys.sp_set_session_context
    @key = N'retention_days',
    @value = @retention_days,
    @read_only = 1;
Værdien forbliver tilgængelig gennem hele sessionens levetid. Hent den med SESSION_CONTEXT og konverter den fra sql_variant til int før du bruger den med DATEADD og GETDATE. For eksempel, beregn en fastholdelsesgrænse:
SELECT DATEADD(
    day,
    -CONVERT(int, SESSION_CONTEXT(N'retention_days')),
    GETDATE()
) AS retention_cutoff;
Genanvend den samme sessionsværdi i en anden sætning til at filtrere en tabel:
SELECT *
FROM dbo.events
WHERE event_timestamp >= DATEADD(
    day,
    -CONVERT(int, SESSION_CONTEXT(N'retention_days')),
    GETDATE()
);
Vigtig
Brug dette mønster fra en klient, der vedligeholder en vedvarende T-SQL-forbindelse, såsom SQL Server Management Studio eller MSSQL-udvidelsen til Visual Studio Code. SQL-forespørgselseditoren i Fabric-portalen understøtter sp_set_session_contextikke , og hver kørsel bruger en separat session. For mere information, se SQL-forespørgselseditorens begrænsninger.
Fejlfinding af brugerdatafunktioner
Query Insights leverer den eksekverings- og ydelsesinformation, du har brug for til at fejlfinde Fabric-funktioner. Du kan identificere forespørgsler, der har kaldt en funktion, afgøre om funktionen brugte batch- eller rækkeeksekvering, og undersøge ekstern serviceforsinkelse, gentagelser, fejlede rækker og payload-størrelse. Brug følgende to visninger til at gå fra et overblik på forespørgselsniveau til detaljerede statistikker for hver funktion:
- Brug
queryinsights.exec_requests_historyden til at identificere forespørgsler, der kaldte Fabric- eller AI-funktioner. Visningen inkluderer forespørgselsteksten, status, indsendelsestid og den samlede forløbne tid. - Brug
queryinsights.external_api_call_statsden til at få detaljerede statistikker for hver funktion, der kaldes af en forespørgsel. Visningen inkluderer funktionstype, eksekveringstilstand, opkald og genprøver, ventetid for ekstern service, nyttelaststørrelse og rækkeresultater.
Visningerne bruges distributed_statement_id til at identificere den samme forespørgselskørsel.
Find forespørgsler, der brugte Fabric-funktioner
Brug queryinsights.exec_requests_history den til at finde nylige udsagn, der har påkaldt en Fabric- eller AI-funktion:
SELECT TOP 100
       h.distributed_statement_id,
       h.submit_time,
       h.status,
       h.total_elapsed_time_ms,
       h.command
FROM queryinsights.exec_requests_history AS h
WHERE h.is_using_external_api = 1
ORDER BY h.submit_time DESC;
Kopier den distributed_statement_id til den erklæring, du vil undersøge. Den næste forespørgsel filtrerer de detaljerede statistikker til Fabric-funktioner.
Se statistik for hver funktion i en sætning
Erstat <distributed_statement_id> med en identifikator, der blev returneret af den forrige forespørgsel. Følgende forespørgsel returnerer én række for hver forskellig Fabric-funktion, der kaldes af sætningen:
DECLARE @distributed_statement_id uniqueidentifier =
    '<distributed_statement_id>';

SELECT function_name,
       execution_mode,
       call_count,
       batch_call_count,
       row_call_count,
       call_retry_count,
       external_service_wait_time_ms,
       external_service_wait_time_ms
           / call_count AS average_wait_time_ms_per_call,
       rows_total,
       rows_succeeded,
       rows_failed,
       data_sent_bytes,
       data_received_bytes
FROM queryinsights.external_api_call_stats
WHERE distributed_statement_id = @distributed_statement_id
  AND function_type = 'FABRIC_FUNCTION'
ORDER BY external_service_wait_time_ms DESC;
Resultaterne ligner følgende eksempel:
| function_name | execution_mode | call_count | batch_call_count | row_call_count | call_retry_count | external_service_wait_time_ms | average_wait_time_ms_per_call | rows_total | rows_succeeded | rows_failed | data_sent_bytes | data_received_bytes |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
inet.ipSubnet |
batch |
12 | 12 | 0 | 0 | 840 | 70 | 600 | 600 | 0 | 12,000 | 9,600 |
api.invokeExternalRestEndpoint |
row |
4 | 0 | 4 | 1 | 1,920 | 480 | 4 | 4 | 0 | 1,024 | 512 |
Tip til fejlfinding
- En høj
row_call_counteller enexecution_modeværdi afrowkan indikere, at funktionen ikke bruger batch-eksekvering. Hvis du forventer batching, bekræft at batch-mode preview er aktiveret, og at funktionen bruger argumentetmax_batch_size. - Brug
external_service_wait_time_msogaverage_wait_time_ms_per_callidentificer langsomme eksterne reaktioner. Hvis disse værdier er høje mensdata_sent_bytesogdata_received_byteser lave, er den eksterne serviceresponstid sandsynligvis den primære forsinkelse. - Store
data_sent_bytesellerdata_received_bytesværdier kan også øge eksekveringstiden. Reducer input- eller outputpayloaden, når funktionen overfører mere data, end scenariet kræver.