Azure NetApp Files
Microsoft Fabric
Azure AI 검색
Microsoft Foundry
Azure Machine Learning
솔루션 아이디어
이 문서에서는 솔루션 아이디어를 설명합니다. 클라우드 설계자는 이 지침을 사용하여 이 아키텍처의 일반적인 구현을 위한 주요 구성 요소를 시각화할 수 있습니다. 이 문서를 시작점으로 사용하여 워크로드의 특정 요구 사항에 맞는 잘 설계된 솔루션을 디자인할 수 있습니다.
이 솔루션 아이디어는 Azure NetApp Files Object REST API를 통해 조직에서 먼저 별도의 개체 저장소에 복사하지 않고도 분석 및 AI에 기존 엔터프라이즈 파일 데이터를 사용하는 방법을 설명합니다. Amazon S3 호환 애플리케이션은 문서 검색 및 AI 지원 분석을 지원할 수 있으며 기존 NFS 및 SMB 워크플로는 해당 데이터에 계속 액세스합니다. 별도의 원본 데이터 복사를 피하면 분석 워크로드를 온보딩하는 시간을 줄이고, 중복 스토리지 비용을 절감하고, 팀이 빌드, 모니터링 및 문제 해결해야 하는 동기화 파이프라인을 제거할 수 있습니다. 또한 원본 데이터 리포지토리가 적으면 제어하고 보호할 복사본이 줄어듭니다. 이 방법은 조직이 기존 파일 기반 애플리케이션을 대체할 필요 없이 증분 현대화를 지원합니다.
Architecture
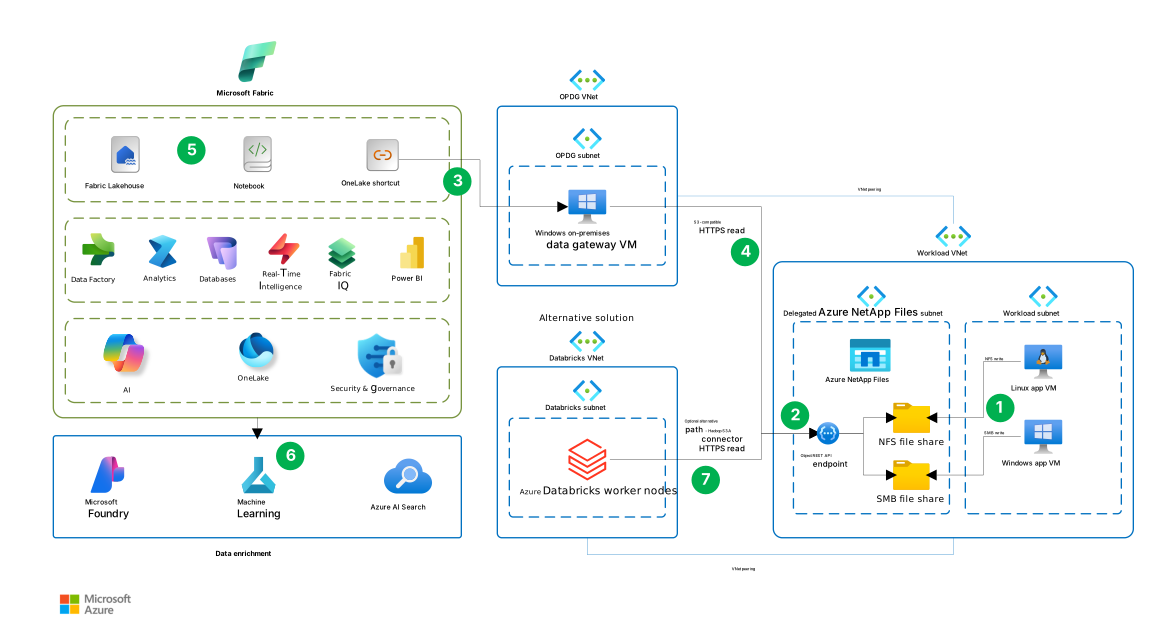
이 아키텍처는 Object REST API를 통해 Azure NetApp Files와의 Microsoft Fabric 통합에 중점을 둡니다. 또한 이 다이어그램은 Azure Databricks가 동일한 Azure NetApp Files 데이터를 사용하는 대체 분석 소비자임을 보여 줍니다. 두 플랫폼을 모두 배포할 필요는 없습니다. 기존 애플리케이션은 볼륨 구성 및 클라이언트 요구 사항에 따라 NFS 또는 SMB를 통해 데이터에 계속 액세스합니다.
Azure Databricks 컴퓨팅은 Hadoop S3A 커넥터를 사용하여 S3 호환 요청을 통해 Azure NetApp Files Object REST API 엔드포인트에 액세스합니다. 이 대체 분석 경로는 온-프레미스 데이터 게이트웨이 또는 Microsoft OneLake를 사용하지 않습니다.
다이어그램의 다운스트림 AI 서비스는 예시적입니다. 수집 통합은 표시되지 않습니다.
이 아키텍처의 Visio 파일을 다운로드하십시오.
데이터 흐름
다음 번호가 매겨진 상호 작용은 아키텍처 다이어그램을 설명합니다. 1~5단계에서는 주요 Microsoft Fabric 경로를 설명합니다. 6단계는 선택적 다운스트림 데이터 보강을 나타냅니다. 7단계는 Fabric 흐름의 연속이 아닌 대체 분석 경로입니다. HTTPS 읽기 요청 레이블이 지정된 화살표는 개체 REST API 엔드포인트에 대한 요청을 표시합니다. 요청된 데이터가 소비자에게 반환됩니다.
애플리케이션은 파일 데이터를 씁니다. 워크로드 서브넷에서 Linux 애플리케이션 VM은 NFS 파일 공유에 기록하고, Windows 애플리케이션 VM은 SMB 파일 공유에 기록합니다. Azure NetApp Files는 위임 서브넷에서 두 공유 모두를 호스팅합니다.
개체 REST API는 파일 데이터를 제공합니다. 위임된 ANF 서브넷의 엔드포인트는 Azure NetApp Files 볼륨에서 구성된 디렉터리에 대한 S3 호환 액세스 권한을 제공합니다. 엔드포인트에서 NFS 및 SMB 공유로의 연결은 별도의 개체 저장소에 대한 복사본이 아니라 기존 데이터에 대한 액세스를 나타냅니다.
Fabric은 OneLake 바로 가기를 통해 데이터에 액세스합니다. 바로 가기는 OPDG(온-프레미스 데이터 게이트웨이) 서브넷에서 Windows 온-프레미스 데이터 게이트웨이 VM을 사용하는 연결을 통해 Azure NetApp Files 데이터를 참조합니다. OneLake 바로가기가 이 게이트웨이에 연결되어 있습니다.
게이트웨이는 Object REST API에서 데이터를 읽어옵니다. 게이트웨이는 OPDG VNet과 워크로드 VNet 간의 피어링을 사용하여 엔드포인트에 도달합니다. S3 호환 HTTPS 읽기 경로는 게이트웨이를 엔드포인트에 연결하며, 엔드포인트는 Fabric용 참조 파일 데이터에 액세스합니다. 연결 요구 사항은 OneLake를 Azure NetApp Files 볼륨에 연결을 참조하세요.
Fabric 데이터를 처리하고 분석합니다. 지원되는 Fabric 워크로드는 바로가기를 통해 데이터를 사용합니다. 예를 들어, 노트북은 참조된 파일을 읽고 분석과 Power BI 보고에 활용하기 위해 파생된 결과를 레이크하우스 테이블에 기록합니다. 다이어그램의 Fabric 상자에는 이러한 처리 및 분석 기능이 나타납니다.
선택적 다운스트림 서비스는 데이터를 보강합니다. Fabric 아래의 화살표는 Microsoft Foundry, Azure Machine Learning 및 Azure AI 검색가 포함된 데이터 보강 그룹으로 연결됩니다. 이 단계는 선택적 다운스트림 처리를 의미합니다. 다이어그램은 이러한 서비스를 연결하는 데 필요한 수집 또는 오케스트레이션을 표시하지 않으며 OneLake 바로 가기는 이러한 통합을 설정하지 않습니다.
또는 Azure Databricks 파일 데이터를 직접 읽습니다. Databricks 서브넷의 작업자 노드는 Hadoop S3A 커넥터를 사용하여 피어된 가상 네트워크를 통해 동일한 개체 REST API 엔드포인트에 HTTPS 읽기 요청을 보냅니다. 이 경로는 3~5단계의 Fabric 액세스 및 처리 경로를 대체합니다. 온-프레미스 데이터 게이트웨이 또는 OneLake를 통과하지 않습니다.
데이터를 사용하는 방법에 따라 바로 가기 위치를 선택합니다.
- 호환되는 기존 델타 테이블입니다. 레이크하우스의 테이블 섹션에서 트랜잭션 로그를 포함하여 전체 델타 테이블을 대상으로 하는 테이블 바로 가기를 만듭니다. Fabric는 대상을 Spark 및 SQL 분석 엔드포인트를 통해 쿼리할 수 있는 테이블로 인식하지만 원본 데이터는 Azure NetApp Files에 유지됩니다.
- 직접 액세스 또는 처리를 위한 파일입니다. 레이크하우스의 Files 섹션에서 바로 가기를 만드세요. 호환되는 워크로드는 먼저 원본 파일을 OneLake에 복사하지 않고도 문서 외에도 독립 실행형 Parquet, CSV 및 JSON 파일을 읽을 수 있습니다. 다운스트림 분석에 레이크하우스 테이블이 필요한 경우 OneLake에서 원본 데이터를 파생 Delta 테이블에 변환하거나 로드합니다.
독립 실행형 Parquet 파일은 자동으로 Delta 테이블로 변환되지 않습니다. 파일 안의 바로 가기는 대상을 테이블로 자동으로 등록하지 않습니다. 자세한 내용은 레이크하우스에서 바로 가기를 배치할 위치를 참조하세요.
Components
다음 구성 요소는 Fabric 중심 아키텍처 및 선택적 Azure Databricks 대안을 지원합니다.
Azure NetApp Files는 NetApp 기술을 기반으로 하는 완전 관리형 파일 스토리지 서비스입니다. 이 아키텍처에서는 엔터프라이즈 데이터 세트를 저장하고 Object REST API를 통해 NFS, SMB 및 S3 호환 개체 액세스를 제공합니다. 스냅샷 및 복제 기능도 제공합니다.
Azure NetApp Files Object REST API는 S3 호환 인터페이스를 통해 기존 파일 데이터를 노출합니다. 이 아키텍처에서는 호환되는 분석 및 AI 애플리케이션이 먼저 별도의 개체 스토리지 복사본을 만들지 않고도 데이터에 액세스할 수 있습니다. 인터페이스는 Amazon S3 작업의 하위 집합을 지원합니다. 이 통합을 선택하기 전에 지원되는 작업이 애플리케이션의 요구 사항을 충족하는지 확인하세요.
Microsoft Fabric은 데이터 이동, 데이터 처리, 수집, 변환, Real-Time Intelligence를 통한 스트림 처리 및 보고서 빌드를 통합하는 분석 플랫폼입니다. 이 아키텍처에서는 OneLake 바로 가기를 통해 Azure NetApp Files 데이터를 처리하고 분석하기 위한 분석 플랫폼을 제공합니다.
OneLake는 Fabric 통합 논리 데이터 레이크입니다. 이 아키텍처에서 OneLake 바로 가기는 참조된 Azure NetApp Files 데이터를 지원되는 Fabric 워크로드에서 해당 데이터를 사용할 수 있도록 합니다.
Azure Virtual Network 이 아키텍처의 Azure 리소스 간에 프라이빗 연결을 제공합니다. 가상 네트워크 피어링을 사용하면 게이트웨이 가상 머신 및 선택적 Azure Databricks 컴퓨팅이 Azure NetApp Files Object REST API 엔드포인트에 도달할 수 있습니다.
온-프레미스 데이터 게이트웨이는 OneLake 바로 가기를 Azure NetApp Files 버킷 엔드포인트에 연결하는 역할을 합니다. 이름에도 불구하고 이 아키텍처에서 게이트웨이는 지원되는 Windows 운영 체제가 있는 Azure 가상 머신에서 표준 모드로 실행됩니다. 게이트웨이 설치 요구 사항을 충족하는 이미지를 선택합니다. Server Core 설치 및 Windows 컨테이너는 지원되지 않습니다. 게이트웨이는 Azure Relay를 통해 아웃바운드 연결을 시작하여 Fabric와 통신합니다. Fabric에서 들어오는 인바운드 연결은 필요하지 않습니다. 온-프레미스 데이터 게이트웨이에 대한 통신 설정 조정에 설명된 아웃바운드 엔드포인트를 허용하도록 방화벽 또는 프록시를 구성합니다.
Azure Databricks 데이터 엔지니어링 및 기계 학습 워크로드를 위한 선택적 대체 분석 플랫폼입니다. 해당 Spark 작업은 Fabric 통합 경로를 사용하는 대신 Azure NetApp Files 데이터 세트에 액세스하기 위해 개체 REST API 엔드포인트에 대해 구성된 Hadoop S3A 커넥터를 사용합니다.
Alternatives
이 아키텍처에는 워크로드의 기능 및 비기능 요구 사항에 따라 다른 Azure 서비스 또는 접근 방식을 대체할 수 있는 여러 구성 요소가 포함되어 있습니다. 다음과 같은 대안과 장만을 고려하세요.
Storage
Azure Blob Storage 및 Azure NetApp Files 중에서 선택할 때 애플리케이션의 프로토콜 요구 사항 및 측정된 성능을 고려합니다.
클라이언트가 Blob Storage REST API 또는 NFS 3.0을 사용할 수 있고 SMB 또는 NFS 4.1이 필요하지 않은 경우 Blob Storage를 선택합니다. 두 인터페이스 모두 동일한 데이터에 액세스할 수 있습니다. Blob Storage NFS 3.0 액세스 경로는 짧은 대기 시간보다 처리량이 더 중요한 고처리량의 읽기 집약적인 순차 워크로드에 최적화되어 있습니다.
애플리케이션 및 분석 워크로드가 SMB 또는 NFS 4.1 및 S3 호환 개체 REST API를 통해 동일한 파일에 액세스해야 하는 경우 또는 파일 애플리케이션에 대기 시간이 짧은 임의 I/O가 필요한 경우 Azure NetApp Files를 선택합니다. Azure NetApp Files에 이미 있는 데이터의 경우 개체 REST API는 원본 애플리케이션 또는 데이터를 마이그레이션하지 않고 분석 액세스를 추가합니다.
두 옵션 모두 소스 애플리케이션과 분석의 동시 부하 조건에서 엔드투엔드 대기 시간 및 처리량을 측정합니다. NFS 또는 SMB 성능은 개체 REST API 또는 Fabric 성능을 판단할 수 없으므로 워크로드 요구 사항에 대해 의도한 액세스 경로를 테스트하세요. 애플리케이션 변경, 마이그레이션, 진행 중인 중복 및 동기화를 비롯한 총 비용을 비교합니다. 프로토콜 및 워크로드를 비교하려면 Azure 스토리지 서비스 비교를 참조하세요.
Integration
Azure Databricks 작업은 Hadoop S3A 커넥터를 사용하여 OneLake 또는 온-프레미스 데이터 게이트웨이 없이 Object REST API를 통해 Azure NetApp Files 데이터를 읽을 수 있습니다. TLS 트러스트를 구성하고 안전하게 저장된 자격 증명을 구성하고 쓰기 저장에 의존하기 전에 필요한 쓰기 작업의 유효성을 검사합니다. 초기화 스크립트가 필요한 경우 현재 Azure Databricks init-script 지침에 따라 지원되는 컴퓨팅의 Unity 카탈로그 볼륨에 저장된 클러스터 범위 스크립트를 사용합니다.
시나리오 세부 정보
동일한 데이터 세트가 탑재된 파일 시스템을 필요로 하는 애플리케이션과 S3 호환 객체 인터페이스를 필요로 하는 분석 또는 AI 서비스 모두에 사용되어야 하는 경우 이 패턴을 사용합니다.
가상 머신 또는 컨테이너에서 실행되는 애플리케이션은 NFS 또는 SMB를 통해 Azure NetApp Files 계속 사용할 수 있습니다. 예를 들어 기존 파일 액세스 코드, 탑재된 공유 및 디렉터리 구조를 사용할 수 있습니다. Azure NetApp Files Object REST API는 볼륨의 루트 디렉터리 또는 하위 디렉터리를 S3 호환 버킷에 매핑하므로 호환되는 개체 클라이언트가 동일한 기본 파일에 액세스할 수 있습니다.
이 방법은 개체 스토리지를 사용하도록 원본 애플리케이션을 변경하지 않고 기존 파일 기반 워크로드에 분석 또는 AI 기능을 추가하려는 경우에 유용합니다. 다운스트림 워크플로는 필요에 따라 변환된 데이터 세트, 인덱스, 임베딩 및 캐시와 같은 파생 데이터를 만들 수 있습니다.
파일 및 개체 클라이언트가 동일한 데이터에 액세스할 때 ID, 권한, 잠금 및 애플리케이션 일관성 요구 사항의 차이를 고려합니다. 객체 소비자가 처리하기 전에 생산자가 파일 또는 일괄 처리가 완료되었음을 알리는 방법을 정의합니다. 생산자는 준비 상태를 알리기 전에 파일 작성을 완료하고 닫고 소비자가 파일을 처리하는 동안 해당 파일을 변경하지 않은 상태로 두어야 합니다. 중단된 쓰기 및 처리 재시도에 대해 이 핸드오프를 테스트합니다.
ID 및 권한 부여 모델도 액세스 방법에 따라 다릅니다. 사용자별 원래 파일 사용 권한은 자동으로 Fabric로 승계되지 않습니다. 의도한 소비자에 대한 Fabric 권한을 구성하고 Object REST API에서 사용하는 ID가 필요한 원본 데이터에만 액세스할 수 있는지 확인합니다. 자세한 내용은 보안을 참조하세요.
소비자마다 서로 다른 수준의 접근 권한이 필요한 경우 디렉터리를 별도의 버킷에 매핑합니다. 파생 데이터의 데이터 분류, 보존, 다운스트림 권한 부여 및 거버넌스는 워크로드의 책임 사항으로 남아 있습니다. 자세한 내용은 버킷 만들기를 참조하세요.
잠재적인 사용 사례
이 아키텍처는 Azure NetApp Files에 이미 저장된 구조화되거나 구조화되지 않은 데이터를 분석해야 하는 워크로드를 지원할 수 있습니다. 다음 예제에서는 Fabric에서 해당 데이터를 사용할 수 있는 다양한 방법을 보여 줍니다.
문서 처리
애플리케이션은 NFS 또는 SMB를 사용하여 문서, 이미지 또는 기타 구조화되지 않은 파일을 Azure NetApp Files에 저장할 수 있습니다. Fabric 노트북은 OneLake 바로 가기를 사용하여 완료된 파일을 읽고 해당 내용을 추출하도록 Azure Document Intelligence와 같은 문서 처리 서비스로 보낼 수 있습니다. 유효성 검사, 분석 및 보고를 위해 결과로 생성된 구조화된 데이터를 레이크하우스 테이블에 저장합니다.
통합 지침은 SynapseML을 통한 문서 인텔리전스 통합을 참조하세요.
데이터 분석
애플리케이션은 CSV나 Parquet 파일 등의 구조화된 데이터를 Azure NetApp Files 공유에 기록할 수 있습니다. Fabric Notebook은 OneLake 바로 가기를 사용하여 완료된 파일을 읽고, 다른 레이크하우스 데이터와 결합하고, 파생된 결과를 lakehouse 테이블에 쓸 수 있습니다.
이 패턴은 소스 애플리케이션이 파일을 저장하는 방식을 변경할 필요 없이 엔지니어링 및 품질 분석, 센서 데이터 분석, 운영 보고서 작성과 같은 시나리오를 지원합니다.
기존의 호환 가능한 Delta 데이터 세트의 경우, 트랜잭션 로그를 포함한 Delta 테이블 전체를 대상으로 하는 OneLake 바로 가기를 레이크하우스의 테이블 섹션에서 만듭니다. 그런 다음 Fabric이 대상을 테이블로 인식할 수 있으며 원본 데이터는 Azure NetApp Files에 유지할 수 있습니다. 자세한 내용은 레이크하우스에서 바로 가기를 배치할 위치를 참조하세요.
AI 검색 및 검색 결과 반환
Azure NetApp Files에 저장된 문서는 AI 워크로드의 소스 콘텐츠로도 활용될 수 있습니다. 예를 들어 처리 워크플로는 OneLake 바로 가기를 통해 문서를 읽고 이를 사용하여 RAG(검색 보강 생성)를 위한 Azure AI 검색 인덱스 작성을 수행할 수 있습니다.
검색 인덱스와 모든 임베딩은 파생된 데이터이며 원본 파일과는 별도로 저장됩니다. 인덱싱된 콘텐츠가 원본의 업데이트, 이름 변경 및 삭제와 계속 동기화되도록 워크플로를 설계합니다. 또한 원래의 SMB 및 NFS 권한이 자동으로 사용자별 검색 권한이 되지 않으므로, 인덱싱된 콘텐츠를 가져올 때 적절한 액세스 제어를 시행해야 합니다.
동일한 패턴을 다른 AI 워크로드로 확장할 수 있습니다. 예를 들어 Fabric Notebook은 원본 파일에서 데이터 세트를 준비하고 Azure Machine Learning에서 사용할 수 있도록 준비된 데이터를 OneLake에 저장할 수 있습니다. 통합 옵션 및 제한 사항에 대해서는 OneLake를 Azure Machine Learning과 통합 문서를 참조하세요.
Considerations
이러한 고려 사항은 워크로드의 품질을 개선하는 데 사용할 수 있는 지침 원칙 집합인 Azure Well-Architected Framework의 핵심 요소를 구현합니다. 자세한 내용은 Well-Architected Framework를 참조하세요. 자세한 지침은 Azure NetApp Files에 대한 Well-Architected Framework 권장 사항을 참조하세요.
Reliability
안정성은 애플리케이션이 고객에 대한 약정을 충족할 수 있도록 하는 데 도움이 됩니다. 자세한 내용은 안정성을 위한 디자인 리뷰 체크리스트를 확인하세요.
Azure NetApp Files는 ONTAP 기반의 내결함성 베어메탈 인프라에서 실행되며 고가용성 SLA를 제공합니다. 가용성 영역 또는 지역 중단에 대한 추가 보호를 위해 필요에 따라 영역 간 또는 지역 간 복제를 구성할 수 있습니다. 이 복제는 비동기적이며 대상 볼륨으로 고객이 시작해야 하는 장애 조치(failover)가 필요합니다. 복제 옵션을 선택하고 워크로드의 복구 목표에 따라 일정을 설정합니다. 자세한 내용은 Azure NetApp Files 안정성을 참조하세요.
또한 하나의 데이터 세트를 공유하면 스토리지 가용성이 파일 애플리케이션 및 분석에 대한 공통 의존 요소가 됩니다. 이러한 스토리지 기능은 게이트웨이, 인덱싱 파이프라인 또는 이를 사용하는 애플리케이션에 대한 종단 간 가용성을 보장하지 않습니다. 게이트웨이, 다운스트림 처리 및 파생 데이터를 포함한 전체 워크로드에 맞게 복구 목표를 설정합니다.
단일 게이트웨이 가상 머신은 Fabric 통합 경로에 대한 단일 장애 지점입니다. 비즈니스에 중요한 워크로드의 경우 별도의 가상 머신에서 실행되는 게이트웨이 멤버를 최소 두 개 이상 게이트웨이 클러스터에 배포합니다. 모든 멤버가 Object REST API 엔드포인트에 도달하고 필요한 아웃바운드 연결을 설정할 수 있는지 확인합니다. 게이트웨이 멤버를 사용할 수 없게 될 때 워크로드의 동작을 테스트합니다.
- 파일 및 볼륨 복구는 공간 효율적인 지정 시간 스냅샷을 통해 지원됩니다. 팀은 실수로 삭제, 손상 또는 분석 프로세스가 실패한 후 개별 파일을 복원하거나, 전체 볼륨을 되돌리거나, 복구 지점에서 새 볼륨을 만들 수 있습니다. 사용 가능한 복구 작업은 Azure NetApp Files의 스냅샷 기반 데이터 보호를 참조하세요.
Security
보안은 의도적인 공격 및 중요한 데이터 및 시스템의 오용에 대한 보증을 제공합니다. 자세한 내용은 보안을 위한 디자인 검토 체크리스트를 참조하세요.
원본 데이터 복사본을 적게 유지 관리하면 보호할 리포지토리 수가 줄어들 수 있습니다. Azure NetApp Files는 저장 데이터를 암호화하고 개체 REST API는 TLS를 사용하여 전송 중인 데이터를 보호합니다. 파일 액세스 권한은 프로토콜에 따라 달라집니다.
SMB 및 NFS 클라이언트는 기존 인증 및 권한 부여 모델을 계속 사용합니다. 기존 NTFS ACL(액세스 제어 목록), NFS 권한 및 ID 매핑 규칙은 해당 클라이언트에 계속 적용됩니다.
개체 REST API 클라이언트는 S3 액세스 키를 사용하여 인증합니다. 버킷 권한은 클라이언트가 매핑된 디렉터리 내에서 읽기 전용 또는 읽기-쓰기 액세스 권한이 있는지 여부를 정의합니다. 개체 요청에는 개별 SMB, NFS 또는 다운스트림 사용자의 ID가 포함되지 않습니다. Azure NetApp Files는 버킷에 구성된 가장된 파일 시스템 ID 엔터티로 모든 개체 작업을 수행합니다. 기존 파일 권한 및 ACL은 해당 ID에 대해서만 평가됩니다.
가장된 파일 시스템 ID는 NFS 볼륨의 UID(사용자 ID) 및 GID(그룹 ID) 또는 SMB 볼륨의 사용자 계정입니다. 이중 프로토콜 볼륨은 구성된 보안 스타일과 일치하는 ID 형식을 사용합니다. 이 ID는 파일 액세스 권한을 결정합니다. S3 액세스 키는 객체 클라이언트를 인증합니다. 자세한 내용은 개체 REST API 보안 및 권한을 참조하세요.
OneLake S3 호환 바로 가기는 액세스 키 ID와 시크릿 액세스 키를 사용하여 버킷에 대해 인증합니다. 원본 NTFS ACL, NFS 권한 및 개별 파일 소유자 ID는 OneLake에 복사되거나 매핑되지 않습니다. Fabric 사용자는 OneLake 및 Fabric 권한에 의해 인가됩니다. 버킷 및 가장된 ID를 통해 바로 가기에 노출된 콘텐츠에만 액세스할 수 있지만 OneLake는 원래 사용자별 파일 권한을 적용하지 않습니다. Microsoft Entra 기반 OAuth, 서비스 주체 및 RoleArn은 이 바로 가기 유형에서는 지원되지 않습니다.
예를 들어 Fabric 사용자는 개인 SMB 계정이 직접 읽을 수 없는 경우에도 Fabric 권한이 액세스를 허용하고 버킷의 가장된 ID가 문서를 읽을 수 있는 경우에도 바로 가기를 사용하여 문서를 읽을 수 있습니다. 디렉터리를 노출하기 전에 의도한 Fabric 대상 사용자에게 해당 콘텐츠에 액세스할 권한이 있는지 확인합니다.
워크로드에 필요한 원본 권한만 사용하여 버킷의 가장된 ID를 구성합니다. 바로 가기 및 레이크하우스에 대한 액세스를 제한합니다. Azure Key Vault 기반의 인증서 워크플로 및 자격 증명 저장소를 사용하여 TLS 인증서 및 S3 액세스 키를 관리합니다. 인증서 및 자격 증명 변경을 Fabric 연결 및 기타 사용처에 대한 업데이트와 연계하는 교체 절차를 정의하고 테스트합니다. 새 버킷 자격 증명을 생성하면 기존 쌍이 즉시 무효화되므로 소비자를 업데이트하고 회전 후 액세스를 확인하는 동안 중단이 발생할 수 있음을 감안하십시오.
자체 서명된 TLS 인증서를 사용하는 경우 모든 게이트웨이 호스트가 해당 인증서를 신뢰하는지 확인합니다. 자세한 내용은 OneLake 게이트웨이 필수 구성 요소를 참조하세요.
보안 및 규정 준수는 스토리지, 액세스 및 다운스트림 서비스의 구성에 따라 달라집니다. 거버넌스 및 규정 준수 범위에 다운스트림 처리 및 파생 데이터를 포함합니다. GDPR 및 HIPAA와 같은 요구 사항은 해당하는 경우 전체 워크로드에 적용됩니다. 자세한 내용은 Object REST API 보안 및 권한 및 OneLake에서 Amazon S3 호환 바로 가기 만들기를 참조하세요.
비용 최적화
비용 최적화는 불필요한 비용을 줄이고 운영 효율성을 개선하는 방법에 중점을 둡니다. 자세한 내용은 비용 최적화를 위한 디자인 검토 목록을 참조하세요.
별도의 원본 데이터 복사를 피하면 중복 스토리지 및 동기화 비용을 줄일 수 있습니다. 이러한 절감액을 Azure NetApp Files의 용량 및 성능 비용, 게이트웨이 컴퓨팅 비용, Fabric 용량, 그리고 후속 처리 및 스토리지 비용과 비교하여 균형 있게 검토하세요.
이 예상 가격 예시에는 1 TiB Azure NetApp Files Standard 용량 풀, 온-프레미스 데이터 게이트웨이용 Windows D8s_v5 가상 머신, 128 GiB P10 관리 디스크 2개, 공용 IP 주소와 아웃바운드 데이터 처리가 포함된 NAT 게이트웨이, Fabric F2 용량 및 100 GB의 기본 OneLake 스토리지가 포함됩니다.
단일 게이트웨이 구성은 고가용성이 없습니다. 선택적 AI Search, 임베딩 서비스 및 Azure Databricks 비용은 제외됩니다. 워크로드의 용량, 네트워킹 및 가용성 요구 사항에 대한 리소스를 조정합니다.
쿨 액세스: 파일 및 개체 액세스를 유지하면서 스냅샷 데이터를 포함한 비활성 데이터 블록을 저렴한 스토리지로 계층화합니다. 워크로드의 액세스 패턴을 기준으로 데이터 검색 비용, 지연 시간, 그리고 서비스 수준에 따른 처리량 변화를 평가합니다.
서비스 수준 및 적정 크기 조정: 데이터 세트의 용량 및 처리량 요구 사항과 일치하는 Azure NetApp Files 서비스 수준을 선택합니다. 유연한 서비스 수준을 사용하면 풀의 용량과 처리량을 독립적으로 프로비전할 수 있습니다. 지속되는 오버 프로비저닝을 방지하려면 수요 변화에 따라 과금 대상 풀 용량 및 처리량을 검토하세요.
운영 효율성
운영 우수성은 애플리케이션을 배포하고 프로덕션 환경에서 계속 실행하는 운영 프로세스를 다룹니다. 자세한 내용은 운영 우수성 설계 검토 체크리스트를 참조하세요.
OneLake 바로 가기는 분석을 위해 별도의 원본 데이터 복사본을 유지하는 파이프라인을 방지하여 운영 복잡성을 줄입니다. 별도의 복사 파이프라인 없이도 팀은 복사 작업을 예약하거나, 전송 실패에서 복구하거나, 원본 및 복사된 데이터를 일상적인 작업의 일부로 조정할 필요가 없습니다.
원본 애플리케이션 및 분석 팀은 공유 Azure NetApp Files 데이터 세트에 대한 변경 내용 및 인시던트 대응을 조정해야 합니다. 모니터링, 실패 처리 및 Object REST API 자격 증명 및 인증서 관리에 대한 소유권을 설정합니다.
스토리지, 게이트웨이 및 Fabric 성능을 모니터링하여 제약 조건을 식별하고 용량 또는 처리량을 조정합니다.
Azure Monitor 사용하여 볼륨 읽기 및 쓰기 처리량, 읽기 및 쓰기 IOPS, 기타 IOPS, 평균 읽기 및 쓰기 대기 시간, 용량 사용량 및 처리량 제한 도달 지표를 추적합니다. 격리된 스파이크가 아니라 지속적인 대기 시간 증가, 반복되는 QoS 제한 및 용량 임계값에 대해 경고해야 합니다. Azure NetApp Files 메트릭은 간격에 따라 집계되며 스토리지 대기 시간에는 모든 클라이언트 쪽 REST 구성 요소가 포함되지 않습니다.
스토리지 메트릭을 요청 대기 시간 백분위수, 개체 크기, 동시성, 재시도, HTTP 상태 코드, CPU, 메모리 및 네트워크 처리량과 같은 클라이언트 쪽 측정값과 상호 연결합니다. 이렇게 하면 볼륨 처리량 제한이 컴퓨팅 용량이 부족한 클라이언트, 비효율적인 SDK 설정, 작은 개체 오버헤드 또는 네트워크 거리와 구분됩니다.
게이트웨이 오류 및 워크로드 완료 시간과 함께 각 게이트웨이 가상 머신의 CPU, 메모리, 사용 가능한 디스크 공간 및 네트워크 처리량을 모니터링합니다. 대표 워크로드 테스트 중 수립된 임계값을 사용하여 지속적인 리소스 압박 및 디스크 공간 부족에 대한 경고를 설정합니다. 오류를 해결하거나 접속이 느린 경우 게이트웨이 진단 로그를 사용합니다. 게이트웨이 진단이 전체 인프라 범위를 제공하지 않으므로 가상 머신과 네트워크를 별도로 모니터링합니다.
Fabric Capacity Metrics 앱을 사용하여 Fabric 용량 사용률 및 제한을 모니터링합니다. 담당 관리자를 위한 용량 사용률 알림을 구성합니다. 용량을 변경하기 전에 용량 사용량을 게이트웨이 및 스토리지 측정값과 연관 지어, 지연이 원본에 대한 액세스에서 발생하는지 아니면 Fabric 처리에서 발생하는지 파악하세요.
성능 효율성
성능 효율성은 사용자 요구를 효율적으로 충족하기 위해 워크로드의 크기를 조정하는 기능을 의미합니다. 자세한 내용은 성능 효율성에 대한 디자인 검토 검사 목록을 참조하세요.
Azure NetApp Files는 동일한 데이터 세트를 사용하여 대기 시간에 민감한 NFS 또는 SMB 애플리케이션과 S3 호환 분석 또는 AI 소비자를 모두 지원할 수 있습니다. 원본 데이터를 하나의 볼륨에 유지하면 그렇지 않을 경우 인덱싱, 학습 또는 일괄 처리를 지연시키고 클라이언트, 네트워크 및 대상 스토리지의 대역폭을 소모하는 복사 단계를 없앨 수 있습니다.
지원되는 Azure NetApp Files 서비스 수준에서의 1밀리초 미만의 스토리지 대기 시간은 NFS 및 SMB 워크로드와 가장 직접적으로 관련이 있습니다. HTTPS 개체 REST API 요청에 대한 엔드 투 엔드 대기 시간을 보장하지는 않습니다. 대기 시간 목표를 설정하기 전에 대표 개체 및 동시성을 사용하여 S3 호환 액세스 경로를 벤치마킹합니다.
스토리지 용량 산정: 파일 애플리케이션과 오브젝트 소비자의 결합된 수요를 기준으로 처리량을 산정합니다. 자동 QoS는 볼륨 처리량을 볼륨 쿼터에 연결합니다. 수동 QoS는 풀의 처리량 예산 내에서 별도의 할당을 허용합니다.. 성능을 조정하기 전에 대표적인 워크로드를 벤치마킹하세요.
게이트웨이 크기 조정: OneLake 바로 가기를 통해 Azure NetApp Files 액세스하는 워크로드의 결합된 수요에 대해 게이트웨이 가상 머신의 크기를 조정합니다. 게이트웨이 크기 산정 및 확장 지침을 시작점으로 사용합니다. 대표적인 데이터 볼륨과 동시 액세스 조건에서 바로 가기 기능을 통해 사이징이 적절한지 검증합니다. 워크로드 완료 시간과 함께 게이트웨이 CPU, 메모리 및 네트워크 처리량을 측정하여 가상 머신 리소스를 늘리거나 게이트웨이 멤버를 추가할지 여부를 결정합니다.
Fabric 용량 크기 조정: Power BI를 포함한 결합된 처리 및 보고 워크로드에 맞게 Fabric 용량을 조정합니다. Fabric 용량 계획 가이드의 지침에 따라 초기 용량을 예측하고, 대표적인 파일럿으로 테스트하고, 측정된 사용률 및 스로틀링에 따라 용량을 조정합니다.
컴퓨팅 리소스를 볼륨과 가까운 곳에 배치하고, 클라이언트 네트워크 구성을 적절히 산정하며, 실제 워크로드로 테스트하세요. 병렬 처리를 늘리고 순차 분석 작업에는 적절히 큰 요청을 사용하되, 대기 시간이나 오류가 증가하면 동시성을 제한하세요. NFS 또는 SMB의 경우 탑재, 프로토콜 및 애플리케이션 설정의 유효성을 검사합니다. REST의 경우 클라이언트의 필요한 API 작업에 대한 지원을 확인하고 연결 재사용, 업로드 동작, 재시도 및 개체 목록을 테스트합니다.
동시 부하에서 엔드투엔드 처리량 및 대기 시간의 유효성을 검사하고 원본 애플리케이션 성능 요구 사항과 분석 수요의 균형을 조정합니다.
Contributors
Microsoft는 이 문서를 유지 관리합니다. 이 문서를 작성한 기여자는 다음과 같습니다.
주요 작성자:
- 댄 잭슨 | 클라우드 솔루션 아키텍트, NetApp
- 앤서니 매시포드 | 클라우드 솔루션 설계자, NetApp
- Daniel Söderholm | 선임 솔루션 엔지니어, 클라우드 + AI 플랫폼, 마이크로소프트
기타 기여자:
- 헤더 그랜디 | 수석 솔루션 엔지니어, 데이터 플랫폼, Microsoft
LinkedIn 비공개 프로필을 보려면, LinkedIn에 로그인하세요.
다음 단계
- Azure NetApp Files 개체 REST API 소개
- Azure NetApp Files 볼륨에 OneLake 연결
- Azure Databricks Init 스크립트
- OneLake를 Azure Machine Learning 통합