Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Azure NetApp Files
Microsoft Fabric
Wyszukiwanie AI platformy Azure
Microsoft Foundry
Uczenie maszynowe Azure
Pomysły dotyczące rozwiązań
W tym artykule opisano pomysł rozwiązania. Architekt chmury może użyć tych wskazówek, aby ułatwić wizualizację głównych składników typowej implementacji tej architektury. Skorzystaj z tego artykułu jako punktu wyjścia, aby zaprojektować dobrze zaprojektowane rozwiązanie zgodne z konkretnymi wymaganiami obciążenia.
W tym rozwiązaniu opisano, w jaki sposób interfejs API REST Azure NetApp Files object pomaga organizacjom używać istniejących danych plików przedsiębiorstwa do analizy i sztucznej inteligencji bez uprzedniego kopiowania ich do oddzielnego magazynu obiektów. Aplikacje zgodne z usługą Amazon S3 mogą obsługiwać wyszukiwanie dokumentów i analizę wspomaganą przez sztuczną inteligencję, podczas gdy istniejące przepływy pracy NFS i SMB nadal uzyskują dostęp do tych danych. Unikanie oddzielnej kopii danych źródłowych może skrócić czas dołączania obciążeń analitycznych, zmniejszać zduplikowane koszty magazynowania i usuwać potoki synchronizacji, które w przeciwnym razie zespoły będą kompilować, monitorować i rozwiązywać problemy. Mniejsza liczba repozytoriów danych źródłowych oznacza również mniejszą liczbę kopii do zarządzania i ochrony. Takie podejście obsługuje modernizację przyrostową bez konieczności zastępowania istniejących aplikacji opartych na plikach przez organizacje.
Architecture
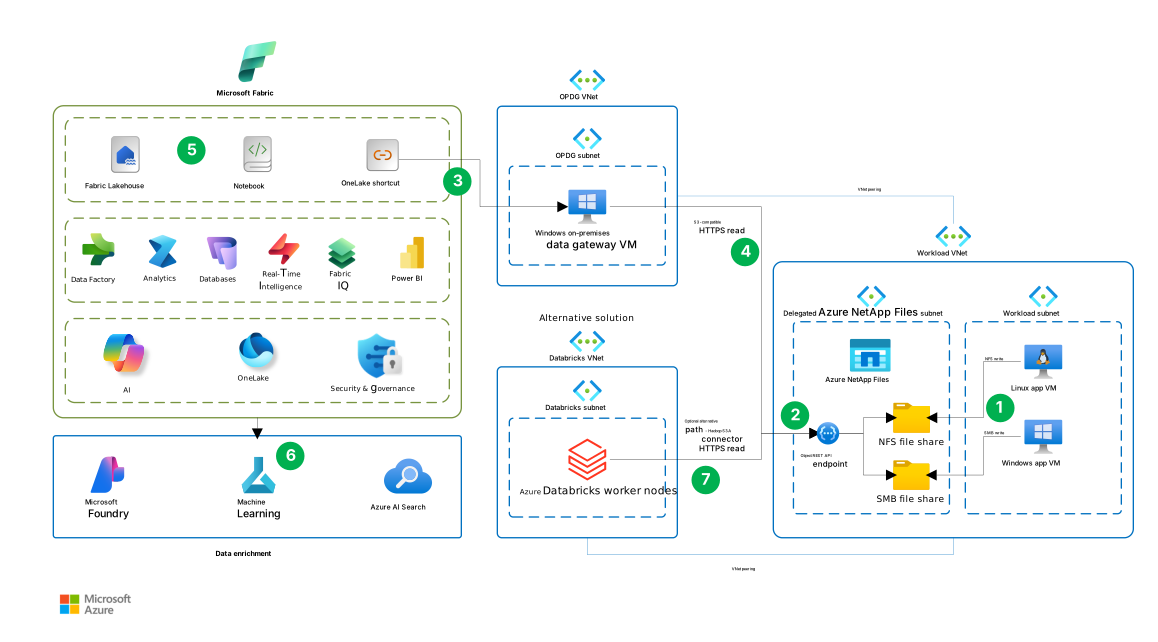
Ta architektura koncentruje się na integracji Microsoft Fabric z Azure NetApp Files za pośrednictwem interfejsu API REST obiektów. Na diagramie przedstawiono również Azure Databricks jako alternatywnego konsumenta analizy tych samych danych Azure NetApp Files. Nie trzeba wdrażać obu platform. Istniejące aplikacje nadal uzyskują dostęp do danych za pośrednictwem systemu plików NFS lub SMB, w zależności od konfiguracji woluminu i wymagań klienta.
Azure Databricks obliczenia uzyskują dostęp do punktu końcowego interfejsu API REST obiektów Azure NetApp Files za pośrednictwem żądań zgodnych z usługą S3A przy użyciu łącznika usługi Hadoop S3A. Ta alternatywna ścieżka analizy nie używa lokalnej bramy danych ani Microsoft OneLake.
Usługi podrzędne sztucznej inteligencji na diagramie są ilustracyjne. Ich integracja pozyskiwania nie jest wyświetlana.
Pobierz plik programu Visio tej architektury.
Przepływ danych
Poniższe ponumerowane interakcje opisują diagram architektury. Kroki od 1 do 5 opisują ścieżkę Microsoft Fabric podstawową. Krok 6 reprezentuje opcjonalne wzbogacanie danych podrzędnych. Krok 7 to alternatywna ścieżka analizy, a nie kontynuacja przepływu Fabric. Strzałki oznaczone etykietą Odczyt HTTPS pokazują żądania w kierunku punktu końcowego interfejsu API REST obiektu; żądane dane są zwracane do konsumenta.
Aplikacje zapisują dane plików. W podsieci Obciążenia maszyna wirtualna aplikacji systemu Linux zapisuje w udziale plików NFS, a maszyna wirtualna aplikacji Windows zapisuje w udziale plików SMB. Azure NetApp Files hostuje oba udziały w podsieci delegowanej.
Interfejs API REST obiektów uwidacznia dane pliku. Punkt końcowy w podsieci Delegowane ANF zapewnia dostęp zgodny z usługą S3 do skonfigurowanych katalogów na woluminach Azure NetApp Files. Połączenia z punktu końcowego do udziałów NFS i SMB reprezentują dostęp do istniejących danych, a nie kopii do oddzielnego magazynu obiektów.
Fabric uzyskuje dostęp do danych za pomocą skrótu OneLake. Skrót odwołuje się do danych Azure NetApp Files za pośrednictwem połączenia, które używa Windows lokalnej maszyny wirtualnej bramy danych w podsieci OPDG (lokalnej bramy danych). Skrót OneLake jest połączony z tą bramą.
Brama odczytuje z interfejsu API REST obiektów. Brama używa komunikacji równorzędnej między siecią wirtualną OPDG a siecią wirtualną obciążenia, aby uzyskać dostęp do punktu końcowego. Ścieżka odczytu protokołu HTTPS zgodna z protokołem S3 łączy bramę z punktem końcowym, który uzyskuje dostęp do danych pliku, do których odwołuje się Fabric. Aby uzyskać informacje o wymaganiach dotyczących połączenia, zobacz Connect OneLake to an Azure NetApp Files volume (Łączenie usługi OneLake z woluminem Azure NetApp Files).
Fabric przetwarza i analizuje dane. Obsługiwane obciążenia Fabric używają danych za pomocą skrótu. Na przykład notesy odczytują przywołyane pliki i zapisują pochodne wyniki w tabelach lakehouse na potrzeby analizy i raportowania Power BI. Pole Fabric na diagramie przedstawia te możliwości przetwarzania i analizy.
Opcjonalne usługi podrzędne wzbogacają dane. Strzałka poniżej Fabric prowadzi do grupy wzbogacania danych, która zawiera Microsoft Foundry, Azure Machine Learning i Wyszukiwanie AI platformy Azure. Ten krok reprezentuje opcjonalne przetwarzanie podrzędne. Diagram nie pokazuje pozyskiwania ani aranżacji potrzebnej do połączenia tych usług, a skrót OneLake nie ustanawia tych integracji.
Alternatywnie Azure Databricks odczytuje dane pliku bezpośrednio. Węzły procesu roboczego w podsieci usługi Databricks używają łącznika Hadoop S3A do wysyłania żądań odczytu HTTPS do tego samego punktu końcowego interfejsu API REST obiektu za pośrednictwem równorzędnych sieci wirtualnych. Ta ścieżka zastępuje ścieżkę dostępu i przetwarzania Fabric w krokach od 3 do 5. Nie przechodzi przez lokalną bramę danych ani usługę OneLake.
Wybierz lokalizację skrótu na podstawie sposobu użycia danych:
- Istniejące zgodne tabele delty. Utwórz skrót do tabeli w sekcji Tabele usługi Lakehouse, kierując się do pełnej tabeli delty, w tym w dzienniku transakcji. Fabric rozpoznaje element docelowy jako tabelę, którą można wykonywać za pośrednictwem platformy Spark i punktu końcowego analizy SQL, podczas gdy dane źródłowe pozostają na Azure NetApp Files.
- Pliki do bezpośredniego dostępu lub przetwarzania. Utwórz skróty w sekcji Pliki lakehouse. Oprócz dokumentów zgodne obciążenia mogą odczytywać autonomiczne pliki Parquet, CSV i JSON bez uprzedniego kopiowania plików źródłowych do usługi OneLake. Gdy analiza podrzędna wymaga tabel typu lakehouse, przekształć lub załadować dane źródłowe do pochodnych tabel delty w usłudze OneLake.
Autonomiczne pliki Parquet nie są automatycznie tabelami delty. Skrót w plikach nie rejestruje automatycznie obiektu docelowego jako tabeli. Aby uzyskać więcej informacji, zobacz Gdzie umieścić skróty w lakehouse.
Components
Poniższe składniki obsługują architekturę skoncentrowaną na Fabric i opcjonalną alternatywę Azure Databricks.
Azure NetApp Files to w pełni zarządzana usługa magazynu plików oparta na technologii NetApp. W tej architekturze przechowuje zestaw danych przedsiębiorstwa i zapewnia dostęp do obiektów zgodnych z systemem plików NFS, SMB i S3 za pośrednictwem interfejsu API REST obiektów. Zapewnia również możliwości migawek i replikacji.
Azure NetApp Files interfejs API REST obiektów uwidacznia istniejące dane plików za pośrednictwem interfejsu zgodnego z usługą S3. W tej architekturze umożliwia ona zgodnym aplikacjom analitycznym i aplikacjom sztucznej inteligencji dostęp do danych bez uprzedniego utworzenia oddzielnej kopii magazynu obiektów. Interfejs obsługuje podzbiór operacji Amazon S3. Przed wybraniem tej integracji upewnij się, że obsługiwane operacje spełniają wymagania aplikacji.
Microsoft Fabric to platforma analityczna, która łączy przenoszenie danych, przetwarzanie danych, pozyskiwanie, przekształcanie, przetwarzanie strumienia za pomocą Real-Time Intelligence i tworzenie raportów. W tej architekturze zapewnia platformę analizy do przetwarzania i analizowania danych z Azure NetApp Files za pomocą skrótów OneLake.
OneLake to ujednolicony logiczny magazyn danych dla Fabric. W tej architekturze skróty OneLake udostępniają przywoływane dane Azure NetApp Files do obsługiwanych obciążeń Fabric.
Azure Virtual Network zapewnia prywatną łączność między zasobami Azure w tej architekturze. Komunikacja równorzędna sieci wirtualnych umożliwia maszynie wirtualnej bramy i opcjonalne zasoby obliczeniowe Azure Databricks uzyskać dostęp do punktu końcowego interfejsu API REST obiektu Azure NetApp Files.
Lokalna brama danych łączy skróty OneLake z punktem końcowym zasobnika Azure NetApp Files. Pomimo swojej nazwy w tej architekturze brama działa w trybie standardowym na maszynie wirtualnej Azure z obsługiwanym systemem operacyjnym Windows. Wybierz obraz spełniający wymagania instalacji bramy. Instalacje Server Core i kontenery Windows nie są obsługiwane. Brama inicjuje połączenia wychodzące za pośrednictwem Azure Relay do komunikowania się z Fabric. Nie są wymagane żadne połączenia przychodzące z Fabric. Skonfiguruj zaporę lub serwer proxy, aby zezwolić na wychodzące punkty końcowe opisane w temacie Dostosowywanie ustawień komunikacji dla lokalnej bramy danych.
Azure Databricks to opcjonalna alternatywna platforma analizy dla obciążeń inżynierii danych i uczenia maszynowego. Jego zadania platformy Spark używają łącznika usługi Hadoop S3A skonfigurowanego dla punktu końcowego interfejsu API REST obiektów w celu uzyskania dostępu do zestawu danych Azure NetApp Files zamiast używania ścieżki integracji Fabric.
Alternatives
Ta architektura obejmuje wiele składników, które można zastąpić innymi usługami lub podejściami platformy Azure, w zależności od wymagań funkcjonalnych i niefunkcjonalnych obciążenia. Rozważ następujące alternatywy i ich kompromisy.
Magazyn
Podczas wybierania między Azure Blob Storage i Azure NetApp Files należy wziąć pod uwagę wymagania protokołu aplikacji i mierzoną wydajność:
Wybierz Blob Storage, gdy klienci mogą używać interfejsu API REST Blob Storage lub NFS 3.0 i nie wymagają protokołu SMB ani NFS 4.1. Oba interfejsy mogą uzyskiwać dostęp do tych samych danych. Ścieżka dostępu systemu Blob Storage NFS 3.0 jest zoptymalizowana pod kątem obciążeń sekwencyjnych o wysokiej przepływności, w których przepływność ma większe znaczenie niż małe opóźnienie.
Wybierz Azure NetApp Files, gdy aplikacje i obciążenia analityczne muszą uzyskiwać dostęp do tych samych plików za pośrednictwem protokołu SMB lub NFS 4.1 i interfejsu API REST obiektu zgodnego z usługą S3 lub gdy aplikacje plików wymagają losowych operacji we/wy o małych opóźnieniach. W przypadku danych już na Azure NetApp Files interfejs API REST obiektów dodaje dostęp do analizy bez migrowania aplikacji źródłowych lub danych.
W przypadku każdej opcji zmierz kompleksowe opóźnienie i przepływność w ramach współbieżnego obciążenia aplikacji źródłowej i analizy. Wydajność systemu plików NFS lub SMB nie ustanawia interfejsu API REST obiektów ani Fabric wydajności, dlatego przetestuj docelową ścieżkę dostępu pod kątem wymagań obciążenia. Porównaj łączne koszty, w tym zmiany aplikacji, migrację i wszelkie trwające duplikowanie i synchronizację. Aby zapoznać się z porównaniem protokołów i obciążeń, zobacz Porównanie usług magazynu Azure.
Integration
Azure Databricks zadania mogą używać łącznika usługi Hadoop S3A do odczytywania Azure NetApp Files danych za pośrednictwem interfejsu API REST obiektów bez usługi OneLake lub lokalnej bramy danych. Skonfiguruj zaufanie protokołu TLS i bezpiecznie przechowywane poświadczenia oraz zweryfikuj wymagane operacje zapisu przed użyciem zapisu zwrotnego. Jeśli potrzebujesz skryptów inicjowania, użyj skryptów o zakresie klastra przechowywanych w woluminach wykazu aparatu Unity w obsługiwanych obliczeniach, postępując zgodnie z bieżącymi wskazówkami dotyczącymi skryptów inicjowania Azure Databricks.
Szczegóły scenariusza
Użyj tego wzorca, gdy ten sam zestaw danych musi obsługiwać aplikacje, które oczekują zainstalowanego systemu plików i usług analitycznych lub usług sztucznej inteligencji, które oczekują interfejsu obiektu zgodnego z usługą S3.
Aplikacje działające na maszynach wirtualnych lub w kontenerach mogą nadal używać Azure NetApp Files za pośrednictwem systemu plików NFS lub SMB. Mogą na przykład używać istniejącego kodu dostępu do plików, zainstalowanych udziałów i struktur katalogów. Interfejs API REST obiektów Azure NetApp Files mapuje katalog główny woluminu lub podkatalog do zasobnika zgodnego z usługą S3, aby umożliwić zgodnym klientom obiektów dostęp do tych samych plików bazowych.
Takie podejście jest przydatne, gdy chcesz dodać funkcje analizy lub sztucznej inteligencji do istniejących obciążeń opartych na plikach bez konieczności zmieniania aplikacji źródłowych na korzystanie z magazynu obiektów. Przepływy pracy podrzędnych mogą nadal tworzyć dane pochodne, takie jak przekształcone zestawy danych, indeksy, osadzanie i pamięci podręczne, zgodnie z potrzebami.
Gdy klienci plików i obiektów uzyskują dostęp do tych samych danych, należy uwzględnić różnice w zakresie tożsamości, uprawnień, blokowania i spójności aplikacji. Zdefiniuj sposób, w jaki producenci sygnalizują ukończenie pliku lub partii przed przetworzeniem go przez użytkowników obiektów. Producenci powinni zakończyć zapisywanie i zamykanie plików przed zasygnalizowaniem gotowości i pozostawić te pliki bez zmian, gdy użytkownicy je przetwarzają. Przetestuj tę rękę pod kątem przerwanych operacji zapisu i przetwarzania ponownych prób.
Modele tożsamości i autoryzacji różnią się również między metodami dostępu. Oryginalne uprawnienia do pliku dla użytkownika nie są automatycznie przenoszone do Fabric. Skonfiguruj Fabric uprawnienia dla zamierzonych odbiorców i upewnij się, że tożsamość używana przez interfejs API REST obiektów ma dostęp tylko do wymaganych danych źródłowych. Aby uzyskać więcej informacji, zobacz Security.
Mapuj katalogi na oddzielne zasobniki, gdy użytkownicy wymagają różnych poziomów dostępu. Klasyfikacja, przechowywanie, autoryzacja podrzędna i ład danych pochodnych pozostają obowiązki związane z obciążeniem. Aby uzyskać więcej informacji, zobacz Tworzenie zasobnika.
Potencjalne przypadki użycia
Ta architektura może obsługiwać obciążenia, które muszą analizować dane ustrukturyzowane lub nieustrukturyzowane, które są już przechowywane w Azure NetApp Files. W poniższych przykładach przedstawiono różne sposoby, które Fabric mogą wykorzystywać te dane.
Przetwarzanie dokumentów
Aplikacje mogą zapisywać dokumenty, obrazy lub inne pliki bez struktury w celu Azure NetApp Files przy użyciu systemu plików NFS lub SMB. Notes Fabric może odczytywać ukończone pliki przy użyciu skrótu OneLake i wysyłać zawartość do usługi przetwarzania dokumentów, takiej jak Azure Document Intelligence, na potrzeby wyodrębniania. Przechowuj wynikowe dane ustrukturyzowane w tabelach lakehouse na potrzeby walidacji, analizy i raportowania.
Aby uzyskać wskazówki dotyczące integracji, zobacz Integracja analizy dokumentów za pomocą usługi SynapseML.
Analiza danych
Aplikacje mogą zapisywać dane ustrukturyzowane, takie jak pliki CSV lub Parquet, do udziału Azure NetApp Files. Fabric notesy mogą odczytywać ukończone pliki przy użyciu skrótu OneLake, łączyć je z innymi danymi lakehouse i zapisywać pochodne wyniki w tabelach lakehouse.
Ten wzorzec może obsługiwać scenariusze, takie jak inżynieria i analiza jakości, analiza danych czujników i raportowanie operacyjne, bez konieczności zmiany sposobu przechowywania plików przez aplikacje źródłowe.
W przypadku istniejących zgodnych zestawów danych delty utwórz skrót OneLake w sekcji Tabele usługi Lakehouse, która jest przeznaczona dla pełnej tabeli delty, w tym dziennika transakcji. Fabric można rozpoznać obiekt docelowy jako tabelę, a dane źródłowe mogą pozostać na Azure NetApp Files. Aby uzyskać więcej informacji, zobacz Gdzie umieścić skróty w lakehouse.
Wyszukiwanie i pobieranie sztucznej inteligencji
Dokumenty przechowywane w Azure NetApp Files mogą również służyć jako zawartość źródłowa dla obciążeń sztucznej inteligencji. Na przykład przepływ pracy przetwarzania może odczytywać dokumenty za pomocą skrótu OneLake i używać ich do tworzenia indeksu Wyszukiwanie AI platformy Azure na potrzeby generowania rozszerzonego pobierania (RAG).
Indeks wyszukiwania i wszystkie osadzanie są danymi pochodnymi i są przechowywane oddzielnie od plików źródłowych. Zaprojektuj przepływ pracy, aby zachować zsynchronizowaną zawartość indeksowaną z aktualizacjami źródłowymi, nazwami i usunięciami. Wymuszaj również odpowiednie mechanizmy kontroli dostępu podczas pobierania indeksowanej zawartości, ponieważ oryginalne uprawnienia SMB i NFS nie stają się automatycznie uprawnieniami wyszukiwania poszczególnych użytkowników.
Ten sam wzorzec można rozszerzyć na inne obciążenia sztucznej inteligencji. Na przykład Fabric notesy mogą przygotowywać zestawy danych z plików źródłowych i przechowywać przygotowane dane w usłudze OneLake do użycia przez Azure Machine Learning. Aby uzyskać informacje o opcjach integracji i ograniczeniach, zobacz Integrowanie usługi OneLake z Azure Machine Learning.
Considerations
Te zagadnienia obejmują implementację filarów platformy Azure Well-Architected Framework, która jest zestawem wytycznych, których można użyć do poprawy jakości obciążenia. Aby uzyskać więcej informacji, zobacz Well-Architected Framework. Aby uzyskać więcej wskazówek, zobacz Well-Architected Framework recommendations for Azure NetApp Files (Zalecenia dotyczące platformyWell-Architected Framework).
Reliability
Niezawodność pomaga zapewnić, że aplikacja może spełnić zobowiązania podjęte przez klientów. Aby uzyskać więcej informacji, zobacz Lista kontrolna przeglądu projektu dotycząca niezawodności.
Azure NetApp Files działa na odpornej na uszkodzenia floty bez systemu operacyjnego obsługiwanej przez ONTAP i zapewnia umowę SLA o wysokiej dostępności. Aby uzyskać dodatkową ochronę przed awariami stref dostępności lub regionalnymi, opcjonalnie można skonfigurować replikację między strefami lub między regionami. Ta replikacja jest asynchroniczna i wymaga przełączenie klienta w tryb failover do woluminu docelowego. Wybierz opcję replikacji i zaplanuj zgodnie z celami odzyskiwania obciążenia. Aby uzyskać więcej informacji, zobacz Azure NetApp Files niezawodność.
Udostępnianie jednego zestawu danych sprawia również, że dostępność magazynu jest wspólną zależnością dla aplikacji plików i analiz. Te możliwości magazynu nie określają kompleksowej dostępności bramy, potoku indeksowania ani korzystania z aplikacji. Dopasuj cele odzyskiwania do kompletnego obciążenia, w tym bramy, przetwarzania podrzędnego i danych pochodnych.
Pojedyncza maszyna wirtualna bramy to pojedynczy punkt awarii dla ścieżki integracji Fabric. W przypadku obciążeń krytycznych dla działania firmy należy wdrożyć co najmniej dwa elementy członkowskie bramy na oddzielnych maszynach wirtualnych w klastrze bramy. Upewnij się, że każdy element członkowski może uzyskać dostęp do punktu końcowego interfejsu API REST obiektów i ustanowić wymagane połączenia wychodzące. Przetestuj zachowanie obciążenia, gdy element członkowski bramy stanie się niedostępny.
- Odzyskiwanie plików i woluminów jest obsługiwane za pomocą wydajnych w przestrzeni migawek do punktu w czasie. Zespoły mogą przywrócić pojedynczy plik, przywrócić pełny wolumin lub utworzyć nowy wolumin z punktu odzyskiwania po przypadkowym usunięciu, uszkodzeniu lub nieudanym procesie analizy. Aby zapoznać się z dostępnymi operacjami odzyskiwania, zobacz Azure NetApp Files ochronę danych opartą na migawkach.
Zabezpieczenia
Zabezpieczenia zapewniają ochronę przed celowymi atakami i nieprawidłowym użyciem cennych danych i systemów. Aby uzyskać więcej informacji, zobacz Lista kontrolna przeglądu projektu dotycząca zabezpieczeń.
Utrzymywanie mniejszej liczby kopii danych źródłowych może zmniejszyć liczbę repozytoriów do ochrony. Azure NetApp Files szyfruje dane magazynowane, a interfejs API REST obiektów używa protokołu TLS do ochrony danych przesyłanych. Uprawnienia dostępu do plików zależą od protokołu:
Klienci SMB i NFS nadal korzystają z istniejących modeli uwierzytelniania i autoryzacji. Istniejące listy kontroli dostępu systemu plików NTFS (ACL), uprawnienia systemu plików NFS i reguły mapowania tożsamości pozostają w mocy dla tych klientów.
Klienci interfejsu API REST obiektów uwierzytelniają się przy użyciu klucza dostępu S3. Uprawnienia zasobnika określają, czy klient ma dostęp tylko do odczytu, czy do odczytu i zapisu w zamapowanym katalogu. Żądania obiektów nie obejmują tożsamości poszczególnych użytkowników SMB, NFS ani podrzędnych. Azure NetApp Files wykonuje każdą operację obiektu jako skonfigurowaną tożsamość spersonifikowanego systemu plików zasobnika. Istniejące uprawnienia do plików i listy ACL są oceniane tylko względem tej tożsamości.
Personifikowana tożsamość systemu plików to identyfikator użytkownika (UID) i identyfikator grupy (GID) dla woluminów NFS lub konto użytkownika dla woluminów SMB. Woluminy z podwójnym protokołem używają typu tożsamości zgodnego ze skonfigurowanym stylem zabezpieczeń. Ta tożsamość określa uprawnienia dostępu do plików. Klucz dostępu S3 uwierzytelnia klienta obiektu. Aby uzyskać więcej informacji, zobacz Temat Object REST API security and permissions (Zabezpieczenia i uprawnienia interfejsu API REST obiektów).
Skrót zgodny z usługą OneLake S3 uwierzytelnia się w zasobniku przy użyciu identyfikatora klucza dostępu i klucza dostępu tajnego. Źródłowe listy ACL systemu plików NTFS, uprawnienia systemu plików NFS i tożsamości poszczególnych właścicieli plików nie są kopiowane ani mapowane na usługę OneLake. Fabric użytkownicy są autoryzowani za pośrednictwem usługi OneLake i Fabric uprawnień. Mogą oni uzyskiwać dostęp tylko do zawartości udostępnianej skrótowi za pośrednictwem zasobnika i jego personifikowanej tożsamości, ale usługa OneLake nie wymusza oryginalnych uprawnień do pliku dla użytkownika. Microsoft Entra oparte na protokole OAuth, jednostkach usługi i usłudze RoleArn nie są obsługiwane dla tego typu skrótu.
Na przykład użytkownik Fabric może być w stanie odczytać dokument przy użyciu skrótu, nawet jeśli osobiste konto SMB nie może odczytać go bezpośrednio, jeśli Fabric uprawnienia zezwalają na dostęp, a tożsamość podszytego zasobnika może odczytać dokument. Przed ujawnieniem katalogu sprawdź, czy docelowa grupa odbiorców Fabric ma uprawnienia dostępu do jego zawartości.
Skonfiguruj tożsamość zasobnika personifikowaną tylko przy użyciu uprawnień źródłowych wymaganych przez obciążenie. Ogranicz dostęp do skrótu i lakehouse. Użyj przepływu pracy certyfikatu opartego na Azure Key Vault i magazynu poświadczeń, aby zarządzać certyfikatami TLS i kluczami dostępu S3. Zdefiniuj i przetestuj procedurę rotacji, która koordynuje zmiany certyfikatu i poświadczeń z aktualizacjami Fabric połączeniami i innymi użytkownikami. Generowanie nowych poświadczeń zasobnika natychmiast unieważnia istniejącą parę, dlatego zaplanuj przerwę podczas aktualizowania użytkowników i weryfikowania dostępu po rotacji.
Jeśli używasz certyfikatu TLS z podpisem własnym, upewnij się, że każdy host bramy ufa mu. Aby uzyskać więcej informacji, zobacz Wymagania wstępne bramy OneLake.
Zabezpieczenia i zgodność zależą od konfiguracji magazynu, dostępu i usług podrzędnych. Uwzględnij podrzędne przetwarzanie i pochodne dane w zakresie ładu i zgodności. Wymagania, takie jak RODO i HIPAA, mają zastosowanie do kompletnego obciążenia, jeśli ma to zastosowanie. Aby uzyskać więcej informacji, zobacz Temat Object REST API security and permissions (Zabezpieczenia i uprawnienia interfejsu API REST obiektów ) i Create an Amazon S3-compatible shortcut in OneLake (Tworzenie skrótu zgodnego z usługą Amazon S3 w usłudze OneLake).
Optymalizacja kosztów
Optymalizacja kosztów koncentruje się na sposobach zmniejszenia niepotrzebnych wydatków i poprawy wydajności operacyjnej. Aby uzyskać więcej informacji, zobacz Lista kontrolna przeglądu projektu dotycząca optymalizacji kosztów.
Unikanie oddzielnej kopii danych źródłowych może zmniejszyć zduplikowane koszty magazynowania i synchronizacji. Zrównoważ te oszczędności względem Azure NetApp Files kosztów pojemności i wydajności, mocy obliczeniowej bramy, pojemności Fabric oraz przetwarzania podrzędnego i magazynu.
W tym przykładowym oszacowaniu cen uwzględniono pulę pojemności 1-TiB Azure NetApp Files Standard, maszynę wirtualną Windows D8s_v5 dla lokalnej bramy danych, dwa dyski zarządzane 128 GiB P10, bramę translatora adresów sieciowych z publicznym adresem IP i przetwarzaniem danych wychodzących, Fabric pojemności F2 i 100 GB natywnego magazynu OneLake.
Konfiguracja pojedynczej bramy nie jest wysoce dostępna. Opcjonalne wyszukiwanie sztucznej inteligencji, osadzanie usług i koszty Azure Databricks są wykluczone. Dostosuj zasoby pod kątem pojemności, sieci i wymagań dotyczących dostępności obciążenia.
Dostęp chłodny: Nieaktywne bloki danych warstwy, w tym dane migawek, do magazynu o niższych kosztach przy zachowaniu dostępu do plików i obiektów. Oceń opłaty za pobieranie, opóźnienie i zmiany przepływności specyficzne dla poziomu usługi względem wzorca dostępu obciążenia.
Poziomy usług i ustalanie rozmiaru z prawej strony: Wybierz Azure NetApp Files poziom usługi zgodny z wymaganiami dotyczącymi pojemności i przepływności zestawu danych. Poziom usług elastycznych umożliwia niezależne aprowizowanie pojemności i przepływności puli. Przejrzyj rozliczaną pojemność i przepływność puli w miarę zmian zapotrzebowania, aby uniknąć trwałej nadmiernej aprowizacji.
Doskonałość operacyjna
Doskonałość operacyjna obejmuje procesy operacyjne, które wdrażają aplikację i zapewniają jej działanie w środowisku produkcyjnym. Aby uzyskać więcej informacji, zobacz Lista kontrolna przeglądu projektu dotycząca doskonałości operacyjnej.
Skróty OneLake zmniejszają złożoność operacyjną, unikając potoku, który obsługuje oddzielną kopię danych źródłowych na potrzeby analizy. Bez oddzielnego potoku kopiowania zespoły nie muszą planować zadań kopiowania, odzyskiwać po awariach transferu ani uzgadniać danych źródłowych i kopiowanych w ramach rutynowych operacji.
Zespoły ds. aplikacji źródłowej i analizy muszą koordynować zmiany i reagowanie na zdarzenia dla udostępnionego zestawu danych Azure NetApp Files. Ustanów własność na potrzeby monitorowania, błędów przetwarzania i poświadczeń interfejsu API REST obiektów oraz zarządzania certyfikatami.
Monitorowanie wydajności magazynu, bramy i Fabric w celu identyfikowania ograniczeń i dostosowywania pojemności lub przepływności:
Użyj Azure Monitor do śledzenia przepływności odczytu i zapisu woluminu, operacji we/wy odczytu i zapisu, innych operacji we/wy na sekundę, średniego opóźnienia odczytu i zapisu, zużycia pojemności i wskaźnika osiągniętego limitu przepływności. Alert dotyczący zwiększonego opóźnienia, powtarzającego się ograniczania QoS i progów pojemności, a nie izolowanych skoków; Azure NetApp Files metryki są agregowane w odstępach czasu, a opóźnienie magazynu nie obejmuje każdego składnika REST po stronie klienta.
Skoreluj metryki magazynu z pomiarami po stronie klienta, takimi jak percentyle opóźnienia żądań, rozmiar obiektu, współbieżność, ponawianie prób, kody stanu HTTP, procesor CPU, pamięć i przepływność sieci. W ten sposób rozróżnia limit przepływności woluminu od niedostatecznego klienta obliczeniowego, nieefektywnych ustawień zestawu SDK, obciążeń związanych z małym obiektem lub odległości sieciowej.
Monitorowanie procesora CPU, pamięci, dostępnego miejsca na dysku i przepływności sieci poszczególnych maszyn wirtualnych bramy oraz błędów bramy i czasów ukończenia obciążenia. Skonfiguruj alerty dotyczące trwałego ciśnienia zasobów i małej ilości miejsca na dysku przy użyciu progów ustanowionych podczas reprezentatywnych testów obciążenia. Użyj dzienników diagnostycznych bramy podczas rozwiązywania problemów z błędami lub wolnym dostępem. Monitoruj maszynę wirtualną i sieć oddzielnie, ponieważ diagnostyka bramy nie zapewnia pełnego pokrycia infrastruktury.
Monitoruj wykorzystanie Fabric pojemności i ograniczanie ich za pomocą aplikacji Fabric Capacity Metrics. Skonfiguruj powiadomienia o wykorzystaniu pojemności dla odpowiedzialnych administratorów. Skorelowanie użycia pojemności z pomiarami bramy i magazynu w celu określenia, czy opóźnienia pochodzą z dostępu źródłowego, czy Fabric przetwarzania przed zmianą pojemności.
Wydajność operacyjna
Wydajność odnosi się do możliwości skalowania obciążenia w celu efektywnego zaspokojenia wymagań użytkowników. Aby uzyskać więcej informacji, zobacz listę kontrolną przeglądu projektu pod kątem wydajności.
Azure NetApp Files mogą obsługiwać zarówno aplikacje NFS, jak i SMB z uwzględnieniem opóźnień oraz analizy zgodne z usługą S3 lub konsumentów sztucznej inteligencji przy użyciu tego samego zestawu danych. Przechowywanie danych źródłowych na jednym woluminie może usunąć etap kopiowania, który w przeciwnym razie opóźniłby indeksowanie, trenowanie lub przetwarzanie wsadowe i zużywać przepustowość klienta, sieci i magazynu docelowego.
Opóźnienie magazynu w milisekundach na obsługiwanych poziomach usługi Azure NetApp Files jest najbardziej bezpośrednio istotne dla obciążeń NFS i SMB. Nie gwarantuje to kompleksowego opóźnienia żądań interfejsu API REST obiektów HTTPS. Przeprowadź test porównawczy ścieżki dostępu zgodnej z usługą S3 z obiektami reprezentatywnymi i współbieżnością przed ustawieniem celu opóźnienia.
Ustalanie rozmiaru magazynu: Rozmiar przepływności dla połączonego zapotrzebowania aplikacji plików i odbiorców obiektów. Automatyczne wiązanie przepływności woluminu QoS z limitem przydziału woluminu. Ręczne QoS umożliwia oddzielne przydzielanie w ramach budżetu przepływności puli. Przeprowadź test porównawczy obciążeń przed dostosowaniem wydajności.
Ustalanie rozmiaru bramy: Rozmiar maszyn wirtualnych bramy dla połączonego zapotrzebowania obciążeń, które uzyskują dostęp Azure NetApp Files za pośrednictwem skrótów OneLake. Skorzystaj ze wskazówek dotyczących określania rozmiaru i skalowania bramy jako punktu wyjścia. Zweryfikuj rozmiar przy użyciu reprezentatywnych woluminów danych i dostępu współbieżnego za pomocą skrótów. Mierzenie przepływności procesora CPU, pamięci i sieci bramy wraz z czasem ukończenia obciążenia w celu określenia, czy zwiększyć zasoby maszyny wirtualnej, czy dodać członków bramy.
Fabric rozmiar pojemności: rozmiar Fabric pojemności dla połączonego obciążenia przetwarzania i raportowania, w tym Power BI. Postępuj zgodnie ze wskazówkami w przewodniku planowania wydajności Fabric, aby oszacować początkową pojemność, przetestować z reprezentatywnym pilotażem i dostosować pojemność na podstawie mierzonego wykorzystania i ograniczania przepustowości.
Umieść obliczenia w pobliżu woluminu, odpowiednio rozmieścij sieć klienta i przetestuj je przy użyciu rzeczywistego obciążenia. Zwiększ równoległość i używaj odpowiednio dużych żądań na potrzeby analizy sekwencyjnej, ale zwiększ współbieżność, gdy opóźnienie lub błędy wzrosną. W przypadku systemu plików NFS lub SMB sprawdź poprawność ustawień instalacji, protokołu i aplikacji. W przypadku interfejsu REST sprawdź obsługę wymaganych operacji interfejsu API klienta i przetestuj ponowne użycie połączenia, zachowanie przekazywania, ponawianie prób i wyświetlanie listy obiektów.
Zweryfikuj kompleksową przepływność i opóźnienie w ramach współbieżnego obciążenia oraz zrównoważ zapotrzebowanie na analizę przy użyciu wymagań dotyczących wydajności aplikacji źródłowych.
Contributors
Microsoft utrzymuje ten artykuł. Następujący współautorzy napisali ten artykuł.
Główni autorzy:
- Dan Jackson | Architekt rozwiązań w chmurze, NetApp
- Anthony Mashford | Architekt rozwiązań w chmurze, NetApp
- Daniel Söderholm | Starszy inżynier rozwiązań, platforma chmury i sztucznej inteligencji, Microsoft
Inni współautorzy:
- Heather Grandy | Starszy inżynier rozwiązań, platformy danych, Microsoft
Aby wyświetlić niepubliczne profile serwisu LinkedIn, zaloguj się do serwisu LinkedIn.
Następne kroki
- Wprowadzenie do interfejsu API REST obiektów dla Azure NetApp Files
- Łączenie usługi OneLake z woluminem Azure NetApp Files
- Skrypty inicjowania w Azure Databricks
- Integrowanie usługi OneLake z usługą Azure Machine Learning