Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
W miarę jak organizacje przyspieszają transformację cyfrową, zdolność do efektywnego zarządzania danymi staje się strategicznym imperatywem biznesowym. Wraz z rozwojem aplikacji opartych na sztucznej inteligencji i przepływów pracy opartych na Copilot, przedsiębiorstwa generują i zużywają dane w niespotykanym dotąd tempie. Dane te napędzają innowacje, umożliwiają spersonalizowane doświadczenia i wspierają podejmowanie krytycznych decyzji — ale tylko wtedy, gdy są inteligentnie zarządzane i przechowywane.
Aby sprostać tym zmieniającym się potrzebom biznesowym, organizacje muszą przyjąć proaktywną strategię zarządzania pamięcią masową. Gwarantuje to, że dane, które nie są już potrzebne do codziennych operacji, są obsługiwane w sposób odpowiedzialny, zwalniając moc przerobową dla obciążeń o wysokiej wartości, zmniejszając tarcia operacyjne i dostosowując się do wymagań dotyczących zgodności i audytu.
Z technicznego punktu widzenia efektywne zarządzanie magazynem w Dataverse systemie Dynamics 365 zwiększa wydajność systemu, poprawia efektywność kosztową i zapewnia zgodność z zasadami przechowywania długoterminowego (LTR). Obie platformy oferują narzędzia i możliwości automatyzacji, które umożliwiają organizacjom zarządzanie pamięcią masową.
Wdrażając strategie opisane w tym artykule, przedsiębiorstwa mogą zmniejszyć koszty ogólne pomocy technicznej, usprawnić zapewnianie zgodności i odblokować większą wartość swoich aplikacji biznesowych, przekształcając pamięć masową z ograniczeń w przewagę konkurencyjną.
Główne korzyści
Efektywne zarządzanie magazynem w Dataverse usłudze Dynamics 365 zapewnia kilka kluczowych korzyści, które rozwiązują typowe problemy klientów i zwiększają ogólną wydajność operacyjną.
Zwiększona zgodność z LTR: Efektywne zarządzanie pamięcią masową zapewnia, że dane są przechowywane zgodnie z zasadami LTR. Pomaga to nie tylko w spełnieniu wymagań prawnych, ale także zapewnia zachowanie i dostęp do krytycznych danych w razie potrzeby.
Zwiększona wydajność: Optymalizując zarządzanie pamięcią masową, organizacje mogą znacznie zwiększyć wydajność swoich systemów. Efektywna alokacja pamięci masowej i zarządzanie nią zmniejsza opóźnienia i poprawia szybkość pobierania danych, co prowadzi do płynniejszych i szybszych operacji.
Zwiększanie efektywności kosztowej: Efektywne zarządzanie pamięcią masową umożliwia organizacjom skupienie się na danych o wysokiej wartości poprzez usprawnienie i uporządkowanie środowiska pamięci masowej. Zachowując tylko to, co jest niezbędne, firmy mogą zoptymalizować swoją pamięć masową, co prowadzi do inteligentniejszego wykorzystania zasobów i ekonomicznej skalowalności.
Tło
Wraz z rozwojem organizacji i digitalizacją coraz większej liczby swoich operacji, ilość danych biznesowych przechowywanych w systemach takich jak Dataverse Dynamics 365 stale rośnie. Obejmuje to nie tylko aktywne, transakcyjne dane, ale także zapisy historyczne, które muszą być przechowywane do celów audytu, regulacyjnych lub ciągłości działania. Z biegiem czasu ta akumulacja może prowadzić do obniżenia wydajności, zwiększonego obciążenia operacyjnego i rosnących kosztów pamięci masowej — zwłaszcza gdy dane, które nie są już aktywnie używane, pozostają w warstwach pamięci masowej o wysokiej wydajności.
Dobrze zdefiniowana strategia zarządzania pamięcią masową pomaga organizacjom sprostać tym wyzwaniom, identyfikując dane, które można zarchiwizować, wyczyścić lub przenieść do tańszej, zoptymalizowanej pod kątem odczytu pamięci masowej. Jest to ważne w przypadku scenariuszy zgodności, w których dane muszą pozostać niezmienne, o niskim dostępie i tylko do odczytu, takie jak rekordy finansowe, dzienniki inspekcji lub zgłoszenia regulacyjne. Zapewnienie, że takie dane są przechowywane w sposób zgodny z przepisami, bez wpływu na wydajność działających systemów, jest kluczowym wymogiem dla wielu przedsiębiorstw.
Korzystając z narzędzi i strategii dostępnych na obu platformach, organizacje mogą uzyskać lepszy wgląd w wykorzystanie zasobów pamięci masowej, ograniczyć zbędne zużycie oraz zapewnić właściwe postępowanie z danymi kluczowymi z punktu widzenia zgodności.
W tym artykule przedstawiono praktyczne podejścia do zarządzania magazynem, które pomagają klientom dostosować praktyki przechowywania danych do potrzeb biznesowych i prawnych. Poprawia to wydajność systemu, zmniejsza koszty operacyjne i zapewnia bezkompromisowe spełnianie zobowiązań w zakresie zgodności.
Dlaczego przechowujemy dane
Aby wybrać i zoptymalizować odpowiedni wzorzec przechowywania danych dla swoich danych, warto zastanowić się nad powodami i zastosowaniami, dla których przechowujemy dane.
Dane operacyjne
W przypadku aplikacji biznesowej dane operacyjne są tym, co jest używane do śledzenia sprzedaży, działań finansowych lub łańcucha dostaw.
Dane te muszą być dostępne w czasie rzeczywistym, co wspiera klientów i wewnętrzne procesy operacyjne, które rejestrują szczegółowe działania, takie jak interakcje z klientami, zamówienia lub działania związane z zapasami.
Z biegiem czasu dane operacyjne mogą przestać być aktywnie wykorzystywane, a stać się rzadko używane. Może być konieczne zapewnienie dostępu do danych niemal w czasie rzeczywistym, aby pomóc klientowi w złożeniu zamówienia lub w zgłoszeniu do pomocy technicznej. Na przykład rozważmy następujące scenariusze:
- Klient składa zamówienie, podczas gdy inny klient, który od jakiegoś czasu nie kontaktował się z firmą, składa zamówienie.
- Każde zamówienie, które zostało złożone i jest wysyłane, jest stale odwiedzane. Są też zamówienia objęte trzyletnią gwarancją, do których może być konieczne odwołanie się w celu uzyskania pomocy technicznej i które mogą ewentualnie wymagać zwrotu pieniędzy.
Może to prowadzić do etapów potrzeb w zakresie dostępu do danych operacyjnych, takich jak:
- Mniej niż rok aktywnego dostępu do danych.
- Mniej niż trzy lata rzadko używanych danych.
- Ponad trzy lata, w których nie ma już operacyjnego dostępu do danych.
Charakter operacyjnej pamięci masowej w czasie rzeczywistym sprawia, że jest ona stosunkowo kosztowna w porównaniu z innymi pamięciami masowymi, dlatego rozpoznanie, kiedy dane muszą być dostępne operacyjnie, a kiedy nie, jest ważne dla definiowania strategii przechowywania.
Integracja operacyjna
Ze względu na wyspecjalizowaną kategorię zastosowań operacyjnych może być wymagana replikacja danych między wieloma systemami operacyjnymi, w tym wzorce, takie jak:
- Bankowość: zarządzanie relacjami z klientami na potrzeby interakcji z klientami pierwszej linii i replikacji do wielu systemów bankowych. Na przykład masz rachunki bieżące, karty kredytowe, kredyty hipoteczne i systemy sprawdzania zdolności kredytowej.
- Produkcja: zarządzanie relacjami z klientami w celu przyjmowania zamówień pierwszej linii oraz system zarządzania zasobami przedsiębiorstwa w celu zarządzania łańcuchem dostaw.
- Obsługa zgłoszeń alarmowych przez policję: Systemy zarządzania relacjami z obywatelami oraz systemy dyspozytorskie dla jednostek policji oferują zarządzanie rozmieszczeniem sił.
W takich przypadkach, mimo że każdy system może mieć unikatowe dane, które śledzi, często istnieją typowe dane podstawowe, które muszą być udostępniane między systemami i synchronizowane, co prowadzi do potrzeb integracji.
Dane inspekcji
Firma zazwyczaj ponosi odpowiedzialność regulacyjną za przechowywanie danych przez dłuższy czas — na przykład średnio przez siedem lat — do celów audytu, zarówno wewnętrznego, jak i zewnętrznego, takich jak wspieranie audytu finansowego, ujawnianie informacji regulacyjnych lub przegląd oszustw.
Te dane zazwyczaj obejmują zarówno dane potrzebne do celów operacyjnych, jak i dane, które nie są już potrzebne, ponieważ umożliwiają przeglądanie całego zestawu danych z jednego miejsca.
Dane analityczne
Organizacje mają potrzebę przeglądu i analizy stanu swojej działalności. Muszą mierzyć i porównywać statystyki w czasie i obejmujące wiele lub wszystkie części działalności.
Duże okresy i zakres danych, na podstawie których może odbywać się ta analiza, prowadzą do konieczności replikacji danych operacyjnych do wyspecjalizowanych narzędzi analitycznych. Dzięki temu złożone analizy nie wpływają na wydajność systemów operacyjnych, ale także umożliwiają analizę zestawów danych, które wykraczają poza okres, w którym dane są potrzebne operacyjnie. Na przykład może być konieczne porównanie danych z siedmiu lat, a nie z jednego do dwóch lat. Różne potrzeby analityczne mogą jednak wymagać pełnych okresów przechowywania danych lub obejmować tylko dane przechowywane w systemach operacyjnych.
Dane analityczne zazwyczaj umożliwiają agregację danych z wielu części firmy i łączą dane z wielu systemów.
Przepływ danych
Dane tych typów zwykle przepływają w czasie z danych operacyjnych, a następnie do danych transakcyjnych lub historycznych, jak pokazano na poniższej ilustracji.
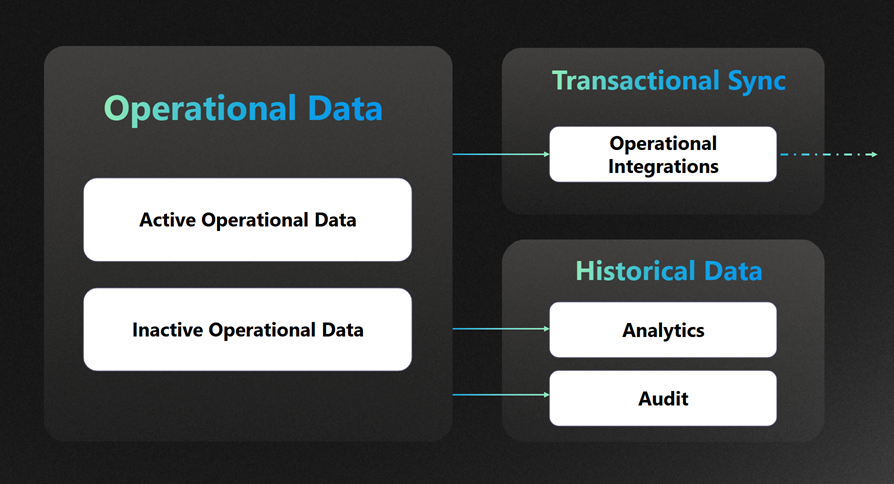
Różne rodzaje pamięci masowej
Typy magazynu w Dataverse
Dataverse Organizuje magazyn w trzech głównych kategoriach, z których każda ma odrębne wzorce użycia i implikacje dotyczące rozliczeń.
| Typ magazynu | Opis | Typowe przypadki użycia |
|---|---|---|
| Przechowywanie w bazie danych | Przechowuje uporządkowane dane w tabelach — standardowych i niestandardowych. | Rekordy biznesowe, metadane, relacje i konfiguracje |
| Magazyn plików | Przechowuje załączniki i dane binarne. | Załączniki do wiadomości e-mail, obrazy, dokumenty przesłane za pośrednictwem Power Apps |
| Przechowywanie dzienników | Przechowuje dzienniki inspekcji i dzienniki śledzenia wtyczek. | Śledzenie zmian, inspekcja, diagnostyka i zgodność |
Typy magazynów platformy finansowej i operacyjnej
Magazyn danych dla finansów i operacji jest zarządzany oddzielnie, ale w coraz większym stopniu jest integrowany z ekosystemem Power Platform. Obejmuje ona następujące typy magazynów.
| Typ magazynu | Opis | Typowe przypadki użycia |
|---|---|---|
| Operacyjne przechowywanie baz danych | Podstawowe dane transakcyjne dla finansów, łańcucha dostaw, zasobów ludzkich i nie tylko | Zapisy w księdze, inwentaryzacja, zamówienia klientów |
| Przechowywanie dokumentów | Duże obiekty binarne (obiekty blob) przechowywane w Azure Blob Storage | Faktury, paragony, zeskanowane dokumenty |
| Telemetria i dzienniki diagnostyczne | Dzienniki systemowe i dane telemetryczne | Monitorowanie wydajności, diagnostyka problemów. |
Współdzielone i zintegrowane scenariusze pamięci masowej
Magazyn danych z podwójnym zapisem
- Umożliwia synchronizację w czasie rzeczywistym między aplikacjami Dataverse finansowymi i operacyjnymi.
- Wymaga starannego zarządzania rolami i pojemnością, aby uniknąć duplikacji lub nadmiernego wykorzystania.
Retencja długoterminowa (LTR)
- Przenosi dane historyczne do zarządzanej usługi Data Lake (MDL).
- Zmniejsza użycie podstawowej pamięci masowej przy jednoczesnym zachowaniu zgodności i dostępu do analiz.
- Integruje się z:
- Szybkie wyszukiwanie (natywne wyszukiwanie Dataverse)
- OneLake (analiza oparta na sieci szkieletowej)
- Synapse Link (niestandardowa analiza jeziora)
Jak Twoje dane rosną w czasie
W miarę jak organizacje coraz powszechniej korzystają z Dataverse platformy finansowej i operacyjnej Dynamics 365, wzrost ilości danych staje się zarówno oznaką sukcesu, jak i strategicznym wyzwaniem. To, co zaczyna się jako szczupły, transakcyjny zestaw danych, może szybko przekształcić się w złożoną, wielowarstwową infrastrukturę danych. W tej sekcji omówiono pięć kluczowych czynników wzrostu ilości danych i ich wpływ na pamięć masową, wydajność i zarządzanie.
Używanie magazynowania danych operacyjnych
Aby uzyskać wgląd w dane z systemów transakcyjnych, wiele organizacji korzysta z usługi Azure Synapse Link, OneLake lub eksportu danych w celu replikowania danych z usługi Dataverse oraz aplikacji finansowych i operacyjnych do systemu analitycznego. Chociaż obsługuje to zaawansowane obciążenia raportowania i sztucznej inteligencji, wprowadza również:
Nadmiarowa pamięć masowa w warstwach operacyjnych i analitycznych
Dane są często duplikowane między środowiskami operacyjnymi i analitycznymi. Ta nadmiarowość zwiększa ogólne zużycie pamięci masowej i może prowadzić do wyższych kosztów, zwłaszcza jeśli dane historyczne są przechowywane w obu systemach przez czas nieokreślony.
Obciążenie związane z duplikowaniem schematu i wersjonowaniem
Aby zachować spójność między systemami, organizacje muszą replikować zmiany schematu — na przykład nowe pola i kolumny o zmienionych nazwach — zarówno w warstwie operacyjnej, jak i analitycznej. Zwiększa to złożoność zarządzania danymi i zwiększa ryzyko dryfu schematu, który może spowodować awarię podrzędnych raportów lub modeli.
Zwiększona retencja danych historycznych do analizy trendów
Systemy analityczne zazwyczaj przechowują dane przez dłuższy czas w celu wspierania analizy trendów, prognozowania i sprawozdawczości regulacyjnej. Choć jest to korzystne, długoterminowe przechowywanie może prowadzić do nadmiernego rozrostu zbiorów danych, jeśli nie stosuje się odpowiednich strategii archiwizacji i tieringu.
Magazynowanie danych jest niezbędne w przypadku analizy, ale bez zasad zarządzania cyklem życia może ono dwu- lub trzykrotnie zwiększyć zapotrzebowanie na miejsce w magazynie.
Korzystanie z wyszukiwania danych
Funkcje takie jak wyszukiwanie w usłudze Dataverse, indeksowanie Copilot i wyszukiwanie trafności wymagają indeksowania dużych ilości danych ustrukturyzowanych i nieustrukturyzowanych. Te indeksy często:
Zużycie pamięci masowej logów i bazy danych
Indeksy wyszukiwania są przechowywane zarówno w magazynie logów, jak i w bazie danych. W miarę jak coraz więcej tabel i pól jest oznaczanych jako możliwe do przeszukiwania, rozmiar indeksu rośnie proporcjonalnie. Może to znacząco wpłynąć na ogólne użycie pamięci masowej, szczególnie w środowiskach z dużą liczbą rekordów lub częstymi zmianami schematu.
Zachowywanie nawet w przypadku nieużywanych lub przestarzałych tabel
Nawet jeśli niektóre tabele są przestarzałe lub nie są już aktywnie używane, skojarzone z nimi indeksy wyszukiwania mogą być trwałe, chyba że zostaną jawnie usunięte. Prowadzi to do niepotrzebnego zużycia pamięci masowej i może skomplikować planowanie pojemności.
Są często duplikowane w różnych środowiskach, takich jak środowiska programistyczne, testowe i produkcyjne
Indeksy wyszukiwania są zwykle replikowane w środowiskach programistycznych, testowych i produkcyjnych. Chociaż zapewnia to spójne zachowanie wyszukiwania, zwielokrotnia również zużycie pamięci masowej, szczególnie gdy środowiska są często klonowane lub odświeżane.
Wyszukiwanie poprawia użyteczność i gotowość na AI, ale nadmierny rozrost indeksu po cichu prowadzi do przekroczenia limitów pamięci masowej.
Włączanie logowania do danych
Dzienniki inspekcji, dzienniki śledzenia dodatków typu plug-in i dane telemetryczne mają kluczowe znaczenie dla zgodności, debugowania i monitorowania. Należy jednak zwrócić uwagę na następujące punkty:
Przechowywanie dzienników rośnie liniowo wraz ze wzrostem użycia i liczby użytkowników.
Dane dziennika rosną proporcjonalnie do:
- Liczba użytkowników i poziom ich aktywności
- Wolumen transakcji i integracji
- Złożoność logiki biznesowej, takiej jak wtyczki i przepływy pracy
W środowiskach o dużym obciążeniu może to prowadzić do szybkiego rozrostu tabel dziennika, zużywając zarówno limity pamięci masowej bazy danych, jak i dzienników.
Domyślne wartości przechowywania są często zbyt długie, na przykład 90 dni lub więcej.
Domyślnie wiele funkcji rejestrowania przechowuje dane przez dłuższy czas, na przykład 90 dni lub dłużej. Chociaż obsługuje to długoterminową możliwość śledzenia, może to spowodować niepotrzebne zużycie magazynu, zwłaszcza gdy dzienniki nie są aktywnie przeglądane ani eksportowane.
Dzienniki generowane przez system są rozliczane klientowi w Dataverse.
W usłudze Dataverse dzienniki generowane przez system, w tym dzienniki audytu i dzienniki śledzenia wtyczek, są wliczane do limitu magazynu przysługującego klientowi. Oznacza to, że bez odpowiednich strategii czyszczenia lub eksportu logowanie może bezpośrednio przyczyniać się do przekroczenia limitów pamięci masowej i wzrostu kosztów licencjonowania.
Rejestrowanie nie podlega negocjacjom w przypadku branż regulowanych, ale musi być sparowane ze strategiami przechowywania i eksportu, takimi jak Azure Monitor lub Log Analytics.
Posiadanie wielu kopii środowiska produkcyjnego
Aby wesprzeć prace rozwojowe, testowanie, szkolenia i rozwiązywanie problemów, klienci często tworzą środowiska testowe typu sandbox lub środowiska klonowane. Każdy egzemplarz:
- Replikuje pełny miejsce na dane i indeks.
- Może zawierać nieoczywiste zależności, takie jak indeksy wyszukiwania, dzienniki inspekcji i metadane.
- Rzadko jest czyszczony po użyciu.
Rozrost środowiska jest głównym czynnikiem wpływającym na koszty i złożoność pamięci masowej. Zasady zarządzania i automatyzacja są kluczem do powstrzymywania.
Optymalizacja zapytań na danych
Wraz ze wzrostem wolumenu danych oraz rosnącym znaczeniem szybkości reakcji aplikacji klienci i niezależni dostawcy oprogramowania często stosują różne techniki optymalizacji zapytań, aby poprawić wydajność w środowiskach Dataverse i Dynamics 365. Te strategie są szczególnie powszechne w scenariuszach raportowania, analizy i integracji.
Aby zwiększyć wydajność, klienci i niezależni dostawcy oprogramowania często tworzą:
Indeksy niestandardowe i widoki zmaterializowane
Służą one do przyspieszania wykonywania zapytań przez wstępne obliczanie sprzężeń lub agregacji. Są one przydatne w scenariuszach obejmujących złożone filtry lub duże zestawy danych.
Nieznormalizowane tabele na potrzeby raportowania
Aby uprościć raportowanie i zmniejszyć złożoność zapytań, deweloperzy często tworzą spłaszczone wersje danych relacyjnych. Te tabele zmniejszają potrzebę sprzężeń środowiska uruchomieniowego i poprawiają wydajność pulpitu nawigacyjnego.
Buforowanie warstw lub agregacji
Często używane dane są czasami wstępnie agregowane lub buforowane w tabelach pośrednich lub magazynach zewnętrznych w celu zmniejszenia obciążenia podstawowej bazy danych.
Poprawiają one szybkość reakcji, ale także:
Zwiększ wykorzystanie pamięci masowej
Każda warstwa optymalizacji wprowadza więcej struktur danych, niezależnie od tego, czy jest to kopia istniejących danych w nieznormalizowanym formacie, wstępnie obliczony widok, czy tabela pamięci podręcznej. Struktury te często duplikują dane już przechowywane w innym miejscu, co prowadzi do większego ogólnego zużycia pamięci masowej. W środowiskach z rygorystycznymi limitami przestrzeni dyskowej lub modelami licencjonowania opartymi na kosztach, takimi jak Dataverse, może to szybko prowadzić do niepotrzebnych dodatkowych opłat.
Może zostać osierocony w miarę rozwoju aplikacji
W miarę rozwoju aplikacji niektóre artefakty optymalizacji mogą już nie być przywoływane przez aktywne raporty, pulpity nawigacyjne lub integracje. Te osierocone obiekty nadal zużywają pamięć masową i mogą nawet spowolnić działanie systemu, na przykład podczas tworzenia kopii zapasowych lub indeksowania, jeśli nie zostaną zidentyfikowane i usunięte. Bez regularnych audytów mogą się one kumulować niezauważenie, podważając wzrost wydajności, do którego zostały stworzone.
Optymalizacja zapytań jest niezbędna do skalowania, ale musi być zrównoważona z higieną magazynu i dostrajaniem opartym na telemetrii.
Indeksy i ich wpływ na pamięć masową
Indeksy są niezbędne do zwiększenia wydajności zapytań i korzystania z szybkiego pobierania danych w dużych zestawach danych. Zarówno w aplikacjach Dataverse, jak i Dynamics 365 Finance and Operations, indeksy są tworzone automatycznie dla kluczy podstawowych i pól często używanych w zapytaniach, a inne indeksy niestandardowe można definiować w celu obsługi określonych scenariuszy biznesowych.
Chociaż indeksy mają kluczowe znaczenie dla wydajności, mają również bezpośredni wpływ na użycie pamięci masowej, często niedoceniane podczas projektowania rozwiązania.
Jak indeksy zużywają magazyn
Fizyczne duplikowanie danych: każdy indeks przechowuje kopię indeksowanych kolumn wraz ze wskaźnikami do odpowiednich wierszy. Im więcej kolumn i wierszy jest indeksowanych, tym większy jest rozmiar indeksu.
Wzrost wraz z ilością danych: wraz ze wzrostem tabeli bazowej rośnie również indeks. W środowiskach z dużą liczbą transakcji indeksy mogą szybko rosnąć, szczególnie w przypadku dużych, nieznormalizowanych tabel lub tych z częstymi wstawieniami i aktualizacjami.
Wiele indeksów na tabelę: często zdarza się, że pojedyncza tabela ma wiele indeksów, na przykład do wyszukiwania, filtrowania, sortowania i sprzężeń. Każdy kolejny indeks zwiększa łączny rozmiar zajmowanej pamięci masowej.
Indeksy wyszukiwania w Dataverse: Funkcje, takie jak Dataverse wyszukiwanie i indeksowanie Copilot, tworzą wyspecjalizowane indeksy, które obejmują wiele pól i tabel. Są one przechowywane w tabeli DataverseSearch i mogą zajmować znaczne miejsce, zwłaszcza gdy są używane w wielu środowiskach, takich jak środowiska programistyczne, testowe i produkcyjne.
Indeksy generowane przez system: niektóre indeksy są tworzone automatycznie przez platformę, na przykład dla pól odnośników lub relacji. Mogą one być kontynuowane nawet wtedy, gdy skojarzone tabele są przestarzałe, chyba że zostaną jawnie usunięte.
Implikacje dotyczące pamięci masowej
- Zwiększone użycie magazynu bazy danych i dzienników: Indeksy zwiększają wykorzystanie zarówno magazynu bazy danych, jak i magazynu dzienników, co może wpływać na koszty licencjonowania w usłudze Dataverse.
- Duplikowanie środowisk: gdy środowiska są kopiowane lub odświeżane, wszystkie indeksy są również duplikowane, co zwiększa wykorzystanie pamięci masowej w środowiskach programistycznych, testowych i produkcyjnych.
- Obciążenie związane z konserwacją: indeksy muszą być aktualizowane w miarę zmian danych, co może zwiększyć opóźnienie zapisu i zużycie zasobów.
Wpływ synchronizacji po stronie serwera na pamięć masową
Synchronizacja Dataverse na serwerze umożliwia bezproblemową integrację wiadomości e-mail, terminów i zadań między Microsoft Exchange i Dataverse. Zwiększa produktywność i automatyzację, ale także przyczynia się do zużycia pamięci masowej w następujący sposób.
- Tworzenie rekordu aktywności: Każda zsynchronizowana wiadomość e-mail lub termin generuje rekord Dataverse aktywności, który zawiera metadane, zawartość treści i potencjalnie załączniki.
- Przechowywanie załączników: Jeśli załączniki nie są filtrowane ani przenoszone poza system, są przechowywane bezpośrednio w usłudze Dataverse, co zwiększa zużycie magazynu.
- Zgodność i przechowywanie: Organizacje korzystające z synchronizacji na serwerze do śledzenia zgodności mogą przechowywać więcej danych niż to konieczne, co jeszcze bardziej zwiększa ilość magazynu.
- Zawartość chroniona: nawet wiadomości e-mail chronione przez usługę Purview, mimo że mają ograniczoną widoczność zawartości, nadal generują rekordy zastępcze, które zajmują miejsce.
Aby poradzić sobie z tym wpływem, przedsiębiorstwa powinny wdrożyć zasady przechowywania, rozważyć usunięcie załączników i regularnie monitorować woluminy rekordów aktywności.
Jak mogę zarządzać stale rosnącą pamięcią masową?
Niezależnie od tego, czy już teraz borykasz się z nadwyżkami pamięci masowej, czy też chcesz je wyprzedzić, zarządzanie wzrostem ilości danych na Dataverse platformie Dynamics 365 Finance and Operations wymaga przemyślanego podejścia opartego na zasadach. W tej sekcji przedstawiono dwa strategiczne punkty wejścia: reaktywne korygowanie i proaktywne zarządzanie.
Możliwe są dwa scenariusze:
- Chcesz proaktywnie stosować najlepsze rozwiązania w celu zarządzania magazynem i unikania wysokich kosztów w przyszłości.
- Jesteś już w sytuacji, w której konieczne jest zmniejszenie rozmiaru i kosztów pamięci masowej.
Stosowanie sprawdzonych metod zarządzania rozmiarem i kosztami magazynu
Scenariusz 1: Chcesz proaktywnie zastosować najlepsze rozwiązania dotyczące zarządzania magazynem
Jeśli nie działasz jeszcze w trybie kryzysowym, to dobry moment, by zastosować narzędzia i techniki do proaktywnego zarządzania pamięcią masową.
Skonfiguruj analitykę dla swoich danych
Wraz z rozwojem organizacji rośnie potrzeba wyciągania wniosków z danych operacyjnych bez wpływu na wydajność podstawowych aplikacji biznesowych. Microsoft oferuje wiele sposobów umożliwiających analizowanie danych z Dataverse oraz z Dynamics 365 Finance and Operations poprzez integrację z własnym jeziorem danych lub hurtownią danych.
Oto dwie potężne opcje, które warto rozważyć:
Opcja 1. Używanie usługi Azure Synapse Link — korzystanie z własnego jeziora
Azure Synapse Link umożliwia bezpośrednie nawiązanie połączenia Dataverse z własnym obszarem roboczym usługi Azure Data Lake lub Synapse. Umożliwia to replikację danych operacyjnych niemal w czasie rzeczywistym do środowiska analitycznego, bez konieczności pisania złożonych potoków ETL.
Korzyści:
- Uruchamiaj zaawansowane modele analityczne i sztucznej inteligencji na danych na żywo lub prawie na żywo.
- Unikaj wpływu wydajności na systemy produkcyjne.
- Korzystaj ze znanych narzędzi, takich jak T-SQL, Spark lub Power BI do raportowania.
Przykład zastosowania: Firma detaliczna korzysta z Synapse Link do analizy zachowań zakupowych klientów w różnych regionach, łącząc dane CRM z usługi Dataverse z zewnętrznymi danymi rynkowymi we własnym data lake.
Opcja 2. Korzystaj z OneLake — ujednoliconej analityki z Microsoft Fabric
Usługa OneLake, będąca częścią platformy Microsoft Fabric, zapewnia spójne środowisko jeziora danych, w którym można przechowywać i analizować dane z wielu źródeł, w tym z usługi Dataverse oraz aplikacji finansowych i operacyjnych, bez konieczności ich duplikowania.
Korzyści:
- Scentralizowana pamięć masowa dla wszystkich obciążeń analitycznych.
- Natywna integracja z usługami Power BI, Synapse i AI.
- Uproszczone zarządzanie i zabezpieczenia w różnych domenach danych.
Przykład użycia: Firma świadcząca usługi finansowe korzysta z OneLake do konsolidacji danych operacyjnych z aplikacji finansowych i operacyjnych oraz Dataverse z zewnętrznymi wskaźnikami ekonomicznymi, umożliwiając modelowanie ryzyka w czasie rzeczywistym i pulpity kierownicze. W ten sposób można oddzielić dane operacyjne od systemów podstawowych i umożliwić skalowalną, ekonomiczną analizę, eksportując te dane do własnych środowisk analitycznych, bez duplikowania obciążeń lub wpływu na wydajność.
Narzędzia i techniki mające na celu zmniejszenie ilości miejsca w magazynie
Dataverse Oferuje kilka wbudowanych narzędzi i strategii, które pomagają administratorom efektywnie zarządzać pamięcią masową i utrzymywać wydajność systemu.
Dataverse
Zarządzanie danymi przy użyciu zasad ładu
- Zacznij od środowisk i tabel, które zużywają najwięcej miejsca do magazynowania.
- Stosuj cykliczne zasady zarządzania, aby radzić sobie z przewidywalnym przyrostem danych, zamiast opierać się wyłącznie na jednorazowym czyszczeniu.
- Przetestuj kryteria usuwania i przechowywania w środowisku testowym przed użyciem ich w środowisku produkcyjnym.
- Regularnie przeglądaj wyniki działania zasad i niepowodzenia.
- Dodaj pojemność magazynu, gdy nie można usunąć wymaganych danych ani przenieść ich do długoterminowego przechowywania.
Oczyszczanie środowiska i danych
- Usuń nieużywane środowiska: Możesz usunąć środowisko, aby odzyskać miejsce w pamięci masowej i usunąć dane osobowe.
-
Zadania usuwania zbiorczego: Następujące dane można usunąć zbiorczo:
- Nieaktualne dane lub dane, które są nieistotne dla firmy.
- Niepotrzebne testy lub przykładowe dane.
- Dane, które są niepoprawnie importowane z innych systemów.
Optymalizacja plików i tabel
- Zmniejsz ilość miejsca na pliki przy użyciu wyszukiwania zaawansowanego: W tym artykule przedstawiono 15 metod lepszego zarządzania pamięcią masową. Zastosowanie jednej lub kilku z tych metod umożliwia kontrolowanie łącznego użycia magazynu danych. Można usuwać kategorie danych w momencie pojawiania się potrzeby lub skonfigurować zadania usuwania zbiorczego tak, aby powtarzały się w określonych odstępach czasu. Można na przykład usuwać notatki, załączniki, historię importu oraz inne dane.
- Wyczyść rekordy z tabel zadań systemowych (AsyncOperationBase) i dzienników procesów (WorkflowLogBase): Jeśli organizacja intensywnie korzysta z przepływów pracy lub przepływów procesów biznesowych, te tabele (AsyncOperationBase, WorkflowLogBase) rosną z czasem i ostatecznie stają się wystarczająco duże, aby wprowadzić problemy z wydajnością i zużywać nadmierną ilość miejsca w bazie danych organizacji. W przypadku WorkflowLogBase można skonfigurować automatyczne usuwanie ukończonych zadań przepływu pracy w tle.
Przechowywanie długoterminowe (LTR) i archiwizacja
- Archiwizacja danych: LTR: Dataverse obsługuje niestandardowe zasady przechowywania, aby bezpiecznie przechowywać nieograniczoną liczbę danych przez długi czas w opłacalny sposób. Chociaż Dataverse może wspierać rozwój Twojej firmy bez ograniczeń dotyczących ilości aktywnych danych, warto rozważyć przeniesienie nieaktywnych danych do magazynu długoterminowego przechowywania w usłudze Dataverse.
- Czyszczenie tabel Dataverse: Jeśli chcesz zachować dane, ale usunąć je z magazynu relacyjnego, przejdź do Długoterminowe przechowywanie danych w Dataverse. W przeciwnym razie wyczyść następujące tabele:
- ActivityPointerBase: Możesz wykonać kroki opisane tutaj, aby wyczyścić tabelę.
- AsyncOperationBase: Możesz wykonać kroki opisane tutaj, aby wyczyścić tabelę.
- msdyn_copilotinteraction: Możesz postępować zgodnie z instrukcjami tutaj, aby posprzątać tabelę.
- PrincipalObjectsAcces: Możesz wykonać kroki opisane tutaj, aby wyczyścić tabelę.
- Śledzenie subskrypcji: Możesz wykonać czynności opisane tutaj, aby wyczyścić tabelę.
Optymalizacja indeksu wyszukiwania
- Ogranicz wyszukiwanie w usłudze Dataverse: Możesz zmniejszyć rozmiar pamięci masowej, wykonując wszystkie kroki opisane w dokumencie Szczegółowe informacje o magazynie opartym na pojemności w usłudze Dataverse.
- Zmniejsz rozmiar tabeli DataverseSearch: Tabela DataverseSearch to łączna przestrzeń magazynowa używana przez indeks wyszukiwania Dataverse. Zawiera dane ze wszystkich pól tabel, które można wyszukiwać, pobierać i filtrować, zindeksowanych dla twojego środowiska. Rozmiar tabeli można zmniejszyć, usuwając kolumny wyszukiwania, kolumny widoku i warunki filtrowania dla co najmniej jednej tabeli. Aby usunąć wszystkie indeksowane dane, można wyłączyć wyszukiwanie Dataverse.
Aplikacje finansowe i operacyjne
Aplikacje finansowe i operacyjne oferują elastyczne opcje zarządzania pamięcią masową w środowiskach produkcyjnych i testowych.
Zarządzanie środowiskiem
- Ogranicz liczbę pełnych kopii środowiska produkcyjnego: możesz zmniejszyć całkowite zużycie przestrzeni dyskowej przez aplikacje finansowe i operacyjne, usuwając pełne kopie środowiska produkcyjnego w środowiskach testowych. Jeśli na przykład w piaskownicy znajduje się pięć kopii środowisk produkcyjnych, zużycie pamięci masowej jest sumą produkcji i pięciu kopii środowisk produkcyjnych w piaskownicy.
- Ograniczanie danych w środowiskach typu sandbox: Ograniczając dane w środowisku typu sandbox, można zmniejszyć całkowite zapotrzebowanie na przestrzeń dyskową. Możesz skorzystać z poniższych metod, aby wyczyścić dane w sandboxie.
- Proces przywracania obejmuje wykonywanie operacji otwierania i przycinania
- Napisz w języku T-SQL
- Napisz X++
- Wykonywanie kopii bez transakcji między środowiskami: Kopiowanie środowiska dla aplikacji finansowych i operacyjnych tradycyjnie wiązało się z pełnym duplikowaniem bazy danych, w tym konfiguracji, danych podstawowych i transakcji, co, choć przydatne do debugowania, znacznie zwiększa zużycie pamięci masowej zarówno w finansach, jak i operacjach Dataverse.
Niestandardowe czyszczenie i zarządzanie dziennikami
- W razie potrzeby napisz niestandardowe procedury czyszczenia: Możesz napisać niestandardowe procedury czyszczenia zgodnie z potrzebami Twojej firmy, aby usunąć niechciane dane.
- Unikaj przechowywania dzienników: Możesz przenieść SysDatabaseLog do mniej transakcyjnej bazy danych, aby zmniejszyć ogólne zużycie magazynu.
Archiwizacja i przechowywanie długoterminowe
-
Archiwizacja danych: LTR: Aplikacje finansowe i operacyjne umożliwiają organizacjom osiągnięcie następujących korzyści dzięki archiwizacji:
- Zabezpiecz historyczne, nieaktywne dane aplikacji przez długi czas, aby spełnić wymagania audytowe, prawne i regulacyjne.
- Zmniejsz rozmiar bazy danych aplikacji i zużywaną pojemność, aby potencjalnie zwiększyć wydajność aplikacji skojarzonej z dużymi tabelami.
- Konfigurowanie danych archiwalnych i zarządzanie nimi
- Dostosowywanie archiwum
- Konsolidacja transakcji magazynowych
Wbudowane procedury czyszczenia
- Procedury czyszczenia: W Dynamics 365 Finance i Dynamics 365 Supply Chain Management procedury czyszczenia są dostępne w różnych modułach. Procedury czyszczenia zawierają przegląd procedur, które są obecnie dostępne. Po skopiowaniu bazy danych piaskownicy należy uruchomić te procedury czyszczenia proaktywnie, aby usunąć niepotrzebne tabele, takie jak historia partii, dzienniki i historia transakcji detalicznych. Usuń nieaktualne lub nieistotne dane.
- Archiwizowanie danych transakcji kartą kredytową: Opisuje zadanie archiwizacji w Dynamics 365 Commerce, które może pomóc zwolnić miejsce w bazie danych dzięki archiwizacji tokenów płatności kartą kredytową.
Zmniejsz rozmiar i koszty pamięci masowej
Scenariusz 2: Jesteś już w sytuacji, w której konieczne jest zmniejszenie rozmiaru i kosztów magazynu
Oceń, co zużywa magazyn
- Użyj centrum administracyjnego Power Platform oraz raportów dotyczących magazynu dla aplikacji Finance and Operations, aby zidentyfikować tabele, typy plików i dzienniki zajmujące najwięcej miejsca.
- Użyj danych telemetrycznych, jeśli są dostępne, aby przypisać użycie do określonych aplikacji, użytkowników lub jednostek biznesowych.
Priorytetowo traktuj kandydatów do sprzątania
- Skoncentruj się na:
- Tabele etapowe i integracyjne, takie jak bufory podwójnego zapisu
- Dzienniki inspekcji: przechowuj je we własnym magazynie
- Nieużywane środowiska lub piaskownice
- Osierocone metadane i indeksy wyszukiwania
- Usuń to, czego nie potrzebujesz, na przykład usuwanie zbiorcze
Używanie usługi Synapse Link i OneLake do raportowania analitycznego
- Eksportuj dane analityczne do usługi Synapse Link.
- Korzystaj z OneLake, aby uzyskać dostęp do przechowywanych danych i danych biznesowych na potrzeby raportowania i analizy.
Zastosuj retencję długoterminową (LTR)
- Przenoszenie danych historycznych do usługi Managed Data Lake (MDL) przy użyciu zasad LTR.
- Utrzymuj dostęp do wyszukiwania i analiz za pośrednictwem funkcji Szybkie szukanie, Synapse Link lub OneLake.
Przypadki użycia
Przypadki użycia zarządzania pamięcią masową w Dataverse środowiskach finansowych i operacyjnych mają kluczowe znaczenie dla optymalizacji przestrzeni bazy danych, zwiększenia wydajności systemu i spełnienia wymagań prawnych. Poniżej znajduje się kilka typowych scenariuszy, które pokazują, jak można zastosować te strategie:
Zarządzanie wzrostem ilości danych historycznych
- Scenariusz: Firma działa w usłudze Dynamics 365 od kilku lat i zgromadziła duże ilości historycznych transakcji i załączników.
- Działanie: Zaimplementuj długoterminowe strategie przechowywania w celu przechowywania nieaktywnych danych, zmniejszenia rozmiaru podstawowej bazy danych i utrzymania zgodności z wymaganiami inspekcji.
Przechowywanie danych w oparciu o zgodność
- Scenariusz: Klient z branży podlegającej regulacjom musi przechowywać dane finansowe lub dane klienta przez siedem do dziesięciu lat w formacie odpornym na manipulacje.
- Działanie: Użyj rozwiązania LTR do przechowywania niezmiennych danych tylko do odczytu zgodnie z wymogami prawnymi i regulacyjnymi, jednocześnie ograniczając wolumen danych biznesowych bez negatywnego wpływu na analizy i raportowanie.
Optymalizacja indeksu usługi Search i Copilot
- Scenariusz:Wyszukiwanie Dataverse i indeksowanie Copilot są włączone we wszystkich środowiskach, w tym w nieużywanych tabelach.
- Akcja: Przeprowadź inspekcję pól z możliwością wyszukiwania i wyłącz indeksowanie dla tabel o niskiej wartości lub przestarzałych. Monitoruj rozmiar tabeli DataverseSearch i optymalizuj konfiguracje, aby zmniejszyć ilość miejsca w dzienniku i bazie danych.
Zarządzanie inspekcją i telemetrią
- Scenariusz: Dzienniki śledzenia działania wtyczek i dzienniki audytu szybko rosną, zajmując coraz więcej miejsca i wpływając na wydajność.
- Akcja: Eksportuj dzienniki do systemów zewnętrznych, takich jak Azure Monitor, i automatyzuj czyszczenie starych wpisów, aby zachować widoczność bez przepełniania magazynu.
Integracja hurtowni danych i analityki
- Scenariusz: Organizacja replikuje dane operacyjne do Azure Synapse lub OneLake na potrzeby analityki, co prowadzi do powielania magazynu danych.
- Akcja: Używaj eksportów przyrostowych, stosuj filtry i unikaj pełnej replikacji zestawu danych, aby zminimalizować nadmiarowość, jednocześnie umożliwiając szczegółowe informacje.
Zmniejszenie nadwyżek magazynowych
- Scenariusz: Klient otrzymuje powiadomienie o przekroczeniu Dataverse limitu magazynowania, co prowadzi do nieoczekiwanych kosztów.
- Akcja: Użyj raportów pojemności, aby zidentyfikować tabele o największym zużyciu, oczyścić przestarzałe środowiska i usunąć nieużywane załączniki lub dzienniki. Rozważ przeniesienie zimnych danych — zazwyczaj rekordów historycznych lub rzadko używanych — do tańszych warstw magazynu.
Optymalizacja wydajności w dużych tabelach
- Scenariusz: Procesy krytyczne dla działania firmy spowalniają z powodu dużych tabel.
- Działanie: Archiwizuj stare rekordy, wyczyść zadania systemowe, na przykład AsyncOperationBase i WorkflowLogBase.
Zarządzanie cyklem życia środowiska
- Scenariusz: Środowiska deweloperskie i testowe są klonowane z produkcji, duplikując wszystkie dane i indeksy.
- Działanie: Ogranicz rozmiar środowisk piaskownicy po ich odświeżeniu, wyłącz niepotrzebne indeksowanie wyszukiwania i usuń dane testowe, aby zmniejszyć zbędne zużycie magazynu danych. Usuń nieużywane środowiska piaskownicy, aby zaoszczędzić miejsce na dysku.
Analizy przypadku
Studium przypadku 1: Zmniejszanie nadwyżek magazynowych dzięki czyszczeniu indeksu
Profil klienta: Globalna firma produkcyjna korzystająca z usługi Dynamics 365 dla aplikacji łańcucha dostaw oraz finansowych i operacyjnych.
Wyzwanie: Klient doświadczał nieoczekiwanych nadwyżek pamięci masowej i spadku wydajności w swoim środowisku produkcyjnym. Badanie wykazało, że wiele niestandardowych indeksów i zmaterializowanych widoków, utworzonych podczas wczesnej implementacji, nie było już używane, ale nadal zajmowało znaczną ilość miejsca.
Rozwiązanie: Zespół przeprowadził kwartalny audyt wszystkich indeksów niestandardowych i usunął te, do których nie odwołują się aktywne zapytania lub raporty. Wdrożono również politykę nadzoru dotyczącą weryfikacji wniosków o utworzenie nowych indeksów przed ich wdrożeniem.
Wynik:
- Zmniejszenie ilości miejsca w pamięci masowej bazy danych o 28%.
- Zwiększona wydajność zapytań o 15%.
- Uniknięto innych kosztów magazynowania w szacowanej wysokości 12 000 USD rocznie.
Studium przypadku 2: Archiwizowanie danych historycznych w celu osiągnięcia celów związanych z zapewnieniem zgodności i wydajnością
Profil klienta: Firma świadcząca usługi finansowe, korzystająca z Dataverse i Dynamics 365 do obsługi wdrażania klientów oraz zarządzania sprawami.
Wyzwanie: Firma musiała przechowywać dane klientów przez ponad siedem lat, aby spełnić wymagania prawne, ale rosnąca ilość nieaktywnych danych spowalniała aktywne przepływy pracy i zwiększała koszty przechowywania.
Rozwiązanie: Klient wdrożył długoterminową strategię przechowywania, wykorzystując Dataverse możliwości archiwizacji. Nieaktywne rekordy zostały przeniesione do zoptymalizowanej pod względem kosztów warstwy magazynowania tylko do odczytu, podczas gdy aktywne dane pozostały w magazynie o wysokiej wydajności.
Wynik:
- Zarchiwizowano ponad 1,2 miliona rekordów.
- Zmniejszono rozmiar podstawowej bazy danych o 40%.
- Utrzymanie pełnej audytowalności i zgodności z zasadami przechowywania.
Analiza przypadku 3: Usprawnianie indeksów wyszukiwania w różnych środowiskach
Profil klienta: Organizacja detaliczna z wieloma środowiskami Dataverse, w tym środowiskami programistycznymi, testowymi i produkcyjnymi, wspierająca rozwiązanie do zarządzania relacjami z klientami z funkcją Copilot.
Wyzwanie: Indeksy wyszukiwania były używane we wszystkich środowiskach, w tym w nieużywanych tabelach i danych testowych. Prowadziło to do rozdętych tabel DataverseSearch i niepotrzebnego zużycia pamięci masowej.
Rozwiązanie: Zespół dokonał przeglądu pól z możliwością wyszukiwania i przestał używać indeksowania tabel niekrytycznych w środowiskach deweloperskich i testowych. Zautomatyzowali również czyszczenie indeksu podczas odświeżania środowiska.
Wynik:
- Zmniejszono ilość miejsca w magazynie indeksów wyszukiwania o 35%.
- Skrócono czas odświeżania środowiska o 20%.
- Zmniejszono ogólne użycie magazynu dzienników i bazy danych.
Studium przypadku 4: Korzystanie z eksportu danych do celów analitycznych bez duplikowania pamięci masowej
Profil klienta: Dostawca opieki zdrowotnej korzystający z usługi Dynamics 365 oraz Dataverse do angażowania pacjentów i rozliczeń.
Wyzwanie: Zespół analityczny potrzebował dostępu do danych operacyjnych na potrzeby analizy trendów i modelowania sztucznej inteligencji, ale duplikowanie danych w oddzielnym magazynie zwiększało koszty magazynowania i złożoność.
Rozwiązanie: Klient korzystał z Azure Synapse Link z eksportem przyrostowym i magazynowaniem warstwowym w usłudze OneLake. Zachowali tylko niezbędne dane analityczne i zastosowali zasady przechowywania, aby zarządzać głębią historyczną.
Wynik:
- Umożliwiono analizę w czasie rzeczywistym bez wpływu na systemy operacyjne.
- Zmniejszenie nadmiarowej pamięci masowej o 45%.
- Ulepszone zarządzanie cyklem życia danych analitycznych.
Podsumowanie
Efektywne zarządzanie pamięcią masową ma kluczowe znaczenie dla utrzymania wydajności systemu i optymalizacji wykorzystania zasobów w środowiskach Dynamics 365. Procedury czyszczenia i zadania archiwalne opisane w tym artykule zapewniają solidne rozwiązania, które zwalniają cenne miejsce w bazie danych i usprawniają operacje. Korzystając z tych narzędzi, takich jak LTR i podobne techniki, klienci mogą sprostać typowym wyzwaniom związanym z pamięcią masową i stworzyć zrównoważone praktyki zarządzania danymi. Co więcej, rzeczywiste studia przypadków pokazują skuteczność tych podejść, oferując wgląd w ich praktyczne zastosowania. Przyjęcie tych strategii umożliwia organizacjom proaktywne zarządzanie potrzebami w zakresie pamięci masowej i zwiększanie ogólnej wydajności.
Materiały referencyjne
Czyszczenie pamięci masowej w Dataverse:
- Zwalnianie miejsca w magazynie
- Czyszczenie rekordów z tabel Zadanie systemowe (AsyncOperationBase) i Dziennik procesu (WorkflowLogBase)
Czyszczenie pamięci masowej w programie Finance and Operations:
- Pojemność magazynowa programu Finance and Operations
- Procedury oczyszczania w programie Dynamics 365 Finance i Dynamics 365 Supply Chain Management
- Archiwizowanie danych transakcji karty kredytowej - Commerce
Pojemność: