Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
GQL (Graph Sorgu Dili), graf veritabanları için ISO standartlaştırılmış sorgu dilidir. Microsoft Fabric'te graf verilerini sorgulamak, analiz etmek ve grafla verimli bir şekilde çalışmak için GQL kullanın.
SQL'i standartlaştıran ISO çalışma grubu GQL geliştirir. Sonuç olarak, GQL ifadeler, koşul ve veri türleri dahil olmak üzere SQL ile birçok kavramı paylaşır. SQL deneyiminiz varsa bu bilgilerin çoğunu GQL'ye uygulayabilirsiniz.
Bu makale, grafik olarak GQL'nin uçtan uca rehberidir. Dilin nasıl bir arada oturduğunu açıklar ve tam sözdizimi ile tip detayları için odaklanmış referanslara bağlantı verir. Aşağıdakileri kapsar:
- Temel kavramlar: Graf veri yapıları, desenler ve sorgu temelleri
-
Temel ifadeler:
MATCH,FILTER,LET,WHENORDER BYLIMIT, veRETURN - Veri türleri ve ifadeler: Değer türleri, işleçler ve yerleşik işlevler
- Gelişmiş teknikler: Çok deyimli oluşturma, değişken kapsam belirleme ve toplama stratejileri
Uyarı
GQL için resmi Uluslararası Standart ISO/IEC 39075 Bilgi Teknolojisi - Veritabanı Dilleri - GQL'dir.
Eğer dil rehberi yerine görev odaklı rehberlik arıyorsanız, nasıl yapılır rehberlerine bakabilirsiniz:
- Ortak GQL sorguları yazma : komşular, çok atlamalı geçiş, paylaşılan bağlantılar ve varlık varlığı denetimleri
- Grafik verilerini filtreleme ve toplama — FİlTRE, WHERE, GROUP BY ve toplama işlevleri
- Çok atlamalı desenler, yol modları, değişken yeniden kullanımı ve İSTEĞE BAĞLı KAÇINCI gibi grafik deseni sorguları yazma
- GQL sorgu performansını iyileştirme — filtreleme stratejisi, çapraz geçiş sınırları ve anahtar kısıtlama önerileri
Tam detaylara ihtiyacınız olduğunda odaklanmış referans makalelerini kullanın:
| Gerekli bilgiler | Kesin makale |
|---|---|
| Bir bakışta söz dizimi | GQL hızlı referans |
| düğüm, kenar, yol ve desen bileşimi sözdizimi | GQL grafik desenleri |
| Operatörler, önlemler ve fonksiyonlar | GQL ifadeleri, önkoşulları ve işlevleri |
| Kelime sözdizimi, değer davranışı ve tür dönüşümleri | GQL değerleri ve değer türleri |
| Grafik tipi tanımları ve kısıtlamaları | GQL grafik türleri |
| Mevcut ISO GQL özellik kapsamı | GQL standart uyumu |
| Mevcut Fabric'e özgü kısıtlamalar ve sınırlamalar | Geçerli sınırlamalar |
Önkoşullar
Başlamadan önce şu kavramları bildiğinizden emin olun:
- Basik veritabanlarını anlama - İlişkisel (SQL), NoSQL veya grafik gibi herhangi bir veritabanı sistemiyle ilgili deneyim yararlı olur.
- Grafik kavramları - Bağlı verilerdeki düğümleri, kenarları ve ilişkileri anlama.
- Sorgu temelleri - Filtreleme, sıralama ve toplama gibi temel sorgu kavramları hakkında bilgi.
Önerilen arka plan:
- SQL veya openCypher dilleri deneyimi, GQL söz dizimini öğrenmeyi kolaylaştırır (bunlar GQL'nin kökleridir).
- Veri modellemeyi tanıma, grafik şeması tasarımına yardımcı olur.
- Graf verileri için özel kullanım örneğinizi anlama.
Neye ihtiyacınız var:
- Sorgu özelliklerine sahip bir grafik çalışma alanına erişim.
- Örnek veriler veya sosyal ağ örneklerimizle çalışmaya istekli olma.
- Sorgu yazmak için temel metin düzenleyicisi.
Tip
Grafik veritabanlarını kullanmaya yeni başladıysanız, bu kılavuza devam etmeden önce graf veri modellerine genel bakış ile başlayın.
GQL'i özel kılan şey
GQL özellikle grafik verileri için tasarlanmıştır, bu yüzden sözdizimi varlıkların nasıl bağlı olduğunu doğrudan ifade eder. SQL genellikle ilişkileri tablolar arasındaki birleşiklerle ifade ederken, GQL verilerin diyagramlarına benzeyen grafik desenleri kullanır.
Örneğin, aşağıdaki sorgu, birbirini tanıyan ve her ikisi de 1999'dan önce doğmuş çiftleri bulur:
MATCH (person:Person)-[:knows]-(friend:Person)
WHERE person.birthday < 19990101
  AND friend.birthday < 19990101
RETURN person.firstName || ' ' || person.lastName AS person_name,
       friend.firstName || ' ' || friend.lastName AS friend_name
Bu desen (person:Person)-[:knows]-(friend:Person) , ilişki yapısının uyumlu olduğunu gösterir. Değişkenler iki kişiyi bağlar, böylece sorgu onların özelliklerini filtreleyip döndürebilir.
GQL ile ilgili temel bilgiler
Bu kavramlar GQL'nin temelini oluşturur:
- Grafikler, etiketleri ve özellikleri olan düğümler ve kenarlar içerir.
- Grafik tipleri, grafikte izin verilen düğüm tiplerini, kenar tiplerini ve kısıtlamaları resmi olarak tanımlar.
-
Sorgular, verileri işlemek ve sonuç elde etmek için ,
FILTER, veRETURNgibi ifadeleriMATCHkullanır. - Desenler , eşleşecek grafik yapılarını tanımlar.
- İfadeler değerleri hesaplar, dönüştürür ve karşılaştırır.
- Önlemler, koşulları test etmek için kullanılan Boolean ifadeleridir.
- Değer türleri, sorguların işleyebileceği ve grafik özelliklerinin depolayabileceği değer türlerini tanımlar.
Grafik verilerini anlamak
GQL ile çalışmak için, dilin sorguladığı etiketlenmiş özellik grafiği yapısını anlamanız gerekir.
Düğümler ve kenarlar: yapı taşları
Etiketli bir özellik grafiği, iki tür grafik elemanı içerir:
- Düğümler genellikle insanlar, organizasyonlar, gönderiler veya ürünler gibi varlıkları temsil eder.
- Kenarlar, düğümler arasındaki bağlantıları temsil eder; örneğin bir kişinin başka birini tanıması veya bir şirkette çalışması gibi.
Her grafik elemanının bir iç kimliği, bir veya daha fazla etiketi ve bir dizi özellik vardır. Etiketler, örneğin veya knowsgibi öğeleri Person sınıflandırır. Özellikler, isim-değer çiftleridir, örneğin firstName: 'Alice' veya birthday: 19730108u. Grafik'te, bir kenarın her zaman tam olarak bir etiketi vardır.
Her kenar tam olarak iki düğümü birbirine bağlar: bir orijin ve bir hedef. Kenar yönü grafik yapısının bir parçasıdır. Örneğin, bir workAt kenar bir Person orijini hedefe Company bağlayabilir.
Uyarı
Graph şu anda yönlendirilmedik kenarlar oluşturmayı desteklemiyor. Mevcut bir yönlendirilmiş kenarı, örneğin herhangi bir yönlendirilmiş kenar deseni -[:knows]-kullanarak her iki yönde sorgulayabilirsiniz.
Grafikler iyi şekillendirilmiştir: her kenar, aynı grafikte bulunan iki düğümü birbirine bağlar.
Graf modelleri ve grafik türleri
Bir Fabric graf modeli, grafikte mevcut düğüm türlerini, kenar türlerini, özellikleri, kaynak eşlemelerini ve anahtarları tanımlar. Hangi kaynak tablo satırlarının düğüm ve kenar olduğunu ve bu öğelerin nasıl bağlandığını belirtir. Modelleme rehberliği için bkz. Grafik şeması tasarla.
GQL standardı, izin verilen düğüm türlerini, kenar türlerini, özelliklerini ve kısıtlamalarını resmi olarak tanımlamak için bir grafik tipi kullanır. Grafik tipleri, Fabric grafik modeliyle temsil edilen yapının dil düzeyindeki karşılığıdır, ancak Graph şu anda GQL grafik tipi bildirimlerini doğrudan kabul etmiyor. Biçimsel sözdizimi ve kavramlar için bakınız: GQL grafik türleri.
Bu rehberde kullanılan örnek grafik
Örnekler, insanları, mekanları, organizasyonları, mesajları, etiketleri ve bunları bağlayan kenarları içeren sosyal ağ örnek veri setini kullanır.
Örnek grafik bu alanları birbirine bağlar:
- İnsanlar başkalarını tanır, şirketlerde çalışır ve üniversitelerde okuyor.
- Şehirler, ülkeler veya bölgeler ve kıtalar coğrafi bir hiyerarşi oluşturur.
- Forumlarda gönderiler bulunur ve insanlar gönderi ve yorumlar oluşturur.
- Etiketler içeriği kategorize eder ve insanların ilgi alanlarını temsil eder.
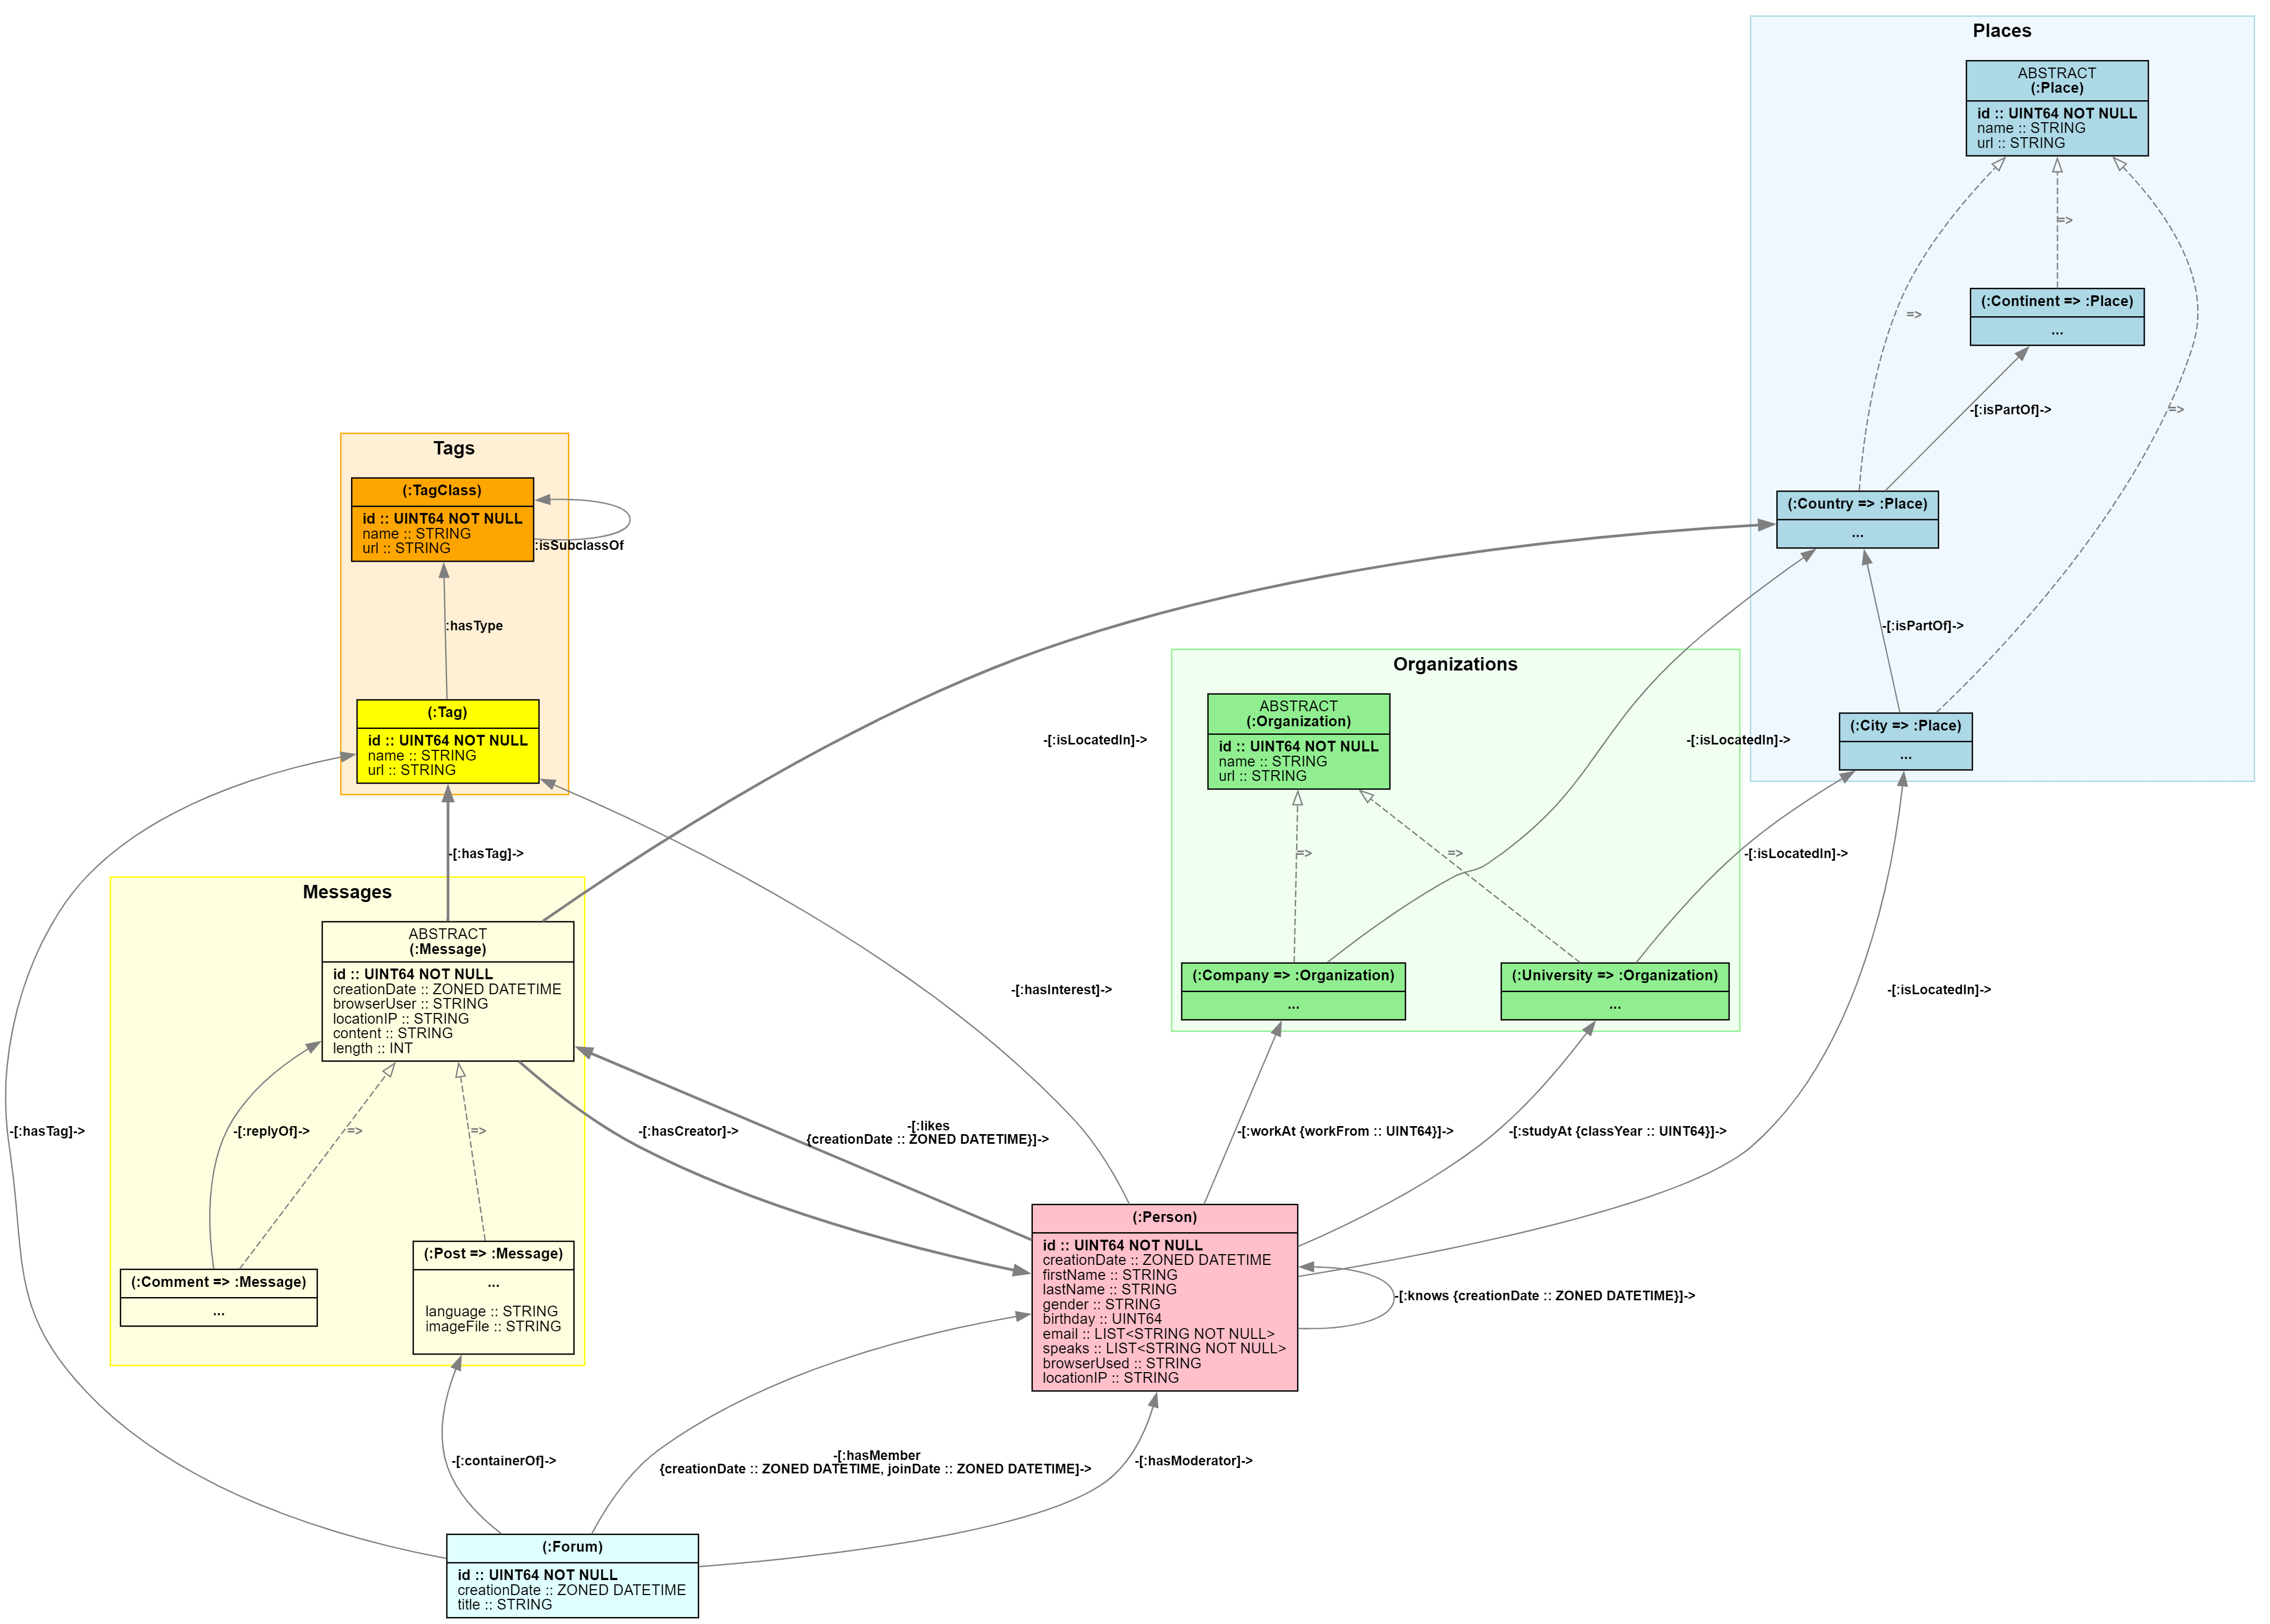
Tam örnek yapı için sosyal ağ şeması örneğine bakınız. Genel grafik kavramları için bkz. Etiketli özellik grafikleri.
İlk GQL sorgularınız
Grafla ilgili temel bilgileri anladığınıza göre GQL kullanarak graf verilerini sorgulamayı görelim. Bu örnekler basitten karmaşıka doğru derlenip GQL'nin yaklaşımının grafik sorgularını nasıl sezgisel ve güçlü hale getirdiğini gösterir.
Basit bir başlangıç: tüm kişileri bulma
Mümkün olan en temel sorguyla başlayın. Grafikteki tüm kişilerin:Person adlarını (ad, soyadı) bulun.
MATCH (p:Person)
RETURN p.firstName, p.lastName
Bu sorgu aşağıdaki gibi çalışır:
-
MATCHetiketliPersontüm düğümleri bulur. -
RETURNadlarını ve soyadlarını gösterir.
Filtreleme ekleme: belirli kişileri bulma
Şimdi belirli özelliklere sahip kişileri bulun. Bu durumda, Alice adlı herkesi bulun ve adlarını ve doğum günlerini gösterin.
MATCH (p:Person)
FILTER p.firstName = 'Alice'
RETURN p.firstName, p.lastName, p.birthday
Bu sorgu aşağıdaki gibi çalışır:
-
MATCHKişi etiketli tüm düğümleri (p) bulur. -
FILTERadı Alice olan düğümler (p). -
RETURNadlarını, soyadını ve doğum gününü gösterir.
Temel sorgu yapısı
Temel GQL sorgularının tümü tutarlı bir desen izler: verileri bulmak, filtrelemek ve döndürmek için birlikte çalışan deyim dizisi.
Çoğu sorgu, grafikte desen bulmakla başlar MATCH ve çıktıyı belirtmek için sona RETURN erer.
İşte birbirini tanıyan ve aynı doğum gününü paylaşan çiftleri bulan basit bir sorgu, ardından bu arkadaş çiftlerinin toplam sayısını döndürüyor.
MATCH (n:Person)-[:knows]-(m:Person)
FILTER n.birthday = m.birthday
RETURN count(*) AS same_age_friends
Bu sorgu aşağıdaki gibi çalışır:
-
MATCHbirbirini bilen tüm düğüm çiftleriniPersonbulur. -
FILTERyalnızca her iki kişinin de doğum gününün aynı olduğu çiftleri tutar. -
RETURNbu tür arkadaş çiftlerinin sayısını sayar.
Tip
Ayrıca bir WHERE madde ekleyerek doğrudan bir desen filtreleyebilirsiniz. Örneğin, MATCH (n:Person WHERE n.birthday < 19900101) sadece Person 1990'dan önceki değere sahip birthday düğümleri eşleştirir.
GQL, C stili // çizgi açıklamalarını, SQL stili -- çizgi açıklamalarını ve C stili /* */ blok açıklamalarını destekler.
Yaygın ifadeler
-
MATCH: Aranan grafik desenini belirler—burada ilgilendiğiniz verinin yapısını tanımlarsınız. -
LET: Eşleşen verilere dayalı yeni değişkenler veya hesaplanan değerler atar—sonuca türetilmiş sütunlar ekler. -
FOR: Bir listeyi satırlara genişletir, isteğe bağlı sıfır tabanlı ofset veya tek tabanlı sıralı pozisyon içerir. -
CALL: Her giriş satırı için bir satır içi alt sorgu çalıştırır ve alt sorgu tarafından döndürülen sütunları ekler. -
FILTER: Koşullar uygulayarak sonuçları daraltır—kriterleri karşılamayan satırları kaldırır. -
ORDER BY: Filtrelenen verileri sıralar—çıktıyı bir veya daha fazla alana göre düzenlemeye yardımcı olur. -
OFFSETveLIMIT: Geri dönen satır sayısını kısıtlayın—sayfa oluşturma veya üst-k sorguları için faydalıdır. -
RETURN: Son çıktıyı belirtir—sonuç kümesine hangi verilerin dahil edilmesini sağlar ve toplama işlemi gerçekleştirir. -
NEXT: Önceki aşamadan dönen sütunları kullanarak başka bir sorgulama aşamasını başlatır.
Deyimler birlikte nasıl çalışır?
GQL ifadeleri bir boru hattı oluşturur ve her ifadenin bir önceki ifadenin çıktısını işler. Bu ardışık yürütme, sorguların kolayca okunmasını ve hata ayıklamasını sağlar çünkü uygulama sırası okuma sırasıyla eşleşir.
Önemli noktalar:
- Cümleler etkili bir şekilde sıralı olarak yürütülür.
- Her ifade veriyi dönüştürür ve bir sonrakine iletir.
- Bu işlem, karmaşık sorguları basitleştiren net, öngörülebilir bir veri akışı oluşturur.
-
NEXTYeni bir sorgulama aşaması başlar. Sadece öncekiRETURNifadede yansıtılan sütunlar bir sonraki aşamada mevcuttur. -
UNION,UNION DISTINCT, veUNION ALLtam sorgu bloklarının sonuçlarını birleştirir.
Uyarı
Cümlelerin tanımlanmış mantıksal bir sırası vardır. Belirli bir fiziksel yürütme stratejisine güvenmek yerine bu veri akışına göre sorgular yaz.
Deyim oluşturma örneği
Aşağıdaki GQL sorgusu, adlarında "Air" olan şirketlerde çalışan ilk 10 kişiyi bulur, onları tam isimlerine göre ayırır ve tam isimleriyle birlikte şirket adlarını geri getirir.
-- Data flows: Match → Let → Filter → Order → Limit → Return
MATCH (p:Person)-[:workAt]->(c:Company)           -- Input: unit table, Output: (p, c) table
LET fullName = p.firstName || ' ' || p.lastName   -- Input: (p, c) table, Output: (p, c, fullName) table
FILTER c.name CONTAINS 'Air'                      -- Input: (p, c, fullName) table, Output: filtered table
ORDER BY fullName                                 -- Input: filtered table, Output: sorted table
LIMIT 10                                          -- Input: sorted table, Output: top 10 rows table
RETURN fullName, c.name AS companyName            -- Input: top 10 rows table
                                                  -- Output: projected (fullName, companyName) result table
Bu sorgu aşağıdaki gibi çalışır:
-
MATCHşirketlerde çalışan insanları bulur. -
LETad ve aile adlarını birleştirerek tam adlar oluşturur. -
FILTERsadece şirket adında "Air" olan şirketlerin çalışanlarını tutar. -
ORDER BYtam ada göre sıralar. -
LIMITilk 10 sonucu alır. -
RETURNtam isimler ve şirket isimleri döndürür.
Değişkenler verilerinizi birbirine bağlar
Önceki örneklerde , pve c gibi fullNamedeğişkenler deyimler arasında veri taşır. Bir değişken adını yeniden kullandığınızda, GQL otomatik olarak aynı verilere başvurduğundan emin olur ve güçlü birleştirme koşulları oluşturur. Değişkenler bazen bağlama değişkenleri olarak da adlandırılır.
Değişkenleri farklı şekillerde kategorilere ayırabilirsiniz:
Bağlama kaynağına göre:
- Desen değişkenleri - eşleşen grafik desenlerine bağlı
- Normal değişkenler - diğer dil yapılarına bağlı
Desen değişkeni türleri:
-
Öğe değişkenleri - grafik öğesi başvuru değerlerine bağlama
- Düğüm değişkenleri - tek tek düğümlere bağlama
- Kenar değişkenleri - tek tek kenarlara bağlama
- Yol değişkenleri - eşleşen yolları temsil eden yol değerlerine bağlama
Başvuru derecelerine göre:
- Tekil değişkenler - desenlerden tek tek öğe başvuru değerlerine bağlama
- Grup değişkenleri - değişken uzunluklu desenlerden eleman referans değerlerinin listelerine bağlanın. Detaylar için bkz. Toplu fonksiyonlar.
Yürütme sonuçları ve sonuçları
Bir sorgu çalıştırdığınızda, aşağıdakilerden oluşan bir yürütme sonucu elde edersiniz:
-
Sonuç, genellikle ifadenizdeki
RETURNverilerin yer aldığı bir sonuç tablosudur. - Sorgunun başarılı olup olmadığını gösteren durum bilgileri.
Sonuç tabloları
Sonuç tablosu (varsa) sorgu yürütmenin gerçek sonucudur.
Sonuç tablosu, sütunlarının adı ve türü, sonuçları görüntülemek için kullanılacak tercih edilen sütun adı dizisi, tablonun sıralı olup olmadığı ve gerçek satırların kendisi hakkında bilgi içerir.
Uyarı
Yürütme başarısız olursa, yürütme sonucuna sonuç tablosu eklenmez.
Atlanmış sonuçlar
GQL ayrıca, veri veya değerlendirme sonucundan bağımsız olarak, satır üretmeyen ifadeler için atılmış bir sonuç tanımlar. Atlanan bir sonuç, başarılı tamamlama durum koduna 00001sahiptir.
Atlanan bir sonuç, boş bir sonuç tablosundan farklıdır. Boş tablo, satır üreten bir sorgu değerlendirilip satır üretmediği anlamına gelir. Sorgu API, çıkarılan bir sonucu sonuç türüyle NOTHINGtemsil edebilir.
Graph, gelecekteki veri tanım dili (DDL) ve veri işleme dili (DML) bildirimi desteği için çıkarılan sonuçları saklar. Mevcut sorgu ifadeleri, boş tablolar dahil olmak üzere tablo sonuçları üretir.
Durum bilgileri
Sorgu yürütme sırasında, işlem hatalar veya uyarılar gibi dikkat çekici çeşitli koşulları algılar. Her koşul, yürütme sonucunun durum bilgilerine bir durum nesnesi tarafından kaydedilir.
Durum bilgileri birincil durum nesnesi ve diğer durum nesnelerinin (muhtemelen boş) bir listesinden oluşur. Birincil durum nesnesi her zaman var olur ve sorgu yürütmenin başarılı mı yoksa başarısız mı olduğunu gösterir.
Her durum nesnesi, beş karakterli alfanumerik bir kod ve kaydedilen durumun açıklamasını içerir.
Sorgu API'si aşağıdaki birincil durum kodlarını kullanır:
| API durum kodu | Meaning |
|---|---|
00000 |
En az bir sıra ile başarılı tamamlama. |
00001 |
Başarıyla tamamlandı, sonuç çıkarıldı. Gelecekteki DDL ve DML desteği için ayrılmıştır. |
01000 |
Bir uyarı veya bilgilendirme durumu. |
02000 |
Şu anda satır üreten sorgudan satır mevcut değildir. |
42000 |
Kullanıcı tarafından düzeltilebilen bir sorgu hatası. |
50000 |
Bir sistem veya sınıflandırılmamış hata. |
API, tanı kaydının üyesinde sorgu motoru _graphaneGqlStatus tarafından bildirilen kanonik GQLSTATUS'u korur. Örneğin, sayısal taşıntı kanonik GQLSTATUS 22003kullanırken, sıfıra 22012bölme ; her ikisi de kamu status.code alanında temsil 42000 edilir.
Önemli
Uygulama kodunda, geniş başarı ve hata yönetimi için kullanılır status.code . Belirli bir sorgu koşununu, ayırt etmek için kanonik GQLSTATUS tanısını kullanın. Açıklama metnini test etmeyin çünkü değişkenlik gösterebilir.
Ayrıca, durum nesneleri temel alınan bir neden durum nesnesi ve kaydedilen koşulu karakterize eden daha fazla bilgi içeren bir tanılama kaydı içerebilir.
Temel kavramlar ve deyimler
Bu bölüm, etkili GQL sorguları yazmak için ihtiyacınız olan temel yapı taşları kapsar. Her kavram pratik sorgu yazma becerilerine yöneliktir.
Grafik desenleri: yapıyı bulun
Bir grafik deseni, eşleşmesi gereken düğümleri, kenarları ve yolları tanımlar. Daha sonraki ifadeler eşleşen öğelere referans vermesi gerektiğinde değişkenleri bağlayın:
MATCH (person:Person)-[employment:workAt]->(company:Company)
RETURN person.firstName, company.name, employment.workFrom
Hangi düğüm veya kenarın desen içinde yer alabileceğini tanımlayan bir önlem satıra yerleştirin:
MATCH (person:Person WHERE person.firstName = 'Alice')
      -[:knows]->(friend:Person)
RETURN friend.firstName, friend.lastName
Bir değişkeni aynı elemanı bağlamak için iki desen pozisyonu gerektirecek şekilde tekrar kullanın.
Daha büyük grafik yapıları oluşturmak için desenleri virgülle ayırın. Bir kenar desenini tekrarlamak ve değişken uzunluktaki yolları eşleştirmek için bir nicelikçi {1,4} kullanın.
Yol modları kontrol elemanının bir yol içinde yeniden kullanımı:
| Yol modu | Davranış |
|---|---|
WALK |
Yinelenen düğümlere ve kenarlara izin verir. Bu mod varsayılandır. |
TRAIL |
Tekrarlayan kenarları önler. |
SIMPLE |
Paylaşılan ilk ve son düğüm dışında tekrarlanan düğümleri engeller. |
ACYCLIC |
Tüm tekrarlanan düğümleri engeller. |
Bir yol arama önekleri, hangi eşleşen yolların döndürüleceğini kontrol eder.
ALL varsayılan değerdir.
ANY SHORTEST Her kaynak-hedef çifti için en kısa bir yol döner:
MATCH path = ANY SHORTEST
  (source:Person WHERE source.id = 123u)-[:knows]->{1,4}(target:Person)
RETURN target.id, path_length(path) AS hopCount
Hat içi önlemler, yol seçiminden önce yol uygunluğunu sınırlar.
Bildirim düzeyinde MATCH ... WHERE ve sonraki FILTER işlemler postfiltrelerdir.
Bu ayrım sonuçları değiştirebilir ANY SHORTEST .
Kesin düğüm, kenar, yol, bileşim, nicelikçi ve önlem yerleştirme semantiği için bakınız: GQL grafik desenleri. Mevcut yol kısıtlamaları için bkz. Mevcut sınırlamalar.
Çekirdek deyimleri
GQL, grafik verilerinizi adım adım işlemek için birlikte çalışan belirli deyim türleri sağlar. Bu deyimleri anlamak, etkili sorgular oluşturmak için gereklidir.
MATCH açıklama
Syntax:
MATCH <graph pattern>, <graph pattern>, ... [ WHERE <predicate> ]
deyimi MATCH giriş verilerini alır ve grafik desenlerini bulur. Giriş değişkenlerini desen değişkenleriyle birleştirir ve tüm eşleşen birleşimleri çıkışlar.
Giriş ve çıkış değişkenleri:
-- Input: unit table (no columns, one row)
-- Pattern variables: p, c
-- Output: table with (p, c) columns for each person-company match
MATCH (p:Person)-[:workAt]->(c:Company)
WHERE kullanarak deyim düzeyi filtreleme:
-- Filter pattern matches
MATCH (p:Person)-[:workAt]->(c:Company) WHERE p.lastName = c.name
kullanarak WHEREtüm eşleşmeleri filtreleyebilirsiniz. Bu yaklaşım ayrı FILTER bir deyimden kaçınıyor. Yol arama öneki gibi ANY SHORTESTbir ile, ifade seviyesi WHERE yol seçiminden sonra uygulanır. Çizgi içi predikatlar ise hangi yolların seçilebileceğini sınırlar. Daha fazla bilgi için, yol seçiminden önceki veya sonra olan Place predicates'e bakınız.
Giriş değişkenlerini kullanarak birleştirme:
MATCH İlk deyim olmadığında, giriş verilerini desen eşleşmeleriyle birleştirir:
...
-- Input: table with 'targetCompany' column
-- Implicit join: targetCompany (equality join)
-- Output: table with (targetCompany, p, r) columns
MATCH (p:Person)-[r:workAt]->(targetCompany)
Önemli
Grafik, temel ve tam doğrusal ifade bileşimini destekler, bunlar arasında NEXT. Ayrıca sorgu bloklarını UNION, UNION DISTINCT, ve UNION ALLile birleştirebilirsiniz.
EXCEPT, INTERSECT, ve OTHERWISE set işlemleri henüz desteklenmemektedir. Daha fazla bilgi için geçerli sınırlamalarla ilgili makaleye bakın.
Anahtar birleştirme davranışları:
Veri birleştirmeyi nasıl MATCH işler:
- Değişken eşitliği: Giriş değişkenleri, eşitlik eşleştirmesi kullanarak desen değişkenleriyle birleşir
-
İç birleşim: Desen eşleşmeleri olmayan giriş satırları atılır. Sol dış birleşim davranışı için kullanın
OPTIONAL MATCH. -
Filtreleme sırası: Desen eşleştirmesi ve yol seçimi tamamlandıktan sonra ifade düzeyindeki
WHEREfiltreler - Desen bileşimi: Paylaşılan değişkenler desenleri aynı elemanla sınırlar. Bağlantısız desenler bir Kartezyen ürün oluşturur.
Önemli
Bağlantısız bir desen geçerli, ancak onun Kartezyen çarpımı birçok satır oluşturabilir. Desenler aynı grafik elemanlarına atıfta bulunması gerekirken paylaşılan değişkenler kullanın.
Paylaşılan değişkenlerle desenleri birleştirin:
-- Shared variable 'p' joins the two patterns
-- Output: people with both workplace and residence data
MATCH (p:Person)-[:workAt]->(c:Company),
      (p)-[:isLocatedIn]->(city:City)
OPTIONAL MATCH açıklama
Syntax:
OPTIONAL MATCH <graph pattern> [ WHERE <predicate> ]
OPTIONAL MATCH gibi MATCH çalışır ancak sol dış birleşim semantiği kullanır. Desen bir giriş satırı için eşleşme bulursa, sorgu satırı atmak yerine eşleşmeyen değişkenlerin değerleriyle NULL korur.
Example:
-- Find all people and, if available, their workplace
MATCH (p:Person)
OPTIONAL MATCH (p)-[:workAt]->(c:Company)
RETURN p.firstName, p.lastName, c.name AS company_name
Herhangi bir şirkette çalışmayan kişiler, için NULLile company_name sonuçlarda görünmeye devam ediyor.
Tip
SQL'e OPTIONAL MATCHbenzer şekilde belirli bir ilişkisi olmayan varlıkları eklemek istediğinizde kullanınLEFT JOIN.
LET açıklama
Syntax:
LET <variable> = <expression>, <variable> = <expression>, ...
deyimi LET hesaplanan değişkenler oluşturur ve sorgu işlem hattınızda veri dönüştürmeyi etkinleştirir.
Temel değişken oluşturma:
MATCH (p:Person)
LET fullName = p.firstName || ' ' || p.lastName
RETURN *
LIMIT 1000
Karmaşık hesaplamalar:
MATCH (p:Person)
LET adjustedAge = 2000 - (p.birthday / 10000),
    fullProfile = p.firstName || ' ' || p.lastName || ' (' || p.gender || ')'
RETURN *
LIMIT 1000
Önemli davranışlar:
- Sorgu altyapısı her giriş satırı için ifadeleri değerlendirir.
- Sonuçlar çıkış tablosunda yeni sütunlara dönüşür.
- Değişkenler yalnızca önceki deyimlerdeki mevcut değişkenlere başvurabilir.
- Bir
LETifadedeki birden fazla atama, aynı giriş kapsamını kullanır, bu yüzden bir atama o ifadeden başka bir atamaya referans veremez.
FOR açıklama
Syntax:
FOR <variable> IN <list_expression>
  [ WITH OFFSET <offset_variable> | WITH ORDINALITY <ordinality_variable> ]
Bu ifade FOR bir listeyi satırlara genişletir. Her giriş satırı için, her liste öğesi için bir çıkış satırı yayar ve bu elemanı belirtilen değişkene bağlar. Giriş satırından diğer değişkenler de kullanılabilir durumda.
WITH OFFSET Sıfır tabanlı bir indeks bağlamak için veya tek tabanlı bir pozisyonu bağlamak için kullanılırWITH ORDINALITY.
LET cities = ['Seattle', 'London', 'Tokyo']
FOR city IN cities WITH ORDINALITY position
RETURN city, position
Bu sorgu, her şehir için bir satır döndürür. Değerler position1, 2, ve 3. Eğer yerine WITH ORDINALITY positionWITH OFFSET position, ile değiştirirseniz, değerler 0, 1, ve 2.
Kaynak ifadesi bir listeye göre değerlendirilmelidir. Liste dışı bir değer sorgunun başarısız olmasına neden olur.
CALL açıklama
Her giriş satırı için bir alt sorgu çalıştırmak için kullanılır CALL :
CALL {
  <query statements>
  RETURN <columns>
}
Zaten kapsamda olan değişkenler alt sorgu içinde örtük olarak mevcuttur. Alt sorgu içinde oluşturulan değişkenler arasında, yalnızca son RETURN iyiminden sütunlar dışarıda kullanılabilir hale gelir. Alt sorgu içinde oluşturulan ancak geri dönmeyen değişkenler yerel olarak kalır.
Aşağıdaki ilişkili alt sorgu, her kişi için bir işveren sayısını hesaplar:
MATCH (p:Person)
CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN count(*) AS employerCount
}
RETURN p.firstName, p.lastName, employerCount
ORDER BY employerCount DESC
Sıradan CALL , bağımlı bir iç birleşim gibi davranır. Alt sorgu tarafından döndürülen her satır için bir çıktı satırı üretir. Alt sorgu satır döndürmezse, karşılık gelen dış satır döner. Birden fazla satır dönerse, dış satır her alt sorgu satırı için bir kez görünür.
Önceki count(*) örnek, gruplanmamış bir toplu kullandığı için her zaman bir alt sorgu satırı döndürür. Eşleşen işveren olmayan bir kişinin bu nedenle bir employerCount ' 0numarası vardır.
Bağımlı sol birleşim olarak kullanın OPTIONAL CALL . Alt sorgu satır döndürmediğinde, bir dış satırı korur ve döndürülen alt sorgu sütunlarını 'ye ayarlar NULL. Alt sorgu birden fazla satır döndürdüğünde, her alt sorgu satırı için bir çıktı satırı üretir.
MATCH (p:Person)
OPTIONAL CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN company.name AS companyName
}
RETURN p.firstName, p.lastName, companyName
Alt sorguları CALL iç içe koyabilirsiniz. İç içe bir alt sorgu, içindeki sorgu kapsamlarından değişkenlere referans verebilir.
Önemli
Her inline CALL gövdeyi ile sonlandırın RETURN. Graph, isimli prosedür çağrılarını veya örneğin CALL (p) { ... }açık değişken içe aktarma listelerini desteklemez.
FILTER açıklama
Syntax:
FILTER [ WHERE ] <predicate>
deyimi, FILTER sorgu işlem hattınızda hangi verilerin devam ettiği üzerinde hassas denetim sağlar.
Temel filtreleme:
MATCH (p:Person)
FILTER p.birthday < 19980101 AND p.gender = 'female'
RETURN *
Karmaşık mantıksal koşullar:
MATCH (p:Person)
FILTER (p.gender = 'male' AND p.birthday < 19940101)
  OR (p.gender = 'female' AND p.birthday < 19990101)
  OR p.browserUsed = 'Edge'
RETURN *
Null kullanan filtreleme desenleri:
Null değerleri güvenli bir şekilde işlemek için şu desenleri kullanın:
-
Değerleri denetleyin:
p.firstName IS NOT NULL- bir ad var -
Verileri doğrulama:
p.id > 0- geçerli kimlik -
Eksik verileri işleme:
NOT coalesce(p.locationIP, '10.x.x.x') STARTS WITH '10.x.x.x'- yerel ağdan bağlanmadı -
Koşulları birleştirme: Karmaşık mantık için açık null denetimlerle kullanma
AND/OR
Dikkat
Null değerler içeren koşulların, bu satırları filtreleyen değerini döndürdüğünü UNKNOWNunutmayın. Null-kapsayıcı mantığa ihtiyacınız olduğunda açık IS NULL denetimler kullanın.
ORDER BY açıklama
Syntax:
ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ],
         <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ...
Hesaplanan ifadelerle çok düzeyli sıralama:
MATCH (p:Person)
RETURN *
ORDER BY p.firstName DESC,               -- Primary: by first name (Z-A)
         p.birthday ASC,                 -- Secondary: by age (oldest first)
         p.id DESC                       -- Tertiary: by ID (highest first)
Sıralamada null işleme:
MATCH (p:Person)
RETURN p.firstName, p.birthday
ORDER BY p.birthday DESC NULLS LAST, p.firstName ASC
Sıralama davranışı ayrıntıları:
Nasıl ORDER BY çalıştığını anlama:
- Sorgu altyapısı her satır için ifadeleri değerlendirir, ardından sonuçlar satır sırasını belirler.
- Birden çok sıralama anahtarı hiyerarşik sıralama (birincil, ikincil, üçüncül vb.) oluşturur.
-
NULLS FIRSTnull değerleri sıfır olmayan değerlerin önüne koyar.NULLS LASTonları sıfır olmayan değerlerin ardınca yerleştirir. - Null yerleştirme sıralama yönünden bağımsızdır. Eğer null sıralamasını belirtmiyorsanız,
NULLS LASThemASCde her ikisi için varsayılan olarak mı .DESC -
ASC(artan) varsayılan düzendir ve açıkça belirtmenizDESCgerekir (azalan). - Yalnızca depolanan özelliklere göre değil, hesaplanan değerlere göre sıralayabilirsiniz.
| Sıralama spesifikasyonu | Ortaya çıkan emir |
|---|---|
ASC veya ASC NULLS LAST |
Sıfır olmayan değerler artan sırayla gelir, ardından null değerler gelir. |
ASC NULLS FIRST |
Null değerler, ardından artan sırayla sıfır olmayan değerler. |
DESC veya DESC NULLS LAST |
Sıfır olmayan değerler azalan sırayla, ardından null değerler. |
DESC NULLS FIRST |
Null değerler, ardından azalan sırayla sıfır olmayan değerler. |
Dikkat
Yalnızca aşağıdaki deyim, oluşturulan sıralama düzenini ORDER BY görebilir.
Bu nedenle, ORDER BY ardından RETURN * gelen sıralı bir sonuç üretmez.
Karşılaştırmak:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
ORDER BY r.creationDate DESC
/* intermediary result _IS_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
/* final result _IS_ _NOT_ guaranteed to be ordered here  */
ile:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
/* intermediary result _IS_ _NOT_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
ORDER BY r.creationDate DESC
/* final result _IS_ guaranteed to be ordered here              */
Bu farkın "Top-k" sorguları için hemen sonuçları vardır: LIMIT her zaman hedeflenen sıralama düzenini oluşturan deyimi izlemelidir ORDER BY .
OFFSET ve LIMIT deyimleri
Syntax:
  OFFSET <offset> [ LIMIT <limit> ]
| LIMIT <limit>
Yaygın düzenler:
-- Basic top-N query
MATCH (p:Person)
RETURN *
ORDER BY p.id DESC
LIMIT 10                                 -- Top 10 by ID
Önemli
Tahmin edilebilir sayfalandırma sonuçları için her zaman sorgular arasında tutarlı satır sıralaması sağlamak için önce ORDER BY ve OFFSET kullanınLIMIT.
RETURN: temel sonuç projeksiyonu
Syntax:
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
[ ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
deyimi, RETURN sonuç tablosunda hangi verilerin görüneceğini belirterek sorgunuzun son çıkışını oluşturur.
Temel çıkış:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday,
       c.name
Netlik için diğer adları kullanma:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS first_name,
       p.lastName AS last_name,
       c.name AS company_name
Sıralama ve üst k ile birleştirin:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday AS birth_year,
       c.name AS company
ORDER BY birth_year ASC
LIMIT 10
DISTINCT kullanarak yinelenen işleme:
-- Remove duplicate combinations
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN DISTINCT p.gender, p.browserUsed, p.birthday AS birth_year
ORDER BY p.gender, p.browserUsed, birth_year
Toplama ile birleştir:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN count(DISTINCT p) AS employee_count
RETURN ile GROUP BY: gruplandırılmış sonuç projeksiyonu
Syntax:
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
GROUP BY <variable>, <variable>, ...
[ ORDER BY <expression> [ ASC | DESC ], <expression> [ ASC | DESC ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
Satırları paylaşılan değerlere ve her grup içindeki işlem toplama işlevlerine göre gruplandırmak için kullanın GROUP BY .
Toplama ile temel gruplandırma:
MATCH (p:Person)-[:workAt]->(c:Company)
LET companyId = c.id, companyName = c.name
RETURN companyId,
       companyName,
       count(*) AS employeeCount,
       avg(p.birthday) AS avg_birth_year
GROUP BY companyId, companyName
ORDER BY employeeCount DESC
Çok sütunlu gruplandırma:
MATCH (p:Person)
LET gender = p.gender
LET browser = p.browserUsed
RETURN gender,
       browser,
       count(*) AS person_count,
       avg(p.birthday) AS avg_birth_year,
       min(p.creationDate) AS first_joined,
       max(p.id) AS highest_id
GROUP BY gender, browser
ORDER BY avg_birth_year DESC
LIMIT 10
Uyarı
Değişken uzunluklu desenler üzerinde yatay toplama için bkz. Toplu fonksiyonlar.
Değerler ve değer türleri
GQL değerleri Boolean, string, sayısal, zamansal, liste, düğüm, kenar, yol, null ve hiçbir şey değerlerini içerir. Türler geçersiz olur, ancak belirtirseniz NOT NULL.
Özellikler, tam sorgu değer sisteminin desteklenen bir alt kümesini kullanır.
RETURN 42 AS integerValue,
       'Alice' AS stringValue,
       TRUE AS booleanValue,
       [1, 2, 3] AS listValue
Null ile karşılaştırmalar ; UNKNOWNnull testleri için kullanılır IS NULL ve IS NOT NULL değerlendirilir. Sayısal işlemler, uyumlu sayısal tipler arasında örtük dönüşümler uygulayabilir.
Uyarı
Her GQL değer tipi her Graph bağlamında desteklenmez. Mevcut özellik ve sorgu kısıtlamaları için bkz. Veri türleri.
Literal sözdizimi, karşılaştırma davranışı, tür dönüşümleri ve tip hiyerarşisi için bakınız: GQL değerleri ve değer tipleri.
Expressions
İfadeler değerleri hesaplar, karşılaştırır, birleştirir ve dönüştürür. Yaygın biçimler arasında özellik referansları, aritmetik ve mantıksal operatörler, önlemler, fonksiyon çağrıları, basit CASE ifadeler ve alt sorgular bulunur:
MATCH (person:Person)
FILTER person.birthday < 19900101
RETURN person.firstName,
       CASE person.gender
         WHEN 'female' THEN 'F'
         WHEN 'male' THEN 'M'
         ELSE 'Other'
       END AS genderCode
GQL üç değerli mantık kullanır: Boolean ifadeleri , TRUEFALSE, veya UNKNOWN. A, FILTER yalnızca önlemi olan TRUEsatırlar korur.
, SUM, AVG, MIN, gibi toplu fonksiyonlar COUNTve MAX satırları özetler. GibiALL, ANYNONEgibi önlemleri listeleyin ve SINGLE bir önlemi liste elemanları için değerlendirin. Prosedür formu EXISTS alt sorguları, iç içe bir sorgunun satır döndürüp dönmediğini test eder.
Tam operatör, önlem, agregat ve fonksiyon davranışı için bakınız: GQL ifadeleri, önlemler ve fonksiyonlar. Görev odaklı filtreleme ve gruplama örnekleri için bkz. Filtre ve grafik verilerini topla.
Gelişmiş sorgu teknikleri
Bu bölümde karmaşık ve verimli graf sorguları oluşturmaya yönelik gelişmiş desenler ve teknikler yer almaktadır. Bu desenler, güçlü analiz sorguları oluşturmanıza yardımcı olmak için temel deyim kullanımının ötesine geçer.
Karmaşık çok durumlu oluşturma
Önemli
Graph temel ve tam doğrusal deyim bileşimini destekler.
EXCEPT, INTERSECT, ve OTHERWISE set işlemleri henüz desteklenmemektedir. Daha fazla bilgi için geçerli sınırlamalarla ilgili makaleye bakın.
Karmaşık sorguları verimli bir şekilde oluşturmanın anlaşılması, gelişmiş graf sorgulaması için çok önemlidir.
UNION ve UNION ALL
UNIONİki veya daha fazla doğrusal sorgu bloğundan elde edilen sonuçları birleştirmek için , UNION DISTINCT, veya UNION ALL kullanın:
<query block>
UNION [ DISTINCT | ALL ]
<query block>
-- Combine results from two separate pattern matches
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS name, c.name AS affiliation
UNION DISTINCT
MATCH (p:Person)-[:studyAt]->(u:University)
RETURN p.firstName AS name, u.name AS affiliation
Çıplak UNION , eşdeğerdir UNION DISTINCT; her ikisi de tekrarlanan satırları kaldırır.
UNION ALL yinelenenler de dahil olmak üzere tüm satırları tutar.
Her sorgu bloğu aynı sütun adları setini döndürmelidir. Sütun sırası bloklar arasında farklılık gösterebilir ve veri türleri uyumlu olmalıdır.
NEXT
Önceki aşamada geri dönen tabloya karşı başka bir sorgu aşamasını çalıştırmak için kullanılır NEXT :
<query stage>
RETURN <columns>
NEXT
<query stage>
Aşağıdaki sorgu, çalışanları ve şirketlerini bulur, ardından geri dönen çalışan düğümlerini başka bir desen eşleşmesinde kullanır:
MATCH (person:Person)-[:workAt]->(company:Company)
RETURN person, company.name AS companyName
NEXT
MATCH (person)-[:isLocatedIn]->(city:City)
RETURN person.firstName AS employee, companyName, city.name AS city
Yalnızca önceki aşamadan geri dönen sütunlar kapsam alanındadır NEXT. Daha uzun bir sorgu aşaması dizisi oluşturmak için birden fazla NEXT ayırıcıyı kullanabilirsiniz.
Her iki aşamada da sorgu bloklarının birleşimi olabilir. Bir birlik, aşamanın çıkışı NEXT sınırı geçmeden önce aşaması içinde değerlendirilir. Eğer A, , ve C sorgu bloklarını temsil eder, A UNION B NEXT C gruplar olarak (A UNION B) NEXT C, gruplar A NEXT B UNION C ise .A NEXT (B UNION C)B
Koşullu deyimler
Her gelen satırı şu şekilde TRUEdeğerlendiren ilk dala yönlendirmek için koşullu bir ifade kullanın:
WHEN <predicate> THEN <linear query statement or { query statements }>
[ WHEN <predicate> THEN <linear query statement or { query statements }> ... ]
[ ELSE <linear query statement or { query statements }> ]
Önceki sorgu aşamasından satır yönlendirmek için gerekli sütunları döndürün ve koşullu ifadeden önce kullanın NEXT :
MATCH (p:Person)
RETURN p.firstName AS name, p.birthday AS birthday
NEXT
WHEN birthday < 19800101u THEN
  RETURN name, 'Before 1980' AS era
WHEN birthday < 20000101u THEN
  RETURN name, '1980-1999' AS era
ELSE
  RETURN name, '2000 or later' AS era
Her WHEN önlem Boolean olmalıdır. Sorgu motoru, her giriş satırı için önlemleri sırayla değerlendirir. Dalını değerlendiren veya UNKNOWN seçmeyen bir yüklemFALSE. Bir predikat değer TRUEverdikten sonra, sonraki önlemler ve seçilmemiş dal gövdeleri değerlendirilmez. Eğer hiçbir önlem değer almazsa TRUE ve yoksa ELSE, giriş satırı geri dönmez.
Önlemler ve dal gövdeleri, önceki aşamadan gelen sütunlara referans verebilir. Bir dal, tek bir doğrusal ifade olabilir veya destekçilere çevrilmiş iç içe işlem olabilir. Bir dalın birden fazla aşama veya ifadeye ihtiyaç duyduğunda, örneğin CALLaşağıdaki gibi iç içe işlemini kullanın:
MATCH (p:Person)
RETURN p, p.firstName AS name
NEXT
WHEN p.gender = 'female' THEN {
  CALL {
    MATCH (p)-[:knows]->(friend:Person)
    RETURN count(*) AS friendCount
  }
  RETURN name, friendCount
}
ELSE
  RETURN name, 0u AS friendCount
Her şube kendi yerel kapsamı vardır. Kardeş dallar başka bir dal tarafından oluşturulan değişkenleri görmez ve sadece seçilen dalın son RETURN sütunları koşullu ifadeden sonra devam eder. Her dal aynı sütun adlarını döndürmeli ve ilgili sonuç türleri uyumlu olmalıdır. Sorgu motoru, uyumlu tipleri ortak bir çıkış tipine yönlendirir. Döndürülen bir dal sütunu, gelen sütunla aynı adı kullanabilir; dal değeri, koşullu çıktıda gelen değerin yerini alır.
Koşullu ifadeler ifadelerden CASE farklıdır. Grafik basit CASE <expression> WHEN <value>ifadeleri destekler, ancak aranan CASE WHEN <predicate> ifadeleri desteklemez. Daha fazla bilgi için bkz. Koşullu ifadeler.
Değişken kapsamı ve gelişmiş akış denetimi
Değişkenler verileri sorgu deyimleri arasında bağlar ve karmaşık graf geçişlerini etkinleştirir. Gelişmiş kapsam kurallarını anlamak, karmaşık çok deyimli sorgular yazmanıza yardımcı olur.
Değişken bağlama ve kapsam desenleri
-- Variables flow forward through subsequent statements
MATCH (p:Person)                                    -- Bind p
LET fullName = p.firstName || ' ' || p.lastName     -- Bind concatenation of p.firstName and p.lastName as fullName
FILTER fullName CONTAINS 'Smith'                    -- Filter for fullNames with “Smith” substring (p is still bound)
RETURN p.id, fullName                               -- Only return p.id and fullName (p is dropped from scope)
Deyimler arasında birleşimler için değişken yeniden kullanımı
-- Multi-statement joins using variable reuse
MATCH (p:Person)-[:workAt]->(:Company)          -- Find people with jobs
MATCH (p)-[:isLocatedIn]->(:City)               -- Same p: people with both job and residence
MATCH (p)-[:knows]->(friend:Person)             -- Same p: their social connections
RETURN *
Kritik kapsam kuralları ve sınırlamaları
-- ✅ Backward references work
MATCH (p:Person)
LET adult = p.birthday < 20061231  -- Can reference p from previous statement
RETURN *

-- ❌ Forward references don't work
LET adult = p.birthday < 20061231  -- Error: p not yet defined
MATCH (p:Person)
RETURN *

-- ❌ Variables in same LET statement can't reference each other
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName,
    greeting = 'Hello, ' || name     -- Error: name not visible yet
RETURN *

-- ✅ Use separate statements for dependent variables
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName
LET greeting = 'Hello, ' || name     -- Works: name now available
RETURN *
Karmaşık sorgularda değişken görünürlüğü
-- Variables remain visible until overridden or query ends
MATCH (p:Person)                     -- p available from here
LET gender = p.gender                -- gender available from here
MATCH (p)-[:knows]->(e:Person)       -- p still refers to original person
                                     -- e is a new variable for the friend
RETURN p.firstName AS manager, e.firstName AS friend, gender
Dikkat
Grafik desenleri dışında, aynı deyimdeki değişkenler birbirine başvuramaz. Bağımlı değişken oluşturmak için ayrı deyimler kullanın.
Toplu satırlar ve yol elemanları
GQL iki toplama bağlamını destekler:
-
Dikey toplama , giriş satırlarını özetler, isteğe bağlı olarak değişkenlere
GROUP BYgöre bölünür. - Yatay toplama , eşleşen bir yol içinde değişken uzunlukta bir kenar deseniyle sınırlanmış bir grup listesini özetler.
MATCH (person:Person)-[:workAt]->(company:Company)
LET companyId = company.id, companyName = company.name
RETURN companyId, companyName, count(*) AS employeeCount
GROUP BY companyId, companyName
MATCH (:Person)-[connections:knows]->{1,4}(:Person)
RETURN count(connections) AS pathLength
Gruplanmış sorgular, toplu filtreler, koleksiyon agregaları ve koşullu yönlendirme için bkz. Filtre ve toplu grafik verileri. Tam toplu sonuç kuralları için bkz. Aggregate functions.
Null ve sorgu hatalarını ele alın
Eksik değerler farklı bir şekilde işleme gerektirdiğinde açık null testler kullanın:
MATCH (person:Person)
FILTER person.browserUsed IS NULL
RETURN person.firstName
Null UNKNOWNile karşılaştırma , FILTER a'nın tutmadığı değer verir.
Yedekleme değeri gerektiğinde kullanın coalesce() .
Sorgu sonuçları başarı durum bilgileri, uyarılar, veri yokluğu koşulları, kullanıcı düzeltilebilir hatalar ve sistem hatalarını içerir. Geniş kontrol akışı için kamu durum kodunu ve belirli bir durum için kanonik GQLSTATUS tanısını kullanın. Yürütme sonuçları ve sonuçları ile GQL durum kodları referansına bakınız.
Ayrılmış sözcükler
GQL, değişkenler, özellik adları veya etiket adları gibi tanımlayıcılar olarak kullanamamanıza neden olan bazı anahtar sözcükleri ayırır. Listenin tamamı için GQL ayrılmış sözcükler başvurusuna bakın.
Tanımlayıcı olarak ayrılmış sözcükler kullanmanız gerekiyorsa, bunların arka uçlarıyla kaçış yapın: `match`, `return`.
Ayrılmış sözcüklerin kaçmasını önlemek için şu adlandırma kuralını kullanın:
- Tek sözcüklü tanımlayıcılar için alt çizgi ekleyin:
:Product_ - Çok sözcüklü tanımlayıcılar için camelCase veya PascalCase kullanın:
:MyEntity,:hasAttribute,textColor
Sonraki Adımlar
- Pratik bir giriş için hızlı başlangıç veya GQL eğitimini takip edin.
- Hazır grafik görevleri için Yaygın GQL sorgularını yaz .
- Ayrıntılı referans için GQL grafik desenlerini, GQL ifadelerini, önlemleri ve fonksiyonlarını, ayrıca GQL değerlerini ve değer tiplerini kullanın.
- Desteklenen Fabric modelleme iş akışı için bir grafik şeması tasarlayın.