Fabric 資料代理使組織能利用生成式 AI 建立對話系統。 透過將 Power BI 語意模型作為資料來源,團隊可以提出自然語言問題,並獲得準確且具豐富情境的答案,而無需撰寫複雜的 DAX 或 SQL 查詢。
然而,AI 回應的品質很大程度上取決於你準備資料來源的程度。 雖然 Fabric 資料代理支援多種資料來源類型,包括湖屋、倉庫、事件屋和本體,但本指南特別聚焦於 Power BI 語意模型,並帶你一步步介紹如何配置這些模型以最大化準確性與相關性。
網狀架構資料代理程式的運作方式
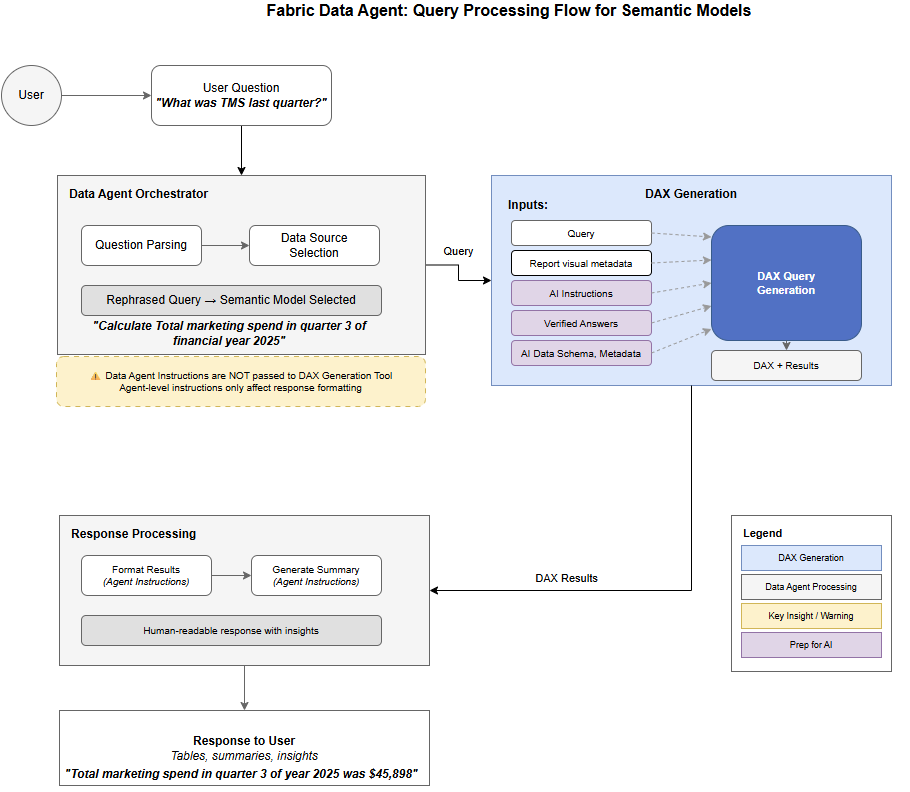
資料代理採用分層架構,使用者問題透過 Orchestrator 流動。 Orchestrator 會決定適當的資料來源,並調用專門工具,包括用於 Power BI 語意模型的 DAX 產生工具,以產生、驗證及執行查詢。
查詢處理流程
問題解析: 代理透過 Azure OpenAI 處理用戶問題,確保遵守安全規範與權限,並遵守 Microsoft 負責任 AI 原則。
資料來源選擇: 系統會根據你提供的結構資訊和 AI 指令,根據可用來源來評估問題。
查詢產生: 對於語意模型,DAX 產生工具會根據結構、元資料(同義詞、數值欄位的最小值與最大值、報告視覺化元資料等)、在 Prep for AI 資料中設定的上下文,以及對話歷史產生 DAX 查詢。
回應格式: 代理人會根據代理人指令,將結果格式化為可讀的回應,包含表格、摘要或洞察。
進階 DAX 生成(預覽)
預覽執行時可提供進階的 DAX 產生工具,供資料代理使用。 與標準 DAX 生成一次產生查詢不同,進階 DAX 生成利用多重推理步驟檢查模型元資料、解讀問題、解決歧義,並產生 DAX 查詢。
進階 DAX 生成的優點包括:
- 對複雜問題更準確的回答: 它以迭代推理、檢視結果、解決歧義,並在多個步驟中精進方法。
- 實例值索引: 它會在語意模型欄位中搜尋值,以產生更準確且可靠的篩選條件。
- Microsoft 體驗中的一致回應:它利用共享功能提升 Fabric 資料代理、Fabric 技能、Power BI、Microsoft 365 Copilot 及 Fabric IQ 外掛間的回應一致性。
- 某些情境下的延遲改善: 雖然該工具能執行多個推理步驟,但其更有效率地識別相關模型物件與值的能力,能降低部分問題的回應延遲。
使用進階 DAX 生成
要啟用此功能,請將資料代理切換到 預覽執行時。
進階 DAX 生成使用本文所述的語意模型元資料及 Prep for AI 配置。 請遵循本文所述的最佳實務,以最大化回應的準確度與效能。
實例值索引目前需要啟用語意模型的 Q&A 設定 。 此設定預設為 Import 與 Direct Lake 模型啟用。 由於 Q&A 將於 2026 年 12 月退休,替換設定將在退休後支援實例值索引,本文將更新新的設定步驟。
為 AI 做準備:讓語意模型 AI 準備好
Power BI 的 Prep for AI 功能提供三個設定元件,直接影響 Fabric 資料代理如何解讀你的語意模型。 你可以在 Power BI Desktop 和 Power BI 服務中存取這些元件。 Power BI Copilot 也使用 Prep 來設定 AI,因此投入時間設定這些設定對 Copilot 和資料代理的回應都有利。
這很重要
在查詢語意模型時,資料代理所使用的 DAX 生成工具僅依賴語意模型的元資料及 AI 配置準備。 DAX 產生工具會忽略你在資料代理層級新增的任何 DAX 查詢產生指令。 正確準備 AI 配置對準確結果至關重要。
AI 資料結構
AI 資料結構讓你能定義模型中一個重點子集,以便 AI 優先排序。 雖然資料代理在新增語意模型作為資料來源時也有自己的表格選擇,但請先在 Prep for AI 中設定你的架構。 DAX 產生工具使用此架構來建立 DAX 查詢。
你可以在 Power BI Desktop 或 Power BI 服務中,從 Home 功能區選擇「準備 AI 資料」來設定這個架構。 接著,導向 「簡化資料結構 」標籤。接著,選擇 AI 在產生回應時應該使用的表格、欄位和指標。 詳細設定說明請參閱 「設定 AI 資料結構」。
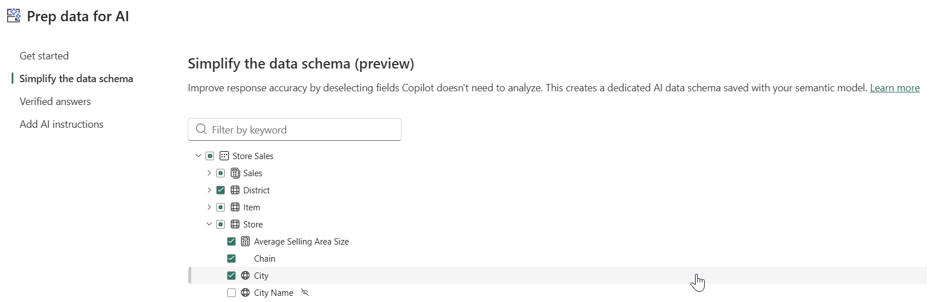
當你將語意模型加入資料代理時,請選擇你在 Prep for AI 中定義的相同資料表,以確保行為一致。 首先,定義你的資料代理的範圍(它應該回答哪些類型的問題)。 然後,只選擇相關的物件。 此方法減少歧義、提升準確度並降低響應延遲。
DAX 產生工具依賴模型的元資料來解讀問題。 使用清晰且商業友善的名稱來命名表格、欄位和衡量指標,反映使用者自然對資料的稱呼方式。 例如,使用「總營收」取代「TR_AMT」或「銷售區域」取代「DIM_GEO_01」。 此指引對於有重疊或相似名稱欄位的大型模型尤其重要,因為名稱模糊可能導致查詢產生錯誤。
範例:解決欄位歧義問題
| 沒有 AI 資料架構 | 搭配 AI 資料架構 |
|---|---|
有使用者提問: "What were our sales last quarter?" 語意模型包含多個與銷售相關的指標:總營收、總銷售、淨銷售以及退貨後銷售。 AI 會回報總銷售額,但你的團隊通常會用淨銷售來做季度報告。 |
在將 AI 資料架構設定為只包含淨銷售額並排除其他不相關的指標後,同樣的問題現在會回傳預期的指標。 AI 不再需要猜測使用者意圖的「銷售」指標。 |
AI 資料結構的建議
為了獲得一致且準確的結果,請確保你在 Fabric 資料代理中選擇的表格,也是透過 AI 準備過程中的 AI 資料結構定義的。
選擇結構時,也包含相依物件。 例如,如果一個總收入指標引用了另外兩個依賴額外欄位的指標,則在結構中包含所有這些相依物件。 要識別相依性,請使用 Semantic Link Labs 函式庫中的 get_measure_dependencies 函式。
如果你的語意模型很大,手動重新命名所有物件可能會很繁瑣。 使用 Power BI 建模 MCP 伺服器 ,讓大型語言模型(LLM)為你的資料表、欄位和度量產生商業友善的名稱。 儲存前請檢視並驗證變更,確保不會破壞任何 DAX 表達式、關聯或其他相依物件。
已驗證的答案
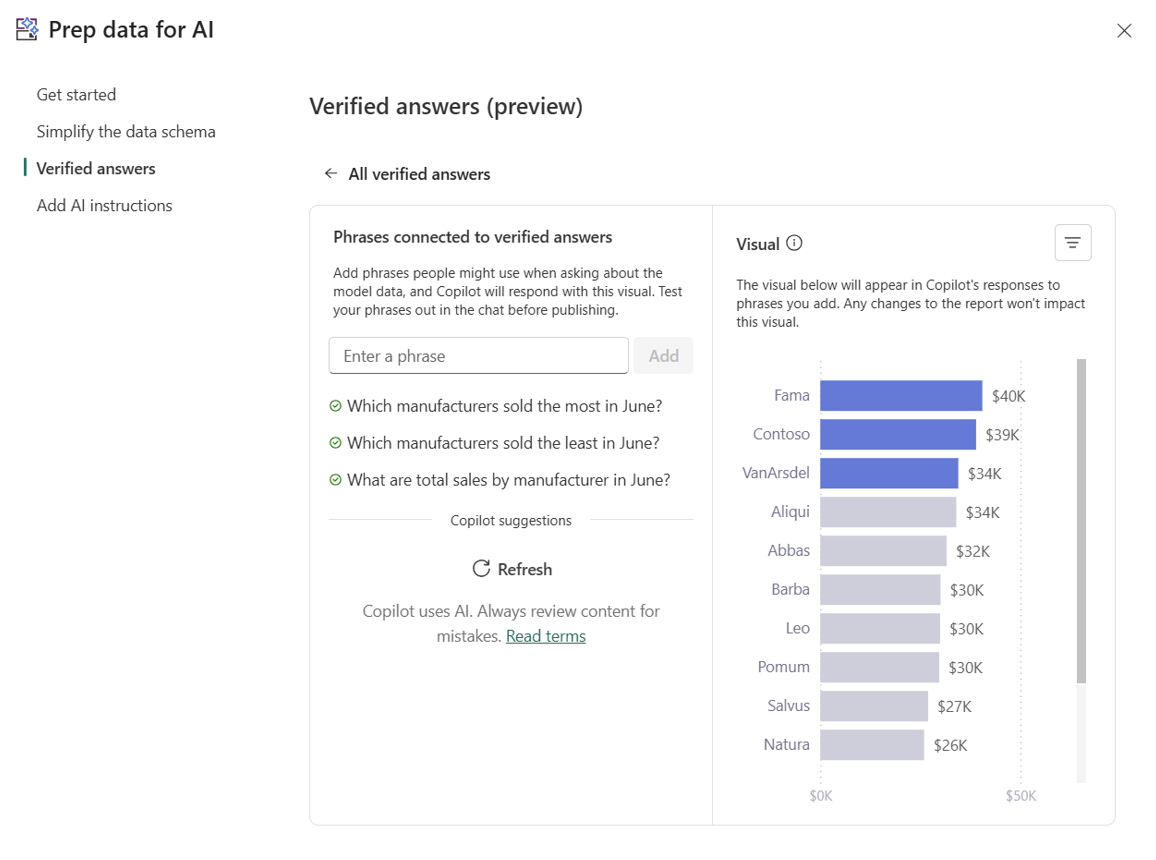
驗證答案是用戶核准的視覺回應,由特定問題觸發。 它們能對常見或複雜問題提供一致且可靠的回應,避免被誤解。 因為你是在語意模型層級(而非報告層級)儲存已驗證的答案,因此它們能跨越任何使用相同模型的資料代理。 欲了解更多資訊,請參閱 「為 AI 準備資料 – 驗證答案」。
當你使用 data agent 的驗證答案時,系統不會返回 Power BI 的圖像視覺化。 它利用使用者問題與視覺化的屬性(欄位、量值、篩選器)來影響 DAX 查詢產生。 此方法意味著經過驗證的答案能提升回應準確度,引導 DAX 產生工具朝向正確的查詢結構。 當使用者向資料代理提問時,系統會先檢查與已驗證答案中定義的提示完全一致或語義相似,然後再產生新的回應。
範例:處理區域術語
| 沒有經過驗證的答案 | 已驗證答案 |
|---|---|
有使用者問: "Show me performance by territory" AI 將「區域」解讀為產品類別,因為產品表中有一個區域欄位。 使用者其實是指銷售區域。 |
你用區域銷售視覺化來建立經過驗證的答案,並觸發問題如 "What is the sales performance by territory?"「顯示按區域劃分的銷售額」和「銷售如何分布於各區域?」等。現在當用戶詢問區域績效時,他們能根據區域銷售視覺化中使用的物件,獲得準確的回答。 |
驗證答案的設定提示
- 每個經過驗證的答案使用五到七個觸發問題,以涵蓋自然變化。
- 包括使用者可能會嘗試的正式與日常對話用語。
- 可設定最多三個篩選器,方便靈活切片,無需產生多個已驗證答案。
- 如果你更改已驗證答案中提及的任何表格、欄位或指標名稱,請更新已驗證答案並再次儲存,以便變更生效。
AI 指示
Prep for AI 中的 AI 指令直接在語意模型上提供上下文、商業邏輯與指引。 它們有助於釐清術語、指導分析方法,並提供 AI 原本無法理解的關鍵商業與語意脈絡。
你可以在 Power BI Desktop 或 Power BI 服務中,從 Home 功能區選擇「 為 AI 準備資料 」,然後導覽到 「新增 AI 指示 」標籤來設定這些指令。詳細設定說明請參閱 AI 說明文件。
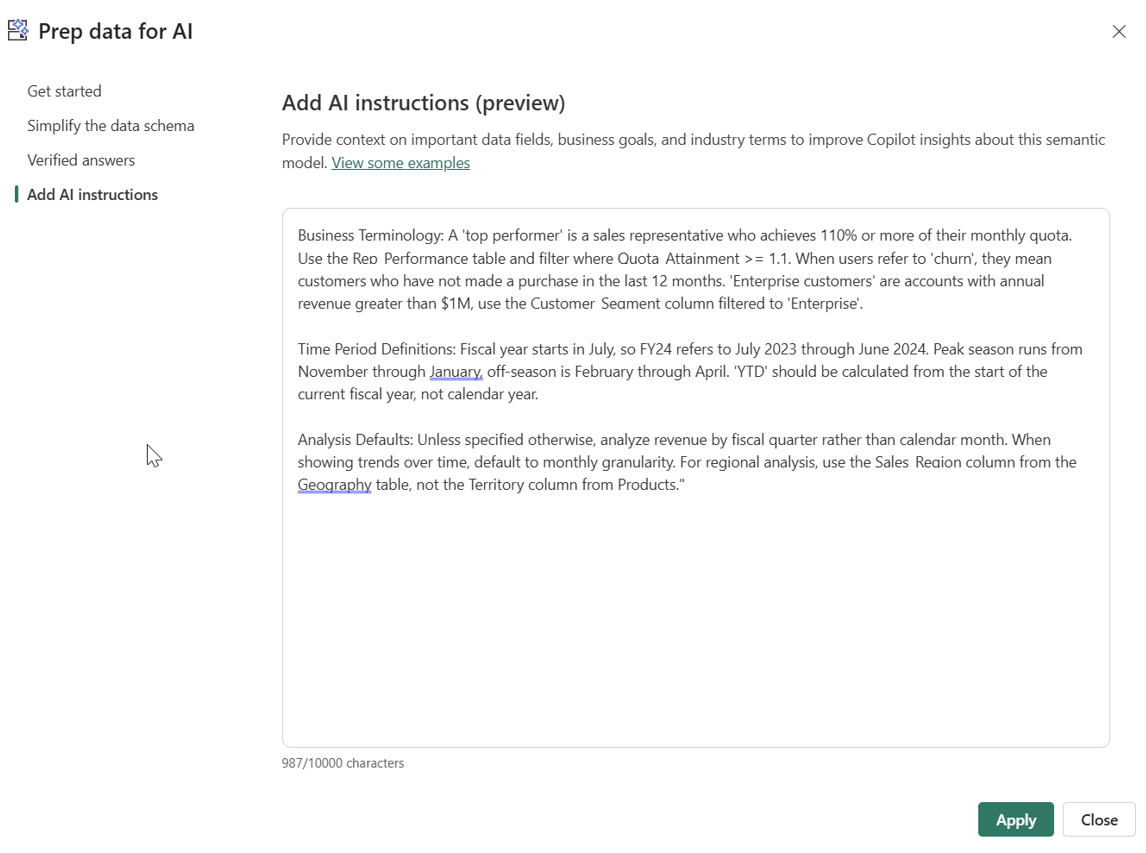
AI 指令是大型語言模型(LLM)所解讀的非結構化指引,但無法保證它完全遵循指令。 清晰具體的指示比複雜或相互矛盾的指示更有效。
如前所述,DAX 生成工具僅指在 Prep for AI 中設定的語意模型 AI 指令。 資料代理的指令不會傳達給工具,查詢語意模型時也會被忽略。 因此,不要在資料代理層級新增語意模型專屬指令。 相反地,所有語意模型指令都放在 Prep for AI 中,讓 DAX 生成工具能使用它們。 資料代理指令應僅包含適用於代理中所有資料來源的指引,例如一般回應格式偏好、跨來源路由規則、常見縮寫、語氣等。 另外要注意的是,與其他資料來源不同,資料代理不支援語意模型的資料來源指令或描述。
範例:定義商業術語
| 沒有 AI 指令 | 使用 AI 指令 |
|---|---|
| 有位用戶問:「上個月表現最好的是誰?」AI 不理解「頂尖表現者」在你組織中的意義,會回傳錯誤或要求說明。 | 你加上指示:「頂尖表現者指的是那些達成其每月配額110%以上的銷售代表。」 使用Rep_Performance表並篩選,Quota_Attainment >= 1.1“ 這樣 AI 就能正確解讀問題並回傳正確結果。 |
有效的指令模式
- 時間段定義: 「旺季從十一月持續到一月。 淡季是二月到四月。」
- 指標偏好: 「當用戶詢問獲利能力時,請使用Contribution_Margin指標,而非Gross_Profit。」
- 資料來源路由: 「關於庫存問題,優先使用 Warehouse_Inventory 表而不是 Sales_Orders。」
- 預設分組: 「除非另有說明,請以財政季度而非日曆月份來分析收入。」
除了 Prep for AI 之外,DAX 查詢產生工具還會利用報表視覺化的元資料,如視覺標題、欄位、衡量、篩選器等,以提升查詢準確度。
建議的實施工作流程
優化語意模型: 首先要優化你的語意模型以提升效能。 資料代理效能不佳常來自於語意模型設計不良、DAX 指標效率低下,或兩者混合。 當使用者提出問題時,資料代理會產生 DAX 查詢,並對你的模型執行。 一個優化良好的模型能節省資源,並實現更快的查詢執行。 在對話式介面中,使用者期望快速回應,因此緩慢的效能直接影響使用者體驗與採用率。
此外,膨脹的模型包含不必要的欄位、表格和度量,會讓 DAX 產生工具在解析時產生更多雜訊,降低回應準確度。 透過及早優化模型,也能避免隨著資料成長和模型變得複雜而產生的效能問題。 你可以在「 Power BI 效能優化模型 」課程中學習更多。
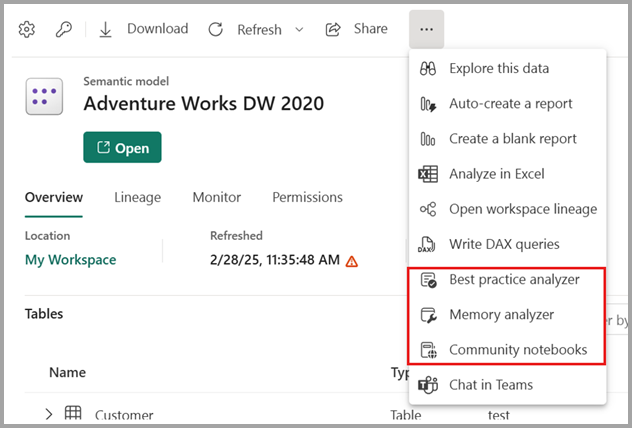
在 Fabric 筆記本中使用 最佳實務分析器(Best Practice Analyzer)與語意模型記憶體分析器(Semantic Model Memory Analyzer ),以識別錯誤資料型別、不必要的欄位、高基數欄位及效率不佳的 DAX 模式等問題。 在表格、欄位和度量中加入描述,幫助 LLM 理解 AI 資料結構中每個物件的目的。
> 根據資料代理人的範圍,在 Prep for AI 中只選擇與代理人應回答的問題相關的表格、欄位與度量來配置 AI 資料架構。
Create Prep for AI > 驗證答案: 找出你最常問的問題,並在 Prep for AI 中使用適當的視覺圖示設定經過驗證的答案。 使用完整且有力的問題作為觸發條件(而非部分片語),以提升配對準確度。
將語意模型加入資料代理: 在 Prep for AI 加入 AI 指令前,先測試並驗證資料代理的回應。 這個步驟幫助你了解在哪些方面需要 AI 指令,以提升 DAX 查詢生成的效率。
新增 AI 準備階段> AI 指令: 根據您的驗證結果,在 Prep for AI 指令中定義商業術語、分析偏好及資料來源優先順序(而非在資料代理指示中)。
準備報告視覺化: 檢視與語意模型相關的報告,包括隱藏的視覺圖示與頁面,以確保視覺化標題具描述性。 結構良好的視覺化有助於 AI 根據視覺元資料(如標題、表格、欄位、所用指標、套用篩選條件等)來建立回應基礎。
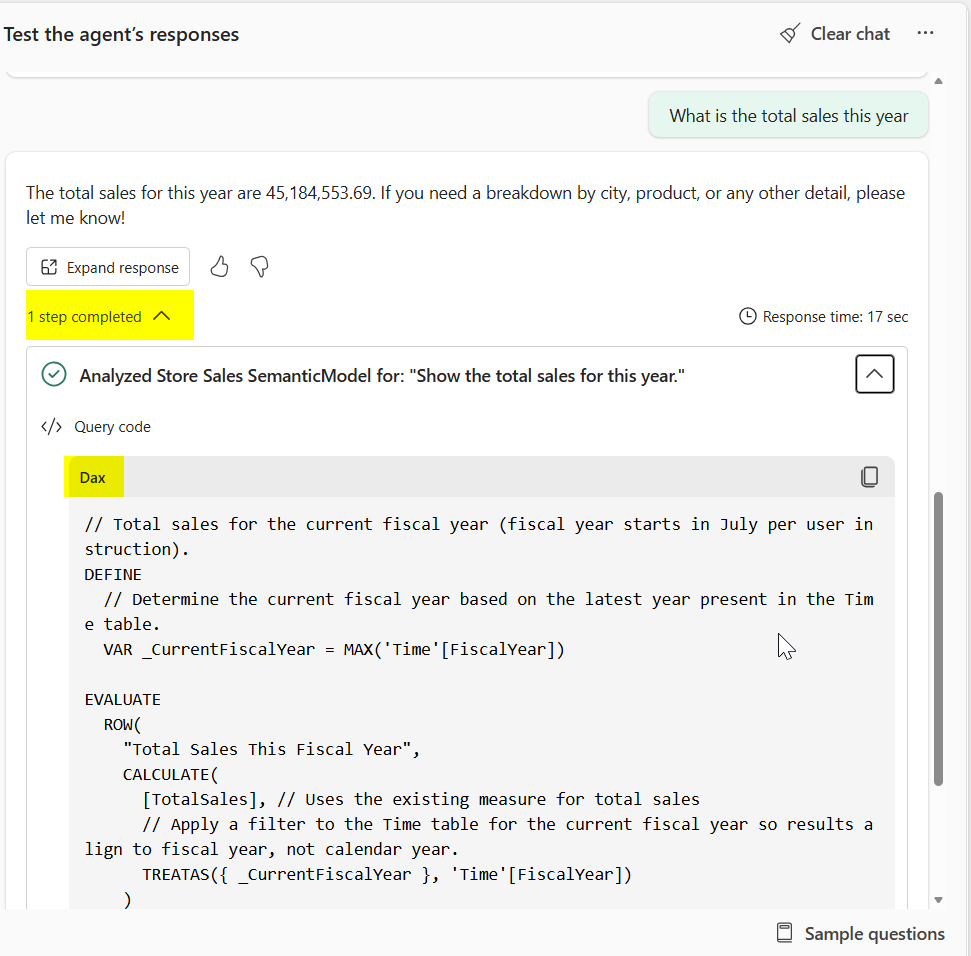
驗證並測試 DAX: 回應的準確度取決於產生的 DAX 查詢。 在測試資料代理時,請在每個回應中檢視 DAX 查詢,確認其有效性並正確回答問題。 若結果錯誤,則分析 DAX 以找出需要調整的配置(語意模型、AI 資料結構、已驗證答案或 AI 指令)。
設定資料代理指令: 僅在資料代理層級新增指令,以提供適用於代理中所有資料來源的指引。 本指南包含一般回應格式偏好、跨來源路由規則、常見縮寫及語氣。 這裡不要加上語意模型專屬的指令,因為它們不會傳給 DAX 產生工具。 關於配置代理指令的指引,請參閱 設定指引。
驗證與反覆: LLMs 在缺乏適當脈絡的情況下可能會產生錯誤結果。 持續迭代你的設定並驗證回應,建立對資料代理的信任。 若要程式化評估回應,您可以使用 Fabric 資料代理 Python SDK 對真實問答對執行自動評估,並分析準確度指標。 請注意,SDK 僅用於此種評估,無法修改語意模型的 Prep for AI 配置。 詳情請參見 「評估您的資料代理人」。 此外,也應讓利害關係人與最終使用者參與評估過程。 他們的回饋確保回應符合現實期望與可用性,幫助您發現自動化檢查可能忽略的缺口。
實施原始碼控制與部署管線: 使用 Git 整合與部署管線來管理跨開發、測試及生產工作空間的資料代理設定。 此做法確保設定變更在升級至生產環境前經過測試與驗證,最終使用者可存取。 詳情請參閱 Fabric 資料代理的原始碼控制、CI/CD 及 ALM。
小提示
你可以參考 fabric-toolbox 倉庫 中的資源,幫助你完成這個工作流程。 此資料庫包含:
要避免的常見陷阱
不使用星型模式: 使用平面、非正規化資料表或樞軸資料結構的語意模型會降低 DAX 效率,且更難正確撰寫。 DAX 針對星型結構進行優化,並有清晰的事實表與維度表。 將寬表解開為正規化結構,每列代表單一觀察值。
依賴隱藏欄位: 如果答案在模型中引用隱藏欄位,驗證答案就無法運作。
包括不必要的措施: 語意模型通常包含輔助指標與中介物件,用以增強報告互動性。 在配置 AI 資料架構時,只包含計算實際業務指標的指標。 排除輔助指標能減少雜訊,並幫助 DAX 產生工具產生更精確的查詢。
重複或重疊的度量: 多個計算相似指標的指標(例如總銷售額、銷售額、營收)會造成模糊性。 整合或明確區分各指標,並排除重複的 AI 資料結構。
非描述性命名: 像 TR_AMT、F_SLS 或 DIM_GEO_01 這類物件名稱,對 DAX 產生工具沒有任何上下文。 使用清晰且商業友善的名稱,如總營收、銷售或客戶地理。 如果你無法重新命名物件,請確保描述和同義詞能提供必要的背景,讓 AI 理解它們的用途。
依賴隱性衡量: 隱性措施可能導致不可預測的結果。 為你希望使用者查詢的計算建立明確的 DAX 度量,並在數值欄位設定正確的預設摘要(Sum、Average、Non 等),以防止意外的彙整。
模糊日期欄位: 多重日期欄位(訂單日期、出貨日期、到期日、日曆季度/財政年度季度等等)且沒有明確指引,會讓 AI 感到困惑。 在 Prep for AI 中使用驗證答案和 AI 指示,指定預設或特定題型的日期欄位。
矛盾的指示: 與驗證答案配置相矛盾的 AI 指令會造成不可預測的行為。
跳過結構細化: 擁有許多同名欄位的大型模型需要聚焦的 AI 資料結構。
過於複雜的指令: 保持指示聚焦且具體。 AI 會解讀,但不保證會遵循複雜且相互矛盾的指引。 複雜的指令也會增加延遲。
Tools
為了遵循這些指引,你可以使用以下 fabric-toolbox GitHub 倉庫中的工具:
- 含有建議的清單。 這些只是指引,並非清單中的所有項目都適用於你的情況。
- 一本筆記本,將所有公用事業集中 在一處。
- Power BI MCP 伺服器 加速 VS Code 的開發與測試
- 語意連結實驗室程式庫,用於以程式方式更新 Fabric 筆記本中的語意模型。