إشعار
يتطلب الوصول إلى هذه الصفحة تخويلاً. يمكنك محاولة تسجيل الدخول أو تغيير الدلائل.
يتطلب الوصول إلى هذه الصفحة تخويلاً. يمكنك محاولة تغيير الدلائل.
ينطبق على: Azure Data Factory Azure Synapse Analytics
تلميح
Data Factory في Microsoft Fabric هو الجيل القادم من Azure Data Factory، مع بنية أبسط، وذكاء اصطناعي مدمج، وميزات جديدة. إذا كنت جديدا في تكامل البيانات، ابدأ مع Fabric Data Factory. يمكن لأعباء عمل ADF الحالية الترقية إلى Fabric للوصول إلى قدرات جديدة في علوم البيانات، والتحليلات اللحظية، والتقارير.
توضح هذه المقالة كيفية استخدام Copy Activity في خطوط أنابيب Azure Data Factory أو Azure Synapse لنسخ البيانات من وإلى قاعدة بيانات Azure SQL، واستخدام Data Flow لتحويل البيانات في قاعدة بيانات Azure SQL. لمعرفة المزيد، اقرأ المقال التمهيدي ل Azure Data Factory أو Azure Synapse Analytics.
إشعار
هذا الموصل متوفر أيضا في Data Factory في Microsoft Fabric. للاطلاع على التكوين والميزات الخاصة ب Fabric، راجع وثائق موصل Fabric قاعدة بيانات Azure SQL.
القدرات المدعومة
موصل قاعدة بيانات Azure SQL هذا مدعوم للقدرات التالية:
| القدرات المدعومة | IR | نقطة النهاية الخاصة المُدارة |
|---|---|---|
| Copy activity (المصدر/الحوض) | (1) (2) | ✓ |
| تعيين تدفق البيانات (المصدر/ المتلقي) | (1) | ✓ |
| نشاط البحث | (1) (2) | ✓ |
| نشاط GetMetadata | (1) (2) | ✓ |
| نشاط البرنامج النصي | (1) (2) | ✓ |
| نشاط الإجراء المخزن | (1) (2) | ✓ |
(1) Azure وقت تشغيل التكامل (2) وقت تشغيل التكامل المستضاف ذاتيا
بالنسبة ل Copy activity، يدعم موصل قاعدة بيانات Azure SQL هذه الوظائف:
- نسخ البيانات باستخدام مصادقة SQL ومصادقة رموز تطبيقات Microsoft Entra مع أصل الخدمة أو هويات مدارة لموارد Azure.
- كمصدر، استرداد البيانات باستخدام استعلام SQL أو إجراء مخزن. يمكنك أيضا اختيار النسخ المتوازي من مصدر قاعدة بيانات Azure SQL، راجع قسم Parallel copy من قاعدة بيانات SQL لمزيد من التفاصيل.
- كمستودع، يتم إنشاء جدول الوجهة تلقائياً إذا لم يكن موجوداً استناداً إلى مخطط المصدر؛ إلحاق البيانات بجدول أو استدعاء إجراء مخزن باستخدام منطق مخصص أثناء النسخ.
إذا كنت تستخدم قاعدة بيانات Azure SQL serverless tier، لاحظ أنه عند إيقاف الخادم مؤقتا، يفشل تشغيل النشاط بدلا من انتظار جاهز الاستئناف التلقائي. يمكنك إضافة إعادة محاولة النشاط أو سلسلة أنشطة إضافية للتأكد من أن الخادم نشط عند التنفيذ الفعلي.
هام
إذا قمت بنسخ البيانات باستخدام وقت تشغيل التكامل Azure، قم بتكوين قاعدة جدار ناري على مستوى الخادم الخادم بحيث تتمكن خدمات Azure من الوصول إلى الخادم. إذا قمت بنسخ البيانات باستخدام وقت تشغيل تكامل مستضاف ذاتياً، فقم بتكوين جدار الحماية للسماح بنطاق بروتوكول الإنترنت المناسب. يشمل هذا النطاق عنوان IP الخاص بالجهاز المستخدم للاتصال ب قاعدة بيانات Azure SQL.
الشروع في العمل
لتنفيذ نشاط النسخ باستخدام خط أنابيب ، يمكنك استخدام إحدى الأدوات أو مجموعات SDK التالية:
- أداة نسخ البيانات
- مدخل Azure
- مجموعة .NET SDK
- Python SDK
- Azure PowerShell
- واجهة برمجة التطبيقات REST
- Azure Resource Manager قالب
إنشاء خدمة مرتبطة ب قاعدة بيانات Azure SQL باستخدام UI
استخدم الخطوات التالية لإنشاء خدمة مرتبطة ب قاعدة بيانات Azure SQL في واجهة مستخدم بوابة Azure.
تصفح إلى تبويب الإدارة في Azure Data Factory أو مساحة Synapse الخاصة بك واختر Linked Services، ثم اضغط على New:
ابحث عن SQL واختر موصل قاعدة بيانات Azure SQL.

قم بتكوين تفاصيل الخدمة، واختبر الاتصال، وأنشئ الخدمة المرتبطة الجديدة.

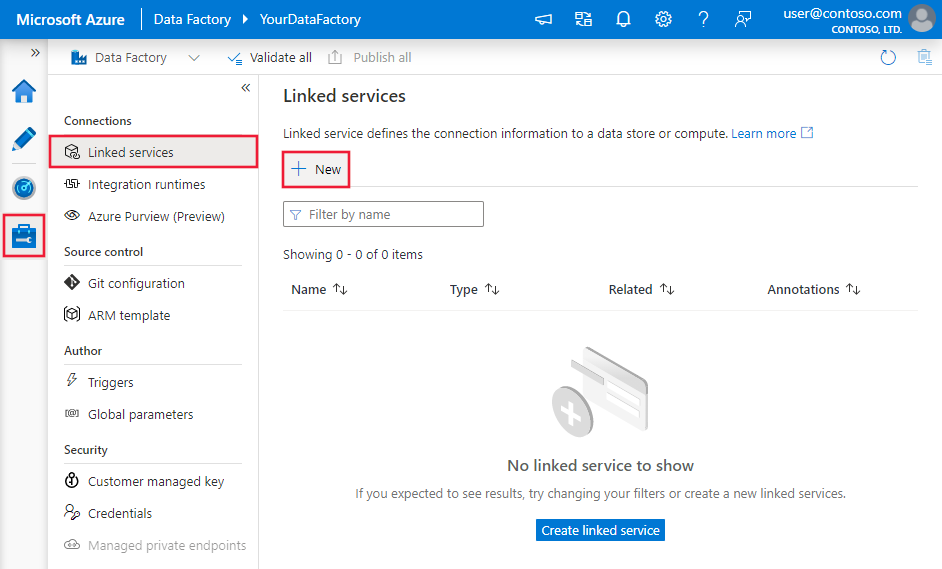
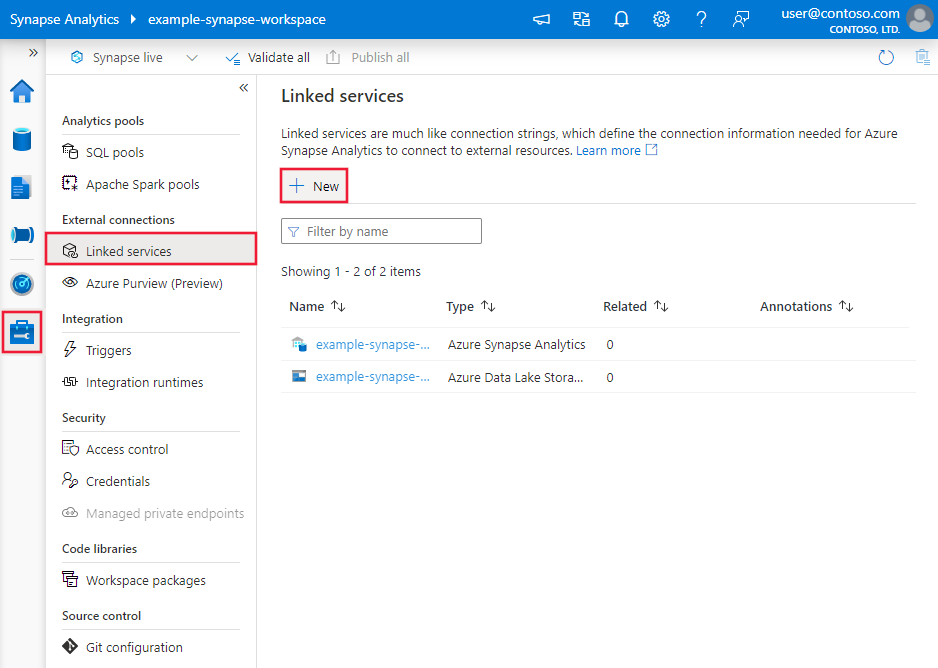
تفاصيل تكوين الموصل
تقدم الأقسام التالية تفاصيل عن الخصائص المستخدمة لتعريف كيانات خطوط أنابيب Azure Data Factory أو Synapse الخاصة بموصل قاعدة بيانات Azure SQL.
خصائص الخدمة المرتبطة
يدعم إصدار الموصل قاعدة بيانات Azure SQL Recommended TLS 1.3. راجع هذا section لترقية نسخة الموصل قاعدة بيانات Azure SQL من Legacy الأصلية. للحصول على تفاصيل الخاصية، راجع الأقسام المقابلة.
تلميح
إذا صادفت خطأ في رمز الخطأ "UserErrorFailedToConnectToSqlServer" ورسالة مثل "حد الجلسة لقاعدة البيانات هو XXX وتم الوصول إليه"، أضف Pooling=false إلى سلسلة الاتصال وحاول مرة أخرى. يوصى أيضا ب Pooling=false لإعداد الخدمة المرتبطة من نوع SHIR (Integration Runtime المستضاف ذاتيا) من نوع الخدمة. يمكن إضافة التجميع ومعلمات الاتصال الأخرى كأسماء وقيم معلمات جديدة في قسم خصائص الاتصال الإضافية في نموذج إنشاء الخدمة المرتبطة.
إصدار الموصى به
هذه الخصائص العامة مدعومة لخدمة مرتبطة قاعدة بيانات Azure SQL عند تطبيق النسخة Recommended:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| النوع | يجب تعيين خاصية النوع إلى: AzureSqlDatabase. | نعم |
| الخادم | اسم أو عنوان الشبكة لمثيل خادم SQL الذي تريد الاتصال به. | نعم |
| قاعدة بيانات | اسم قاعدة البيانات. | نعم |
| نوع المصادقة | النوع المستخدم للمصادقة. القيم المسموح بها هي SQL (افتراضي)، ServicePrincipal، SystemAssignedManagedIdentity، UserAssignedManagedIdentity. انتقل إلى قسم المصادقة ذات الصلة حول خصائص ومتطلبات أساسية محددة. | نعم |
| alwaysEncryptedSettings | حدد معلومات alwaysencryptedsettings المطلوبة لتمكين Always Encrypted لحماية البيانات الحساسة المُخزنة في خادم SQL باستخدام الهوية المدارة أو كيان الخدمة. لمزيد من المعلومات، راجع مثال JSON الذي يتبع الجدول واستخدم القسم Always Encrypted. إذا لم يتم تحديده، فسيتم تعطيل الإعداد الافتراضي المشفر دائماً. | لا |
| تشفير | الإشارة إلى ما إذا كان تشفير TLS مطلوبا لجميع البيانات المرسلة بين العميل والخادم. الخيارات: إلزامية (ل true، default)/اختيارية (ل false)/strict. | لا |
| trustServerCertificate | الإشارة إلى ما إذا كان سيتم تشفير القناة أثناء تجاوز سلسلة الشهادات للتحقق من صحة الثقة. | لا |
| اسم المضيفInCertificate | اسم المضيف الذي يجب استخدامه عند التحقق من صحة شهادة الخادم للاتصال. عند عدم التحديد، يتم استخدام اسم الخادم للتحقق من صحة الشهادة. | لا |
| connectVia | يُستخدم وقت تشغيل التكامل هذا للاتصال بمخزن البيانات. يمكنك استخدام وقت تشغيل تكامل Azure أو وقت تشغيل تكامل ذاتي المستضاف إذا كان مخزن بياناتك موجودا في شبكة خاصة. إذا لم يتم تحديده، يتم استخدام وقت تشغيل تكامل Azure الافتراضي. | لا |
للحصول على خصائص اتصال إضافية، راجع الجدول أدناه:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| applicationIntent | نوع حمل عمل التطبيق عند الاتصال بخادم. القيم المسموح بها هي ReadOnly وReadWrite. |
لا |
| connectTimeout | طول الوقت (بالثوان) لانتظار اتصال بالخادم قبل إنهاء المحاولة وإنشاء خطأ. | لا |
| connectRetryCount | عدد عمليات إعادة الاتصال التي تمت محاولتها بعد تحديد فشل الاتصال الخامل. يجب أن تكون القيمة عددا صحيحا بين 0 و255. | لا |
| ConnectRetryInterval | مقدار الوقت (بالثوان) بين كل محاولة إعادة اتصال بعد تحديد فشل الاتصال الخامل. يجب أن تكون القيمة عددا صحيحا بين 1 و60. | لا |
| وقت موازنة التحميل | الحد الأدنى من الوقت (بالثوان) للاتصال للعيش في تجمع الاتصال قبل إتلاف الاتصال. | لا |
| commandTimeout | وقت الانتظار الافتراضي (بالثوان) قبل إنهاء محاولة تنفيذ أمر وإنشاء خطأ. | لا |
| الأمان المتكامل | القيم المسموح بها هي true أو false. عند تحديد false، حدد ما إذا كان اسم المستخدم وكلمة المرور محددين في الاتصال. عند تحديد true، يشير إلى ما إذا كانت بيانات اعتماد الحساب الحالية Windows تستخدم للمصادقة. |
لا |
| تجاوز الفشلPartner | اسم أو عنوان الخادم الشريك للاتصال به إذا كان الخادم الأساسي معلقا. | لا |
| maxPoolSize | الحد الأقصى لعدد الاتصالات المسموح بها في تجمع الاتصال للاتصال المحدد. | لا |
| minPoolSize | الحد الأدنى لعدد الاتصالات المسموح بها في تجمع الاتصال للاتصال المحدد. | لا |
| مجموعات متعددةActiveResultSets | القيم المسموح بها هي true أو false. عند تحديد true، يمكن للتطبيق الاحتفاظ بمجموعات نتائج نشطة متعددة (MARS). عند تحديد false، يجب على التطبيق معالجة أو إلغاء جميع مجموعات النتائج من دفعة واحدة قبل أن يتمكن من تنفيذ أي دفعات أخرى على هذا الاتصال. |
لا |
| multiSubnetFailover | القيم المسموح بها هي true أو false. إذا كان التطبيق الخاص بك يتصل بمجموعة توفر AlwaysOn (AG) على شبكات فرعية مختلفة، فقم بتعيين هذه الخاصية لتوفير true اكتشاف أسرع للخادم النشط حاليا والاتصال به. |
لا |
| packetSize | حجم وحدات البايت لحزم الشبكة المستخدمة للاتصال بمثيل الخادم. | لا |
| تجميع | القيم المسموح بها هي true أو false. عند تحديد true، سيتم تجميع الاتصال. عند تحديد false، سيتم فتح الاتصال بشكل صريح في كل مرة يتم فيها طلب الاتصال. |
لا |
مصادقة SQL
لاستخدام مصادقة SQL، بالإضافة إلى الخصائص العامة الموضحة في القسم السابق، حدد الخصائص التالية:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| userName | اسم المستخدم المستخدم للاتصال بالخادم. | نعم |
| كلمة المرور | كلمة المرور لاسم المستخدم. وضع علامة على هذا الحقل باعتباره SecureString لتخزينه بشكل آمن. أو يمكنك الإشارة إلى سر مخزن في Azure Key Vault. | نعم |
مثال: استخدام مصادقة SQL
{
    "name": "AzureSqlDbLinkedService",
    "properties": {
        "type": "AzureSqlDatabase",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "SecureString",
                "value": "<password>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
مثال: كلمة مرور في Azure Key Vault
{
    "name": "AzureSqlDbLinkedService",
    "properties": {
        "type": "AzureSqlDatabase",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "AzureKeyVaultSecret",
                "store": {
                    "referenceName": "<Azure Key Vault linked service name>",
                    "type": "LinkedServiceReference"
                },
                "secretName": "<secretName>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
مثال: استخدام Always Encrypted
{
    "name": "AzureSqlDbLinkedService",
    "properties": {
        "type": "AzureSqlDatabase",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "SecureString",
                "value": "<password>"
            },
            "alwaysEncryptedSettings": {
                "alwaysEncryptedAkvAuthType": "ServicePrincipal",
                "servicePrincipalId": "<service principal id>",
                "servicePrincipalKey": {
                    "type": "SecureString",
                    "value": "<service principal key>"
                }
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
المصادقة الأساسية للخدمة
لاستخدام مصادقة كيان الخدمة، بالإضافة إلى الخصائص العامة الموصوفة في القسم السابق، حدد الخصائص التالية:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| servicePrincipalId | حدد معرّف عميل التطبيق. | نعم |
| servicePrincipalCredential | بيانات اعتماد كيان الخدمة. حدِّد مفتاح التطبيق. ضع علامة على هذا الحقل ك SecureString لتخزينه بأمان، أو يشير إلى سر مخزن في Azure Key Vault. | نعم |
| tenant | حدد معلومات المستأجر، مثل اسم المجال أو معرّف المستأجر، الذي يتواجد تطبيقك ضمنه. استرجعها عن طريق تحريك مؤشر الفأرة في الزاوية العلوية اليمنى من بوابة Azure. | نعم |
| azureCloudType | للمصادقة الأساسية للخدمة، حدد نوع بيئة سحابة Azure التي تم تسجيل تطبيق Microsoft Entra الخاص بك فيها. القيم المسموح بها هي AzurePublic، وAzureChina، وAzureUsGovernment، وAzureGermany. وبشكل افتراضي، يتم استخدام مصنع البيانات أو بيئة سحابة خط Synapse. |
لا |
عليك أيضًا اتباع الخطوات التالية:
إنشاء تطبيق Microsoft Entra من بوابة Azure. قم بتدوين اسم التطبيق والقيم التالية التي تحدد الخدمة المرتبطة:
- مُعرّف التطبيق
- مفتاح التطبيق
- معرف المستأجر
توفير مسؤول Microsoft Entra لخادمك على بوابة Azure إذا لم تكن قد فعلت ذلك بالفعل. يجب أن يكون مسؤول Microsoft Entra مستخدما ل Microsoft Entra أو مجموعة Microsoft Entra، لكنه لا يمكن أن يكون مدير خدمة. يتم تنفيذ هذه الخطوة بحيث يمكنك في الخطوة التالية استخدام هوية Microsoft Entra لإنشاء مستخدم قاعدة بيانات محتوى لمدير الخدمة.
إنشاء مستخدمي قاعدة البيانات المضمنة لمبدأ الخدمة. اتصل بقاعدة البيانات التي تريد نسخ البيانات منها أو إليها باستخدام أدوات مثل SQL Server Management Studio، مع هوية Microsoft Entra التي تحتوي على الأقل صلاحيات تعديل أي مستخدم. قم بتشغيل T-SQL التالي:
CREATE USER [your application name] FROM EXTERNAL PROVIDER;امنح مدير الخدمة الأذونات المطلوبة كما تفعل عادةً لمستخدمي SQL أو غيرهم. قم بتشغيل التعليمات البرمجية التالية. لمزيد من الخيارات، يرجى مراجعة هذا المستند.
ALTER ROLE [role name] ADD MEMBER [your application name];قم بتكوين خدمة مرتبطة قاعدة بيانات Azure SQL في مساحة عمل Azure Data Factory أو Synapse.
مثال على الخدمة المرتبطة التي تستخدم المصادقة الأساسية للخدمة
{
    "name": "AzureSqlDbLinkedService",
    "properties": {
        "type": "AzureSqlDatabase",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "hostNameInCertificate": "<host name>",
            "authenticationType": "ServicePrincipal",
            "servicePrincipalId": "<service principal id>",
            "servicePrincipalCredential": {
                "type": "SecureString",
                "value": "<application key>"
            },
            "tenant": "<tenant info, e.g. microsoft.onmicrosoft.com>"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
مصادقة الهوية المدارة المعينة من قبل النظام
يمكن ربط مصنع البيانات أو مساحة عمل Synapse بهوية مدارة system المعينة لموارد Azure تمثل الخدمة عند المصادقة مع موارد أخرى في Azure. يمكنك استخدام هذه الهوية المدارة لمصادقة قاعدة بيانات Azure SQL. يمكن للمصنع المعين أو مساحة العمل Synapse الوصول إلى البيانات ونسخها من قاعدة البيانات الخاصة بك أو إليها باستخدام هذه الهوية.
لاستخدام مصادقة الهوية المدارة المعينة من قبل النظام، حدد الخصائص العامة الموضحة في القسم السابق، واتبع هذه الخطوات.
توفير مسؤول Microsoft Entra لخادمك على بوابة Azure إذا لم تكن قد فعلت ذلك بالفعل. يمكن أن يكون مسؤول Microsoft Entra مستخدما ل Microsoft Entra أو من مجموعة Microsoft Entra. إذا منحت المجموعة ذات الهوية المُدارة دوراً إدارياً، فتخط الخطوتين 3 و4. سيكون للمسؤول حق الوصول الكامل إلى قاعدة البيانات.
إنشاء مستخدمي قاعدة البيانات المضمنة للهوية المُدارة. اتصل بقاعدة البيانات التي تريد نسخ البيانات منها أو إليها باستخدام أدوات مثل SQL Server Management Studio، مع هوية Microsoft Entra التي تحتوي على الأقل صلاحيات تعديل أي مستخدم. قم بتشغيل T-SQL التالي:
CREATE USER [your_resource_name] FROM EXTERNAL PROVIDER;امنح الهوية المُدارة الأذونات المطلوبة كما تفعل عادة لمستخدمي SQL وغيرهم. قم بتشغيل التعليمات البرمجية التالية. لمزيد من الخيارات، يرجى مراجعة هذا المستند.
ALTER ROLE [role name] ADD MEMBER [your_resource_name];قم بتكوين خدمة مرتبطة قاعدة بيانات Azure SQL.
مثال
{
    "name": "AzureSqlDbLinkedService",
    "properties": {
        "type": "AzureSqlDatabase",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SystemAssignedManagedIdentity"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
مصادقة الهوية المدارة المعينة من قبل المستخدم
يمكن ربط مصنع البيانات أو مساحة عمل Synapse ب idities managed المعينة من قبل المستخدم التي تمثل الخدمة عند المصادقة مع موارد أخرى في Azure. يمكنك استخدام هذه الهوية المدارة لمصادقة قاعدة بيانات Azure SQL. يمكن للمصنع المعين أو مساحة العمل Synapse الوصول إلى البيانات ونسخها من قاعدة البيانات الخاصة بك أو إليها باستخدام هذه الهوية.
لاستخدام مصادقة هوية مدارة من قبل عميل معيّن، بالإضافة إلى الخصائص العامة الموصوفة في القسم السابق، حدد الخصائص التالية:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| بيانات الاعتماد | حدد الهوية المدارة المعينة من قبل المستخدم ككائن بيانات الاعتماد. | نعم |
عليك أيضًا اتباع الخطوات التالية:
توفير مسؤول Microsoft Entra لخادمك على بوابة Azure إذا لم تكن قد فعلت ذلك بالفعل. يمكن أن يكون مسؤول Microsoft Entra مستخدما ل Microsoft Entra أو من مجموعة Microsoft Entra. إذا قمت بمنح المجموعة ذات الهوية المُدارة المعينة من قِبل المستخدم دورًا إداريًا، فتخط الخطوات 3. سيكون للمسؤول حق الوصول الكامل إلى قاعدة البيانات.
قم بإنشاء مستخدمي قاعدة البيانات المضمنة للهوية المُدارة المعينة من قبل المستخدم. اتصل بقاعدة البيانات التي تريد نسخ البيانات منها أو إليها باستخدام أدوات مثل SQL Server Management Studio، مع هوية Microsoft Entra التي تحتوي على الأقل صلاحيات تعديل أي مستخدم. قم بتشغيل T-SQL التالي:
CREATE USER [your_resource_name] FROM EXTERNAL PROVIDER;قم بإنشاء هوية مدارة واحدة أو عدة هويات مدارة يعينها المستخدم وامنح الهوية المدارة المعينة من قِبَل المستخدم الأذونات المطلوبة كما تفعل عادةً لمستخدمي SQL وغيرهم. قم بتشغيل التعليمات البرمجية التالية. لمزيد من الخيارات، يرجى مراجعة هذا المستند.
ALTER ROLE [role name] ADD MEMBER [your_resource_name];تعيين هوية مدارة معينة من قبل المستخدم، واحدة أو متعددة، إلى مصنع البيانات وإنشاء بيانات اعتماد لكل هوية مدارة معينة من قبل المستخدم.
قم بتكوين خدمة مرتبطة قاعدة بيانات Azure SQL.
مثال
{
    "name": "AzureSqlDbLinkedService",
    "properties": {
        "type": "AzureSqlDatabase",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "UserAssignedManagedIdentity",
            "credential": {
                "referenceName": "credential1",
                "type": "CredentialReference"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
الإصدار القديم
تدعم هذه الخصائص العامة لخدمة مرتبطة قاعدة بيانات Azure SQL عند تطبيق نسخة Legacy:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| النوع | يجب تعيين خاصية النوع إلى: AzureSqlDatabase. | نعم |
| سلسلة الاتصال | حدد المعلومات اللازمة للاتصال بمثيل قاعدة بيانات Azure SQL لخاصية connectionString. يمكنك أيضا وضع كلمة مرور أو مفتاح الخدمة الرئيسي في Azure Key Vault. إذا كانت المصادقة عبر SQL، قم بسحب تكوين password من سلسلة الاتصال. لمزيد من المعلومات، راجع بيانات اعتماد المتجر في Azure Key Vault. |
نعم |
| alwaysEncryptedSettings | حدد معلومات alwaysencryptedsettings المطلوبة لتمكين Always Encrypted لحماية البيانات الحساسة المُخزنة في خادم SQL باستخدام الهوية المدارة أو كيان الخدمة. لمزيد من المعلومات، راجع قسم استخدام Always Encrypted. إذا لم يتم تحديده، فسيتم تعطيل الإعداد الافتراضي المشفر دائماً. | لا |
| connectVia | يُستخدم وقت تشغيل التكامل هذا للاتصال بمخزن البيانات. يمكنك استخدام وقت تشغيل تكامل Azure أو وقت تشغيل تكامل ذاتي المستضاف إذا كان مخزن بياناتك موجودا في شبكة خاصة. إذا لم يتم تحديده، يتم استخدام وقت تشغيل تكامل Azure الافتراضي. | لا |
بالنسبة إلى أنواع المصادقة المختلفة، راجع الأقسام التالية حول خصائص ومتطلبات أساسية معينة على التوالي:
- مصادقة SQL للإصدار القديم
- المصادقة الأساسية للخدمة للإصدار القديم
- مصادقة الهوية المدارة المعينة من قبل النظام للإصدار القديم
- مصادقة الهوية المدارة المعينة من قبل المستخدم للإصدار القديم
مصادقة SQL للإصدار القديم
لاستخدام مصادقة SQL، حدد الخصائص العامة الموضحة في القسم السابق.
المصادقة الأساسية للخدمة للإصدار القديم
لاستخدام مصادقة كيان الخدمة، بالإضافة إلى الخصائص العامة الموصوفة في القسم السابق، حدد الخصائص التالية:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| servicePrincipalId | حدد معرّف عميل التطبيق. | نعم |
| servicePrincipalKey | حدِّد مفتاح التطبيق. ضع علامة على هذا الحقل ك SecureString لتخزينه بأمان أو إشارة إلى سر مخزن في Azure Key Vault. | نعم |
| tenant | حدد معلومات المستأجر، مثل اسم المجال أو معرّف المستأجر، الذي يتواجد تطبيقك ضمنه. استرجعها عن طريق تحريك مؤشر الفأرة في الزاوية العلوية اليمنى من بوابة Azure. | نعم |
| azureCloudType | للمصادقة الأساسية للخدمة، حدد نوع بيئة سحابة Azure التي تم تسجيل تطبيق Microsoft Entra الخاص بك فيها. القيم المسموح بها هي AzurePublic، وAzureChina، وAzureUsGovernment، وAzureGermany. وبشكل افتراضي، يتم استخدام مصنع البيانات أو بيئة سحابة خط Synapse. |
لا |
تحتاج أيضا إلى اتباع الخطوات الواردة في المصادقة الأساسية للخدمة لمنح الإذن المقابل.
مصادقة الهوية المدارة المعينة من قبل النظام للإصدار القديم
لاستخدام مصادقة الهوية المدارة المعينة من قبل النظام، اتبع نفس الخطوة للإصدار الموصى به في مصادقة الهوية المدارة المعينة من قبل النظام.
مصادقة الهوية المدارة المعينة من قبل المستخدم للإصدار القديم
لاستخدام مصادقة الهوية المدارة المعينة من قبل المستخدم، اتبع نفس الخطوة للإصدار الموصى به في مصادقة الهوية المدارة المعينة من قبل المستخدم.
خصائص مجموعة البيانات
للحصول على قائمة كاملة بالأقسام والخصائص المتوفرة لتعريف مجموعات البيانات، راجع مجموعات البيانات.
الخصائص التالية مدعومة لمجموعة بيانات قاعدة بيانات Azure SQL:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| النوع | يجب تعيين خاصية نوع مجموعة البيانات إلى: AzureSqlTable. | نعم |
| Schema | اسم المخطط. | لا للمصدر، نعم للمتلقي |
| طاولتنا | اسم الجدول/طريقة العرض. | لا للمصدر، نعم للمتلقي |
| اسم الجدول | اسم الجدول/طريقة العرض مع المخطط. هذه الخاصية مدعومة للتوافق مع الإصدارات السابقة. بالنسبة لحمل العمل الجديد، استخدم schema وtable. |
لا للمصدر، نعم للمتلقي |
مثال خصائص مجموعة البيانات
{
    "name": "AzureSQLDbDataset",
    "properties":
    {
        "type": "AzureSqlTable",
        "linkedServiceName": {
            "referenceName": "<Azure SQL Database linked service name>",
            "type": "LinkedServiceReference"
        },
        "schema": [ < physical schema, optional, retrievable during authoring > ],
        "typeProperties": {
            "schema": "<schema_name>",
            "table": "<table_name>"
        }
    }
}
خصائص Copy activity
للحصول على قائمة كاملة بالأقسام والخصائص المتوفرة لتعريف الأنشطة، راجع البنية الأساسية لبرنامج ربط العمليات التجارية. يوفر هذا القسم قائمة بالخصائص المدعومة من قبل مصدر ومصرف قاعدة بيانات Azure SQL.
قاعدة بيانات Azure SQL كمصدر
تلميح
لتحميل البيانات من قاعدة بيانات Azure SQL بكفاءة باستخدام تقسيم البيانات، تعلم المزيد من Parallel copy من قاعدة بيانات SQL.
لنسخ البيانات من قاعدة بيانات Azure SQL، يتم دعم الخصائص التالية في قسم نشاط النسخ source:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| النوع | يجب تعيين خاصية نوع مصدر نشاط النسخ إلى AzureSqlSource. لا يزال نوع "SqlSource" معتمدًا للتوافق مع الإصدارات السابقة. | نعم |
| sqlReaderQuery | تستخدم هذه الخاصية استعلام SQL المُخصص لقراءة البيانات. مثال على ذلك select * from MyTable . |
لا |
| sqlReaderStoredProcedureName | اسم الإجراء المخزن الذي يقرأ البيانات من الجدول المصدر. يجب أن تكون بوابة لغة الاستعلامات المركبة الأخيرة عبارة عن مصطلح SELECT في الإجراء المُخزن. | لا |
| storedProcedureParameters | معلمات الإجراء المخزن. القيم المسموح بها هي أزواج الاسم أو القيمة. يجب أن تتطابق أسماء وأغلفة المعلمات مع الأسماء والغلاف الخاص بمعلمات الإجراء المخزن. |
لا |
| isolationLevel | يحدد سلوك تأمين المعاملة لمصدر SQL. القيم المسموح بها هي: ReadCommitted، وReadUncommitted، وRepeatableRead، وSerializable، وSnapshot. إذا لم يتم تحديده، فسيتم استخدام مستوى العزل الافتراضي لقاعدة البيانات. يرجى مراجعة هذا المستند للحصول على المزيد من التفاصيل. | لا |
| خيارات التقسيم | يحدد خيارات تقسيم البيانات المستخدمة لتحميل البيانات من قاعدة بيانات Azure SQL. القيم المسموح بها هي: None (افتراضي)، وPhysicalPartitionsOfTable، وDynamicRange. عندما يتم تفعيل خيار تقسيم (أي ليس None)، يتم التحكم في درجة التوازي لتحميل البيانات المتزامنة من قاعدة بيانات Azure SQL بواسطة إعداد parallelCopies في نشاط النسخ. |
لا |
| partitionSettings | حدد مجموعة الإعدادات الخاصة بتقسيم البيانات. تطبيق عندما لا يكون خيار التقسيم None. |
لا |
تحت partitionSettings: |
||
| partitionColumnName | حدد اسم عمود المصدر بعدد صحيح أو نوع التاريخ/التاريخ والوقت (int أو smallint أو bigint أو date أو smalldatetime أو datetime أو datetime2 أو datetimeoffset) التي سيتم استخدامها عن طريق تقسيم النطاق للنسخ المتوازي. إذا لم يتم تحديده، فسيتم اكتشاف الفهرس أو المفتاح الأساسي للجدول تلقائيًا واستخدامهما كعمود للقسم.تُطبق عندما يكون خيار التقسيم هو DynamicRange. إذا كنت تستخدم استعلاماً لاسترداد البيانات المصدر، اربط ?DfDynamicRangePartitionCondition في عبارة WHERE. على سبيل المثال، راجع القسم النسخ المتوازي من قاعدة بيانات SQL. |
لا |
| التقسيم | القيمة القصوى لعمود القسم لتقسيم نطاق القسم. تُستخدم هذه القيمة لتحديد مرحلة القسم، وليس لتصفية الصفوف في الجدول. سيتم تقسيم ونسخ جميع الصفوف في الجدول أو نتيجة الاستعلام. إذا لم يتم تحديده، يكشف نشاط النسخ القيمة تلقائياً. تُطبق عندما يكون خيار التقسيم هو DynamicRange. على سبيل المثال، راجع القسم النسخ المتوازي من قاعدة بيانات SQL. |
لا |
| partitionLowerBound | الحد الأدنى لقيمة عمود القسم لتقسيم نطاق القسم. تُستخدم هذه القيمة لتحديد مرحلة القسم، وليس لتصفية الصفوف في الجدول. سيتم تقسيم ونسخ جميع الصفوف في الجدول أو نتيجة الاستعلام. إذا لم يتم تحديده، يكشف نشاط النسخ القيمة تلقائياً. تُطبق عندما يكون خيار التقسيم هو DynamicRange. على سبيل المثال، راجع القسم النسخ المتوازي من قاعدة بيانات SQL. |
لا |
لاحظ النقاط التالية:
- إذا تم تحديد sqlReaderQuery ل AzureSqlSource، فإن نشاط النسخ يشغل هذا الاستعلام ضد المصدر قاعدة بيانات Azure SQL للحصول على البيانات. يمكنك أيضاً تحديد إجراء مخزن عن طريق تحديد sqlReaderStoredProcedureName وstoredProcedureParameters إذا كان الإجراء المُخزن يأخذ المعلمات.
- عند استخدام الإجراء المُخزن في المصدر لاسترداد البيانات، لاحظ إذا تم تصميم الإجراء المُخزن الخاص بك لإرجاع مخطط مختلف عند تمرير قيمة معلمة مختلفة، فقد تواجه عطلاً أو ترى نتيجة غير متوقعة عند استيراد مخطط من واجهة المستخدم أو عند نسخ البيانات إلى قاعدة بيانات SQL باستخدام إنشاء الجدول التلقائي.
مثال استعلام SQL
"activities":[
    {
        "name": "CopyFromAzureSQLDatabase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Azure SQL Database input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "AzureSqlSource",
                "sqlReaderQuery": "SELECT * FROM MyTable"
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
مثال الإجراء المخزّن
"activities":[
    {
        "name": "CopyFromAzureSQLDatabase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Azure SQL Database input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "AzureSqlSource",
                "sqlReaderStoredProcedureName": "CopyTestSrcStoredProcedureWithParameters",
                "storedProcedureParameters": {
                    "stringData": { "value": "str3" },
                    "identifier": { "value": "$$Text.Format('{0:yyyy}', <datetime parameter>)", "type": "Int"}
                }
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
تعريف الإجراء المخزن
CREATE PROCEDURE CopyTestSrcStoredProcedureWithParameters
(
    @stringData varchar(20),
    @identifier int
)
AS
SET NOCOUNT ON;
BEGIN
     select *
     from dbo.UnitTestSrcTable
     where dbo.UnitTestSrcTable.stringData != stringData
    and dbo.UnitTestSrcTable.identifier != identifier
END
GO
قاعدة بيانات Azure SQL as the sink
تلميح
تعرف أكثر على سلوكيات الكتابة المدعومة، والتكوينات، وأفضل الممارسات من أفضل الممارسات لتحميل البيانات في قاعدة بيانات Azure SQL.
لنسخ البيانات إلى قاعدة بيانات Azure SQL، تدعم الخصائص التالية في قسم نشاط النسخ sink:
| الخاصية | الوصف | مطلوب |
|---|---|---|
| النوع | يجب تعيين خاصية نوع متلقي نشاط النسخ إلى AzureSqlSink. لا يزال نوع "SqlSink" معتمدًا للتوافق مع الإصدارات السابقة. | نعم |
| preCopyScript | حدد استعلام SQL ليتم تشغيل نشاط النسخ قبل كتابة البيانات في قاعدة بيانات Azure SQL. يتم استدعاؤه مرة واحدة فقط لكل نسخة تشغيل. استخدم هذه الخاصية لتنظيف البيانات المحملة في الخلفية. | لا |
| tableOption | تحديد ما إذا كان سيتم إنشاء جدول المتلقي تلقائياً إذا لم يكن موجوداً استناداً إلى المخطط المصدر. لا يتم دعم الإنشاء التلقائي للجدول عندما يحدد التجمع الإجراء المخزن. القيم المسموح بها هي: none (افتراضي)، وautoCreate. |
لا |
| sqlWriterStoredProcedureName | اسم الإجراء المُخزن الذي يحدد كيفية تطبيق البيانات المصدر في الجدول الهدف. سيتم استدعاء هذا الإجراء المُخزن كل دفعة. بالنسبة للعمليات التي يتم تشغيلها مرة واحدة فقط وليس لها علاقة ببيانات المصدر، على سبيل المثال، الحذف أو الاقتطاع، استخدم الخاصية preCopyScript.يرجى مراجعة مثال من استدعاء إجراء مُخزن من متلقي SQL. |
لا |
| storedProcedureTableTypeParameterName | اسم المعلمة لنوع الجدول المحدد في الإجراء المخزن. | لا |
| sqlWriterTableType | اسم نوع الجدول الذي سيتم استخدامه في الإجراء المخزن. يجعل نشاط النسخ البيانات التي يتم نقلها متاحة في جدول مؤقت بنوع الجدول الماثل. يمكن بعد ذلك أن يدمج رمز الإجراء المخزن البيانات التي يتم نسخها مع البيانات الموجودة. | لا |
| storedProcedureParameters | معلمات الإجراء المخزن. القيم المسموح بها هي أزواج الاسم والقيمة. يجب أن تتطابق الأسماء وغلاف المعلمات مع الأسماء والغلاف الخاص بمعلمات الإجراء المخزن. |
لا |
| writeBatchSize | عدد الصفوف المراد إدراجها في جدول SQL لكل دفعة. القيمة المسموح بها هي integer (عدد الصفوف). بشكل افتراضي، تحدد الخدمة ديناميكياً حجم الدُفعة المناسب بناءً على حجم الصف. |
لا |
| writeBatchTimeout | وقت الانتظار حتى تكتمل عملية الإجراء الإدراج والإصدار والتخزين قبل انتهاء المهلة. القيم المسموح بها هي للمدى الزمني. مثال على ذلك هو "00:30:00" لمدة 30 دقيقة. إذا لم يتم تحديد أي قيمة، يتم تعيين المهلة الافتراضية إلى "00:30:00". |
لا |
| disableMetricsCollection | تجمع الخدمة مقاييس مثل وحدات بيانات قاعدة بيانات Azure SQL DTUs لتحسين أداء النسخ والتوصيات، مما يضيف وصولا إضافيا إلى قاعدة البيانات الرئيسية. إذا كنت مهتمًا بهذا السلوك، فحدد trueلإيقاف تشغيله. |
لا (الافتراضي هو false) |
| maxConcurrentConnections | الحد الأعلى للاتصالات المتزامنة التي تم إنشاؤها إلى مخزن البيانات أثناء تشغيل النشاط. حدد قيمة فقط عندما تريد تحديد الاتصالات المتزامنة. | لا |
| WriteBehavior | حدد سلوك الكتابة لنشاط النسخ لتحميل البيانات إلى قاعدة بيانات Azure SQL. القيمة المسموح بها هي Insert و Upsert. تستخدم الخدمة insert لتحميل البيانات بشكلٍ افتراضي. |
لا |
| upsertSettings | حدد مجموعة إعدادات سلوك الكتابة. استخدمها عندما يكون خيار WriteBehavior هو Upsert. |
لا |
تحت upsertSettings: |
||
| useTempDB | حدد ما إذا كنت تريد استخدام الجدول المؤقت العمومي أو الجدول الفعلي كجدول مؤقت ل upsert. تستخدم الخدمة الجدول المؤقت العمومي كجدول مؤقت بشكلٍ افتراضي. القيمة هي true. |
لا |
| interimSchemaName | حدد المخطط المؤقت لإنشاء جدول مؤقت إذا تم استخدام جدول فعلي. ملاحظة: يحتاج المستخدم إلى الحصول على إذن لإنشاء أي جدول وحذفه. بشكل افتراضي، سيشارك الجدول المؤقت نفس المخطط كجدول متلقي. استخدمه عندما يكون خيار useTempDB هو False. |
لا |
| المفاتيح | حدد أسماء الأعمدة لتعريف الصف الفريد. يمكن استخدام مفتاح واحد أو سلسلة من المفاتيح. إذا لم يتم تحديده، فسيتم استخدام عمود المفتاح الأساسي. | لا |
مثال 1: إلحاق البيانات
"activities":[
    {
        "name": "CopyToAzureSQLDatabase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<Azure SQL Database output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "<source type>"
            },
            "sink": {
                "type": "AzureSqlSink",
                "tableOption": "autoCreate",
                "writeBatchSize": 100000
            }
        }
    }
]
مثال 2: استدعاء إجراء مخزن أثناء النسخ
تعرف على مزيد من التفاصيل من استدعاء إجراء مخزن من متلقي SQL.
"activities":[
    {
        "name": "CopyToAzureSQLDatabase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<Azure SQL Database output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "<source type>"
            },
            "sink": {
                "type": "AzureSqlSink",
                "sqlWriterStoredProcedureName": "CopyTestStoredProcedureWithParameters",
                "storedProcedureTableTypeParameterName": "MyTable",
                "sqlWriterTableType": "MyTableType",
                "storedProcedureParameters": {
                    "identifier": { "value": "1", "type": "Int" },
                    "stringData": { "value": "str1" }
                }
            }
        }
    }
]
مثال 3: بيانات Upsert
"activities":[
    {
        "name": "CopyToAzureSQLDatabase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<Azure SQL Database output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "<source type>"
            },
            "sink": {
                "type": "AzureSqlSink",
                "tableOption": "autoCreate",
                "writeBehavior": "upsert",
                "upsertSettings": {
                    "useTempDB": true,
                    "keys": [
                        "<column name>"
                    ]
                },
            }
        }
    }
]
نسخة موازية من قاعدة بيانات SQL
يوفر موصل قاعدة بيانات Azure SQL في نشاط النسخ تقسيم بيانات مدمج لنسخ البيانات بالتوازي. يمكنك العثور على خيارات تقسيم البيانات في علامة التبويب Source لنشاط النسخ.
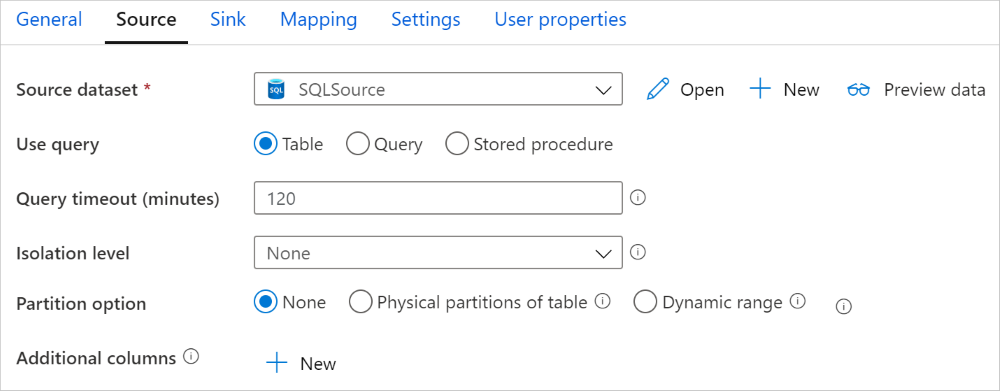
عند تفعيل النسخ المقسمة، يقوم نشاط النسخ بتشغيل استعلامات متوازية على مصدر قاعدة بيانات Azure SQL الخاص بك لتحميل البيانات حسب الأقسام. يتم التحكم في الدرجة المتوازية بواسطة parallelCopies الإعداد على نشاط النسخ. على سبيل المثال، إذا ضبطت parallelCopies على أربعة، تقوم الخدمة بتوليد وتشغيل أربع استعلامات في نفس الوقت بناء على خيار التقسيم والإعدادات المحددة لديك، وكل استعلام يسترجع جزءا من البيانات من قاعدة بيانات Azure SQL الخاص بك.
ينصح بتفعيل النسخ المتوازية مع تقسيم البيانات خاصة عند تحميل كمية كبيرة من البيانات من قاعدة بيانات قاعدة بيانات Azure SQL الخاصة بك. فيما يلي تكوينات مقترحة لسيناريوهات مختلفة. عند نسخ البيانات إلى مخزن بيانات مستند إلى ملف، يوصى بالكتابة إلى مجلد كملفات متعددة (حدد اسم المجلد فقط)، وفي هذه الحالة يكون الأداء أفضل من الكتابة إلى ملف واحد.
| السيناريو | الإعدادات المقترحة |
|---|---|
| تحميل كامل من جدول كبير بأقسام فعلية. |
خيار التقسيم: أقسام فعلية للجدول. أثناء التنفيذ، تكتشف الخدمة تلقائياً الأقسام المادية ونسخ البيانات حسب الأقسام. للتحقق مما إذا كان الجدول يحتوي على قسم فعلي أم لا، يمكنك الرجوع إلى هذا الاستعلام. |
| تحميل كامل من جدول كبير، بدون أقسام فعلية، مع وجود عدد صحيح أو عمود التاريخ والوقت لتقسيم البيانات. |
خيارات التقسيم: تقسيم النطاق الديناميكي. عمود التقسيم (اختياري): حدد العمود المستخدم لتقسيم البيانات. إذا لم يتم تحديده، يتم استخدام الفهرس أو عمود المفتاح الأساسي. الحد الأعلى للتقسيموالحد الأدنى للتقسيم (اختياري): حدد إذا كنت تريد تحديد المقدار الموسع للتقسيم. هذا ليس لتصفية الصفوف في الجدول، سيتم تقسيم ونسخ جميع الصفوف في الجدول. إذا لم يتم تحديده، فقم بنسخ النشاط تلقائياً للكشف عن القيم. على سبيل المثال، إذا كان معرّف عمود التقسيم يحتوي على قيم تتراوح من 1 إلى 100، وقمت بتعيين الحد الأدنى كـ 20 والحد الأعلى كـ 80، مع النسخ المتوازي كـ 4، تسترد الخدمة البيانات من خلال 4 أقسام - المعرّفات في النطاق <= 20 و[21 و50] و[51 و80] و>=81 على التوالي. |
| تحميل كمية كبيرة من البيانات باستخدام استعلام مخصص، دون أقسام فعلية، مع وجود عدد صحيح أو عمود التاريخ/التاريخ والوقت لتقسيم البيانات. |
خيارات التقسيم: تقسيم النطاق الديناميكي. استعلام: SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>.عمود التقسيم: حدد العمود المستخدم لتقسيم البيانات. الحد الأعلى للتقسيموالحد الأدنى للتقسيم (اختياري): حدد إذا كنت تريد تحديد المقدار الموسع للتقسيم. هذا ليس لتصفية الصفوف في الجدول، سيتم تقسيم كافة الصفوف في نتيجة الاستعلام ونسخها. إذا لم يتم تحديده، يكشف نشاط النسخ القيمة تلقائياً. على سبيل المثال، إذا كان معرّف عمود التقسيم يحتوي على قيم تتراوح من 1 إلى 100، وقمت بتعيين الحد الأدنى كـ 20 والحد الأعلى كـ 80، مع النسخ المتوازي كـ 4، تسترد الخدمة البيانات من خلال 4 أقسام - المعرّفات في النطاق <= 20 و[21 و50] و[51 و80] و>=81 على التوالي. فيما يلي المزيد من نماذج الاستعلامات لسيناريوهات مختلفة: 1. الاستعلام عن الجدول بأكمله: SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition2. الاستعلام من جدول مع تحديد عمود وعوامل تصفية إضافية ل where-clause: SELECT <column_list> FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>3. الاستعلام باستخدام الاستعلامات الفرعية: SELECT <column_list> FROM (<your_sub_query>) AS T WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>4. الاستعلام مع القسم في الاستعلام الفرعي: SELECT <column_list> FROM (SELECT <your_sub_query_column_list> FROM <TableName> WHERE ?DfDynamicRangePartitionCondition) AS T |
أفضل الممارسات لتحميل البيانات مع خيار التقسيم:
- اختر عمود مميز كعمود تقسيم (مثل المفتاح الأساسي أو المفتاح الفريد) لتجنب انحراف البيانات.
- إذا كان الجدول يحتوي على قسم مضمن، فاستخدم خيار القسم "الأقسام المادية للجدول" للحصول على أداء أفضل.
- إذا استخدمت Azure Integration Runtime لنسخ البيانات، يمكنك تعيين وحدات "وحدات تكامل البيانات (DIU)" (>4) أكبر لاستخدام موارد حوسبة أكبر. تحقق من السيناريوهات القابلة للتطبيق هناك.
- تتحكم "درجة توازي النسخ" في أرقام التقسيم، ويؤدي تعيين هذا الرقم إلى عدد كبير جداً في بعض الأحيان إلى الإضرار بالأداء، ويوصي بتعيين هذا الرقم إلى (DIU أو عدد عقد وقت تشغيل التكامل المستضاف ذاتياً) * (2 إلى 4).
مثال: تحميل كامل من جدول كبير مع أقسام فعلية
"source": {
    "type": "AzureSqlSource",
    "partitionOption": "PhysicalPartitionsOfTable"
}
مثال: الاستعلام مع تقسيم النطاق الديناميكي
"source": {
    "type": "AzureSqlSource",
    "query": "SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>",
    "partitionOption": "DynamicRange",
    "partitionSettings": {
        "partitionColumnName": "<partition_column_name>",
        "partitionUpperBound": "<upper_value_of_partition_column (optional) to decide the partition stride, not as data filter>",
        "partitionLowerBound": "<lower_value_of_partition_column (optional) to decide the partition stride, not as data filter>"
    }
}
نموذج استعلام للتحقق من التقسيم الفعلي
SELECT DISTINCT s.name AS SchemaName, t.name AS TableName, pf.name AS PartitionFunctionName, c.name AS ColumnName, iif(pf.name is null, 'no', 'yes') AS HasPartition
FROM sys.tables AS t
LEFT JOIN sys.objects AS o ON t.object_id = o.object_id
LEFT JOIN sys.schemas AS s ON o.schema_id = s.schema_id
LEFT JOIN sys.indexes AS i ON t.object_id = i.object_id
LEFT JOIN sys.index_columns AS ic ON ic.partition_ordinal > 0 AND ic.index_id = i.index_id AND ic.object_id = t.object_id
LEFT JOIN sys.columns AS c ON c.object_id = ic.object_id AND c.column_id = ic.column_id
LEFT JOIN sys.partition_schemes ps ON i.data_space_id = ps.data_space_id
LEFT JOIN sys.partition_functions pf ON pf.function_id = ps.function_id
WHERE s.name='[your schema]' AND t.name = '[your table name]'
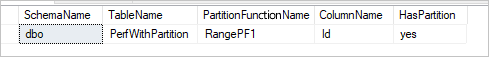
إذا كان الجدول يحتوي على تقسيم فعلي، فسترى "HasPartition" كـ "yes" كما يلي.
أفضل الممارسات لتحميل البيانات في قاعدة بيانات Azure SQL
عند نسخ البيانات إلى قاعدة بيانات Azure SQL، قد تحتاج إلى سلوك كتابة مختلف:
- إلحاق: تحتوي بيانات المصدر الخاصة بي على سجلات جديدة فقط.
- Upsert: تحتوي بيانات المصدر الخاصة بي على كل من الإدراجات والتحديثات.
- الاستبدال: أريد إعادة تحميل جدول أبعاد بأكمله في كل مرة.
- الكتابة باستخدام منطق مخصص: أحتاج معالجة إضافية قبل الإدراج النهائي في الجدول الوجهة.
الرجوع إلى الأقسام المعنية حول كيفية التكوين في الخدمة وأفضل الممارسات.
قم بإلحاق البيانات
إضافة البيانات هي السلوك الافتراضي لموصل قاعدة بيانات Azure SQL sink هذا. تقوم الخدمة بإدراج مجمع للكتابة إلى الجدول بكفاءة. يمكنك تكوين المصدر والإيداع وفقاً لذلك في نشاط النسخ.
إدخال وتحديث البيانات
يدعم Copy activity الآن تحميل البيانات بشكل أصلي في جدول مؤقت لقاعدة البيانات ثم تحديث البيانات في جدول الحوض إذا كان هناك مفتاح وإدخال بيانات جديدة. لمعرفة المزيد عن إعدادات upsert في أنشطة النسخ، راجع قاعدة بيانات Azure SQL ك sink.
استبدال الجدول بأكمله
يمكنك تكوين الخاصية preCopyScript في متلقي نشاط النسخ. في هذه الحالة، لكل نشاط نسخ يتم تشغيله، تقوم الخدمة بتشغيل البرنامج النصي أولاً. ثم يقوم بتشغيل النسخة لإدراج البيانات. على سبيل المثال، للكتابة فوق الجدول بأكمله بأحدث البيانات، حدد برنامجاً نصياً لحذف جميع السجلات أولاً قبل تحميل البيانات الجديدة من المصدر بشكل مجمع.
اكتب البيانات بمنطق مخصص
تشبه خطوات كتابة البيانات باستخدام منطق مخصص تلك الموضحة في قسم Upsert data. عندما تحتاج إلى تطبيق معالجة إضافية قبل الإدراج النهائي لبيانات المصدر في جدول الوجهة، يمكنك تحميل البيانات إلى جدول المراحل ثم استدعاء نشاط الإجراءات المخزنة، أو استدعاء إجراء مخزن في مصارف نشاط النسخ لتطبيق البيانات، أو استخدام Mapping Data Flow.
استدعاء إجراء مخزن من متلقي SQL
عندما تنسخ البيانات إلى قاعدة بيانات Azure SQL، يمكنك أيضا تكوين واستدعاء إجراء مخزن يحدده المستخدم مع معلمات إضافية على كل دفعة من جدول المصدر. تستفيد ميزة الإجراء المخزن من المعلمات ذات القيم الجدولية.
يمكنك استخدام إجراء مُخزن عندما لا تخدم آليات النسخ المضمنة الغرض. مثال على ذلك عندما تريد تطبيق معالجة إضافية قبل الإدراج النهائي لبيانات المصدر في الجدول الوجهة. توجد بعض أمثلة المعالجة الإضافية عندما تريد دمج الأعمدة والبحث عن قيم إضافية وإدراجها في أكثر من جدول.
يوضح المثال التالي كيفية استخدام إجراء مخزن لإجراء رفع مستوى إلى جدول في قاعدة بيانات Azure SQL. افترض أن بيانات الإدخال وجدول Marketing المتلقي تحتوي كل منها على ثلاثة أعمدة: ProfileID، وState، وCategory. قم بإدراج الصفوف أو تحديثها "upsert" استناداً إلى عمود ProfileID، وطبقه فقط لفئة معينة تسمى "ProductA".
في قاعدة البيانات الخاصة بك، قم بتعريف نوع الجدول بنفس اسم sqlWriterTableType. مخطط نوع الجدول هو نفس المخطط الذي تم إرجاعه بواسطة بيانات الإدخال الخاصة بك.
CREATE TYPE [dbo].[MarketingType] AS TABLE(
    [ProfileID] [varchar](256) NOT NULL,
    [State] [varchar](256) NOT NULL,
    [Category] [varchar](256) NOT NULL
)
في قاعدة البيانات الخاصة بك، قم بتعريف الإجراء المُخزن بنفس الاسم مثل sqlWriterStoredProcedureName. يتعامل مع بيانات الإدخال من المصدر المحدد ويدمج في جدول الإخراج. اسم معلمة نوع الجدول في الإجراء المُخزن هو نفسه tableName المُحدد في مجموعة البيانات.
CREATE PROCEDURE spOverwriteMarketing @Marketing [dbo].[MarketingType] READONLY, @category varchar(256)
AS
BEGIN
MERGE [dbo].[Marketing] AS target
USING @Marketing AS source
ON (target.ProfileID = source.ProfileID and target.Category = @category)
WHEN MATCHED THEN
    UPDATE SET State = source.State
WHEN NOT MATCHED THEN
    INSERT (ProfileID, State, Category)
    VALUES (source.ProfileID, source.State, source.Category);
END
في خط أنابيب Azure Data Factory أو Synapse، حدد قسم SQL sink في نشاط النسخ كما يلي:
"sink": {
    "type": "AzureSqlSink",
    "sqlWriterStoredProcedureName": "spOverwriteMarketing",
    "storedProcedureTableTypeParameterName": "Marketing",
    "sqlWriterTableType": "MarketingType",
    "storedProcedureParameters": {
        "category": {
            "value": "ProductA"
        }
    }
}
عند كتابة البيانات إلى قاعدة بيانات Azure SQL باستخدام الإجراء المخزن، يقوم المخزن بتقسيم البيانات المصدرية إلى دفعات صغيرة ثم يقوم بالإدراج، بحيث يمكن تنفيذ الاستعلام الإضافي في الإجراء المخزن عدة مرات. إذا كان لديك الاستعلام لنشاط النسخ ليعمل قبل كتابة البيانات في قاعدة بيانات Azure SQL، فلا ينصح بإضافتها إلى الإجراء المخزن، فإضافته في صندوق pre-copy script.
تعيين خصائص تدفق البيانات
عند تحويل البيانات في رسم خريطة تدفق البيانات، يمكنك القراءة والكتابة إلى جداول من قاعدة بيانات Azure SQL. لمزيد من المعلومات، راجع تحويل المصدر و تحويل المتلقي في تعيين تدفقات البيانات.
تحويل المصدر
الإعدادات الخاصة ب قاعدة بيانات Azure SQL متاحة في تبويب Source Options في تحويل المصدر.
الإدخال حدد ما إذا كنت توجه مصدرك إلى جدول (ما يعادل Select * from <table-name>) أو ستدخل استعلام SQL مخصصًا.
الاستعلام: إذا حددت استعلامًا في حقل الإدخال، فأدخل استعلام SQL لمصدرك. يتجاوز هذا الإعداد أي جدول اخترته في مجموعة البيانات. عبارات Order By غير مدعومة هنا، ولكن يمكنك تعيين جملة SELECT FROM الكاملة. يمكنك أيضاً استخدام وظائف الجدول المعرفة بواسطة المستخدم. select * from udfGetData() هو UDF في SQL يقوم بإرجاع جدول. سينتج هذا الاستعلام جدول مصدر يمكنك استخدامه في تدفق البيانات. يعد استخدام الاستعلامات أيضاً طريقة رائعة لتقليل عدد الصفوف للاختبار أو لعمليات البحث.
تلميح
تعبير الجدول الشائع (CTE) في SQL غير مدعوم في وضع استعلام تدفق بيانات التعيين، لأن الشرط الأساسي لاستخدام هذا الوضع هو أنه يمكن استخدام الاستعلامات في عبارة SQL query FROM ولكن لا يمكن لـ CTEs إجراء ذلك. لاستخدام CTEs، تحتاج إلى إنشاء إجراء مخزّن باستخدام الاستعلام التالي:
CREATE PROC CTESP @query nvarchar(max)
AS
BEGIN
EXECUTE sp_executesql @query;
END
ثم استخدم وضع الإجراء المخزّن في تحويل المصدر لتدفق بيانات التعيين وتعيين @query مثال يشبه with CTE as (select 'test' as a) select * from CTE. ثم يمكنك استخدام CTEs كما هو متوقع.
إجراء مخزّن: حدد هذا الخيار إذا كنت ترغب في إنشاء إسقاط وبيانات مصدر من إجراء مخزن يتم تنفيذه من قاعدة بيانات المصدر. يمكنك كتابة المخطط، واسم الإجراء، والمعلمات، أو النقر فوق "تحديث" لتطلب من الخدمة اكتشاف المخططات وأسماء الإجراءات. ثم يمكنك النقر فوق «استيراد» لاستيراد جميع معلمات الإجراء باستخدام النموذج @paraName.

- مثال SQL:
Select * from MyTable where customerId > 1000 and customerId < 2000 - مثال SQL ذات معلمات:
"select * from {$tablename} where orderyear > {$year}"
حجم الدُفعة: أدخل حجم الدُفعة لتقسيم البيانات الكبيرة إلى قراءات.
مستوى العزل: الإعداد الافتراضي لمصادر SQL في تعيين تدفق البيانات للقراءة غير ملزم. يمكنك تغيير مستوى العزل هنا إلى إحدى هذه القيم:
- تثبيت القراءة
- عدم تثبيت القراءة
- القراءة القابلة للتكرار
- قابل للتسلسل
- لا شيء (تجاهل مستوى العزل)

تمكين الاستخراج التزايدي: استخدم هذا الخيار لإخبار ملف تعريف التطبيق (ADF) بمعالجة الصفوف التي تغيرت منذ آخر مرة تم فيها تنفيذ البنية الأساسية لبرنامج ربط العمليات التجارية فقط. لتمكين الاستخراج التزايدي مع انحراف المخطط، اختر الجداول استنادا إلى أعمدة تزايدية / علامة مائية بدلا من الجداول التي تم تمكينها لالتقاط بيانات التغيير الأصلي.
عمود تزايدي: عند استخدام ميزة الاستخراج التزايدي، يجب اختيار التاريخ/الوقت أو العمود الرقمي الذي ترغب في استخدامه كعلامة مائية في الجدول المصدر.
تمكين التقاط بيانات التغيير الأصلي (معاينة): استخدم هذا الخيار لإخبار ADF بمعالجة بيانات دلتا التي تم التقاطها بواسطة تقنية التقاط بيانات تغيير SQL فقط منذ آخر مرة تم فيها تنفيذ البنية الأساسية لبرنامج ربط العمليات التجارية. باستخدام هذا الخيار، سيتم تحميل بيانات دلتا بما في ذلك إدراج الصف والتحديث والحذف تلقائيا دون الحاجة إلى أي عمود تزايدي. تحتاج إلى تفعيل تغيير التقاط البيانات على قاعدة البيانات Azure SQL قبل استخدام هذا الخيار في ADF. لمزيد من المعلومات حول هذا الخيار في ADF، راجع التقاط بيانات التغيير الأصلي.
بدء القراءة من البداية: سيؤدي تعيين هذا الخيار باستخدام الاستخراج التزايدي إلى توجيه ADF لقراءة جميع الصفوف عند التنفيذ الأول للبنية الأساسية لبرنامج ربط العمليات التجارية مع تشغيل الاستخراج التزايدي.
تحويل المتلقي
الإعدادات الخاصة ب قاعدة بيانات Azure SQL متاحة في تبويب Settings في تحويل الحوض.
طريقة التحديث: تحدد العمليات المسموح بها في وجهة قاعدة البيانات الخاصة بك. الوضع الافتراضي هو السماح فقط بالإدراج. لتحديث الصفوف أو رفعها أو حذفها، يلزم إجراء تحويل الصفوف لوضع علامات على الصفوف لهذه الإجراءات. بالنسبة للتحديثات وعمليات التنشيط والحذف، يجب تعيين عمود أو أعمدة مفتاح لتحديد الصف الذي ستتم إعادة تعديله.

سيتم استخدام اسم العمود الذي تختاره كمفتاح هنا بواسطة الخدمة كجزء من التحديث اللاحق، والتحرير، والحذف. لذلك، يجب اختيار عمود موجود في تعيين "المتلقي". إذا كنت ترغب في عدم كتابة القيمة في عمود المفتاح هذا، فانقر فوق "تخطِ كتابة أعمدة المفاتيح".
يمكنك تمثيل عمود المفتاح المستخدم هنا لتحديث جدول قاعدة بيانات Azure SQL المستهدف. إذا كان لديك عدة أعمدة لمفتاح مركب، فانقر فوق "تعبير مخصص" وستتمكن من إضافة محتوى ديناميكي باستخدام لغة تعبير تدفق البيانات، والتي يمكن أن تتضمن مجموعة من السلاسل بأسماء أعمدة لمفتاح مركب.
إجراء الجدول: يحدد ما إذا كان سيتم إعادة إنشاء أو إزالة كافة الصفوف من الجدول الوجهة قبل الكتابة.
- لا شيء: لن يتم اتخاذ أي إجراء على الطاولة.
- إعادة الإنشاء: سيتم حذف الجدول وإعادة إنشائه. مطلوب في حال إنشاء جدول جديد بشكل ديناميكي.
- الاقتطاع: سيتم إزالة جميع الصفوف من الجدول الهدف.
حجم الدُفعة: يتحكم في عدد الصفوف التي تتم كتابتها في كل مجموعة. تعمل أحجام الدُفعات الأكبر على تحسين الضغط والذاكرة، ولكنها تخاطر بنفاد استثناءات الذاكرة عند تخزين البيانات مؤقتاً.
استخدام TempDB: بشكل افتراضي، ستستخدم الخدمة جدول مؤقت عمومي لتخزين البيانات كجزء من عملية التحميل. يمكنك بدلاً من ذلك إلغاء تحديد الخيار "استخدام TempDB" وبدلاً من ذلك، اطلب من الخدمة تخزين جدول الحجز المؤقت في قاعدة بيانات المستخدم الموجودة في قاعدة البيانات المستخدمة لهذا المتلقي.

نصوص SQL قبل وبعد: أدخل نصوص SQL متعددة الأسطر التي سيتم تنفيذها قبل (المعالجة المسبقة) وبعد (المعالجة اللاحقة) أن تتم كتابة البيانات في قاعدة بيانات المتلقي الخاصة

تلميح
- يوصى بتقسيم البرامج النصية دفعة واحدة مع أوامر مُتعددة إلى دفعات متعددة.
- يمكن فقط تشغيل عبارات لغة تعريف البيانات (DDL) ولغة معالجة البيانات (DML) التي ترجع عدد تحديثات بسيط كجزء مـن دفعة. تعرَّف على المزيد من خلال تنفيذ عمليات الدُفعات
معالجة صف الخطأ
عند الكتابة إلى قاعدة بيانات Azure SQL، قد تفشل بعض صفوف البيانات بسبب القيود التي تحددها الوجهة. تتضمن بعض الأخطاء الشائعة ما يلي:
- سيتم اقتطاع البيانات المتسلسلة أو الثنائية في الجدول
- لا يمكن إدراج القيمة NULL في العمود
- تعارضت عبارة INSERT مع قيد CHECK
بشكل افتراضي، سيفشل تشغيل تدفق البيانات عند حدوث أول خطأ. يمكنك اختيار المتابعة عند ظهور الخطأ الذي يتيح استكمال تدفق البيانات حتى إذا كانت هناك أخطاء في الصفوف الفردية. توفر الخدمة خيارات مختلفة لك للتعامل مع صفوف الأخطاء هذه.
تثبيت المعاملة: اختر ما إذا كانت بياناتك ستتم كتابتها في معاملة واحدة أو على دفعات. ستؤدي المعاملة الفردية إلى أداء أسوأ ولكن لن تكون أي بيانات مكتوبة مرئية للآخرين حتى تكتمل المعاملة.
Output rejected data: إذا كان مفعلا، يمكنك إخراج صفوف الأخطاء في ملف csv في مساحة تخزين Azure Blob أو حساب Azure Data Lake Storage Gen2 من اختيارك. سيؤدي هذا إلى كتابة صفوف الخطأ بثلاثة أعمدة إضافية: عملية SQL مثل INSERT أو UPDATE، ورمز خطأ تدفق البيانات، ورسالة الخطأ في الصف.
الإبلاغ عن خطأ بسبب الخطأ: في حالة التمكين، سيتم تمييز تدفق البيانات كنجاح حتى إذا تم العثور على صفوف خطأ.

Data Type mapping for قاعدة بيانات Azure SQL
عند نسخ البيانات من أو إلى قاعدة بيانات Azure SQL، تستخدم التحويلات التالية من أنواع بيانات قاعدة بيانات Azure SQL إلى أنواع بيانات Azure Data Factory المؤقتة. تستخدم نفس الخرائط في ميزة خط أنابيب Synapse، التي تنفذ Azure Data Factory مباشرة. لمعرفة كيفية تعيين نشاط النسخ لمخطط المصدر ونوع البيانات إلى المتلقي، راجع تعيينات نوع البيانات والمخطط.
| قاعدة بيانات Azure SQL data type | نوع البيانات المؤقتة لمصنع البيانات |
|---|---|
| عدد صحيح كبير | Int64 |
| binary | بايت [] |
| بت | Boolean |
| حرف | سلسلة ، Char [] |
| date | DateTime |
| التاريخ/الوقت | DateTime |
| التاريخ والوقت2 | DateTime |
| Datetimeoffset | DateTimeOffset |
| عدد عشري | عدد عشري |
| FILESTREAM (varbinary (max)) | بايت [] |
| Float | مزدوج |
| صورة | بايت [] |
| العدد الصحيح | Int32 |
| money | عدد عشري |
| nchar | سلسلة ، Char [] |
| ntext | سلسلة ، Char [] |
| عددي | عدد عشري |
| nvarchar | سلسلة ، Char [] |
| real | فردي |
| rowversion | بايت [] |
| smalldatetime | DateTime |
| Smallint | Int16 |
| smallmoney | عدد عشري |
| sql_variant | الكائن |
| النص | سلسلة ، Char [] |
| time | TimeSpan |
| الطابع الزمني | بايت [] |
| Tinyint | بايت |
| uniqueidentifier | Guid |
| varbinary | بايت [] |
| حروف متنوعة | سلسلة ، Char [] |
| xml | السلسلة |
إشعار
بالنسبة لأنواع البيانات التي تتوافق مع النوع العشري المتوسط، يدعم Copy activity حاليا دقة تصل إلى 28. إذا كانت لديك بيانات بدقة أكبر من 28، ففكر في التحويل إلى سلسلة في استعلام SQL.
بحث عن خصائص النشاط
لمعرفة تفاصيل حول الخصائص، تحقق من نشاط البحث.
خصائص نشاط GetMetadata
لمعرفة تفاصيل حول الخصائص، يرجى التحقق من نشاط GetMetadata
باستخدام التشفير دائمًا
عند نسخ البيانات من/إلى قاعدة بيانات Azure SQL باستخدام Always Encrypted، اتبع الخطوات التالية:
تخزين مفتاح العمود الرئيسي column (CMK) في Azure Key Vault. تعرف على المزيد حول كيفية تكوين Always Encrypted باستخدام Azure Key Vault
تأكد من الوصول إلى مخزن المفاتيح حيث يتم تخزين المفتاح الرئيسي للعمود (CMK ). راجع هذه المقالة لمعرفة الأذونات المطلوبة.
قم بإنشاء خدمة مرتبطة للاتصال بقاعدة بيانات SQL الخاصة بك وتمكين وظيفة "التشفير دائماً" باستخدام إما الهوية المدارة أو أساس الخدمة.
إشعار
يدعم قاعدة بيانات Azure SQL Always Encrypted السيناريوهات التالية:
- تستخدم مخازن بيانات المصدر أو مصدر البيانات الهوية المُدارة أو أساس الخدمة كنوع مصادقة مزود رئيسي.
- تستخدم كل من مخازن بيانات المصدر والمخزن هوية مُدارة كنوع مصادقة مزود رئيسي.
- تستخدم كل من مخازن بيانات المصدر والمخزن نفس مبدأ الخدمة مثل نوع مصادقة مزود المفتاح.
إشعار
حاليا، لا يدعم قاعدة بيانات Azure SQL Always Encrypted لتحويل المصارف في تدفقات بيانات الخريط.
التقاط بيانات التغيير الأصلي
يمكن ل Azure Data Factory دعم قدرات التقاط بيانات التغيير الأصلية ل SQL Server و Azure SQL DB و Azure SQL MI. يمكن الكشف عن البيانات التي تم تغييرها بما في ذلك إدراج الصف وتحديثه وحذفه في مخازن SQL تلقائيا واستخراجها بواسطة تدفق بيانات تعيين ADF. مع عدم وجود خبرة في التعليمات البرمجية في تعيين تدفق البيانات، يمكن للمستخدمين بسهولة تحقيق سيناريو النسخ المتماثل للبيانات من مخازن SQL عن طريق إلحاق قاعدة بيانات كمخزن وجهة. ما هو أكثر من ذلك، يمكن للمستخدمين أيضا إنشاء أي منطق تحويل البيانات بين لتحقيق سيناريو ETL تزايدي من مخازن SQL.
تأكد من الاحتفاظ باسم المسار والنشاط دون تغيير، بحيث يمكن تسجيل نقطة التحقق بواسطة ADF للحصول على بيانات تم تغييرها من آخر تشغيل تلقائيًا. إذا قمت بتغيير اسم المسار أو اسم النشاط، فسيتم إعادة تعيين نقطة التحقق، ما يؤدي بك إلى البدء من البداية أو الحصول على تغييرات من الآن في التشغيل التالي. إذا كنت تريد تغيير اسم المسار أو اسم النشاط ولكنك لا تزال تحتفظ بنقطة التحقق للحصول على بيانات تم تغييرها من آخر تشغيل تلقائيا، فيرجى استخدام مفتاح نقطة التحقق الخاص بك في نشاط تدفق البيانات لتحقيق ذلك.
عند تصحيح أخطاء المسار، تعمل هذه الميزة بنفس الطريقة. كن على علم بأنه ستتم إعادة تعيين نقطة التحقق عند تحديث المستعرض الخاص بك أثناء تشغيل التصحيح. بعد أن تكون راضيًا عن نتيجة المسار من تشغيل التصحيح، يمكنك المضي قدمًا للنشر وتشغيل المسار. في اللحظة التي تقوم فيها بتشغيل المسار المنشور لأول مرة، تتم إعادة تشغيله تلقائيًا من البداية أو يحصل على تغييرات من الآن فصاعدًا.
في قسم المراقبة، دائمًا لديك فرصة لإعادة تشغيل المسار. عند القيام بذلك، يتم دائمًا التقاط البيانات التي تم تغييرها من نقطة التحقق السابقة لتشغيل المسار المحدد.
المثال 1:
عند ربط تحويل مصدر مشار إليه مباشرة إلى مجموعة البيانات الممكنة ل SQL CDC مع تحويل متلقي مشار إليه إلى قاعدة بيانات في تدفق بيانات التعيين، سيتم تطبيق التغييرات التي حدثت على مصدر SQL تلقائيا على قاعدة البيانات الهدف، بحيث ستحصل بسهولة على سيناريو النسخ المتماثل للبيانات بين قواعد البيانات. يمكنك استخدام أسلوب التحديث في تحويل المتلقي لتحديد ما إذا كنت تريد السماح بالإدراج أو السماح بالتحديث أو السماح بالحذف في قاعدة البيانات الهدف. البرنامج النصي المثال في تعيين تدفق البيانات كما هو موضح أدناه.
source(output(
		id as integer,
		name as string
	),
	allowSchemaDrift: true,
	validateSchema: false,
	enableNativeCdc: true,
	netChanges: true,
	skipInitialLoad: false,
	isolationLevel: 'READ_UNCOMMITTED',
	format: 'table') ~> source1
source1 sink(allowSchemaDrift: true,
	validateSchema: false,
	deletable:true,
	insertable:true,
	updateable:true,
	upsertable:true,
	keys:['id'],
	format: 'table',
	skipDuplicateMapInputs: true,
	skipDuplicateMapOutputs: true,
	errorHandlingOption: 'stopOnFirstError') ~> sink1
المثال 2:
إذا كنت ترغب في تمكين سيناريو ETL بدلا من النسخ المتماثل للبيانات بين قاعدة البيانات عبر SQL CDC، يمكنك استخدام التعبيرات في تعيين تدفق البيانات بما في ذلك isInsert(1) و isUpdate(1) و isDelete(1) للتمييز بين الصفوف مع أنواع عمليات مختلفة. فيما يلي أحد أمثلة البرامج النصية لتعيين تدفق البيانات على اشتقاق عمود واحد بالقيمة: 1 للإشارة إلى الصفوف المدرجة، و2 للإشارة إلى الصفوف المحدثة و3 للإشارة إلى الصفوف المحذوفة لتحويلات انتقال البيانات من الخادم لمعالجة بيانات دلتا.
source(output(
		id as integer,
		name as string
	),
	allowSchemaDrift: true,
	validateSchema: false,
	enableNativeCdc: true,
	netChanges: true,
	skipInitialLoad: false,
	isolationLevel: 'READ_UNCOMMITTED',
	format: 'table') ~> source1
source1 derive(operationType = iif(isInsert(1), 1, iif(isUpdate(1), 2, 3))) ~> derivedColumn1
derivedColumn1 sink(allowSchemaDrift: true,
	validateSchema: false,
	skipDuplicateMapInputs: true,
	skipDuplicateMapOutputs: true) ~> sink1
القيد المعروف:
- سيتم تحميل التغييرات الصافية فقط من SQL CDC بواسطة ADF عبر cdc.fn_cdc_get_net_changes_.
Upgrade the قاعدة بيانات Azure SQL version
لترقية النسخة قاعدة بيانات Azure SQL، في صفحة Edit linked service، اختر Recommended تحت Version وقم بتكوين الخدمة المرتبطة بالرجوع إلى Linked Service خصائص للإصدار الموصى به.
الاختلافات بين الإصدار الموصى به والإصدار القديم
يوضح الجدول أدناه الفروقات بين قاعدة بيانات Azure SQL باستخدام النسخة الموصى بها والنسخة القديمة.
| إصدار الموصى به | الإصدار القديم |
|---|---|
دعم TLS 1.3 عبر encrypt ك strict. |
TLS 1.3 غير مدعوم. |
المحتوى ذو الصلة
للحصول على قائمة مخازن البيانات المعتمدة كمصادر ومواضع تلقٍّ بواسطة نشاط النسخ، راجع مخازن البيانات المعتمدة والتنسيقات.