Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Note
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Rozšíření AI ve službě Azure AI Vyhledávač odkazuje na integraci s Nástroji Foundry ke zpracování obsahu, který nelze prohledávat v nezpracované podobě. Prostřednictvím obohacení se analýza a odvozování používají k vytvoření prohledávatelného obsahu a struktury, kde dříve neexistoval žádný.
Vzhledem k tomu, že Azure AI Vyhledávač se používá pro textové a vektorové dotazy, účelem rozšiřování AI je zlepšit nástroj vašeho obsahu ve scénářích souvisejících s vyhledáváním. Nezpracovaný obsah musí být text nebo obrázky (vektory nemůžete rozšiřovat), ale výstup z rozšiřovacího kanálu lze vektorizovat a indexovat v indexu vyhledávání pomocí dovedností, jako je dovednost Rozdělení textu pro dělení na části a vkládací dovednost Azure OpenAI pro vektorové kódování. Další informace o používání dovedností ve scénářích vektorů najdete v tématu Integrované bloky dat a vkládání.
Rozšiřování AI je založeno na dovednostech.
Integrované dovednosti klepněte na Nástroje Foundry. Na nezpracovaný obsah používají následující transformace a zpracování:
- Překlad a rozpoznávání jazyka pro vícejazyčné vyhledávání
- Rozpoznávání entit pro extrahování jmen lidí, míst a dalších entit z velkých bloků textu
- Extrakce klíčových frází k identifikaci a výstupu důležitých termínů
- Optické rozpoznávání znaků (OCR) pro rozpoznávání tištěného a ručně psaného textu v binárních souborech.
- Analýza obrázků, která popisuje obsah obrázku a vypíše popisy jako prohledávatelná textová pole.
- Vkládání textu prostřednictvím Azure OpenAI pro integrovanou vektorizaci
- Multimodální vkládání prostřednictvím služby Azure Vision in Foundry Tools pro vektorizaci textu a obrázků
Vlastní schopnosti spouštějí váš externí kód. Vlastní dovednosti můžete použít pro jakékoli vlastní zpracování, které chcete zahrnout do výpočetního řetězce.
Rozšiřování AI je rozšíření kanálu indexeru , který se připojuje ke zdrojům dat Azure. Kanál rozšiřování má všechny komponenty kanálu indexeru (indexer, zdroj dat, index) a sadu dovedností , která určuje kroky atomového rozšiřování.
Následující diagram znázorňuje průběh rozšiřování AI:
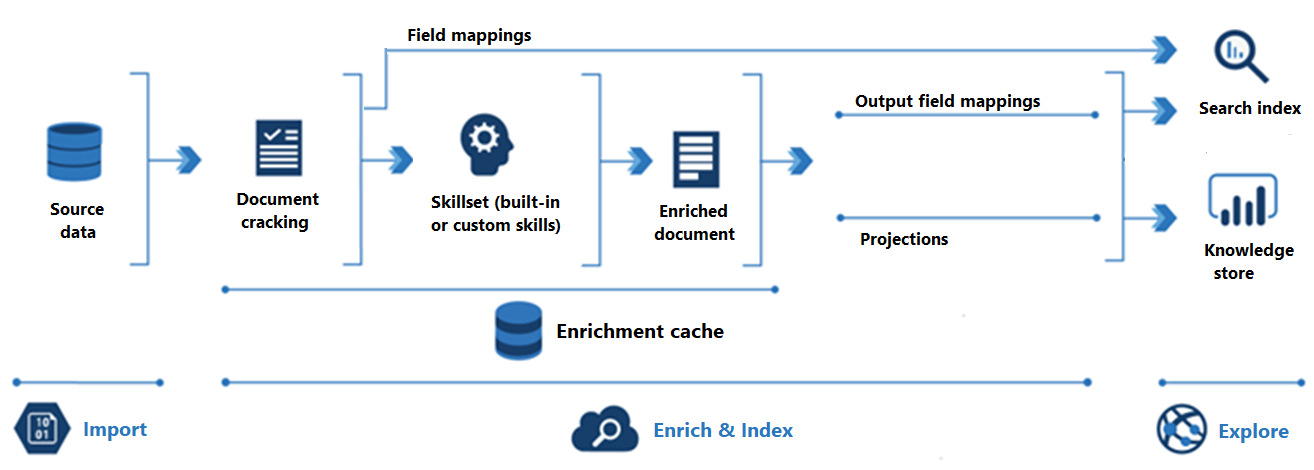
Import je prvním krokem. Indexer se tady připojí ke zdroji dat a načte obsah (dokumenty) do vyhledávací služby. Azure Blob Storage je nejběžnější prostředek používaný ve scénářích rozšiřování AI, ale jakýkoli podporovaný zdroj dat může poskytovat obsah.
Obohacení a index pokrývá většinu procesu obohacování AI:
Obohacení začíná, když indexer zpracovává dokumenty a extrahuje obrázky a text. Typ zpracování, ke kterému dojde dále, závisí na vašich datech a dovednostech, které jste přidali do sady dovedností. Obrázky je možné předat dovednostem, které provádějí zpracování obrázků. Textový obsah je zařazen do fronty pro zpracování textu a přirozeného jazyka. Interně dovednosti vytvářejí obohacený dokument , který shromažďuje transformace při jejich výskytu.
Obohacený obsah se generuje během provádění sady dovedností a je dočasný, pokud ho neuložíte. Cache obohacení můžete povolit, aby se zachovaly výstupy dovedností pro opakované použití při budoucích spuštěních sady dovedností.
Aby se obsah dostal do indexu vyhledávání, musí mít indexer informace o mapování pro odesílání rozšířeného obsahu do cílového pole. Mapování polí (explicitní nebo implicitní) nastavují cestu k datům ze zdrojových dat na index vyhledávání. Mapování výstupních polí nastavují cestu k datům z obohacených dokumentů na index.
Indexování je proces, při kterém se nezpracovaný a obohacený obsah ingestuje do fyzických datových struktur indexu vyhledávání (jeho souborů a složek). V tomto kroku dochází k lexikální analýze a tokenizaci.
Průzkum je posledním krokem. Výstup je vždy vyhledávací index , který můžete dotazovat z klientské aplikace. Výstupem může být úložiště znalostí skládající se z objektů blob a tabulek ve službě Azure Storage, ke kterým se přistupuje prostřednictvím nástrojů pro zkoumání dat nebo podřízených procesů. Pokud vytváříte úložiště znalostí, projekce určují cestu k datům pro obohacený obsah. Stejný obohacený obsah se může objevit jak v indexech, tak v úložištích znalostí.
Kdy použít rozšiřování AI
Rozšiřování je užitečné, pokud je nezpracovaný obsah nestrukturovaný text, obsah obrázku nebo obsah, který potřebuje rozpoznávání a překlad jazyka. Použití umělé inteligence prostřednictvím integrovaných dovedností může tento obsah odemknout pro fulltextové vyhledávání a aplikace pro datové vědy.
Můžete také vytvořit vlastní dovednosti pro zajištění externího zpracování. Opensourcový kód, kód třetí strany nebo kód první strany je možné integrovat do pipeline jako vlastní dovednost. Klasifikační modely, které identifikují určité charakteristiky různých typů dokumentů, spadají do této kategorie, ale všechny externí balíčky, které do vašeho obsahu přidávají hodnotu, je možné použít.
Případy použití pro předdefinované dovednosti
Integrované dovednosti jsou založené na rozhraních API foundry Tools: Azure Vision a Azure Language. Pokud není vstup obsahu malý, očekává se, že připojíte fakturovatelný prostředek Microsoft Foundry ke spouštění větších úloh.
Sada dovedností sestavená pomocí předdefinovaných dovedností je vhodná pro následující scénáře aplikací:
Dovednosti zpracování obrázků zahrnují optické rozpoznávání znaků (OCR) a identifikaci vizuálních funkcí, jako je rozpoznávání obličeje, interpretace obrazu, rozpoznávání obrázků (známé osoby a orientační body) nebo atributy, jako je orientace obrázku. Tyto dovednosti vytvářejí textové reprezentace obsahu obrázků pro fulltextové vyhledávání ve službě Azure AI Vyhledávač.
Strojový překlad poskytuje dovednost překladu textu, často spárovaná s rozpoznáváním jazyka pro řešení s více jazyky.
Zpracování přirozeného jazyka analyzuje bloky textu. Dovednosti v této kategorii zahrnují rozpoznávání entit, detekci mínění (včetně dolování názorů) a rozpoznávání osobních identifikovatelných informací. S těmito dovednostmi se nestrukturovaný text mapuje jako prohledávatelná a filtrovatelná pole v indexu.
Scénáře použití pro personalizované dovednosti
Vlastní dovednosti provádějí externí kód, který poskytnete a zabalíte do webového rozhraní vlastní dovednosti. Několik příkladů vlastních dovedností najdete v úložišti GitHubu azure-search-power-skills .
Dovednosti na míru nejsou vždy složité. Pokud máte například existující balíček, který poskytuje porovnávání vzorů nebo model klasifikace dokumentů, můžete ho zabalit do vlastní dovednosti.
Ukládání výstupu
Ve službě Azure AI Vyhledávač indexer uloží výstup, který vytvoří. Jedno spuštění indexeru může vytvořit až tři datové struktury, které obsahují rozšířené a indexované výstupy.
| Úložiště dat | Required | Location | Description |
|---|---|---|---|
| prohledávatelný index | Required | Search | Používá se pro fulltextové vyhledávání a další formuláře dotazu. Zadání indexu je požadavek indexeru. Obsah indexu se naplní z výstupů dovedností a všechna zdrojová pole mapovaná přímo na pole v indexu. |
| úložiště znalostí | Optional | Azure Storage | Používá se pro podřízené aplikace, jako je dolování znalostí, datové vědy a multimodální vyhledávání. Úložiště znalostí je definováno v sadě dovedností. Její definice určuje, jestli se vaše rozšířené dokumenty promítají jako tabulky nebo objekty (soubory nebo objekty blob) ve službě Azure Storage. V případě scénářů s vícemodálními vyhledáváními můžete ukládat extrahované obrázky do úložiště znalostí a odkazovat na ně v době dotazu, což umožňuje vrácení imagí přímo do klientských aplikací. |
| mezipaměť rozšiřování | Optional | Azure Storage | Používá se k rozšiřování mezipaměti pro opakované použití v následných spuštěních sady dovedností. Mezipaměť ukládá importovaný, nezpracovaný obsah (prolomené dokumenty). Ukládá také rozšířené dokumenty vytvořené během provádění sady dovedností. Ukládání do mezipaměti je užitečné, pokud používáte analýzu obrázků nebo technologii OCR a chcete se vyhnout času a nákladům na opětovné zpracování souborů obrázků. |
Indexy a úložiště znalostí jsou plně nezávislé na sobě. Ačkoli musíte připojit index, který splňuje požadavky indexeru, pokud je vaším jediným cílem úložiště znalostí, můžete index po jeho naplnění ignorovat.
Zkoumání obsahu
Po definování a načtení indexu vyhledávání nebo úložiště znalostí můžete prozkoumat jeho data.
Dotazování indexu vyhledávání
Spusťte dotazy pro přístup k rozšířenému obsahu vygenerovaném kanálem. Index je jako jakýkoli jiný, který byste mohli vytvořit pro Azure AI Vyhledávač: můžete doplnit analýzu textu vlastními analyzátory, vyvolat přibližné vyhledávací dotazy, přidat filtry nebo experimentovat s bodovacími profily za účelem vyladění relevance vyhledávání.
Použití nástrojů pro zkoumání dat ve znalostním úložišti
Úložiště znalostí ve službě Azure Storage může předpokládat následující formy: kontejner objektů blob dokumentů JSON, kontejner objektů blob objektů obrázků nebo tabulky ve službě Table Storage. K přístupu k obsahu můžete použít Průzkumník služby Storage, Power BI nebo libovolnou aplikaci, která se připojuje ke službě Azure Storage.
Kontejner blobů zachycuje obohacené dokumenty v celém rozsahu, což je užitečné, pokud vytváříte kanál do jiných procesů.
Tabulka je užitečná, pokud potřebujete řezy obohacených dokumentů nebo pokud chcete zahrnout nebo vyloučit konkrétní části výstupu. Pro analýzu v Power BI jsou tabulky doporučeným zdrojem dat pro zkoumání a vizualizaci dat v Power BI.
Dostupnost a ceny
Rozšíření AI je dostupné v oblastech, které nabízejí Foundry Tools. Pokud chcete zkontrolovat dostupnost rozšiřování AI, podívejte se na seznam oblastí.
Fakturace se řídí cenovým modelem Standard. Náklady spojené s integrovanými dovednostmi se účtují, když v sadě dovedností zadáte prostředek Azure OpenAI v modelu Foundry nebo klíč prostředku Foundry. K extrakci obrázků jsou spojené také náklady, které se měří službou Azure AI Vyhledávač. Extrakce textu a pomocné dovednosti ale nejsou fakturovatelné. Další informace najdete v tématu Plán a správa nákladů na službu Azure AI Vyhledávač.
Kontrolní seznam: Typický pracovní postup
Obohacovací mechanismus se skládá z indexačních nástrojů, které mají sady dovedností. Po indexování můžete zadat dotaz na index, abyste ověřili výsledky.
Začněte podmnožinou dat v podporovaném zdroji dat. Návrh indexeru a sady dovedností je iterativní proces. Práce probíhá rychleji s malou reprezentativní sadou dat.
Vytvořte zdroj dat, který určuje připojení k vašim datům.
Vytvořte sadu dovedností. Pokud není projekt malý, měli byste připojit zdroj Foundry. Pokud vytváříte úložiště znalostí, definujte ho v sadě dovedností.
Vytvořte schéma indexu, které definuje index vyhledávání.
Vytvořte a spusťte indexer , aby se všechny předchozí komponenty spojily. Tento krok načte data, spustí sadu dovedností a načte index.
Indexer je také místo, kde zadáte mapování polí a mapování výstupních polí, která nastaví cestu k datům indexu vyhledávání.
Volitelně můžete povolit ukládání obohacení do mezipaměti v konfiguraci indexeru. Tento krok umožňuje později znovu použít existující obohacení.
Spuštěním dotazů vyhodnoťte výsledky nebo spusťte ladicí relaci a projděte si případné problémy se sadou dovedností.
Pokud chcete zopakovat některý z předchozích kroků, před spuštěním indexeru ho resetujte . Můžete také odstranit a znovu vytvořit objekty při každém spuštění (doporučujeme, pokud používáte úroveň Free). Pokud jste povolili ukládání do mezipaměti, indexer se stáhne z mezipaměti, pokud se zdrojová data nezmění a pokud vaše úpravy kanálu nebudou zneplatnit mezipaměť.
Související obsah
- Rychlý start: Vytvoření sady dovedností na webu Azure Portal
- Příručka: Sady dovedností ve službě Azure AI Vyhledávač
- koncepty sady dovedností ve službě Azure AI Vyhledávač
- Úložiště znalostí v Azure AI Vyhledávač
- Vytvoření sady dovedností ve službě Azure AI Vyhledávač
- Vytvoření úložiště znalostí pomocí REST