Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Foundry IQ (Recherche Azure AI) est un service de recherche entièrement managé qui indexe le contenu et prend en charge la récupération par le biais d’API, d’applications et d’agents IA. Il convient aux scénarios de recherche d’entreprise et aux expériences client basées sur l’IA qui nécessitent une génération de contenu dynamique par le biais de modèles d’achèvement de conversation. En tant que service Azure, Foundry IQ fournit une gamme de fonctionnalités pour prendre en charge vos exigences de fiabilité.
Lorsque vous utilisez Azure, la fiabilité est une responsabilité partagée. Microsoft offre une gamme de fonctionnalités permettant de prendre en charge la résilience et la récupération. Vous êtes responsable de comprendre le fonctionnement de ces fonctionnalités dans tous les services que vous utilisez et de sélectionner les fonctionnalités dont vous avez besoin pour atteindre vos objectifs métier et vos objectifs de temps d’activité.
Cet article décrit comment Foundry IQ gère les erreurs temporaires, les défaillances de zone de disponibilité, les défaillances à l’échelle de la région et la maintenance du service. Il décrit également les options de sauvegarde et de restauration et les exigences de configuration pour le contrat de niveau de service Foundry IQ (SLA).
Recommandations de déploiement de production pour la fiabilité
Pour les charges de travail de production, nous vous recommandons de :
Utilisez un niveau facturable. N’utilisez pas le niveau Free, qui ne fournit pas de SLA.
Si vous utilisez le modèle tarifaire Dédié, configurez au moins deux réplicas pour les charges de travail en lecture seule, ou au moins trois réplicas pour les charges de travail en lecture-écriture. Plusieurs réplicas améliorent la résilience aux erreurs temporaires et à la maintenance du service et répondent aux exigences du contrat SLA applicables.
Déployez votre service de recherche dans une région qui prend en charge les zones de disponibilité, afin que Foundry IQ puisse distribuer la capacité entre les zones.
Vue d’ensemble de l’architecture de fiabilité
Lorsque vous utilisez Foundry IQ, vous créez un service de recherche. Chaque service de recherche prend en charge de nombreux index de recherche qui stockent votre contenu utilisable dans une recherche.
Foundry IQ n’est pas conçu comme magasin de données principal. Vous remplissez des index de recherche en envoyant (push) des documents à partir de votre application ou à l’aide d’indexeurs, qui récupèrent du contenu à partir de sources de données externes prises en charge. Les indexeurs peuvent appeler des compétences pour traiter et enrichir du contenu avant de l’ajouter à un index.
Foundry IQ propose deux modèles tarifaires, Dedicated et Serverless. Les deux fournissent les mêmes fonctionnalités de recherche principales, mais gèrent la capacité différemment.
Modèle de tarification dédié
Dans le modèle tarifaire dédié, vous sélectionnez un niveau de service et configurez les réplicas et les partitions de votre service. Vous êtes responsable de prévoir une capacité suffisante pour votre charge de travail. Chaque réplica contient une copie des données d’index sur laquelle le moteur de recherche effectue les recherches. Chaque réplica représente une seule machine virtuelle. Les services de base prennent en charge jusqu’à trois réplicas. Les services standard et optimisés pour le stockage prennent en charge jusqu’à 12 réplicas. Pour plus d’informations, consultez Limites de service dans Foundry IQ.
L’ajout de plusieurs réplicas permet à Foundry IQ de :
Augmentez la disponibilité du service de recherche.
Effectuez une maintenance sur un réplica pendant que les requêtes continuent à s’exécuter sur d’autres réplicas.
Gérez un débit plus élevé des charges de travail d’indexation et de requête.
Améliorez la résilience en tentant de provisionner des réplicas dans différentes zones de disponibilité, si la région les prend en charge.
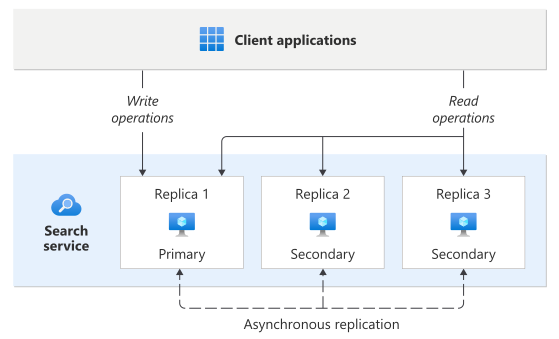
Foundry IQ désigne automatiquement un réplica pour être le réplica principal. Toutes les opérations en écriture sont effectuées sur ce réplica. Les autres réplicas sont utilisés pour les opérations en lecture.
Le diagramme suivant illustre la façon dont un service de recherche avec trois réplicas est susceptible d’être réparti sur trois zones de disponibilité :
Vous pouvez également configurer le nombre de partitions, qui représentent le stockage utilisé par les index de recherche.
Il est important de comprendre l’impact de l’ajout de répliques et de partitions, car ils affectent respectivement les performances de lecture et d’écriture de différentes manières. Pour découvrir plus d’informations sur les réplicas et les partitions, consultez Estimer et gérer la capacité d’un service de recherche.
Modèle de tarification sans serveur
Lorsque vous utilisez le modèle de tarification Serverless, vous n’avez pas besoin de configurer des réplicas ou des partitions. Foundry IQ gère la capacité pour vous en fonction du volume de requêtes, de l’activité d’indexation et de la complexité de la charge de travail. Les fonctionnalités de fiabilité de cet article, telles que la redondance de zone, s’appliquent également aux services serverless. Les conseils sur le nombre de réplicas et de partitions s’appliquent uniquement aux services dédiés.
Dependencies
Selon les fonctionnalités que vous utilisez, votre service de recherche peut nécessiter d’autres ressources et modèles. Une défaillance dans une dépendance peut affecter l’indexation ou les requêtes même lorsque votre service de recherche est sain. Vous êtes responsable de la configuration et de la gestion des ressources et des points de terminaison que vous fournissez. Microsoft gère l’infrastructure sous-jacente pour les services Azure et les modèles que Foundry IQ héberge.
Sources de données : Les indexeurs récupèrent du contenu à partir de sources de données externes. Vous avez également besoin de vos données sources pour reconstruire un index.
Compétences et modèles que vous configurez : Les compétences peuvent appeler des services externes, des déploiements de modèles ou des API web que vous hébergez pour effectuer l’enrichissement par IA pendant l’indexation. Les requêtes peuvent également dépendre des modèles que vous configurez. Par exemple, la récupération agentique, qui combine les résultats de plusieurs requêtes, peut utiliser un modèle pour la planification des requêtes et la génération de réponses.
Un vectoriseur appelle un modèle d’embeddings que vous configurez pour convertir l’entrée de requête en vecteurs. Si le vectoriseur ne peut pas obtenir de réponse du modèle après nouvelles tentatives, la requête entière échoue, y compris les requêtes hybrides. Foundry IQ ne revient pas automatiquement aux résultats par mot clé uniquement.
stockage Azure : certaines fonctionnalités facultatives écrivent des données dans un compte de stockage que vous fournissez. Un cache d’enrichissement (version préliminaire) stocke le contenu traité pour la réutilisation entre les exécutions d’indexation. Un knowledge store enregistre le contenu enrichi dans des tables ou des objets blob pour que d’autres applications puissent l’utiliser. Vous êtes responsable de la configuration des fonctionnalités de fiabilité du compte de stockage. Pour plus d’informations, consultez Fiabilité dans Stockage Blob Azure et Fiabilité dans Azure Table Storage.
Modèles hébergés par Microsoft :le réordonnancement sémantique réordonne les résultats de recherche, et la réécriture de requête (préversion) génère d’autres requêtes. Les deux fonctionnalités utilisent des modèles que Microsoft héberge et gère.
Par défaut, le classement sémantique retourne des résultats partiels si son modèle n’est pas disponible. Vous pouvez configurer à la place les requêtes pour qu’elles échouent. Si la réécriture de requête n’est pas disponible, Foundry IQ utilise le texte de requête d’origine.
Résilience aux erreurs temporaires
Les erreurs temporaires sont des défaillances courtes et intermittentes dans les composants. Elles se produisent fréquemment dans un environnement distribué comme le cloud, et font partie intégrante des opérations ordinaires. Les erreurs temporaires se corrigent après une courte période de temps. Il est important que vos applications puissent gérer les erreurs temporaires, généralement en réessayant les requêtes affectées.
Toutes les applications hébergées dans le cloud doivent suivre les instructions de gestion des erreurs temporaires Azure lorsqu’elles communiquent avec toutes les API, bases de données et autres composants hébergés dans le cloud. Pour plus d’informations, voir Recommandations concernant le traitement des pannes transitoires.
Les services de recherche peuvent rencontrer des erreurs temporaires pendant les opérations de maintenance. Pour plus d’informations, consultez Résilience à la maintenance du service. Des erreurs temporaires peuvent également se produire lorsque le service de recherche indexe ou lorsque votre application interroge l’index.
Les indexeurs Foundry IQ ont une gestion intégrée des erreurs temporaires. Si une source de données n’est pas disponible brièvement, l’indexeur est conçu pour récupérer et réessayer. Il utilise le suivi des modifications pour reprendre l’indexation à partir du dernier document indexé avec succès.
Si vous créez des applications qui interagissent avec Foundry IQ, elles doivent gérer les erreurs temporaires. Utilisez une stratégie de nouvelle tentative avec temporisation exponentielle pour les opérations de lecture et d’écriture.
Résilience aux échecs de zone de disponibilité
Les zones de disponibilité sont des groupes physiquement distincts de centres de données au sein d’une région Azure. Lorsqu'une zone tombe en panne, les services peuvent basculer vers l'une des zones restantes.
Lorsque votre service de recherche répond aux exigences, Foundry IQ est redondant interzone ; il distribue la capacité entre plusieurs zones de disponibilité dans la région de service de recherche.
Le comportement de la zone de disponibilité décrit dans cette section s’applique aux services dédiés et serverless, mais la configuration est différente :
Pour les services serverless : Foundry IQ gère les réplicas pour vous. Chaque service serverless fournit un contrat SLA en lecture-écriture, car il repose sur l’équivalent de trois réplicas.
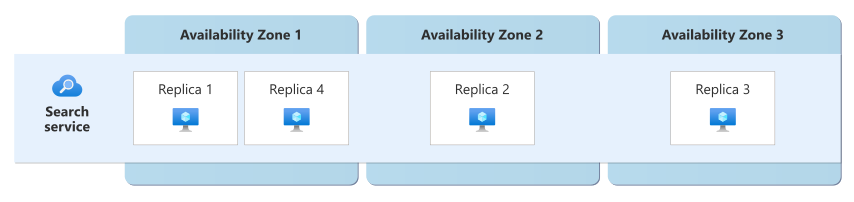
Pour les services dédiés : Lorsque vous ajoutez deux réplicas ou plus, Foundry IQ tente de placer chaque réplica dans une zone de disponibilité différente. Pour les services qui ont plus de réplicas que de zones disponibles, les réplicas sont répartis aussi uniformément que possible sur les zones.
Le diagramme suivant montre un exemple de service de recherche avec quatre réplicas susceptibles d’être déployés sur trois zones de disponibilité :
Si votre service dédié ne répond pas à ces exigences, il n’est pas redondant interzone. Par exemple, un service dédié avec un réplica peut devenir indisponible si la zone de disponibilité qui héberge ce réplica a une panne.
Important
Foundry IQ ne garantit pas l’emplacement exact des réplicas. Le placement est soumis à des contraintes de capacité, à des opérations de mise à l’échelle et à d’autres facteurs.
Spécifications
La redondance de zone est automatiquement activée lorsque votre service de recherche répond à l’ensemble des critères suivants :
Prise en charge des régions : La prise en charge des zones de disponibilité dépend de l’infrastructure et du stockage. Pour obtenir la liste des régions prises en charge, consultez Choisir une région pour Foundry IQ.
Niveau : Pour le modèle de tarification dédié, utilisez le niveau de base ou version ultérieure.
Pour le modèle de tarification Serverless, Foundry IQ gère la redondance de zone pour vous.
Nombre de réplicas : Pour le modèle de tarification dédié, utilisez au moins deux réplicas.
Pour le modèle de tarification Serverless, Foundry IQ gère les réplicas pour vous.
Note
Pour les services dédiés, Foundry IQ tente de distribuer des réplicas entre plusieurs zones lorsque vous avez deux réplicas ou plus. Toutefois, vous avez besoin d’au moins trois réplicas pour recevoir un contrat SLA en lecture-écriture. Les services serverless n’utilisent pas le nombre de réplicas et chaque service serverless bénéficie d’un SLA de lecture-écriture pendant sa durée de vie. Pour plus d’informations, consultez contrat de niveau de service.
Distribution d’instances entre zones
Pour le modèle de tarification dédié, Foundry IQ tente de placer des réplicas dans différentes zones de disponibilité. Cependant, il existe parfois des situations où tous les réplicas d’un service de recherche peuvent être placés dans la même zone de disponibilité. Cette situation peut se produire lorsque des réplicas sont supprimés de votre service, par exemple lorsque vous effectuez un scale-in en configurant votre service pour utiliser moins de réplicas. La suppression de réplicas ne déclenche pas le rééquilibrage des réplicas restants entre les zones de disponibilité.
Si vous souhaitez réduire la probabilité que tous vos réplicas soient placés dans une seule zone de disponibilité, vous pouvez déclencher manuellement une opération de scale-out immédiatement après une opération de scale-in. Par exemple, supposons que votre service de recherche dispose de 10 réplicas et que vous souhaitiez effectuer un scale-in vers 7 réplicas. Au lieu d’effectuer une opération de mise à l’échelle unique, vous pouvez effectuer temporairement une mise à l’échelle vers 6 réplicas, puis mettre immédiatement à l’échelle 7 réplicas pour déclencher le rééquilibrage de zone.
Cost
Chaque service de recherche dédié commence par un réplica. La redondance de zone nécessite deux réplicas ou plus, ce qui augmente le coût d’exécution du service. Pour comprendre les implications des répliques sur la facturation, utilisez le calculateur de prix.
Avec le modèle de tarification Serverless, vous n’avez pas besoin de mettre à l’échelle votre service pour obtenir la redondance de zone. La redondance de zone et le contrat SLA sont inclus. Vous payez des frais basés sur la consommation pour le calcul et le stockage.
Configurez la prise en charge des zones de disponibilité
Si votre service de recherche répond aux exigences de redondance de zone, aucune configuration supplémentaire n’est nécessaire. Dans la mesure du possible, Foundry IQ tente de placer vos réplicas dans différentes zones de disponibilité.
Planification de capacité et gestion
Si vous utilisez le modèle tarifaire dédié, préparez-vous à une défaillance de zone de disponibilité en envisageant d’augmenter le nombre de réplicas. Le surprovisionnement permet au service de recherche de tolérer une perte de capacité et de continuer à fonctionner sans dégradation des performances. L’ajout de réplicas pendant une panne est difficile. Par conséquent, le surapprovisionnement permet de s’assurer que votre service de recherche peut gérer des volumes de requêtes normaux, même avec une capacité réduite. Pour plus d’informations, consultez Gérer la capacité en surprovisionnant.
Avec le modèle de tarification Serverless, vous n’avez pas besoin de planifier le surprovisionnement. La facturation serverless est basée sur votre utilisation. Foundry IQ gère la capacité en arrière-plan pour répondre à vos besoins.
Comportement lorsque toutes les zones sont saines
Cette section décrit ce à quoi s’attendre lorsque les services de recherche sont configurés pour la redondance de zone et que toutes les zones de disponibilité sont opérationnelles.
Opération interzone : Foundry IQ équilibre automatiquement les requêtes entre les réplicas disponibles. Il peut envoyer des opérations de lecture à n’importe quel réplica dans n’importe quelle zone de disponibilité. Il envoie des opérations d’écriture à un seul réplica principal sélectionné par le service Foundry IQ.
Réplication des données interzones : Les modifications apportées aux données sont automatiquement répliquées entre les réplicas entre les zones de disponibilité. La réplication se produit de manière asynchrone, ce qui signifie que les écritures sont validées sur un réplica principal avant qu’elles ne soient répliquées vers d’autres réplicas.
Comportement lors d’une défaillance de zone
Cette section décrit ce à quoi s’attendre lorsque les services de recherche sont configurés pour la redondance de zone et qu’une panne de zone de disponibilité se produit.
- Détection et réponse : Foundry IQ est responsable de la détection d’une défaillance dans une zone de disponibilité. Vous n’avez rien à faire pour initier un failover de zone.
- Notification : Microsoft ne vous avertit pas automatiquement lorsqu'une zone est en panne. Toutefois, vous pouvez utiliser Azure Resource Health pour surveiller l’intégrité d’une ressource individuelle, et vous pouvez configurer des alertes Resource Health pour vous avertir des problèmes. Vous pouvez également utiliser Azure Service Health pour comprendre l’intégrité globale du service, y compris les défaillances de zone, et vous pouvez configurer des alertes Service Health pour vous avertir des problèmes.
Demandes actives : Les demandes que les réplicas traitent dans la zone ayant échoué sont arrêtées. Les clients doivent réessayer les demandes en suivant les instructions pour gérer les erreurs temporaires.
Perte de données attendue : Si la zone de disponibilité affectée contient uniquement des réplicas en lecture, aucune perte de données n’est attendue.
Si le réplica principal est perdu car il se trouvait dans la zone affectée, il est possible que toutes les opérations en écriture qui n’ont pas encore été répliquées soient perdues.
Temps d’arrêt attendu : Dans la plupart des cas, une défaillance de zone n’est pas censée provoquer un temps d’arrêt pour votre service de recherche pour les opérations de lecture, car les réplicas en lecture dans d’autres zones de disponibilité continuent de traiter les demandes.
Si le réplica principal est perdu parce qu’il était dans la zone affectée, Foundry IQ promeut automatiquement un autre réplica pour devenir le nouveau réplica principal afin que les opérations d’écriture puissent reprendre. La promotion du réplica prend généralement quelques secondes. Pendant ce temps, les opérations d’écriture peuvent ne pas réussir. Assurez-vous que vos applications sont préparées en suivant l’Guide de gestion des erreurs temporaires.
Toutefois, il existe des situations peu probables où tous les réplicas de votre service de recherche peuvent se trouver dans une seule zone de disponibilité. Dans ce scénario, vous pouvez rencontrer des temps d’arrêt jusqu’à ce que la zone récupère. Pour découvrir plus d’informations et comprendre une solution de contournement, consultez Distribution d’instance.
Redistribution : Lorsqu’une zone échoue, Foundry IQ détecte l’échec et achemine les demandes vers des réplicas actifs dans les zones survivantes. Si la réplique principale est perdue, une autre réplique est promue et devient la nouvelle réplique principale.
Récupération de la zone
Lorsque la zone de disponibilité récupère, Foundry IQ restaure automatiquement les opérations normales et commence à router le trafic vers les réplicas disponibles dans les zones utilisées par le service, y compris la zone récupérée.
Tester les pannes de zone
Foundry IQ gère le routage du trafic pour les services redondants entre zones. Vous n’avez pas besoin d’initier ou de valider des processus d’échec de zone.
Résilience aux défaillances à l’échelle de la région
Foundry IQ est un service à région unique. Si la région devient indisponible, votre service de recherche devient également indisponible.
Solutions multirégions personnalisées pour la résilience
Vous pouvez déployer plusieurs services Foundry IQ dans différentes régions pour améliorer la résilience aux défaillances à l’échelle de la région. Foundry IQ ne réplique pas automatiquement les index et n’effectue pas de basculement entre les régions.
Vous êtes responsable du déploiement et de la configuration des services, de la synchronisation de leurs index et de la configuration des stratégies de routage et de basculement des demandes. Planifiez la capacité dans la région secondaire avant une panne. Les contraintes de capacité régionale peuvent vous empêcher de créer un service quand vous en avez besoin. Pour plus d’informations, consultez Planifier les déploiements de Foundry IQ dans des régions à forte demande.
Si vous souhaitez optimiser les performances de votre solution globale, recherchez des opportunités d’indexation sur des réplicas en lecture seule de vos sources de données. Par exemple, certains indexeurs prennent en charge la lecture à partir des réplicas en lecture d’une source de données géo-distribuée.
Pour plus d’informations, consultez Déploiements multirégions dans Foundry IQ.
Sauvegarde et restauration
Étant donné que Foundry IQ n’est pas une solution de stockage de données principale, elle ne fournit pas d’options de sauvegarde et de restauration en libre-service. Toutefois, vous pouvez utiliser l’exemple index-backup-restore pour .NET ou Python pour sauvegarder votre définition d’index et ses documents dans une série de fichiers JSON, qui sont ensuite utilisés pour restaurer l’index. Passez en revue les conditions préalables et limitations de chaque exemple, puis testez la restauration d’un index exporté avant de l’utiliser pour la récupération.
La suppression d’un index est irréversible. Si vous supprimez accidentellement un index et que vous n’avez pas de sauvegarde, vous pouvez reconstruire l’index. La reconstruction implique de recréer l’index sur votre service de recherche, puis de le recharger en récupérant des données à partir de votre magasin de données principal. Vous avez besoin des données sources d’origine pour reconstruire l’index.
Pour empêcher la suppression accidentelle de votre service de recherche, vous pouvez appliquer un verrou de suppression de ressource. Le verrou protège la ressource du service de recherche, mais il ne protège pas les index individuels ou les documents indexés contre la suppression.
Résilience à la maintenance du service
Les services de recherche peuvent rencontrer des erreurs temporaires pendant les opérations de maintenance standard et non planifiées. Foundry IQ ne fournit pas de notification préalable et n’autorise pas la planification de la maintenance à des moments spécifiques. Bien que tous les efforts soient déployés pour réduire les temps d’arrêt, même pour les services à réplica unique, de brèves interruptions peuvent toujours se produire.
Vos applications doivent également suivre les instructions pour gérer les erreurs temporaires.
Pour le modèle de tarification dédié, certaines opérations que vous lancez affectent également votre service :
Mises à niveau de service : Avec deux réplicas ou plus, votre service reste disponible pendant une mise à niveau du service tandis qu’un réplica est mis à jour.
Changements de niveau tarifaire et de mise à l’échelle : Les modifications prises en charge des nombres de réplicas, des nombres de partitions et des niveaux tarifaires s’exécutent en arrière-plan. Votre service reste disponible pour les opérations de lecture et d’écriture. Ces opérations peuvent prendre plusieurs heures et vous ne pouvez pas les annuler. Pour plus d’informations, consultez Gérer et ajuster la capacité.
Contrat de niveau de service
Le contrat de niveau de service (SLA) pour les services Azure décrit la disponibilité attendue de chaque service et les conditions que votre solution doit respecter pour atteindre cette attente de disponibilité. Pour plus d’informations, consultez les SLA pour les services en ligne.
Foundry IQ ne fournit pas de contrat SLA de disponibilité pour le niveau Gratuit.
Pour les services facturables, les exigences du contrat SLA dépendent du modèle de tarification :
- Modèle tarifaire dédié : Configurez au moins deux réplicas pour un contrat SLA de lecture (requêtes) ou au moins trois réplicas pour un contrat SLA en lecture-écriture (requêtes et indexation).
- Modèle de tarification serverless : Chaque service dispose d’un contrat SLA en lecture-écriture pour sa durée de vie. Vous n’avez pas besoin de configurer des réplicas.