Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Microsoft Fabric menyediakan beberapa cara untuk membawa data ke lingkungan analitik Anda. Baik Anda perlu memproses peristiwa streaming secara real time, mereplikasi database operasional, mengatur alur batch, atau mengakses data tanpa menyalinnya, Fabric menawarkan kemampuan bawaan untuk mendukung setiap skenario. Fabric juga mendukung pola berbagi data yang diatur melalui OneLake, memungkinkan akses lintas penyewa dan lintas ruang kerja ke himpunan data langsung tanpa duplikasi.
Artikel ini menjelaskan opsi penyerapan data utama dan pergerakan data di Fabric. Ini mencakup:
- Pemasukan data real-time dengan Eventstreams dan Eventhouse
- Orkestrasi batch dengan pipelines Data Factory dan proses Penyalinan
- Replikasi hampir secara real-time dengan Mirroring
- Virtualisasi data dengan pintasan OneLake
Gunakan gambaran umum ini untuk memahami cara kerja setiap pendekatan dan memilih strategi yang paling sesuai dengan persyaratan beban kerja Anda untuk latensi, transformasi, dan kompleksitas operasional.
Pengambilan data waktu nyata
Item Eventstreams dan Eventhouse dalam beban kerja Real-Time Intelligence mendukung skenario data streaming. Eventstreams menyerap dan memproses peristiwa real-time, dan Eventhouses menyimpan dan mengkueri peristiwa tersebut dalam skala besar. Anda biasanya menggunakan Eventstream untuk mengambil dan merutekan data ke Eventhouse. Anda juga dapat menggunakan setiap kemampuan secara independen berdasarkan kebutuhan Anda. Diagram berikut menunjukkan bagaimana himpunan data real-time mengalir ke Eventstream dan Eventhouse di Fabric:
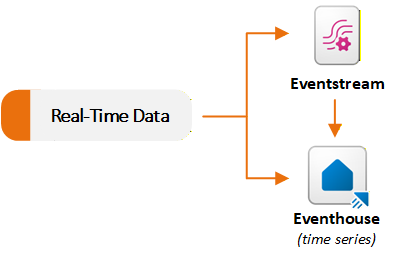
Menyerap dan merutekan peristiwa dengan Eventstream
Eventstream memberikan pengalaman tanpa kode untuk menyerap peristiwa ke Fabric, menerapkan transformasi in-stream, dan merutekan data ke beberapa tujuan. Eventstream bertindak sebagai pipa pengambilan data real-time. Anda membuat Eventstream dan menambahkan satu atau beberapa konektor sumber. Fabric mendukung banyak sumber streaming, termasuk peristiwa Fabric internal seperti peristiwa ruang kerja Fabric, peristiwa file OneLake, dan peristiwa pekerjaan pipeline.
Setelah acara mulai mengalir, Anda dapat menerapkan transformasi opsional real-time melalui editor tarik dan jatuhkan. Misalnya, Anda dapat memfilter peristiwa, menghitung agregat jendela waktu, menggabungkan beberapa aliran, atau membentuk ulang bidang tanpa menulis kode.
Anda dapat mengirim aliran yang diproses ke satu atau beberapa tujuan yang didukung. Eventstreams dapat mengekspos titik akhir Apache Kafka melalui sumber dan tujuan titik akhir kustom. Kemampuan ini memungkinkan produsen Kafka melakukan streaming peristiwa ke dalam Fabric dan konsumen Kafka mengonsumsi peristiwa dari Fabric.
Eventstreams tidak menyimpan data secara permanen. Mereka mengalirkan peristiwa melalui memori dan meneruskannya ke tujuan yang dikonfigurasi. Desain ini membuat Eventstreams cocok untuk skenario ekstrak real time, transformasi, pemuatan (ETL) dan untuk mendistribusikan data streaming ke beberapa target. Misalnya, Anda dapat menyerap telemetri dari sensor Internet of Things (IoT), memfilter dan mengagregasi data secara real time, mengirim aliran yang disempurnakan ke Eventhouse untuk analitik, dan merutekan peristiwa anomali ke Aktivator untuk pemberitahuan.
Menyerap data langsung ke Eventhouse
Eventhouse dapat menyerap data langsung dari beberapa sumber. Fabric menyertakan fitur terintegrasi Pengambilan data dalam Eventhouse. Wizard tersambung ke sumber seperti file lokal, Azure Storage, Amazon S3, Azure Event Hubs, dan OneLake. Anda dapat memuat data ke dalam tabel database Kusto Query Language (KQL) secara real time atau mode batch dengan menggunakan antarmuka pengguna Eventhouse.
Anda juga dapat memilih Eventstream yang ada di Fabric sebagai sumber. Misalnya, jika Anda menggunakan Eventstream yang menyerap data dari IoT Hub atau Kafka, Anda dapat merutekan outputnya langsung ke tabel database KQL tanpa konfigurasi tambahan.
Penyerapan data batch
Data Factory memberikan pengalaman utama untuk alur ekstrak, transformasi, pemuatan (ETL) dan ekstrak, muat, transformasi (ELT) tradisional. Ini termasuk pustaka konektor besar. Fabric Data Factory menyediakan daftar konektor asli untuk penyimpanan data lokal dan cloud, termasuk database, aplikasi perangkat lunak sebagai layanan (SaaS), dan sistem berbasis file. Konektor ini membantu Anda terhubung ke hampir semua sistem sumber.
Mengatur pergerakan data dengan alur
Anda dapat membangun alur yang menggunakan konektor ini untuk menyalin atau memindahkan data ke OneLake atau penyimpanan analitis. Pendekatan ini mendukung:
- Himpunan data yang tidak terstruktur seperti gambar, video, dan audio
- Himpunan data semi-terstruktur seperti JSON, CSV, dan XML
- Himpunan data terstruktur dari sistem database relasional yang didukung
Dalam alur, Anda menggabungkan beberapa komponen orkestrasi, termasuk:
- Aktivitas pemindahan data, seperti Menyalin data dan Menyalin tugas
- Aktivitas transformasi data, seperti Dataflow Gen2, Menghapus data, Fabric Notebook, dan skrip SQL
- Aktivitas alur kontrol, seperti ForEach, Pencarian, Atur Variabel, dan Webhook
Anda dapat menjalankan alur sesuai permintaan, sesuai jadwal, atau sebagai respons terhadap peristiwa. Misalnya, Anda dapat menjadwalkan alur untuk berjalan setiap dua jam selama hari kerja atau memicunya saat file baru dibuat di OneLake.
Menyederhanakan pergerakan data dengan tugas penyalinan
Pekerjaan salin mendukung beberapa pola pengiriman data, termasuk salinan massal, salinan bertahap, dan replikasi CDC (penangkapan perubahan data). Anda dapat menggunakan tugas salin data untuk memindahkan data dari sumber ke OneLake tanpa membuat pipeline, sementara tetap menyediakan akses ke opsi konfigurasi lanjutan. Pekerjaan salin mendukung banyak sumber dan tujuan. Ini menawarkan lebih banyak kontrol daripada Mirroring dan kompleksitas operasional yang lebih sedikit daripada mengelola alur yang menggunakan aktivitas Copy.
Mereplikasi data dengan Mirroring
Pencerminan mereplikasi data dari sistem eksternal ke Fabric dalam hampir real-time dengan pengaturan otomatis. Anda tersambung ke sistem eksternal, seperti Azure SQL Database, SQL Server, Oracle, SAP, atau Snowflake. Fabric terus mereplikasi data atau metadata ke OneLake. Pencerminan mendukung tiga jenis:
- Pencerminan database mereplikasi seluruh database dan tabel.
- Pencerminan metadata menyinkronkan metadata seperti nama katalog, skema, dan tabel alih-alih memindahkan data secara fisik. Pendekatan ini menggunakan pintasan sehingga data tetap berada dalam sistem sumbernya saat masih dapat diakses di Fabric.
- Pencerminan terbuka menggunakan format tabel Delta Lake yang terbuka. Pengembang dapat menulis perubahan aplikasi langsung ke item database cermin di OneLake dengan menggunakan API publik.
Fabric mendengarkan perubahan sistem sumber (melalui penangkapan data perubahan atau metode serupa) dan menerapkan perubahan tersebut hampir secara real-time ke salinan cermin. Hasilnya adalah himpunan data langsung yang dapat dikueri yang tetap sinkron dengan latensi rendah, tanpa alur ETL yang kompleks.
Mirroring saat ini mendukung berbagai sumber, termasuk Azure SQL Database, SQL Managed Instance, Azure Cosmos DB, Azure Database for PostgreSQL, Google BigQuery, Oracle, SAP, Snowflake, dan SQL Server. Ini juga mendukung sumber data dari solusi mitra yang telah menerapkan OPEN Mirroring API. Data yang dicerminkan disimpan di OneLake sebagai tabel Delta terkini. Fabric mempertahankan tabel ini secara otomatis sehingga Anda dapat menggunakannya untuk analitik real time atau menggabungkannya dengan data Fabric lainnya. Kemampuan ini mendukung skenario pemrosesan transaksional dan analitik hibrid, di mana data operasional terus mengalir ke platform analitik Anda.
Pencerminan menghilangkan kebutuhan untuk membangun alur beban inkremental secara manual. Dari perspektif Biaya Mirroring, operasi komputasi agar database yang dicerminkan tetap sinkron tidak menggunakan Unit Kapasitas (CUs) dari kapasitas Fabric Anda. Penyimpanan data replika di OneLake juga gratis hingga batas terabyte dalam SKU Fabric Anda (misalnya, F64 menyertakan 64 TB penyimpanan database yang dicerminkan gratis).
Mengakses data eksternal dengan pintasan
Fabric menyediakan pintasan untuk mengaktifkan virtualisasi data. Pintasan di OneLake mereferensikan data yang disimpan dalam sistem eksternal, seperti Azure Data Lake Storage Gen2, Amazon S3, atau SharePoint. Jalan pintas juga dapat merujuk pada data di dalam OneLake itu sendiri, termasuk data dari ruang kerja lain dan data yang dibagikan di antara penyewa melalui berbagi data OneLake. Alih-alih menyalin data, pintasan memungkinkan OneLake untuk mereferensikan file eksternal dan internal sebagai bagian dari data lake terpadu. Anda dapat mengkueri atau menggabungkan data eksternal dengan data lokal tanpa melakukan migrasi awal. Pendekatan penyerapan tanpa salinan ini berguna ketika persyaratan residensi data atau masalah duplikasi mencegah pemindahan data. Diagram berikut menunjukkan bagaimana pintasan menghubungkan sistem penyimpanan eksternal ke item Fabric tanpa menyalin data:
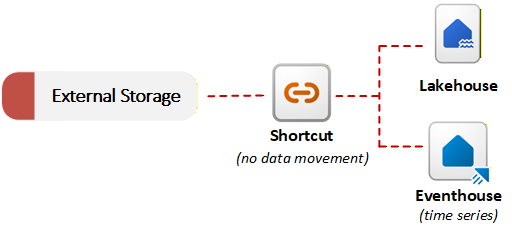
OneLake dapat mendeteksi jenis data yang direferensikan oleh pintasan dan menerapkan transformasi file atau transformasi AI tanpa memerlukan alur atau kode kustom. Transformasi ini bekerja pada target pintasan apa pun, termasuk data yang dibagikan dari penyewa lain melalui berbagi data OneLake. OneLake mempertahankan tabel Delta yang dihasilkan sinkron dengan sumber secara otomatis. Misalnya, Anda dapat mengonversi .csv file ke tabel Delta atau menerapkan analisis sentimen berbasis AI ke .txt file dalam folder.
Dikombinasikan dengan Mirroring, pintasan memberi Anda pola akses data yang fleksibel. Anda dapat menyimpan data dengan menggunakan pintasan, atau Anda dapat mereplikasi data dengan menggunakan pencerminan. Dalam kedua kasus, data siap untuk alat analitik Fabric tanpa ETL yang kompleks.
Panduan keputusan: Memilih strategi pergerakan data
Microsoft Fabric menyediakan beberapa opsi untuk membawa data ke Fabric, termasuk Eventstreams untuk pemrosesan waktu nyata, Mirroring, alur dengan aktivitas Salin, pekerjaan salin, dan pintasan. Setiap opsi menawarkan keseimbangan kontrol, otomatisasi, dan kompleksitas operasional yang berbeda. Saat Anda memerlukan akses langsung dan terkelola ke data yang sudah ada di OneLake (baik di tenant yang sama atau dibagikan dari organisasi lain), pertimbangkan untuk menggabungkan berbagi data OneLake dengan pintasan alih-alih mereplikasi data.
Untuk panduan tentang memilih pendekatan yang sesuai untuk skenario Anda, lihat panduan keputusan Microsoft Fabric: Memilih strategi pergerakan data.