Azure NetApp Files
Microsoft Fabric
Azure AI 検索
Microsoft Foundry
Azure Machine Learning
ソリューションのアイデア
この記事ではソリューションのアイデアについて説明します。 クラウド アーキテクトは、このガイダンスを使用して、このアーキテクチャの一般的な実装の主要なコンポーネントを視覚化できます。 ワークロードの特定の要件に適合する、適切に設計されたソリューションを設計するための出発点として、この記事を使用してください。
このソリューションのアイデアでは、Azure NetApp Files Object REST API を使用して、組織が最初に別のオブジェクト ストアにコピーすることなく、分析と AI に既存のエンタープライズ ファイル データを使用する方法について説明します。 Amazon S3 と互換性のあるアプリケーションでは、ドキュメント検索と AI 支援分析をサポートできますが、既存の NFS および SMB ワークフローからも引き続きそのデータにアクセスできます。 別のソース データ コピーを回避することで、分析ワークロードのオンボードにかかる時間を短縮し、重複するストレージ コストを削減し、チームが構築、監視、トラブルシューティングを行う同期パイプラインを削除できます。 ソース データ リポジトリの数が少ないほど、管理および保護するコピーも少なくなります。 このアプローチでは、組織が既存のファイル ベースのアプリケーションを置き換える必要なく、増分モダン化がサポートされます。
Architecture
このアーキテクチャでは、Object REST API を使用したAzure NetApp FilesとのMicrosoft Fabric統合に重点を置いています。 この図では、同じAzure NetApp Files データの代替分析コンシューマーとしてのAzure Databricksも示しています。 両方のプラットフォームをデプロイする必要はありません。 既存のアプリケーションは、ボリュームの構成とクライアントの要件に応じて、NFS または SMB 経由で引き続きデータにアクセスします。
Azure Databricksコンピューティングでは、Hadoop S3A コネクタを使用して、S3 互換の要求を介して Azure NetApp Files Object REST API エンドポイントにアクセスします。 この代替分析パスでは、オンプレミス データ ゲートウェイや OneLake Microsoftは使用されません。
図中のダウンストリーム AI サービスは例示です。 それらのインジェスト統合は表示されません。
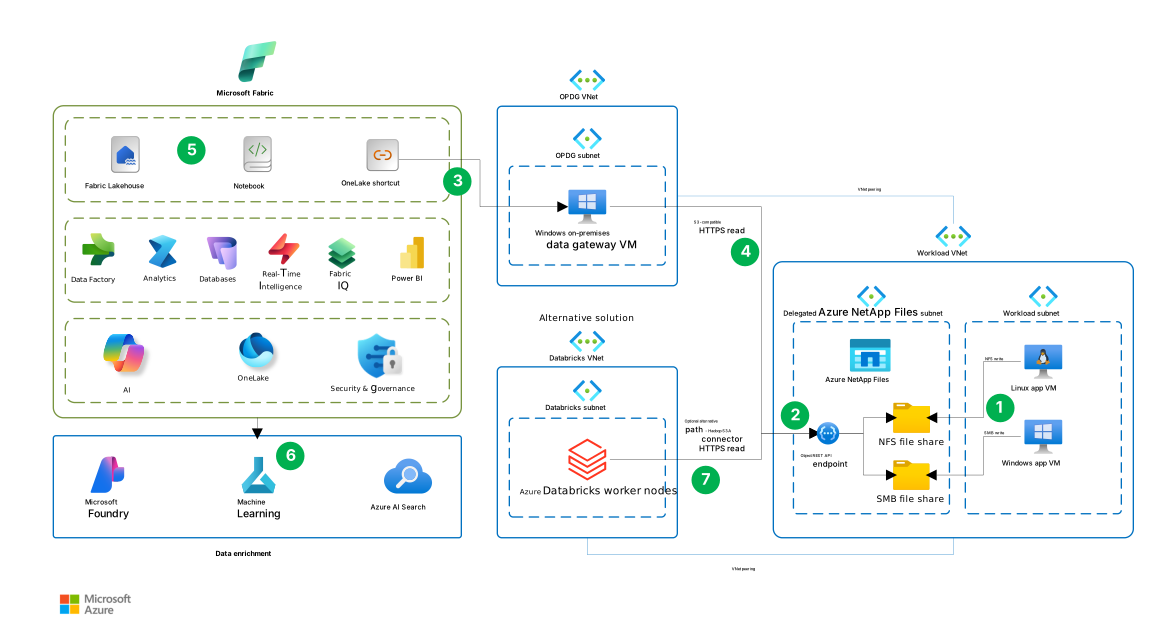
このアーキテクチャのVisio ファイルをダウンロードしてください。
データ フロー
次の番号付き相互作用では、アーキテクチャ図について説明します。 手順 1 から 5 では、プライマリ Microsoft Fabric パスについて説明します。 手順 6 は、下流工程での任意のデータ拡充を示します。 手順 7 は、Fabric フローの継続ではなく、代替分析パスです。 HTTPS 読み出しというラベルの付いた矢印は、Object REST API エンドポイントへのリクエストを示しています。要求されたデータはコンシューマーに返されます。
アプリケーションはファイルデータを書き込みます。 ワークロード サブネットでは、Linux アプリケーション VM が NFS ファイル共有に書き込み、Windows アプリケーション VM が SMB ファイル共有に書き込みます。 Azure NetApp Filesは、委任されたサブネット内の両方の共有をホストします。
Object REST API はファイルデータを提供します。 委任された ANF サブネット内のエンドポイントは、Azure NetApp Files ボリューム上の構成済みディレクトリへの S3 互換アクセスを提供します。 エンドポイントから NFS 共有および SMB 共有への接続は、別個のオブジェクトストアへのコピーではなく、既存のデータへのアクセスを意味します。
Fabric は OneLake ショートカットを使用してデータにアクセスします。 ショートカットは、OPDG (オンプレミス データ ゲートウェイ) サブネット内のWindowsオンプレミス データ ゲートウェイ VM を使用する接続を介して、Azure NetApp Files データを参照します。 OneLake ショートカットはこのゲートウェイに接続されています。
ゲートウェイはオブジェクト REST API から読み取ります。 ゲートウェイは、OPDG VNet とワークロード VNet の間のピアリングを使用してエンドポイントに到達します。 S3 互換の HTTPS 読み取りパスは、ゲートウェイをエンドポイントに接続し、そのエンドポイントが Fabric 用の参照先ファイル データにアクセスします。 接続要件については、「OneLake を Azure NetApp Files ボリュームに接続する」を参照してください。
Fabric がデータを処理および分析します。 サポートされているFabricワークロードは、ショートカットを使用してデータを利用します。 たとえば、ノートブックは参照されたファイルを読み取り、分析や Power BI レポートに使用するために、生成された結果をレイクハウス テーブルに書き込みます。 図の Fabric のボックスには、これらの処理機能と分析機能が示されています。
オプションのダウンストリーム サービスによってデータが強化されます。 Fabric の下にある矢印は、Microsoft Foundry、Azure Machine Learning、Azure AI 検索 を含むデータ エンリッチメント グループにつながっています。 この手順は、任意のダウンストリーム処理を示します。 この図には、これらのサービスを接続するために必要なインジェストやオーケストレーションは示されておらず、OneLake ショートカットではそれらの統合が確立されません。
または、Azure Databricksはファイル データを直接読み取ります。 Databricks サブネット内のワーカー ノードは、Hadoop S3A コネクタを使用して、ピアリングされた仮想ネットワーク経由で同じオブジェクト REST API エンドポイントに HTTPS 読み取り要求を送信します。 このパスは、手順 3 から 5 のFabricアクセスおよび処理パスを置き換えます。 オンプレミスのデータ ゲートウェイまたは OneLake を通過しません。
データの使用方法に基づいてショートカットの場所を選択します。
- 既存の互換性のある Delta テーブル。 lakehouse の Tables セクションに、トランザクション ログを含む完全な Delta テーブルを対象とするテーブル ショートカットを作成します。 Fabricは、ソース データがAzure NetApp Filesに残っている間、Spark と SQL 分析エンドポイントを介してクエリを実行できるテーブルとしてターゲットを認識します。
- 直接アクセス用または処理用のファイル。 Lakehouse の [ファイル ] セクションにショートカットを作成します。 対応するワークロードでは、ソース ファイルを事前に OneLake にコピーしなくても、ドキュメントに加えて、スタンドアロンの Parquet、CSV、JSON ファイルを読み取ることができます。 下流の分析で lakehouse テーブルが必要な場合は、ソース データを変換するか、OneLake 内の派生 Delta テーブルに読み込みます。
スタンドアロンの Parquet ファイルは、自動的には差分テーブルではありません。 Files 内のショートカットでは、リンク先がテーブルとして自動的に登録されません。 詳細については、「 レイクハウス内のショートカットを配置する場所」を参照してください。
Components
次のコンポーネントは、Fabric を中心としたアーキテクチャと、オプションの Azure Databricks の代替案をサポートします。
Azure NetApp Filesは、NetApp テクノロジに基づいて構築されたフル マネージドのファイル ストレージ サービスです。 このアーキテクチャでは、これがエンタープライズ データセットを格納し、Object REST API を介して NFS、SMB、S3 互換のオブジェクト アクセスを提供します。 また、スナップショットとレプリケーションの機能も提供します。
Azure NetApp Files Object REST API は、S3 互換インターフェイスを介して既存のファイル データを公開します。 このアーキテクチャでは、互換性のある分析/解析および AI アプリケーションが、最初に別のオブジェクト ストレージ コピーを作成せずにデータにアクセスできるようにします。 このインターフェイスでは、Amazon S3 操作のサブセットがサポートされます。 この統合を選択する前に、サポートされている操作 がアプリケーションの要件を満たしていることを確認してください。
Microsoft Fabricは、データ移動、データ処理、インジェスト、変換、Real-Time インテリジェンスによるストリーム処理、レポート作成を統合する分析プラットフォームです。 このアーキテクチャでは、OneLake ショートカットを使用してAzure NetApp Filesからのデータを処理および分析するための分析プラットフォームを提供します。
OneLake は、Fabric用の統合論理データ レイクです。 このアーキテクチャでは、OneLake ショートカットにより、Azure NetApp Files 内の参照データを対応する Fabric ワークロードで利用できるようになります。
Azure Virtual Networkは、このアーキテクチャ内のAzureリソース間でプライベートな接続を提供します。 仮想ネットワーク ピアリングにより、ゲートウェイ仮想マシンとオプションの Azure Databricks コンピューティング リソースが Azure NetApp Files Object REST API エンドポイントにアクセスできるようになります。
オンプレミス データ ゲートウェイは、OneLake ショートカットと Azure NetApp Files のバケット エンドポイントの間を接続します。 名前とは異なり、このアーキテクチャでは、ゲートウェイはサポート対象の Windows オペレーティング システムを実行する Azure 仮想マシン上で標準モードで実行されます。 ゲートウェイのインストール要件を満たすイメージを選択します。 Server Core のインストール環境および Windows コンテナーはサポートされていません。 ゲートウェイは、Azure Relay 経由で外向き接続を確立し、Fabric と通信します。 Fabricからの受信接続は必要ありません。 オンプレミス データ ゲートウェイの通信設定の調整に関するセクションで説明されている送信エンドポイントを許可するようにファイアウォールまたはプロキシを構成します。
Azure Databricks は、データ エンジニアリングと機械学習のワークロード向けに選択できる代替分析プラットフォームです。 その Spark ジョブでは、Object REST API エンドポイント用に構成された Hadoop S3A コネクタを使用して、Fabric統合パスを使用するのではなく、Azure NetApp Files データセットにアクセスします。
Alternatives
このアーキテクチャには、ワークロードの機能要件と非機能要件に応じて、他のAzure サービスまたはアプローチに置き換えることができる複数のコンポーネントが含まれています。 次の代替手段とそのトレードオフを検討してください。
Storage
Azure Blob StorageとAzure NetApp Filesのいずれかを選択する場合は、アプリケーションのプロトコル要件と測定されたパフォーマンスを考慮してください。
クライアントが Blob Storage REST API または NFS 3.0 を使用でき、SMB または NFS 4.1 を必要としない場合は、Blob Storage を選択します。 両方のインターフェイスが同じデータにアクセスできます。 Blob Storage NFS 3.0 アクセス パスは、スループットが低待機時間よりも重要な、高スループットで読み取り負荷の高いシーケンシャル ワークロード用に最適化されています。
アプリケーションと分析ワークロードが、SMB または NFS 4.1、および S3 互換の Object REST API を介して同じファイルにアクセスする必要がある場合、またはファイルアプリケーションで低レイテンシのランダム I/O が必要な場合は、Azure NetApp Files を選択します。 すでに Azure NetApp Files 上にあるデータには、Object REST API により、ソース アプリケーションやデータを移行することなく分析用のアクセスが提供されます。
どちらのオプションでも、ソース アプリケーションと分析の同時負荷でエンド ツー エンドの待機時間とスループットを測定します。 NFS または SMB のパフォーマンスは、オブジェクト REST API または Fabric のパフォーマンスを示すものではないため、ワークロードの要件に照らして、意図したアクセス パスをテストしてください。 アプリケーションの変更、移行、継続的な二重運用と同期などを含む合計コストを比較します。 プロトコルとワークロードの比較については、「Azureストレージ サービスの比較」を参照してください。
Integration
Azure Databricks ジョブでは、Hadoop S3A コネクタを使用して、OneLake またはオンプレミス データ ゲートウェイを使用せずに、Object REST API を介してAzure NetApp Filesデータを読み取ることができます。 書き戻しに依存する前に、TLS の信頼設定と安全に保存された認証情報を構成し、必要な書き込み操作を検証します。 初期化スクリプトが必要な場合は、現在の Azure Databricks init-script ガイダンスに従って、サポートされているコンピューティングで Unity カタログ ボリュームに格納されているクラスター スコープのスクリプトを使用します。
シナリオの詳細
このパターンは、同じデータセットを、マウントされたファイル システムを想定するアプリケーションと、S3 互換のオブジェクト インターフェイスを想定する分析または AI サービスに提供する必要がある場合に使用します。
仮想マシンまたはコンテナーで実行されているアプリケーションは、NFS または SMB 経由でAzure NetApp Filesを引き続き使用できます。 たとえば、既存のファイル アクセス コード、マウントされた共有、ディレクトリ構造を使用できます。 Azure NetApp Files オブジェクト REST API は、ボリュームのルート ディレクトリまたはサブディレクトリを S3 互換バケットに対応付けることで、互換性のあるオブジェクト クライアントが同じ基盤となるファイルにアクセスできるようにします。
この方法は、オブジェクト ストレージを使用するようにソース アプリケーションを変更せずに、既存のファイル ベースのワークロードに分析機能または AI 機能を追加する場合に便利です。 ダウンストリーム ワークフローでは、必要に応じて、変換されたデータセット、インデックス、埋め込み、キャッシュなどの派生データを作成できます。
ファイル クライアントとオブジェクト クライアントが同じデータにアクセスする場合は、ID、アクセス許可、ロック、アプリケーション整合性の要件の違いを考慮してください。 プロデューサーが、オブジェクト コンシューマーが処理する前に、ファイルまたはバッチの完了を通知する方法を定義します。 プロデューサーは、準備完了を通知する前にファイルへの書き込みを終えてファイルを閉じ、コンシューマーがそれらのファイルを処理している間は変更しないままにしておく必要があります。 書き込みの中断や処理の再試行に対して、この引き継ぎをテストします。
アイデンティティと認可のモデルは、アクセス方法によっても異なります。 元のユーザーごとのファイル アクセス許可は、Fabric に自動的には引き継がれません。 対象となるコンシューマー向けに Fabric のアクセス許可を構成し、Object REST API で使用される ID が必要なソース データのみにアクセスできることを確認します。 詳細については、「セキュリティ」を参照してください。
利用者に異なるアクセスレベルが必要な場合は、ディレクトリを別々のバケットに対応付けます。 データ分類、保持、下流での認可、および派生データのガバナンスは、引き続きワークロード側の責任です。 詳細については、「バケットの作成」を参照してください。
考えられるユース ケース
このアーキテクチャでは、既にAzure NetApp Filesに格納されている構造化データまたは非構造化データを分析する必要があるワークロードをサポートできます。 次の例は、Fabricがそのデータを使用できるさまざまな方法を示しています。
ドキュメント処理
アプリケーションは、NFS または SMB を使用して、ドキュメント、イメージ、またはその他の非構造化ファイルをAzure NetApp Filesに保存できます。 Fabric ノートブックでは、OneLake ショートカットを使用して処理完了済みのファイルを読み取り、その内容を抽出のためにドキュメント処理サービス (Azure ドキュメント インテリジェンスなど) に送信できます。 結果として得られる構造化データを、検証、分析、およびレポート用の lakehouse テーブルに格納します。
統合に関するガイダンスについては、SynapseML を使用した Document Intelligence の統合を参照してください。
データ分析
アプリケーションは、CSV ファイルや Parquet ファイルなどの構造化データを Azure NetApp Files の共有に書き込むことができます。 Fabricノートブックでは、OneLake ショートカットを使用して完了したファイルを読み取り、それらを他の lakehouse データと組み合わせて、派生した結果を lakehouse テーブルに書き込むことができます。
このパターンでは、ソース アプリケーションがファイルの格納方法を変更しなくても、エンジニアリングと品質分析、センサー データ分析、運用レポートなどのシナリオをサポートできます。
既存の互換性のある Delta データセットに対して、トランザクション ログを含む完全な Delta テーブルを対象とした OneLake ショートカットを、レイクハウスの Tables セクションに作成します。 Fabricはターゲットをテーブルとして認識でき、ソース データはAzure NetApp Filesに残ることができます。 詳細については、「レイクハウス内のショートカットを配置する場所」を参照してください。
AI 検索と情報取得
Azure NetApp Filesに格納されているドキュメントは、AIワークロード向けの元コンテンツとして利用することもできます。 たとえば、処理ワークフローでは、OneLake ショートカットを使用してドキュメントを読み取り、それらを使用して取得拡張生成 (RAG) 用のAzure AI 検索 インデックスを作成できます。
検索インデックスと埋め込みはすべて派生データであり、ソース ファイルとは別に格納されます。 インデックスされたコンテンツをソースの更新、名前変更、削除と同期した状態に保てるように、ワークフローを設計します。 また、元の SMB と NFS のアクセス許可はユーザーごとの検索アクセス許可にならないため、インデックス付きコンテンツを取得するときに適切なアクセス制御を適用します。
同じパターンを他の AI ワークロードに拡張できます。 たとえば、Fabricノートブックでは、ソース ファイルからデータセットを準備し、準備されたデータを Azure Machine Learning で使用できるように OneLake に格納できます。 統合オプションと制限事項については、「OneLake を Azure Machine Learning と統合する」を参照してください。
考慮事項
これらの考慮事項は、ワークロードの品質向上に使用できる一連の基本原則である Azure Well-Architected Framework の要素を組み込んでいます。 詳細については、「 Well-Architected Framework」を参照してください。 詳細なガイダンスについては、Azure NetApp Files 向け Well-Architected Framework の推奨事項を参照してください。
Reliability
信頼性は、アプリケーションが顧客に対して行ったコミットメントを確実に満たすことができるのに役立ちます。 詳細については、「信頼性の設計レビュー チェックリスト」を参照してください。
Azure NetApp Filesは、ONTAP を搭載したフォールト トレラントなベアメタルフリートで実行され、高可用性 SLAを提供します。 可用性ゾーンまたはリージョンの障害に対する追加の保護のために、必要に応じて、クロスゾーンレプリケーションまたはリージョン間レプリケーションを構成できます。 このレプリケーションは非同期であり、宛先ボリュームへのお客様主導のフェールオーバーが必要です。 ワークロードの復旧目標に応じて、レプリケーション オプションとスケジュールを選択します。 詳細については、「Azure NetApp Files reliability」を参照してください。
また、1 つのデータセットを共有すると、ストレージの可用性がファイル アプリケーションと分析に共通する依存関係になります。 これらのストレージ機能では、ゲートウェイ、インデックス作成パイプライン、または利用側アプリケーションに対するエンドツーエンドの可用性は確立されません。 復旧目標を、ゲートウェイ、ダウンストリーム処理、派生データを含む完全なワークロードに合わせます。
1 つのゲートウェイ仮想マシンは、Fabric統合パスの単一障害点です。 ビジネス クリティカルなワークロードの場合は、別々の仮想マシン上の ゲートウェイ クラスター に少なくとも 2 つのゲートウェイ メンバーをデプロイします。 すべてのメンバーが Object REST API エンドポイントに到達し、必要な送信接続を確立できることを確認します。 ゲートウェイ メンバーが使用できなくなった場合のワークロードの動作をテストします。
- ファイルとボリュームの復元は、スペース効率の高いポイントインタイムスナップショットによってサポートされます。 Teams は、個々のファイルを復元したり、完全なボリュームを元に戻したり、誤削除、破損、または分析プロセスの失敗後の復旧ポイントから新しいボリュームを作成したりできます。 使用可能な復旧操作については、Azure NetApp Files のスナップショット ベースのデータ保護を参照してください。
セキュリティ
セキュリティは、意図的な攻撃や貴重なデータとシステムの誤用に対する保証を提供します。 詳細については、セキュリティ設計レビューのチェックリストを参照してください。
ソース データ コピーの数を減らすことで、保護するリポジトリの数を減らすことができます。 Azure NetApp Filesは保存データを暗号化し、Object REST API は TLS を使用して転送中のデータを保護します。 ファイル アクセスのアクセス許可は、プロトコルによって異なります。
SMB クライアントと NFS クライアントは、既存の認証および承認モデルを引き続き使用します。 既存の NTFS アクセス制御リスト (ACL)、NFS アクセス許可、および ID マッピング規則は、これらのクライアントに対して引き続き有効です。
オブジェクト REST API クライアントは、S3 アクセスキーを使用して認証を行います。 バケットのアクセス許可は、クライアントがマップされたディレクトリ内で読み取り専用または読み取り/書き込みアクセスを持っているかどうかを定義します。 オブジェクト要求には、個々の SMB、NFS、またはダウンストリーム ユーザーの ID は含まれません。 Azure NetApp Filesは、バケットに構成された偽装用のファイル システム ID として、すべてのオブジェクト操作を実行します。 既存のファイルのアクセス許可と ACL は、その主体に対してのみ評価されます。
借用されたファイル システム ID は、NFS ボリュームのユーザー ID (UID) とグループ ID (GID)、または SMB ボリュームのユーザー アカウントです。 デュアル プロトコル ボリュームでは、構成されたセキュリティ スタイルに一致する ID の種類が使用されます。 この識別情報は、ファイル アクセス許可を決定します。 S3 アクセス キーは、オブジェクト クライアントの認証に使用されます。 詳細については、「 オブジェクト REST API のセキュリティとアクセス許可」を参照してください。
OneLake の S3 互換ショートカットは、アクセス キー ID とシークレット アクセス キーを使用してバケットへの認証を行います。 ソースの NTFS ACL、NFS アクセス許可、および各ファイルの所有者 ID は、OneLake にコピーまたはマップされません。 Fabricユーザーは、OneLake と Fabric のアクセス許可を通じて認可されます。 バケットとその偽装 ID を介してショートカット経由で公開されたコンテンツにのみアクセスできますが、OneLake では元のユーザー単位のファイル アクセス許可は適用されません。 Microsoft Entra ベースの OAuth、サービス プリンシパル、および RoleArn は、このショートカットの種類ではサポートされていません。
たとえば、Fabricユーザーは、Fabric のアクセス許可でアクセスが許可されており、バケットの偽装 ID がドキュメントを読み取ることができる場合、個人の SMB アカウントが直接読み取ることができない場合でも、ショートカットを使用してドキュメントを読み取ることができます。 ディレクトリを公開する前に、想定される Fabric の対象ユーザーがそのコンテンツへのアクセスを許可されていることを確認します。
ワークロードに必要なソース側の権限のみが付与された ID を、バケットのなりすまし ID として構成します。 ショートカットとレイクハウスへのアクセスを制限します。 Azure Key Vault ベースの証明書ワークフローと資格情報ストレージを使用して、TLS 証明書と S3 アクセス キーを管理します。 証明書と資格情報の変更を、Fabric 接続およびその他のコンシューマーの更新と連携させるローテーション手順を定義し、テストします。 新しいバケット資格情報を生成すると、既存のペアが直ちに無効になるため、コンシューマーを更新し、ローテーション後にアクセスを確認する間に中断が発生する可能性を見込んで対応してください。
自己署名 TLS 証明書を使用する場合は、すべてのゲートウェイ ホストがその証明書を信頼していることを確認します。 詳細については、「OneLake ゲートウェイの前提条件」を参照してください。
セキュリティとコンプライアンスは、ストレージ、アクセス、およびダウンストリーム サービスの構成に依存します。 ガバナンスとコンプライアンスのスコープにダウンストリーム処理と派生データを含めます。 GDPR や HIPAA などの要件は、必要に応じて、ワークロード全体に適用されます。 詳細については、「 Object REST API のセキュリティとアクセス許可 」および「OneLake で Amazon S3 互換のショートカットを作成」を参照してください。
コストの最適化
コストの最適化では、不要な経費を削減し、運用効率を向上させる方法に重点を置いています。 詳細については、「コスト最適化の設計レビュー チェックリスト」を参照してください。
別のソース データ コピーを回避すると、重複するストレージと同期のコストが削減されます。 これらの節約額を、Azure NetApp Files の容量とパフォーマンスのコスト、ゲートウェイ コンピューティング、Fabric 容量、ダウンストリームの処理とストレージのコストと比較検討してください。
この価格見積もりの例には、1 TiB Azure NetApp Files Standard 容量プール、オンプレミス データ ゲートウェイ用のWindows D8s_v5仮想マシン、2 つの 128 GiB P10 マネージド ディスク、パブリック IP アドレスと送信データ処理を備えた NAT ゲートウェイ、Fabric F2 容量、100 GB のネイティブ OneLake ストレージが含まれます。
単一ゲートウェイ構成は高可用性ではありません。 オプションの AI 検索、埋め込みサービス、Azure Databricksコストは除外されます。 ワークロードの容量、ネットワーク、可用性の要件に合わせてリソースを調整します。
クール アクセス: スナップショット データを含む非アクティブなデータ ブロックを階層化して、ファイルとオブジェクトへのアクセスを保持しながら、低コストのストレージに階層化します。 取得料金、待機時間、およびサービス レベル固有のスループットの変化をワークロードのアクセス パターンに照らして評価します。
サービス レベルと適切なサイズ設定:データセットの容量とスループットの要件に一致するAzure NetApp Filesサービス レベルを選択します。 柔軟なサービス レベルを使用すると、プールの容量とスループットを個別にプロビジョニングできます。 需要の変化に応じて課金対象プールの容量とスループットを確認し、永続的な過剰プロビジョニングを回避します。
オペレーショナル エクセレンス
オペレーショナル エクセレンスは、アプリケーションをデプロイし、それを運用環境で実行し続ける運用プロセスをカバーします。 詳細については、「 オペレーショナル エクセレンスの設計レビュー チェックリスト」を参照してください。
OneLake ショートカットは、分析用に別のソース データ コピーを維持するパイプラインを回避することで、運用の複雑さを軽減します。 別のコピー パイプラインがない場合、チームは、コピー ジョブのスケジュール設定、転送エラーからの復旧、定期的な操作の一環としてソースとコピーされたデータの調整を行う必要はありません。
ソース アプリケーションチームと分析チームは、共有Azure NetApp Files データセットの変更とインシデント対応を調整する必要があります。 監視、エラーの処理、 およびオブジェクト REST API の資格情報と証明書の管理の所有権を確立します。
ストレージ、ゲートウェイ、およびFabricパフォーマンスを監視して制約を特定し、容量またはスループットを調整します。
Azure Monitorを使用して、ボリュームの読み取りと書き込みのスループット、読み取りと書き込みの IOPS、その他の IOPS、読み取りと書き込みの平均待機時間、容量消費量、スループット制限に達したインジケーターを追跡します。 一時的なスパイクではなく、継続的な待機時間の増加、QoS の繰り返しの制限、および容量のしきい値に対してアラートを設定します。Azure NetApp Filesメトリックは間隔を通して集計され、ストレージ待機時間にはすべてのクライアント側 REST コンポーネントが含まれるわけではありません。
ストレージ メトリックを、リクエスト レイテンシのパーセンタイル、オブジェクト サイズ、コンカレンシー、再試行回数、HTTP ステータス コード、CPU、メモリ、ネットワーク スループットなどのクライアント側の測定指標と関連付けます。 これにより、ボリューム スループットの制限が、小さなコンピューティング クライアント、非効率的な SDK 設定、小さなオブジェクトのオーバーヘッド、またはネットワーク距離と区別されます。
各ゲートウェイ仮想マシンの CPU、メモリ、利用可能なディスク領域、ネットワーク スループットを、ゲートウェイ エラーおよびワークロードの完了時間と併せて監視します。 代表的なワークロードテストで確立したしきい値を使用して、継続的なリソース逼迫とディスク容量不足に対するアラートを設定してください。 エラーやアクセスの遅さをトラブルシューティングする際は、ゲートウェイ診断ログを使用してください。 ゲートウェイ診断では完全なインフラストラクチャカバレッジが提供されないため、仮想マシンとネットワークを個別に監視します。
Fabric Capacity Metrics アプリを使用して、Fabric 容量の使用率とスロットリングを監視します。 担当する管理者向けの容量使用率通知を構成します。 容量の使用状況をゲートウェイおよびストレージの測定値と照合し、容量を変更する前に、遅延の原因がソース アクセスにあるのか、Fabric の処理にあるのかを特定します。
パフォーマンス効率
パフォーマンス効率とは、ユーザーの要求を効率的に満たすためにスケーリングするワークロードの能力を指します。 詳細については、「パフォーマンス効率のための設計レビュー チェックリスト」を参照してください。
Azure NetApp Filesは、待機時間に依存する NFS または SMB アプリケーションと、同じデータセットを使用する S3 互換の分析または AI コンシューマーの両方をサポートできます。 ソースデータを 1 つのボリューム上に保持すると、そうしない場合にはインデックス作成、トレーニング、またはバッチ処理を遅らせ、クライアント、ネットワーク、およびコピー先ストレージの帯域幅を消費するコピーの段階を省略できます。
サポートされている Azure NetApp Files のサービス レベルにおける 1 ミリ秒未満のストレージ レイテンシは、NFS と SMB のワークロードに最も直接関係します。 HTTPS オブジェクト REST API 要求のエンドツーエンドの待機時間は保証されません。 待機時間の目標を設定する前に、代表的なオブジェクトとコンカレンシーで S3 互換のアクセス パスをベンチマークします。
ストレージのサイズ設定: ファイル アプリケーションとオブジェクト コンシューマーの合計需要のサイズ スループット。 自動 QoS により、ボリューム スループットがボリューム クォータに関連付けられます。 手動 QoS により、プールのスループット予算内で個別の割り当てが可能. パフォーマンスを調整する前に、代表的なワークロードをベンチマークします。
ゲートウェイのサイズ設定:OneLake ショートカットを使用してAzure NetApp Filesにアクセスするワークロードの需要を合わせて、ゲートウェイ仮想マシンのサイズを変更します。 まずはゲートウェイのサイジングとスケーリングの指針を参照してください。 ショートカット経由で、代表的なデータ ボリュームと同時アクセスを使用してサイジングを検証します。 ゲートウェイの CPU、メモリ使用量、およびネットワーク スループットをワークロードの完了時間と併せて測定し、仮想マシンのリソースを増やすべきか、またはゲートウェイ メンバーを追加すべきかを判断します。
Fabric 容量のサイズ設定: Power BI を含む、処理とレポートの合計ワークロードに合わせて Fabric 容量のサイズを設定します。 Fabric capacity planning guide のガイダンスに従って初期容量を見積もり、代表的なパイロット環境でテストを行い、測定した使用率とスロットリングに基づいて容量を調整します。
コンピューティングをボリュームの近くに配置し、クライアント ネットワークを適切にサイジングし、実際のワークロードでテストします。 並列処理を増やし、シーケンシャル分析には適切に大きな要求を使用しますが、待機時間やエラーが増加した場合はコンカレンシーを制限します。 NFS または SMB の場合は、マウント、プロトコル、アプリケーションの設定を検証します。 REST の場合は、クライアントの必要な API 操作のサポートを確認し、接続の再利用、アップロード動作、再試行、オブジェクトの一覧をテストします。
同時負荷の下でエンドツーエンドのスループットと待機時間を検証し、ソース アプリケーションのパフォーマンス要件と分析の需要のバランスを取ります。
Contributors
Microsoft では、この記事を保持しています。 この記事を書いたのは、以下の寄稿者です。
主な執筆者:
- ダン・ジャクソン |クラウド ソリューション アーキテクト、NetApp
- アンソニー・マッシュフォード | クラウドソリューションアーキテクト、NetApp
- ダニエル・セーデルホルム |クラウド + AI プラットフォーム、Microsoft シニア ソリューション エンジニア
その他の共同作成者:
- ヘザー・グランディ | シニアソリューションエンジニア、データ プラットフォーム部門、マイクロソフト
公開されていない LinkedIn プロフィールを見るには、LinkedIn にサインインしてください。
次のステップ
- Azure NetApp Filesのオブジェクト REST API の概要
- OneLake を Azure NetApp Files ボリュームに接続する
- Azure Databricksの Init スクリプト
- OneLake と Azure Machine Learning の統合