Important
この機能は ベータ版です。 ワークスペース設定は必要ありません。 Agent BricksのCLIをインストールして始めてください。
Agent Bricks CLI(databricks-agentbricks)は、コード内でカスタムエージェントを構築・展開する開発者向けのAzure Databricksコマンドラインツールです。
Agent Bricks CLIは、ターミナルからカスタムエージェントを構築するためのコードファーストパスです。 Agent Bricks CLIは、Databricksのベストプラクティスに基づく組み込みフレームワークを用いてプロジェクトを支えています。 その後、プロジェクトをローカルで実行してテストし、Azure Databricksエージェントのランタイムにデプロイできます。 CLIは、空のディレクトリからデプロイ済みエージェントへと移行し、ランタイムやツール、メモリ、管理リソースを手作業で配線する必要がなくなります。 アプリベースのワークフローを含むカスタムエージェントを構築する他の方法については、「 レガシーエージェントサーバーを使ったDatabricks Apps上でエージェントを実行する」をご覧ください。
前提条件
Databricks CLIがインストールされ、あなたのパス上で利用可能になっています。
Python 3.11 以降。 Agent BricksのCLIパッケージはPython 3.10でインストールできますが、スキャフォールドされるプロジェクトはPython 3.11以上が必要です。 DatabricksはPython 3.12を推奨しています。
uvこれは、agentbricks init、agentbricks dev、agentbricks deployのスキャフォールディングされたプロジェクトを実行します。Agent Bricks CLIをインストールしてください。
uvツールとしてインストールするには、以下を実行します。uv tool install databricks-agentbricks代わりに
pipでインストールするには、pip install databricks-agentbricksを実行してください。 インストールが失敗した場合は トラブルシューティングをご覧ください。
概要: サインインからエージェントのデプロイまで
以下の手順は「 新しいエージェントを作成」の手順をまとめています。
databricks auth login --host "https://<your-workspace-url>" --profile my-workspace
agentbricks login --profile my-workspace
agentbricks init --framework langgraph my-agent
cd my-agent
agentbricks dev
agentbricks deploy my-agent
Tip
すべてのコマンドおよびコマンド グループは --helpをサポートします。 例えば、メモリコマンドとそのフラグを一覧にするために agentbricks memory --help を実行しましょう。
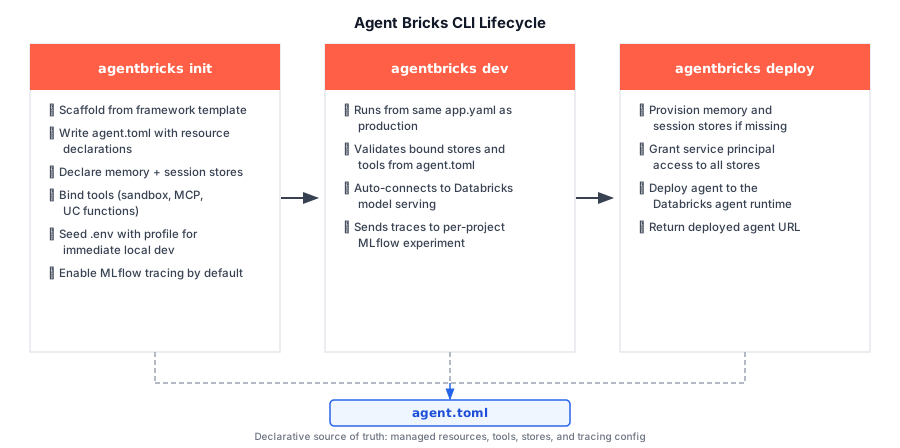
エージェントブリックスCLIライフサイクル
Agent Bricks CLIは、フレームワークテンプレートからデプロイ可能なエージェントコードのローカルディレクトリをスキャフォールドし、ランタイム、テスト、オプションのチャットUIがすでに配線されています。 アプリケーションロジック(モデル、ツール、プロンプト)を書き、CLIがローカルで実行しAzure Databricksのインフラストラクチャにデプロイします。
agent.tomlは、エージェントが依存するすべてのAzure Databricks管理リソースの宣言的真理の源です:ツールバインディング(データサンドボックス、管理されたモデルコンテキストプロトコル(MCP)サービス、Unityカタログ関数)、およびメモリ、セッション、トレーシングリソース。
agentbricks deploy それを読み込んでプロビジョニングや配線を行うので、手書きのセットアップコードではなくファイル自体がデプロイされます。
エージェントを空のディレクトリから本番環境に移す3つのコマンド:
-
agentbricks initバンドルされたテンプレートからプロジェクトをスキャフォールディングし、オプションでDatabricksプロファイルを.envファイルにシードしてプロジェクトをすぐに実行できるようにします。 -
agentbricks devエージェントはAzure Databricksのモデルサービングに対してローカルで実行されるため、デプロイ前にテストできます。 -
agentbricks deployagent.tomlで宣言されたリソースをプロビジョニングし、エージェントをAzure Databricksエージェントのランタイムにロールアウトします。
Note
また、ツールを追加したり、メモリやセッションストアをinit時だけでなくいつでもバインディングできます。 これらのステップの間に、 agentbricks tools add、 agentbricks memory bind、 agentbricks sessions bind を使ってエージェントの設定を更新してください。
エージェントブリックスのCLI機能
| 能力 | Description |
|---|---|
| モデルアクセス | Agent Bricks CLIはモデルアクセスを自動的にプロビジョニングし、エージェントが認証情報やエンドポイントを管理せずにAzure Databricksで提供されたモデルを呼び出せるようにします。 Databricks Foundation モデル API を参照してください。 |
| マネージドメモリ | エージェントが書き込み検索できる長期メモリで、アクターごとに分割され、マネージドストアによって裏付けられています。 メモリを使って事実や好みをセッション間で永続化し、agentbricks memory pipeline を使ってセッションストアから記憶を要約・整理します。
Agent memory および Agent memory pipelines を参照してください。 |
| マネージドセッション | 管理されたセッションストア内に保持され、アクターごとに分割された会話の記録。セッションを独立したコピーにフォークすることもサポートします。 エージェント セッションを参照してください。 |
| Tools |
agent.tomlで宣言されたAzure Databricks管理機能:ダウンスコープ化されたUnity Catalogサンドボックス、Azure Databricks管理MCPサービス、またはUnity Catalog関数。 カスタムPythonツールはプロジェクトコードに直接書かれます。
MCPsを参照してください。 |
| トレース | デフォルトでオンのMLflowトレーシングで、各ランのトレースをプロジェクトごとのMLflow実験にルーティングし、デバッグやモニタリングを行います。 トレーシングの概要を参照してください。 |
| Deployment | エージェントをAzure Databricksエージェントのランタイムにデプロイし、エージェントのサービスプリンシパルにバウンドストアへのアクセス権を与え、デプロイライフサイクルを管理します。 |
新しいエージェントを作成する
ステップ1:OAuthで認証し、プロフィールを保存する
Agent Bricks CLIは DatabricksのCLI認証を使用しています。 OAuth(ユーザーからマシンへの認証)でワークスペースに認証し、認証情報を名前付きプロファイルとして保存してください。 以下のコマンドの両方を実行してください。
Note
プロファイルとは、~/.databrickscfgに保存された接続設定(ワークスペースのURLとその認証情報)の名前付きセットです。 このページの例は「my-workspace」という名前のプロファイルを使用しています。 どんな名前でも選んで、--profileを使って渡す。
OAuthフローを開始するには、ホストをワークスペースのURLに置き換えて以下の手順を実行してください。 コマンドはブラウザを開きサインインを完了させ、その後
my-workspaceプロファイルを~/.databrickscfgに書き込みます。databricks auth login --host "https://<your-workspace-url>" --profile my-workspaceプロファイルを検証し、後続のコマンドで
--profileを省略できるように Agent Bricks CLI のデフォルトとして保存するには、以下を実行します:agentbricks login --profile my-workspaceプロフィールの認証情報が欠落しているか拒否された場合、
agentbricks loginがdatabricks auth loginを再実行し、再試行します。
ステップ2:エージェントプロジェクトの足場を築く
新しいエージェントプロジェクトをスキャフォールドし、テンプレートを選ぶために --framework パスします。 この例はブラウザチャットアプリを含むLangGraphテンプレートを使用しています。
agentbricks init --framework langgraph my-agent
cd my-agent
CLIはフレームワークごとに1つのテンプレートをバンドルし、 --framework どのテンプレートからスキャフォールドするかを選びます:LangGraph用の langgraph かOpenAIエージェントSDKの openai かです。 CLIはプロジェクトの管理リソースやツールバインディングを agent.toml に、テンプレートの出所を .agentbricks/project.tomlに書き込みます。 チャットアプリなしでAPIのみのバックエンドを足場にするには、 --disable-chat-appを追加してください。
ステップ3:管理されたセッションストアとメモリストアをアタッチする
マネージドストアは、エージェントが会話履歴や長期記憶を保持できるようにします。
agentbricks init
agent.toml では、セッションストアとメモリストアを宣言し、プロジェクト名にランダムな接尾辞(my-agent-cuzvas-memory など)を付けた名前を付けます。
agentbricks deploy は、まだ存在しない宣言済みストアを作成し、デプロイされたエージェントにそのアクセス権を付与するため、ほとんどのエージェントはこのステップを省略できます。
別のストアを使う場合は、別のストアを名前でバインドします。 各コマンドは agent.toml内の店舗名を置き換えます。 店舗は作成されません。
my-agent-sessionsという名前のセッションストアとmy-agent-memoryというメモリストアをバインドするには、以下を実行します。
agentbricks sessions bind my-agent-sessions
agentbricks memory bind my-agent-memory
ストア内にすでにメモリがある状態でエージェントを起動するには、ストアを作成し、デプロイ前にエントリを追加してください。 「エージェントメモリを使い始める」の「Agent Bricks CLI」タブをご覧ください。
ステップ 4: トレースを表示
トレースはデフォルトでオンになっています。
agentbricks init はデフォルトの MLflow 実験 /Shared/agentbricks_traces/<project>-<suffix> を関連付け、agentbricks dev と agentbricks deploy は各ランのトレースをその実験に送信します。
エージェントがトレースを作成した後にトレースをリストアップするには、以下を実行します。
agentbricks tracing list
特定のMLflow実験をバインドするには、 agentbricks tracing bind --experiment-id <experiment-id>を実行します。 トレースをオフにするには agentbricks tracing unbindを実行してください。
ステップ5:エージェントをローカルで運用する
デプロイ前にマシンでエージェントをテストしてください。
agentbricks dev
これにより、Azure Databricksエージェントのランタイムと同じコマンドと環境を使ってポート8000のローカルサーバーが起動します。 Agent Bricks CLIはエージェントをAzure Databricksモデルのサーバーに接続し、ローカルでモデルを呼び出せるようにします。 テンプレートはagent/agent.pyのMODEL値をデフォルトモデルとして設定します。 別のモデルを使う場合は、その値を編集してください。 エージェントとやり取りするリクエストを http://localhost:8000 に送ります。
Note
agentbricks dev メモリやセッションストアに接続できません。 長期記憶はオフで、会話履歴はローカルサーバーが稼働している間だけ残ります。 チャットアプリでは、ストアがバインドされていてもローカル メモリでは「接続されていない」と表示されます。 メモリは agentbricks deploy後に接続されます。
ステップ6:エージェントを展開する
エージェントをAzure Databricksエージェントランタイムにデプロイしてください。 CLI は、関連付けられたストアをプロビジョニングし、エージェントのサービス プリンシパルにそれらへのアクセス権を付与して、デプロイを実行します。 展開されたエージェントは agent-bricks-<name>と名付けられます。
agentbricks deploy my-agent
デプロイメントが完了すると、CLIはデプロイメントのURLを返します。 そのURLを開くと、自動的にAzure Databricksモデルのサービスに接続されたライブエージェントとやり取りできます。 展開後の管理には、agentbricks deployments logsやagentbricks deployments stopなどのagentbricks deploymentsコマンドを使いましょう。
既存のエージェントを追加
すでに LangGraph または OpenAI Agents SDK を使用してエージェントを構築済みの場合は、--existing フラグを使用して、そのエージェントを Agent Bricks CLI と DurableAgentServer に移行します。 CLIはコードを書き換えるわけではありません。 その代わりに、Claude Code や Codex などのコーディングエージェントがプロジェクトを変換する際に従う移行手順を作成します。
ステップ1:移行の準備
エージェントのプロジェクトディレクトリから移行の準備をしてください。 エージェントが使用するフレームワークとして、langgraph(LangGraph)または openai(OpenAI Agents SDK)を渡してください。
agentbricks init --framework langgraph --existing .
CLIは、移行手順、コーディングエージェントへのプロンプト、CLIのテンプレートから生成された参照プロジェクトを含む agent-bricks-migrate/ ディレクトリを作成します。 また、コーディング エージェントに指示を示す .claude/skills/ と .agent/skills/ のスキルも追加されます。 このコマンドは、アプリケーションのコード、依存関係、または .env ファイルを変更せず、ワークスペース内にリソースを作成することもありません。
ステップ2: コーディングエージェントを使ってプロジェクトを変換する
agent-bricks-migrate/からのプロンプトをコーディングエージェントに貼り付けてください。 コーディング エージェントは、プロジェクトを agent.toml と DurableAgentServer のエントリ ポイントを使用するように変換し、その変換結果を確認します。
ステップ3:変換を確認する
プロジェクトディレクトリで agentbricks doctor を実行してください:
agentbricks doctor .
agentbricks doctorコードを実行したりAzure Databricksに連絡したりせずにプロジェクトのファイルを検査します。 プロジェクトに有効な agent.toml があり、invoke ハンドラで DurableAgentServer を起動し、そのフレームワーク用のアダプタを呼び出すと、処理は成功します。 レポートの失敗は、変換が完了していないことを意味します。
ステップ 4: クリーンアップ、実行、デプロイ
agent-bricks-migrate/ と、それを参照している 2 つのスキルを削除し、コミットに含めないようにしてください。 その後、 agentbricks dev でエージェントを実行し、 agentbricks deployでデプロイします。
Considerations
-
--existingは、DurableAgentServerを通じて LangGraph および OpenAI Agents SDK をサポートしています。 これは--server customをサポートしていません。 - エージェントをマネージドセッションストアに切り替えても、既存の会話履歴は移動しません。 移行の指示では、以前の会話の処理方法を決めるように求められています。
-
--disable-chat-app、--memory-store、--session-storeの選択肢がリファレンスプロジェクトを形作ります。 彼らは資源を創出しません。
MCPツールの追加
エージェントをAgent Bricks CLIでビルドする場合は、system.aiでプロジェクトに組み込みのagentbricks tools add mcpMCPサービスを追加してください。 このコマンドは、ワークスペース内にそのサービスが存在するかどうかを確認し、そのツールを agent.toml に記録します。 エージェントは実行時にツールに接続するため、接続コードを書く必要はありません。
追加可能なMCPサービスを一覧表示するには、以下のコマンドを実行します:
agentbricks tools list --kind mcp
以下は、一般的な組み込みサービスを追加する例です。
# Answer analytics questions across your workspace with Genie One.
agentbricks tools add mcp system.ai.genie_one_mcp

# Run SQL on a SQL warehouse.
agentbricks tools add mcp system.ai.dbsql

# Connect to third-party applications.
agentbricks tools add mcp system.ai.slack
agentbricks tools add mcp system.ai.github
デフォルトでは、ツールはリクエストをエージェントに送ったユーザーの権限で動作します。 アプリのサービスプリンシパルとして実行するには、 --auth appを追加してください。 Google Drive、Gmail、Googleカレンダー、Microsoft 365では、各ユーザーは最初の呼び出し前に一度だけOAuthログインを行います。
接続アプリケーションを参照してください。
ツールを確認または削除するには、agentbricks tools list または agentbricks tools remove mcp <service> を実行します。。
その他のツールについては、以下のページをご覧ください。
- すべての組み込みのサービスとそれらが何をするか: Databricksが提供するMCPs。
- 独自の外部MCPサーバー: 外部MCPサーバー。
- Unity Catalogはツールとして機能します: Unity Catalog関数を使ってエージェントツールを作成できます。
- 単一のキュレーションされたGenie Agent: Genie Agent MCPサーバー。
agent.toml 参照
agent.toml は、エージェントが使用する Azure Databricks 管理リソースに関する、宣言的な信頼できる情報源です。
agentbricks init がこれを作成し、agentbricks tools add、agentbricks memory bind、agentbricks sessions bind、agentbricks tracing bind がこれを更新し、agentbricks deploy がこれを読み取ってリソースのプロビジョニングやアクセス権の付与を行います。 直接編集することも可能です。
| セクションまたはフィールド | Description |
|---|---|
schema_version |
agent.toml 形式のバージョン。 生成されたプロジェクトでは 1 が使用されます。 |
[agent]
framework
|
フレームワークテンプレート: langgraph か openai。 |
[agent]
server
|
エージェント サーバー: DurableAgentServer の場合は agentbricks、または独自のサーバーの場合は custom。 |
[memory_store]
name
|
エージェントが使用するマネージドメモリストアです。 |
[session_store]
name
|
エージェントが使うマネージドセッションストアです。 |
[tracing]
experiment_name
|
トレース用の MLflow エクスペリメント。 トレースをオフにするにはセクションを削除してください。 |
[[tools]] |
ツールのバインド。 各ツールには、id、auth の値として user または app、ツールを識別する source、およびオプションの policy が設定されています。 |
[auth.user] |
コード内で作成するツールについて、ユーザーからの承認を要求します: required と additional_api_scopes。 詳細は、ユーザー認証の要求を参照してください。 |
以下の例は、agentbricks init が my-agent という名前の LangGraph エージェント用に生成するファイルです:
schema_version = 1

[agent]
framework = "langgraph"
server = "agentbricks"

[memory_store]
name = "my-agent-cuzvas-memory"

[session_store]
name = "my-agent-cuzvas-sessions"

[tracing]
experiment_name = "/Shared/agentbricks_traces/my-agent-cuzvas"
ランダムな接尾辞(この例ではcuzvas )はプロジェクトごとに異なるため、同じ名前のプロジェクトでもストアや実験を共有しません。
以下の例は、agentbricks tools add が書き出すツール バインディングを示しています: 組み込みのMCPサービス、Genieエージェント、そして1つのテーブルにスコープ化されたサンドボックスです。
[[tools]]
id = "web_search"
auth = "user"
source = { kind = "mcp", service = "system.ai.web_search" }

[[tools]]
id = "genie_agent"
auth = "user"
source = { kind = "genie_agent", space_id = "<space-id>" }

[[tools]]
id = "sandbox"
auth = "user"
source = { kind = "sandbox", service = "system.ai.sandbox" }
policy = { downscope = [{ resource = "table:samples.nyctaxi.trips", permission = "read_only" }] }
Unity Catalog関数を呼び出すツールは source = { kind = "uc_function", function = "<catalog>.<schema>.<function>" } を使用し、 auth = "app"のみをサポートします。
コマンド リファレンス
以下の表はAgent BricksのCLIコマンドを示しています。
| Command | Description |
|---|---|
agentbricks login |
プロフィールを認証して、デフォルトとして保存してください。 |
agentbricks logout |
認証情報を削除せずに、保存済みのデフォルトプロファイルを削除します。 |
agentbricks init |
--existing を使って、新しいエージェントプロジェクトのスキャフォールドを作成したり、既存のエージェントを移行に備えたりします。 |
agentbricks doctor |
Agent Bricks CLIのために既存のエージェントが設定されているか確認してください。 |
agentbricks dev |
チャットUIでエージェントをローカルで実行します。 |
agentbricks memory |
長期記憶の管理:ストアのバインドやアンバインド、ストア、エントリー、メモリパイプラインの管理を行います。 |
agentbricks sessions |
会話セッションの管理:ストアのバインドまたはアンバインド、セッションストアの管理を行います。 |
agentbricks tools |
エージェントのツールを一覧表示し、追加し、削除します。 |
agentbricks mcp |
マネージドMCPサービスを発見しましょう。 |
agentbricks tracing |
バインド、アンバインド、およびトレースを点検する。 |
agentbricks deploy |
エージェントをAzure Databricksエージェントランタイムにデプロイしてください。 |
agentbricks deployments |
展開されたエージェントの管理: list、 get、 wait、 logs、 start、 stop、 delete。 |
agentbricks endpoint |
HTTPエンドポイントを呼び出します。 |
agentbricks experimental |
予告なしに変わるかもしれない実験的なコマンド: experimental models と experimental prompts。 |
すべてのフラグやオプションについては、GitHub のAgent Bricks CLIコマンドリファレンスを参照してください。
Troubleshooting
Intel Macでビルド中にインストールが失敗します cryptography
もしIntel Macでソースから cryptography パッケージをビルドしている際にインストールが失敗した場合は、代わりにプリビルドパッケージをインストールしてください。
pipでインストールするには、以下を実行してください:
pip install --only-binary :all: databricks-agentbricks
インストールまたはagentbricks dev実行は、Pythonのバージョンが原因で失敗します
依存関係構築中にインストールやagentbricks devが失敗した場合は、Pythonバージョンをpython3 --versionで確認してください。 スキャフォールドプロジェクトにはPython 3.11以上が必要であり、DatabricksはPython 3.12を推奨しています。 新しいPythonリリースでは、一部の依存関係にプリビルドパッケージがない場合があります。 Python 3.12でCLIをインストールするには、以下を実行します:
uv tool install --python 3.12 databricks-agentbricks
その他のリソース
- エージェントツールとMCPサービス: MCP。
- エージェントメモリの概念とAPI: エージェントメモリ。
- エージェントセッションの概念とAPI: エージェントセッション。
- セッション履歴を要約して長期記憶に保存する: エージェントメモリパイプライン。
- エージェント向けMLflowトレーシング: トレーシングの概要。