Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
GQL (Graph Query Language) to ustandaryzowany język zapytań ISO dla grafowych baz danych. Użyj biblioteki GQL do wydajnego wykonywania zapytań, analizowania i pracy z danymi grafu za pomocą grafu w usłudze Microsoft Fabric.
Ta sama grupa robocza ISO, która standandalizuje język SQL, opracowuje bibliotekę GQL. W związku z tym język GQL udostępnia wiele pojęć dotyczących języka SQL, w tym wyrażeń, predykatów i typów danych. Jeśli masz doświadczenie w języku SQL, możesz zastosować większość tej wiedzy do biblioteki GQL.
Ten artykuł to przewodnik od początku do końca po GQL w grafie. Wyjaśnia, jak język się ze sobą łączy i łączy się z ukierunkowanymi odniesieniami dla pełnej składni i szczegółów typu. Obejmuje:
- Podstawowe pojęcia: grafowe struktury danych, wzorce i podstawy zapytań
-
Podstawowe stwierdzenia:
MATCH, ,FILTERLET,WHEN, ,ORDER BY,LIMIT, orazRETURN - Typy danych i wyrażenia: typy wartości, operatory i wbudowane funkcje
- Zaawansowane techniki: kompozycja z wieloma instrukcjami, określanie zakresu zmiennych i strategie agregacji
Uwaga / Notatka
Oficjalna Norma Międzynarodowa dla GQL to ISO/IEC 39075 Information Technology - Database Languages - GQL.
Jeśli szukasz wskazówek zorientowanych na zadania zamiast przewodnika językowego, zobacz poradniki instruktażowe:
- Pisanie typowych zapytań GQL — sąsiedzi, przechodzenie z wieloma przeskokami, połączenia współużytkowane i kontrole istnienia jednostek
- Filtrowanie i agregowanie danych grafu — funkcje FILTER, WHERE, GROUP BY i aggregate
- Pisanie zapytań wzorca grafu — wzorce wieloskoku, tryby ścieżki, ponowne użycie zmiennej i OPCJONALNE DOPASOWANIE
- Optymalizowanie wydajności zapytań GQL — strategia filtrowania, limity przechodzenia i zalecenia dotyczące ograniczeń kluczowych
Korzystaj z artykułów referencyjnych na temat, gdy potrzebujesz pełnych szczegółów:
| Wymagane informacje | Artykuł definitywny |
|---|---|
| Składnia w skrócie | Szybki przewodnik po GQL |
| Składnia złożenia węzłów, krawędzi, ścieżek i wzorców | Wzorce grafu GQL |
| Operatory, predykaty i funkcje | Wyrażenia GQL, predykaty i funkcje |
| Składnia literalna, zachowanie wartości i konwersje typów | Wartości I typy wartości GQL |
| Definicje typów grafów i ograniczenia | Typy wykresów GQL |
| Obecny zakres funkcji ISO GQL | Zgodność ze standardami GQL |
| Obecne ograniczenia i limity specyficzne dla Fabric | Bieżące ograniczenia |
Wymagania wstępne
Przed rozpoczęciem upewnij się, że znasz następujące pojęcia:
- Basic informacje o bazach danych — doświadczenie w dowolnym systemie bazy danych, takim jak relacyjny (SQL), NoSQL lub graf jest przydatny.
- Pojęcia dotyczące grafu — opis węzłów, krawędzi i relacji w połączonych danych.
- Podstawy zapytań — znajomość podstawowych pojęć związanych z zapytaniami, takich jak filtrowanie, sortowanie i agregacja.
Zalecane tło:
- Doświadczenie w językach SQL lub openCypher ułatwia uczenie się składni GQL (są to korzenie GQL).
- Znajomość modelowania danych pomaga w projektowaniu schematu grafu.
- Opis konkretnego przypadku użycia danych grafu.
Czego potrzebujesz:
- Dostęp do obszaru roboczego grafu z możliwościami zapytań.
- Przykładowe dane lub gotowość do pracy z naszymi przykładami sieci społecznościowych.
- Podstawowy edytor tekstów do pisania zapytań.
Wskazówka
Jeśli dopiero zaczynasz korzystać z grafowych baz danych, zacznij od omówienia modeli danych grafu , zanim przejdziesz do tego przewodnika.
Co sprawia, że GQL specjalne
GQL został zaprojektowany specjalnie dla danych grafowych, więc jego składnia bezpośrednio wyraża, jak jednostki są połączone. Podczas gdy SQL zwykle wyraża relacje poprzez połączenia między tabelami, GQL wykorzystuje wzorce grafów przypominające diagramy danych.
Na przykład następujące zapytanie znajduje pary osób, które się znają i obie urodziły się przed 1999 rokiem:
MATCH (person:Person)-[:knows]-(friend:Person)
WHERE person.birthday < 19990101
  AND friend.birthday < 19990101
RETURN person.firstName || ' ' || person.lastName AS person_name,
       friend.firstName || ' ' || friend.lastName AS friend_name
Wzór (person:Person)-[:knows]-(friend:Person) pokazuje, że struktura relacji jest zgodna. Zmienne łączą obie osoby, dzięki czemu zapytanie może filtrować i zwracać ich właściwości.
Podstawy języka GQL
Te koncepcje stanowią fundament GQL:
- Grafy zawierają węzły i krawędzie z etykietami i właściwościami.
- Typy grafów formalnie definiują typy węzłów, krawędzi oraz ograniczenia dozwolone w grafie.
-
Zapytania wykorzystują instrukcje takie jak
MATCH,FILTER, orazRETURNdo przetwarzania danych i generowania wyników. - Wzory opisują struktury grafów, aby się do nich zgadzały.
- Wyrażenia obliczają , transformują i porównują wartości.
- Predykaty to wyrażenia boolowskie używane do testowania warunków.
- Typy wartości określają rodzaje wartości, które zapytania mogą przetwarzać, a właściwości grafu mogą przechować.
Zrozum dane grafowe
Aby pracować z GQL, musisz zrozumieć strukturę grafu właściwości, którą język zapytuje.
Węzły i krawędzie: bloki konstrukcyjne
Graf z oznakowanymi właściwościami zawiera dwa rodzaje elementów grafu:
- Węzły zazwyczaj reprezentują podmioty, takie jak osoby, organizacje, posty czy produkty.
- Krawędzie reprezentują połączenia między węzłami, na przykład gdy osoba zna inną osobę lub pracuje w firmie.
Każdy element grafu ma swoją tożsamość wewnętrzną, jedną lub więcej etykiet oraz zestaw właściwości. Etykiety klasyfikują elementy, takie jak Person lub knows. Własności to pary nazwy-wartość, takie jak firstName: 'Alice' lub birthday: 19730108u. W Graphie krawędź zawsze ma dokładnie jedną etykietę.
Każda krawędź łączy dokładnie dwa węzły: początek i cel. Kierunek krawędzi jest częścią struktury grafu. Na przykład krawędź workAt może łączyć początek Person punktu odniesienia do celu Company .
Uwaga / Notatka
Obecnie Graph nie obsługuje tworzenia nieskierowanych krawędzi. Możesz zapytać istniejącą skierowaną krawędź w dowolnym kierunku, używając wzorca krawędzi dowolnej skierowanej, takiej jak -[:knows]-.
Grafy są dobrze uformowane: każda krawędź łączy dwa węzły istniejące w tym samym grafie.
Modele grafu i typy grafów
Model grafu Fabric definiuje typy węzłów, typy krawędzi, właściwości, mapowania źródłowe oraz klucze dostępne w grafie. Określa, które wiersze tabeli źródłowej stają się węzłami i krawędziami oraz jak te elementy się łączą. Aby uzyskać wskazówki dotyczące modelowania, zobacz Projektuj schemat grafu.
Standard GQL wykorzystuje typ grafu do formalnego opisu dozwolonych typów węzłów, typów krawędzi, właściwości i ograniczeń. Typy grafów są odpowiednikiem struktury reprezentowanej przez model grafu Fabric na poziomie językowym, jednak Graph obecnie nie akceptuje bezpośrednio deklaracji typów grafów GQL. Aby poznać składnię formalną i pojęcia, zobacz typy grafów GQL.
Przykładowy wykres użyty w tym przewodniku
Przykłady wykorzystują zbiór danych z narzędzi sieci społecznościowych, który obejmuje osoby, miejsca, organizacje, wiadomości, tagi oraz krawędzie je łączące.
Wykres próbny łączy następujące obszary:
- Ludzie znają innych ludzi, pracują w firmach i studiują na uniwersytetach.
- Miasta, kraje lub regiony oraz kontynenty tworzą hierarchię geograficzną.
- Fora zawierają posty, a ludzie tworzą posty i komentarze.
- Tagi kategoryzują treści i reprezentują zainteresowania ludzi.
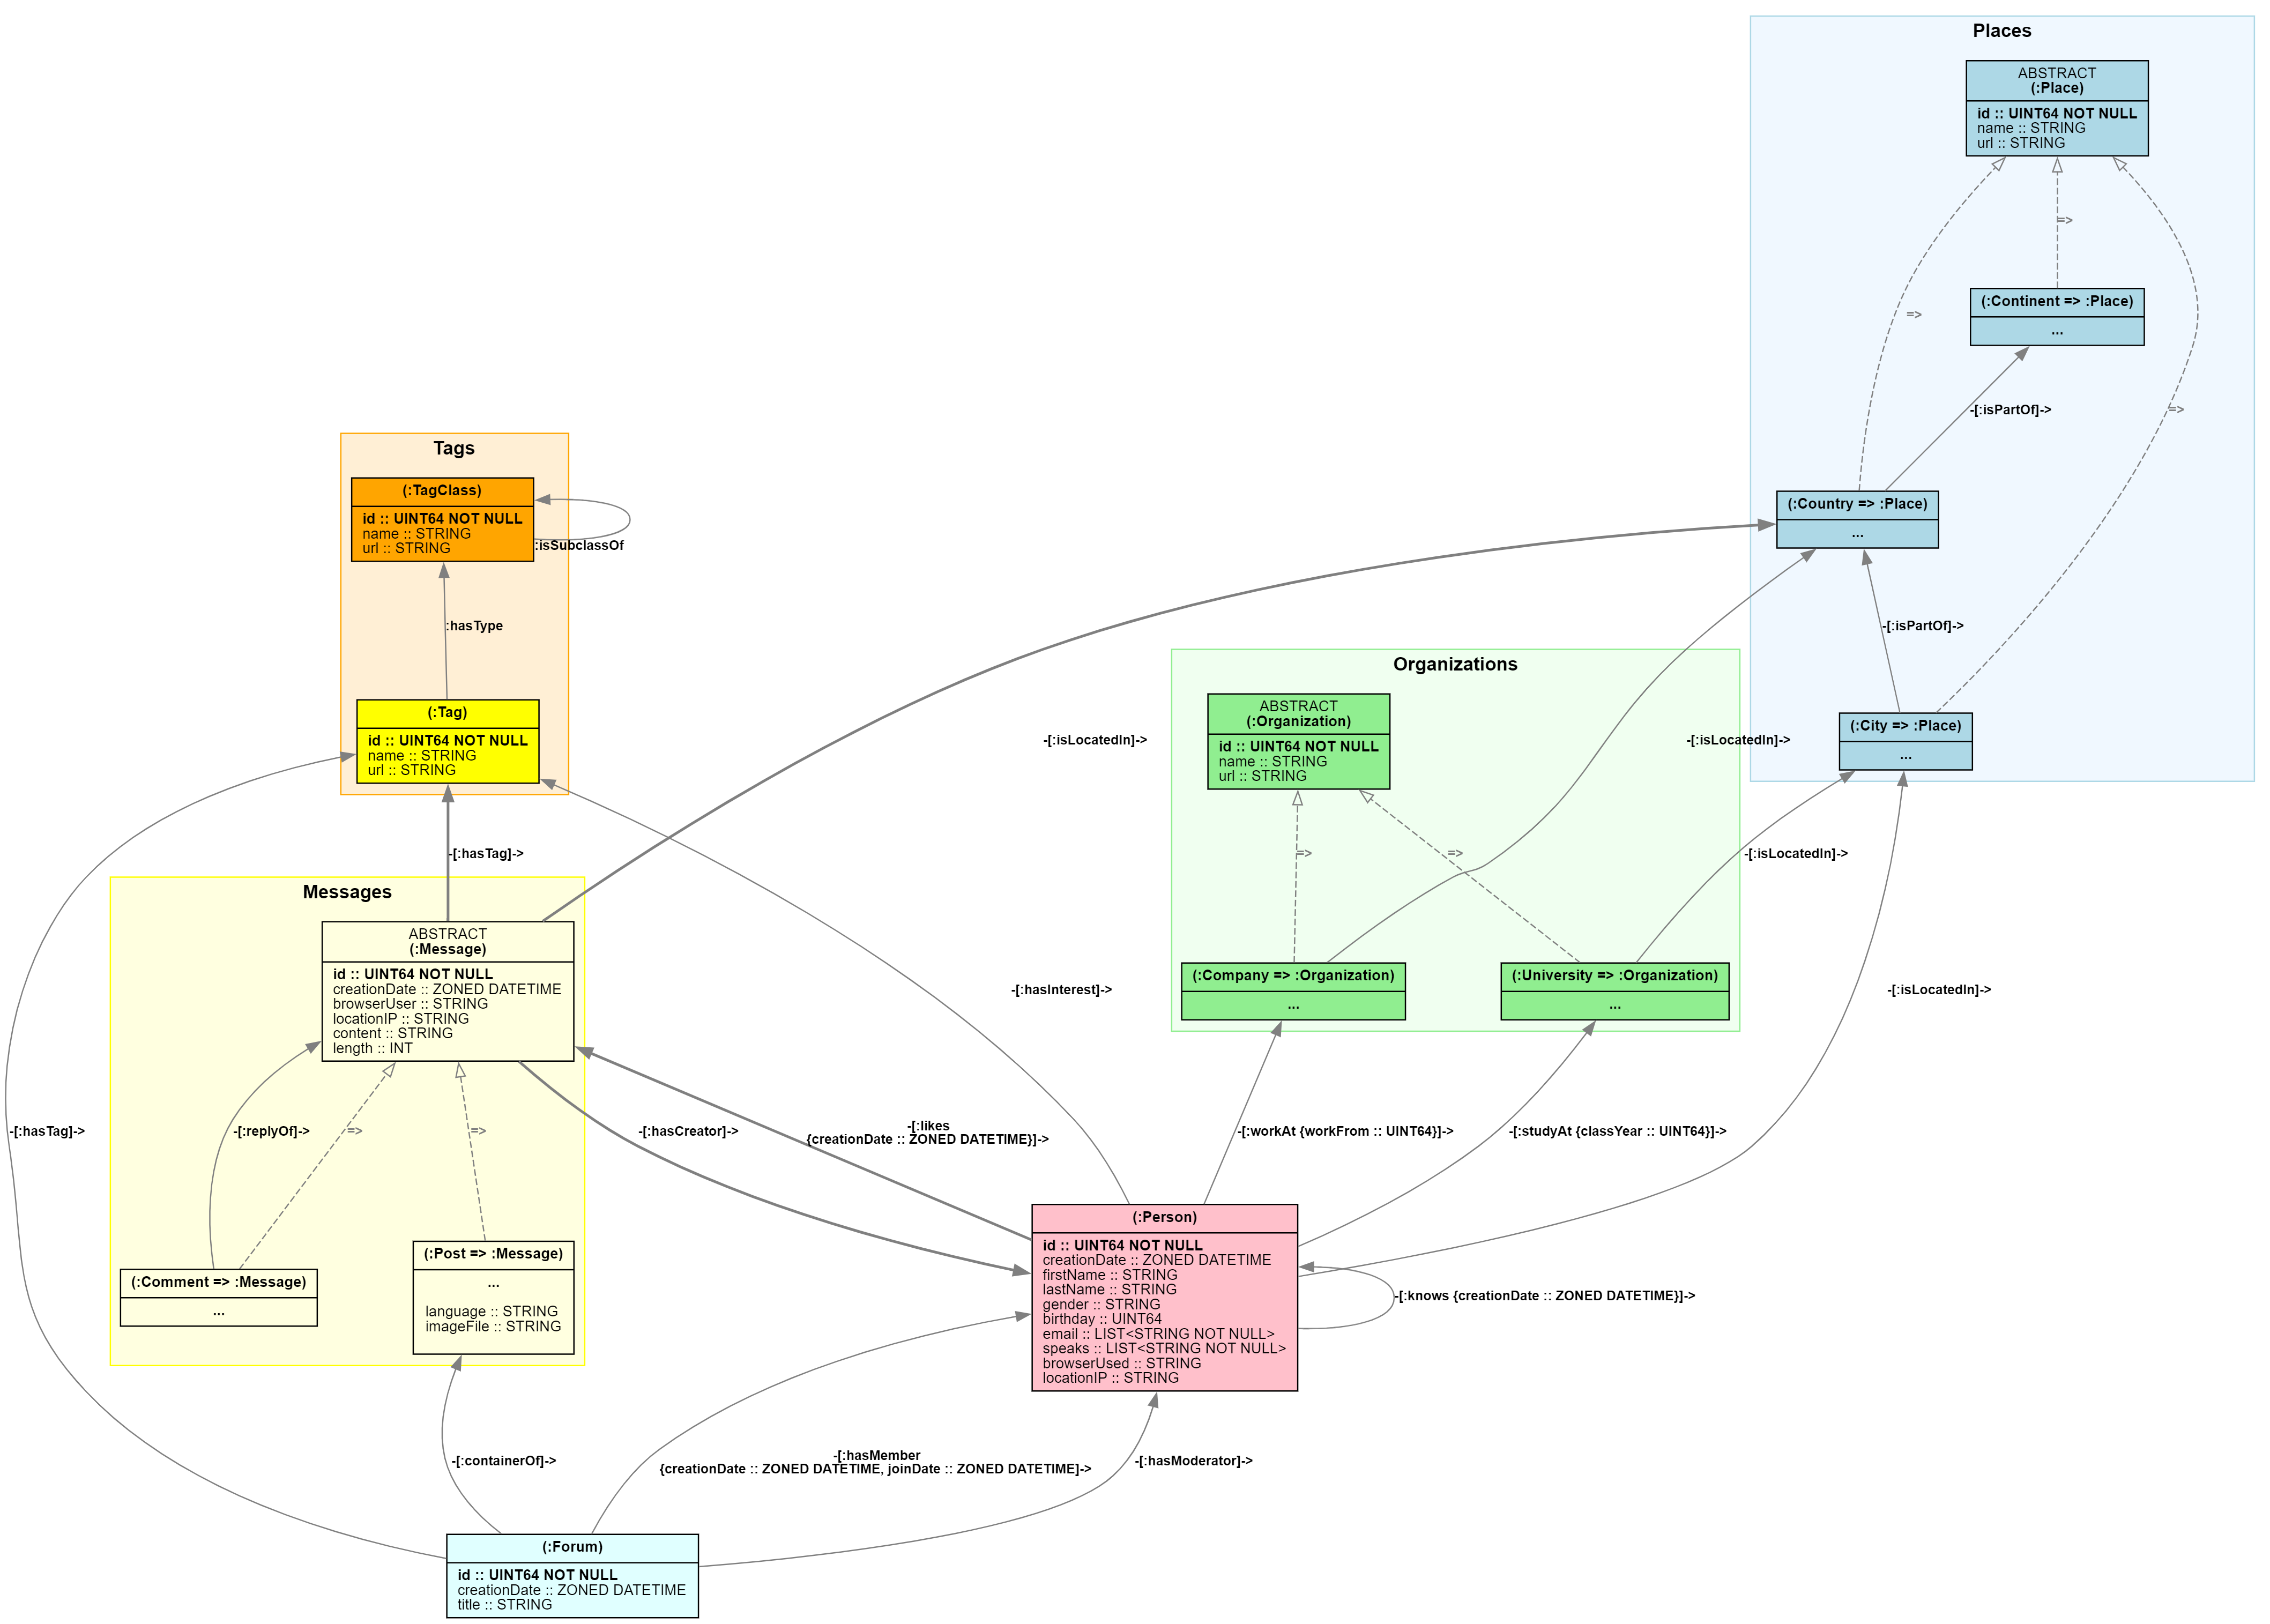
Pełną strukturę przykładu można znaleźć w przykładzie schematu sieci społecznej. Ogólne pojęcia grafów można znaleźć w artykule Oznaczone wykresy własności.
Pierwsze zapytania GQL
Teraz, gdy znasz podstawy grafu, zobaczmy, jak wykonywać zapytania dotyczące danych grafu przy użyciu języka GQL. Te przykłady są kompilować od prostych do złożonych, pokazując, jak podejście GQL sprawia, że zapytania grafu są intuicyjne i zaawansowane.
Rozpocznij od prostego: znajdź wszystkie osoby
Rozpocznij od najbardziej podstawowych możliwych zapytań. Znajdź nazwy (imię, nazwisko) wszystkich osób (:Persons) na grafie.
MATCH (p:Person)
RETURN p.firstName, p.lastName
To zapytanie jest uruchamiane w następujący sposób:
-
MATCHznajduje wszystkie węzły oznaczone etykietąPerson. -
RETURNwyświetla swoje imię i nazwisko.
Dodawanie filtrowania: znajdowanie określonych osób
Teraz znajdź osoby o określonych cechach. W tym przypadku znajdź wszystkich nazwanych Alicji i pokaż swoje nazwiska i urodziny.
MATCH (p:Person)
FILTER p.firstName = 'Alice'
RETURN p.firstName, p.lastName, p.birthday
To zapytanie jest uruchamiane w następujący sposób:
-
MATCHznajduje wszystkie węzły (p) oznaczone etykietą Osoba. -
FILTERwęzły (p), których imię to Alice. -
RETURNwyświetla swoje imię, nazwisko i urodziny.
Podstawowa struktura zapytań
Podstawowe zapytania GQL są zgodne ze spójnym wzorcem: sekwencja instrukcji, które współpracują ze sobą w celu znajdowania, filtrowania i zwracania danych.
Większość zapytań zaczyna się od MATCH znalezienia wzorców na wykresie, a kończy od RETURN określenia wyjścia.
Oto proste zapytanie, które znajduje pary osób znających się nawzajem i mają tę samą datę urodzenia, a następnie zwraca łączną liczbę tych par przyjaciół.
MATCH (n:Person)-[:knows]-(m:Person)
FILTER n.birthday = m.birthday
RETURN count(*) AS same_age_friends
To zapytanie jest uruchamiane w następujący sposób:
-
MATCHznajduje wszystkie pary węzłówPerson, które znają się nawzajem. -
FILTERutrzymuje tylko pary, w których obie osoby mają te same urodziny. -
RETURNliczy, ile takich par przyjaciół istnieje.
Wskazówka
Możesz też filtrować bezpośrednio w wzorze, dodając klauzulę WHERE . Na przykład dopasowuje MATCH (n:Person WHERE n.birthday < 19900101) tylko Person węzły o birthday wartości sprzed 1990 roku.
Język GQL obsługuje komentarze linii w stylu // C, komentarze linii w stylu -- SQL i komentarze blokowe w stylu /* */ C.
Powszechne stwierdzenia
-
MATCH: Identyfikuje wzór grafu do wyszukiwania — to właśnie wtedy definiujesz strukturę interesujących Cię danych. -
LET: Przypisuje nowe zmienne lub obliczane wartości na podstawie dopasowanych danych — dodaje kolumny pochodne do wyniku. -
FOR: Rozszerza listę do wierszy, z opcjonalnym przesunięciem opartym na zerze lub pozycji porządkowej opartej na jednym. -
CALL: Uruchamia podzapytanie wpisowe dla każdego wiersza wejściowego i dodaje kolumny zwracane przez podzapytanie. -
FILTER: Zawęża wyniki poprzez zastosowanie warunków — usuwa wiersze, które nie spełniają kryteriów. -
ORDER BY: Sortuje filtrowane dane — pomaga organizować wyniki na podstawie jednego lub więcej pól. -
OFFSETorazLIMIT: Ogranicz liczbę zwróconych wierszy — przydatne do paginacji lub zapytań top-k. -
RETURN: Określa końcowy wynik — określa, jakie dane powinny być zawarte w zbiorze wyników i wykonuje agregację. -
NEXT: Rozpoczyna kolejny etap zapytania, używając kolumn zwróconych z poprzedniego etapu.
Jak instrukcje współpracują ze sobą
Instrukcje GQL tworzą potok, w którym każde polecenie przetwarza wyjście poprzedniego. To sekwencyjne wykonanie ułatwia czytanie i debugowanie zapytań, ponieważ kolejność wykonania odpowiada kolejności odczytu.
Najważniejsze kwestie:
- Instrukcje są skutecznie wykonywane sekwencyjnie.
- Każde polecenie przekształca dane i przekazuje je kolejnemu.
- Ten proces tworzy przejrzysty, przewidywalny przepływ danych, który upraszcza złożone zapytania.
-
NEXTRozpoczyna się nowy etap zapytania. W kolejnym etapie dostępne są tylko kolumny wyświetlane przez poprzednieRETURNinstrukcje. -
UNION,UNION DISTINCT, oraz łącząUNION ALLwyniki pełnych bloków zapytań.
Uwaga / Notatka
Stwierdzenia mają określony porządek logiczny. Pisz zapytania zgodnie z tym przepływem danych, zamiast polegać na konkretnej strategii fizycznej realizacji.
Przykład kompozycji instrukcji
Poniższe zapytanie GQL znajduje pierwszych 10 osób pracujących w firmach z "Air" w nazwie, sortuje je według pełnej nazwy i zwraca ich pełne imię oraz nazwę firmy.
-- Data flows: Match → Let → Filter → Order → Limit → Return
MATCH (p:Person)-[:workAt]->(c:Company)           -- Input: unit table, Output: (p, c) table
LET fullName = p.firstName || ' ' || p.lastName   -- Input: (p, c) table, Output: (p, c, fullName) table
FILTER c.name CONTAINS 'Air'                      -- Input: (p, c, fullName) table, Output: filtered table
ORDER BY fullName                                 -- Input: filtered table, Output: sorted table
LIMIT 10                                          -- Input: sorted table, Output: top 10 rows table
RETURN fullName, c.name AS companyName            -- Input: top 10 rows table
                                                  -- Output: projected (fullName, companyName) result table
To zapytanie jest uruchamiane w następujący sposób:
-
MATCHZnajdź osoby pracujące w firmach. -
LETtworzy pełne nazwy, łącząc imiona i nazwiska rodzinne. -
FILTERzatrzymuje tylko pracowników firm z "Air" w nazwie firmy. -
ORDER BYsortuje według pełnej nazwy. -
LIMITpobiera pierwsze 10 wyników. -
RETURNZwraca pełne imiona i nazwy firm.
Zmienne łączą dane
Zmienne, takie jak p, ci fullName w poprzednich przykładach, przenoszą dane między instrukcjami. W przypadku ponownego użycia nazwy zmiennej biblioteka GQL automatycznie zapewnia, że odwołuje się do tych samych danych, tworząc zaawansowane warunki sprzężenia. Zmienne są czasami nazywane również zmiennymi powiązania.
Zmienne można kategoryzować na różne sposoby:
Według źródła powiązania:
- Zmienne wzorca — powiązane przez pasujące wzorce grafu
- Zmienne regularne — powiązane z innymi konstrukcjami językowymi
Typy zmiennych wzorca:
-
Zmienne elementów — powiązanie z wartościami odwołania do elementu grafu
- Zmienne węzła — powiązanie z poszczególnymi węzłami
- Zmienne krawędzi — wiązanie z poszczególnymi krawędziami
- Zmienne ścieżki — powiązanie z wartościami ścieżki reprezentującymi dopasowane ścieżki
Według stopnia referencyjnego:
- Zmienne pojedyncze — wiązanie z poszczególnymi wartościami odwołania do elementów z wzorców
- Zmienne grupowe – przypisują listy wartości odniesień elementów z wzorców o zmiennej długości. Szczegóły można znaleźć w sekcji Funkcje agregatu.
Wyniki i wyniki wykonywania
Po uruchomieniu zapytania uzyskasz wynik wykonania , który składa się z następujących elementów:
-
Wynik, zazwyczaj tabela wyników z danymi z twojego
RETURNwyciągu. - Informacje o stanie pokazujące, czy zapytanie zakończyło się pomyślnie, czy nie.
Tabele wyników
Tabela wyników — jeśli jest obecna — jest rzeczywistym wynikiem wykonywania zapytania.
Tabela wyników zawiera informacje o nazwie i typie kolumn, preferowanej sekwencji nazw kolumn, która ma być używana do wyświetlania wyników, czy tabela jest uporządkowana, oraz samych wierszy.
Uwaga / Notatka
Jeśli wykonanie nie powiedzie się, w wyniku wykonania nie zostanie uwzględniona żadna tabela wyników.
Pominięto wyniki
GQL definiuje również pominięty wynik dla zdań, które nigdy nie generują wierszy, niezależnie od danych lub wyniku oceny. Pominięty wynik ma kod 00001statusu pomyślnego ukończenia .
Pominięty wynik różni się od pustej tabeli wyników. Pusta tabela oznacza, że zapytanie generujące wiersze zostało ocenione, ale nie wygenerowało żadnych wierszy. API zapytania może reprezentować pominięty wynik za pomocą rodzaju NOTHINGrezultatu .
Graf rezerwuje pominięte wyniki na potrzeby przyszłego wsparcia instrukcji w językach definicji danych (DDL) oraz języku manipulacji danymi (DML). Obecne instrukcje zapytań generują wyniki tabelowe, w tym puste tabele.
Informacje o stanie
Podczas wykonywania zapytania proces wykrywa różne godne uwagi warunki, takie jak błędy lub ostrzeżenia. Każdy warunek jest rejestrowany przez obiekt stanu w informacjach o stanie wyniku wykonania.
Informacje o stanie składają się z obiektu stanu podstawowego i (prawdopodobnie pustej) listy innych obiektów stanu. Obiekt stanu podstawowego zawsze istnieje i wskazuje, czy wykonanie zapytania zakończyło się pomyślnie, czy nie powiodło się.
Każdy obiekt statusu zawiera pięcioznakowy kod alfanumeryczny oraz opis zapisanego stanu.
API zapytań wykorzystuje następujące podstawowe kody statusu:
| Kod statusu API | Meaning |
|---|---|
00000 |
Pomyślne ukończenie przynajmniej jednego rzędu. |
00001 |
Pomyślne zakończenie z pominiętym wynikiem. Zarezerwowane na przyszłe wsparcie DDL i DML. |
01000 |
Ostrzegawcze lub informacyjne warunki. |
02000 |
Obecnie nie ma dostępnych wierszy z zapytania generującego wiersze. |
42000 |
Błąd zapytania możliwy do poprawy przez użytkownika. |
50000 |
Błąd systemowy lub nieklasyfikowany. |
API zachowuje kanoniczny status GQL, zgłaszany przez silnik zapytań w _graphaneGqlStatus członku rekordu diagnostycznego. Na przykład numeryczne przepełnienie używa kanonicznego GQLSTATUS 22003, podczas gdy dzielenie przez zero używa 22012; oba są reprezentowane przez 42000 w polu publicznym status.code .
Ważne
W kodzie aplikacyjnym używa się status.code go do szerokiego sukcesu i obsługi błędów. Używaj kanonicznego diagnostyki GQLSTATUS, gdy musisz rozróżnić konkretny warunek zapytania. Nie testuj tekstu opisu, bo może się różnić.
Ponadto obiekty stanu mogą zawierać podstawowy obiekt stanu przyczyny i rekord diagnostyczny z dodatkowymi informacjami, które scharakteryzują zarejestrowany warunek.
Podstawowe pojęcia i instrukcje
W tej sekcji opisano podstawowe bloki konstrukcyjne potrzebne do pisania skutecznych zapytań GQL. Każda koncepcja opiera się na praktycznych umiejętnościach pisania zapytań.
Wzorce grafów: znajdź strukturę
Wzór grafu opisuje węzły, krawędzie i ścieżki do dopasowania. Bind zmienne, gdy późniejsze instrukcje muszą odnosić się do dopasowanych elementów:
MATCH (person:Person)-[employment:workAt]->(company:Company)
RETURN person.firstName, company.name, employment.workFrom
Umieść predykat w linii, gdy definiuje, który węzeł lub krawędź może uczestniczyć w wzorcu:
MATCH (person:Person WHERE person.firstName = 'Alice')
      -[:knows]->(friend:Person)
RETURN friend.firstName, friend.lastName
Ponownie użyj zmiennej, aby wymagać dwóch pozycji wzoru do powiązania tego samego elementu.
Oddziel wzorce przecinkami, aby tworzyć większe struktury grafów. Użyj kwantyfikatora, {1,4} na przykład do powtórzenia wzoru krawędzi i dopasowywania ścieżek o zmiennej długości.
Ponowne wykorzystanie elementów sterujących ścieżką w ramach ścieżki:
| Tryb ścieżki | Behavior |
|---|---|
WALK |
Umożliwia powtarzające się węzły i krawędzie. Ten tryb jest domyślny. |
TRAIL |
Zapobiega powtarzającym się krawędziom. |
SIMPLE |
Zapobiega powtarzaniu się węzłów, z wyjątkiem wspólnego pierwszego i ostatniego węzła. |
ACYCLIC |
Zapobiega powtarzającym się węzłom. |
Prefiks przeszukiwania ścieżek decyduje, które odpowiadające ścieżki są zwracane. Wartość domyślna to ALL.
ANY SHORTEST Zwraca jedną najkrótszą ścieżkę dla każdej pary źródło-cel:
MATCH path = ANY SHORTEST
  (source:Person WHERE source.id = 123u)-[:knows]->{1,4}(target:Person)
RETURN target.id, path_length(path) AS hopCount
Predykaty inline ograniczają kwalifikację ścieżki przed wyborem ścieżki.
Operacje na poziomie MATCH ... WHERE instrukcji i późniejsze FILTER są postfiltrami.
To rozróżnienie może zmienić ANY SHORTEST wyniki.
Aby uzyskać definitywną semantykę węzłów, krawędzi, ścieżek, kompozycji, kwantyfikatorów i umiejscowienia predykatów, zobacz wzorce grafów GQL. Aby uzyskać ograniczenia ścieżek prądu, zobacz Ograniczenia prądu.
Instrukcje podstawowe
Biblioteka GQL udostępnia określone typy instrukcji, które współpracują ze sobą w celu przetwarzania danych grafu krok po kroku. Zrozumienie tych instrukcji jest niezbędne do tworzenia skutecznych zapytań.
MATCH, oświadczenie
Składnia:
MATCH <graph pattern>, <graph pattern>, ... [ WHERE <predicate> ]
Instrukcja MATCH pobiera dane wejściowe i znajduje wzorce grafu. Łączy zmienne wejściowe ze zmiennymi wzorca i zwraca wszystkie dopasowane kombinacje.
Zmienne wejściowe i wyjściowe:
-- Input: unit table (no columns, one row)
-- Pattern variables: p, c
-- Output: table with (p, c) columns for each person-company match
MATCH (p:Person)-[:workAt]->(c:Company)
Filtrowanie na poziomie instrukcji przy użyciu metody WHERE:
-- Filter pattern matches
MATCH (p:Person)-[:workAt]->(c:Company) WHERE p.lastName = c.name
Wszystkie dopasowania można filtrować po filtrowaniu przy użyciu polecenia WHERE. Takie podejście pozwala uniknąć oddzielnej FILTER instrukcji. Przy prefiksie przeszukiwania ścieżek, takim jak ANY SHORTEST, poziom instrukcji WHERE obowiązuje po wybraniu ścieżki. Predykaty inline zamiast tego ograniczają, które ścieżki kwalifikują się do wyboru. Więcej informacji można znaleźć w artykule Place predykaty przed lub po wyborze ścieżki.
Łączenie przy użyciu zmiennych wejściowych:
Gdy MATCH nie jest pierwszą instrukcją, łączy dane wejściowe z dopasowaniami wzorca:
...
-- Input: table with 'targetCompany' column
-- Implicit join: targetCompany (equality join)
-- Output: table with (targetCompany, p, r) columns
MATCH (p:Person)-[r:workAt]->(targetCompany)
Ważne
Graf obsługuje podstawowe i pełne liniowe składanie zdań, w tym NEXT. Możesz także łączyć bloki zapytań z UNION, UNION DISTINCT, oraz UNION ALL. Operacje EXCEPT, INTERSECT, i OTHERWISE zbiorów nie są jeszcze obsługiwane. Aby uzyskać więcej informacji, zobacz artykuł dotyczący bieżących ograniczeń.
Zachowania łączenia kluczy:
Jak MATCH obsługuje dołączanie danych:
- Równość zmiennych: sprzężenia zmiennych wejściowych ze zmiennymi wzorca przy użyciu dopasowywania równości
-
Sprzężenie wewnętrzne: wiersze wejściowe bez dopasowań wzorca są odrzucane. Służy
OPTIONAL MATCHdo zachowania sprzężenia lewego i zewnętrznego. -
Kolejność filtrowania: Filtry na poziomie
WHEREinstrukcji po zakończeniu dopasowania wzorców i wyboru ścieżki - Kompozycja wzorców: Zmienne współdzielone ograniczają wzorce do tego samego elementu. Niespójne wzorce tworzą iloczyn kartezjański.
Ważne
Niespójny wzór jest poprawny, ale jego iloczyn kartezjański może tworzyć wiele wierszy. Używaj zmiennych współdzielonych, gdy wzorce powinny odnosić się do tych samych elementów grafu.
Łączenie wzorców ze zmiennymi współdzielonymi:
-- Shared variable 'p' joins the two patterns
-- Output: people with both workplace and residence data
MATCH (p:Person)-[:workAt]->(c:Company),
      (p)-[:isLocatedIn]->(city:City)
OPTIONAL MATCH, oświadczenie
Składnia:
OPTIONAL MATCH <graph pattern> [ WHERE <predicate> ]
OPTIONAL MATCH działa jak MATCH , ale używa semantyki sprzężenia lewego zewnętrznego. Jeśli wzorzec nie znajdzie dopasowania dla wiersza wejściowego, zapytanie zachowuje wiersz z wartościami NULL niedopasowanych zmiennych zamiast go odrzucać.
Example:
-- Find all people and, if available, their workplace
MATCH (p:Person)
OPTIONAL MATCH (p)-[:workAt]->(c:Company)
RETURN p.firstName, p.lastName, c.name AS company_name
Osoby, które nie pracują w żadnej firmie, nadal pojawiają się w wynikach dla NULL .company_name
Wskazówka
Użyj OPTIONAL MATCH polecenia , jeśli chcesz uwzględnić jednostki, które mogą nie mieć określonej relacji, podobnie jak w przypadku języka SQL LEFT JOIN.
LET, oświadczenie
Składnia:
LET <variable> = <expression>, <variable> = <expression>, ...
Instrukcja LET tworzy obliczone zmienne i umożliwia przekształcanie danych w potoku zapytania.
Tworzenie zmiennej podstawowej:
MATCH (p:Person)
LET fullName = p.firstName || ' ' || p.lastName
RETURN *
LIMIT 1000
Złożone obliczenia:
MATCH (p:Person)
LET adjustedAge = 2000 - (p.birthday / 10000),
    fullProfile = p.firstName || ' ' || p.lastName || ' (' || p.gender || ')'
RETURN *
LIMIT 1000
Kluczowe zachowania:
- Aparat zapytań ocenia wyrażenia dla każdego wiersza wejściowego.
- Wyniki stają się nowymi kolumnami w tabeli wyjściowej.
- Zmienne mogą odwoływać się tylko do istniejących zmiennych z poprzednich instrukcji.
- Wiele przypisań w jednym
LETzawołaniu korzysta z tego samego zakresu wejściowego, więc przypisanie nie może odwołać się do innego przypisania z tego indykcji.
FOR, oświadczenie
Składnia:
FOR <variable> IN <list_expression>
  [ WITH OFFSET <offset_variable> | WITH ORDINALITY <ordinality_variable> ]
To FOR sformułowanie rozszerza listę na wiersze. Dla każdego wiersza wejściowego generuje jeden wiersz wyjściowy dla każdego elementu listy i wiąże ten element z podaną zmienną. Pozostałe zmienne z wiersza wejściowego pozostają dostępne.
Użyj WITH OFFSET do powiązania indeksu opartego na zero lub do WITH ORDINALITY powiązania pozycji opartej na jednym.
LET cities = ['Seattle', 'London', 'Tokyo']
FOR city IN cities WITH ORDINALITY position
RETURN city, position
To zapytanie zwraca jeden wiersz dla każdego miasta. Wartości position to 1, 2, oraz 3. Jeśli zastąpimy WITH ORDINALITY position przez , WITH OFFSET positionwartości to 0, 1, oraz 2.
Wyrażenie źródłowe musi być wyrażone do listy. Wartość nie-lista powoduje niepowodzenie zapytania.
CALL, oświadczenie
Użyj do CALL uruchomienia podzapytania w linii dla każdego wiersza wejściowego:
CALL {
  <query statements>
  RETURN <columns>
}
Zmienne, które już znajdują się w zakresie, są domyślnie dostępne wewnątrz podzapytania. Spośród zmiennych utworzonych wewnątrz podzapytania, tylko kolumny z RETURN jego końcowego zapytania są dostępne poza nim. Zmienne utworzone wewnątrz podzapytania, ale nie zwrócone, pozostają lokalne.
Poniższe powiązane podzapytanie oblicza liczbę pracodawców dla każdej osoby:
MATCH (p:Person)
CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN count(*) AS employerCount
}
RETURN p.firstName, p.lastName, employerCount
ORDER BY employerCount DESC
Zwykłe CALL działa jak zależne wewnętrzne połączenie. Generuje jeden wiersz wyjściowy dla każdego wiersza zwracanego przez podzapytanie. Jeśli podzapytanie nie zwraca żadnych wierszy, odpowiadający mu zewnętrzny wiersz nie zostaje zwrócony. Jeśli zwraca wiele wierszy, zewnętrzny wiersz pojawia się raz dla każdego wiersza podzapytania.
Powyższy count(*) przykład zawsze zwraca jeden wiersz podzapytania, ponieważ używa niegrupowanego agregatu. Osoba bez dopasowanego pracodawcy ma więc .employerCount0
Użyj OPTIONAL CALL jako lewego dołączenia zależnego. Gdy podzapytanie nie zwraca żadnych wierszy, zachowuje jeden zewnętrzny wiersz i ustawia zwrócone kolumny podzapytania na .NULL Gdy podzapytanie zwraca wiele wierszy, generuje jeden wiersz wyjściowy dla każdego wiersza podzapytania.
MATCH (p:Person)
OPTIONAL CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN company.name AS companyName
}
RETURN p.firstName, p.lastName, companyName
Możesz zagnieżdżać podzapytania inline CALL . Zagnieżdżone podzapytanie może odwoływać się do zmiennych z zakresów zapytań otaczających je otaczającymi.
Ważne
Każdy ciało w linii CALL zakończ się słowami RETURN. Graph nie obsługuje wywołań procedur nazwanych ani jawnych list importu zmiennych, takich jak CALL (p) { ... }.
FILTER, oświadczenie
Składnia:
FILTER [ WHERE ] <predicate>
Instrukcja FILTER zapewnia dokładną kontrolę nad tym, które dane przechodzą przez potok zapytania.
Podstawowe filtrowanie:
MATCH (p:Person)
FILTER p.birthday < 19980101 AND p.gender = 'female'
RETURN *
Złożone warunki logiczne:
MATCH (p:Person)
FILTER (p.gender = 'male' AND p.birthday < 19940101)
  OR (p.gender = 'female' AND p.birthday < 19990101)
  OR p.browserUsed = 'Edge'
RETURN *
Wzorce filtrowania z obsługą wartości null:
Użyj tych wzorców, aby bezpiecznie obsługiwać wartości null:
-
Sprawdzanie wartości:
p.firstName IS NOT NULL— ma imię -
Weryfikowanie danych:
p.id > 0— prawidłowy identyfikator -
Obsługa brakujących danych:
NOT coalesce(p.locationIP, '10.x.x.x') STARTS WITH '10.x.x.x'— nie nawiązała połączenia z sieci lokalnej -
Łączenie warunków: użyj
AND/ORz jawnymi sprawdzaniem wartości null dla złożonej logiki
Ostrzeżenie
Pamiętaj, że warunki obejmujące wartości null zwracają UNKNOWNwartość , która filtruje te wiersze. Użyj jawnych IS NULL testów, gdy potrzebujesz logiki inkluzywnej o wartości null.
ORDER BY, oświadczenie
Składnia:
ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ],
         <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ...
Sortowanie na wielu poziomach przy użyciu wyrażeń obliczanych:
MATCH (p:Person)
RETURN *
ORDER BY p.firstName DESC,               -- Primary: by first name (Z-A)
         p.birthday ASC,                 -- Secondary: by age (oldest first)
         p.id DESC                       -- Tertiary: by ID (highest first)
Obsługa wartości null w sortowaniu:
MATCH (p:Person)
RETURN p.firstName, p.birthday
ORDER BY p.birthday DESC NULLS LAST, p.firstName ASC
Szczegóły zachowania sortowania:
Informacje o sposobie ORDER BY działania:
- Aparat zapytań ocenia wyrażenia dla każdego wiersza, a następnie wyniki określają kolejność wierszy.
- Wiele kluczy sortowania tworzy kolejność hierarchiczną (podstawową, pomocniczą, trzeciorzędną itd.).
-
NULLS FIRSTStawia wartości zerowe przed wartościami niezerowymi.NULLS LASTumieszcza je po wartościach niezerowych. - Rozmieszczenie zera jest niezależne od kierunku sortowania. Jeśli nie określisz zerowego porządku,
NULLS LASTjest domyślnym dla obuDESCASC. -
ASC(rosnąco) jest kolejnością domyślną i musisz jawnie określićDESC(malejąco). - Można sortować według wartości obliczeniowych, a nie tylko przechowywanych właściwości.
| Specyfikacja sortowania | Powstały porządek |
|---|---|
ASC lub ASC NULLS LAST |
Wartości niezerowe w kolejności rosnącej, następnie wartości zerowe. |
ASC NULLS FIRST |
Wartości zerowe, a następnie wartości niezerowe w kolejności rosnącej. |
DESC lub DESC NULLS LAST |
Wartości niezerowe w kolejności malejącej, a następnie wartości zerowe. |
DESC NULLS FIRST |
Wartości zerowe, a następnie wartości niezerowe w kolejności malejącej. |
Ostrzeżenie
Tylko natychmiast poniższa instrukcja może zobaczyć kolejność sortowania, która ORDER BY ustanawia.
W związku z tym, ORDER BY a następnie RETURN * nie generuje uporządkowanego wyniku.
Porównywać:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
ORDER BY r.creationDate DESC
/* intermediary result _IS_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
/* final result _IS_ _NOT_ guaranteed to be ordered here  */
tym:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
/* intermediary result _IS_ _NOT_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
ORDER BY r.creationDate DESC
/* final result _IS_ guaranteed to be ordered here              */
Ta różnica ma natychmiastowe konsekwencje dla zapytań "Top-k": LIMIT zawsze musi postępować zgodnie z instrukcją ORDER BY , która ustanawia docelową kolejność sortowania.
OFFSET i LIMIT instrukcje
Składnia:
  OFFSET <offset> [ LIMIT <limit> ]
| LIMIT <limit>
Typowe wzorce:
-- Basic top-N query
MATCH (p:Person)
RETURN *
ORDER BY p.id DESC
LIMIT 10                                 -- Top 10 by ID
Ważne
W przypadku przewidywalnych wyników stronicowania należy zawsze używać ORDER BY przed OFFSET i LIMIT zapewnić spójne porządkowanie wierszy w zapytaniach.
RETURN: podstawowa projekcja wyników
Składnia:
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
[ ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
Instrukcja RETURN generuje końcowe dane wyjściowe zapytania, określając, które dane są wyświetlane w tabeli wyników.
Podstawowe dane wyjściowe:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday,
       c.name
Używanie aliasów w celu uzyskania jasności:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS first_name,
       p.lastName AS last_name,
       c.name AS company_name
Połącz z sortowaniem i top-k:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday AS birth_year,
       c.name AS company
ORDER BY birth_year ASC
LIMIT 10
Zduplikowana obsługa przy użyciu funkcji DISTINCT:
-- Remove duplicate combinations
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN DISTINCT p.gender, p.browserUsed, p.birthday AS birth_year
ORDER BY p.gender, p.browserUsed, birth_year
Połącz z agregacją:
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN count(DISTINCT p) AS employee_count
RETURN z GROUP BY: pogrupowane projekcje wyników
Składnia:
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
GROUP BY <variable>, <variable>, ...
[ ORDER BY <expression> [ ASC | DESC ], <expression> [ ASC | DESC ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
Służy GROUP BY do grupowania wierszy według wartości udostępnionych i funkcji agregacji obliczeniowej w każdej grupie.
Podstawowe grupowanie za pomocą agregacji:
MATCH (p:Person)-[:workAt]->(c:Company)
LET companyId = c.id, companyName = c.name
RETURN companyId,
       companyName,
       count(*) AS employeeCount,
       avg(p.birthday) AS avg_birth_year
GROUP BY companyId, companyName
ORDER BY employeeCount DESC
Grupowanie wielokolumna:
MATCH (p:Person)
LET gender = p.gender
LET browser = p.browserUsed
RETURN gender,
       browser,
       count(*) AS person_count,
       avg(p.birthday) AS avg_birth_year,
       min(p.creationDate) AS first_joined,
       max(p.id) AS highest_id
GROUP BY gender, browser
ORDER BY avg_birth_year DESC
LIMIT 10
Uwaga / Notatka
Aby uzyskać agregację poziomą nad wzorcami o zmiennej długości, zobacz Funkcje agregatu.
Wartości i typy wartości
Wartości GQL obejmują wartości Boolean, string, numeric, temporal, list, node, edge, path, null oraz nothing. Typy są unieważnialne, chyba że określisz NOT NULL.
Właściwości wykorzystują wspierany podzbiór pełnego systemu wartości zapytań.
RETURN 42 AS integerValue,
       'Alice' AS stringValue,
       TRUE AS booleanValue,
       [1, 2, 3] AS listValue
Porównania z zerowym ewaluują do UNKNOWN; użyć IS NULL i dla testów IS NOT NULL zerowych. Operacje numeryczne mogą stosować niejawne konwersje między kompatybilnymi typami numerycznymi.
Uwaga / Notatka
Nie każdy typ wartości GQL jest obsługiwany we wszystkich kontekstach grafów. Aktualne ograniczenia właściwości i zapytań można znaleźć w artykule Typy danych.
W przypadku składni literalnej, zachowań porównawczych, konwersji typów oraz hierarchii typów zobacz wartości GQL i typy wartości.
Expressions
Wyrażenia obliczają, porównują, agregują i transformują wartości. Do popularnych form należą odwołania do właściwości, operatory arytmetyczne i logiczne, predykaty, wywołania funkcji, wyrażenia proste CASE oraz podzapytania:
MATCH (person:Person)
FILTER person.birthday < 19900101
RETURN person.firstName,
       CASE person.gender
         WHEN 'female' THEN 'F'
         WHEN 'male' THEN 'M'
         ELSE 'Other'
       END AS genderCode
GQL wykorzystuje logikę trójwartościową: wyrażenia boole'owskie mogą być obliczane do , TRUEFALSE, lub UNKNOWN. A zachowuje FILTER tylko wiersze, dla których jego predykat to .TRUE
Funkcje agregujące takie jak COUNT, SUM, AVG, MIN, i MAX podsumowują wiersze. Wymień predykaty takie jak ALL, ANY, NONE, i SINGLE wymień predykat dla elementów listy. Podzapytania w formie EXISTS procedury sprawdzają, czy zagnieżdżone zapytanie zwraca wiersz.
Dla pełnego zachowania operatora, predykatu, agregatu i funkcji zobacz wyrażenia GQL, predykaty i funkcje. Przykłady filtrowania i grupowania zorientowanego na zadania można znaleźć w artykule Filtruj i agreguj dane grafowe.
Zaawansowane techniki zapytań
W tej sekcji opisano zaawansowane wzorce i techniki tworzenia złożonych, wydajnych zapytań grafów. Te wzorce wykraczają poza podstawowe użycie instrukcji, aby ułatwić tworzenie zaawansowanych zapytań analitycznych.
Złożona kompozycja wielostanowa
Ważne
Graf obsługuje kompozycję instrukcji podstawowej i pełnej liniowej. Operacje EXCEPT, INTERSECT, i OTHERWISE zbiorów nie są jeszcze obsługiwane. Aby uzyskać więcej informacji, zobacz artykuł dotyczący bieżących ograniczeń.
Efektywne tworzenie złożonych zapytań ma kluczowe znaczenie dla zaawansowanych zapytań grafów.
UNION i UNION ALL
Użyj UNION, UNION DISTINCT, lub UNION ALL aby połączyć wyniki z dwóch lub więcej liniowych bloków zapytań:
<query block>
UNION [ DISTINCT | ALL ]
<query block>
-- Combine results from two separate pattern matches
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS name, c.name AS affiliation
UNION DISTINCT
MATCH (p:Person)-[:studyAt]->(u:University)
RETURN p.firstName AS name, u.name AS affiliation
Gołe jest UNION równoważne ; UNION DISTINCToba usuwają zduplikowane wiersze.
UNION ALL przechowuje wszystkie wiersze, w tym duplikaty.
Każdy blok zapytań musi zwracać ten sam zestaw nazw kolumn. Kolejność kolumn może się różnić między blokami, a typy danych muszą być kompatybilne.
NEXT
Użyj do NEXT wykonania kolejnego etapu zapytania na tabeli zwróconej przez poprzedni etap:
<query stage>
RETURN <columns>
NEXT
<query stage>
Następujące zapytanie znajduje pracowników i ich firmy, a następnie wykorzystuje zwrócone węzły pracownicze w innym dopasowaniu wzorców:
MATCH (person:Person)-[:workAt]->(company:Company)
RETURN person, company.name AS companyName
NEXT
MATCH (person)-[:isLocatedIn]->(city:City)
RETURN person.firstName AS employee, companyName, city.name AS city
Tylko kolumny zwrócone przez poprzedni etap są objęte po NEXT. Możesz użyć wielu NEXT separatorów, aby zbudować dłuższą sekwencję etapów zapytań.
Każdy etap może zawierać zjednoczenie bloków zapytań. Suma jest oceniana w obrębie swojego etapu, zanim wyjście etapu przekroczy granicę NEXT . Jeśli A, B, i reprezentują C bloki zapytań, A UNION B NEXT C grupują jako (A UNION B) NEXT C, a A NEXT B UNION C grupy jako A NEXT (B UNION C).
Instrukcje warunkowe
Użyj instrukcji warunkowej, aby przekierować każdy przychodzący wiersz do pierwszej gałęzi, której predykat oblicza się jako TRUE:
WHEN <predicate> THEN <linear query statement or { query statements }>
[ WHEN <predicate> THEN <linear query statement or { query statements }> ... ]
[ ELSE <linear query statement or { query statements }> ]
Aby przeprowadzić wiersze z etapu zapytania, zwróć wymagane kolumny i użyj NEXT przed warunkowym zapytaniem:
MATCH (p:Person)
RETURN p.firstName AS name, p.birthday AS birthday
NEXT
WHEN birthday < 19800101u THEN
  RETURN name, 'Before 1980' AS era
WHEN birthday < 20000101u THEN
  RETURN name, '1980-1999' AS era
ELSE
  RETURN name, '2000 or later' AS era
Każdy WHEN predykat musi być booleuszowski. Silnik zapytań ocenia predykaty w kolejności dla każdego wiersza wejściowego. Predykat, który ocenia do FALSE lub UNKNOWN nie wybiera swojej gałęzi. Po tym, jak predykat zostanie wyliczony do , TRUEpóźniejsze predykaty i niezaznaczone ciała gałęzi nie są oceniane. Jeśli żaden predykat nie jest obliczany do i TRUE nie ELSEma , wiersz wejściowy nie jest zwracany.
Predykaty i ciała gałęzi mogą odwoływać się do kolumn z poprzedniego etapu. Gałęzia może być jednym liniowym zdaniem lub zagnieżdżoną procedurą zamkniętą w nawiasach. Używaj procedury zagnieżdżonej, gdy gałąź wymaga wielu etapów lub instrukcji, takich jak CALL:
MATCH (p:Person)
RETURN p, p.firstName AS name
NEXT
WHEN p.gender = 'female' THEN {
  CALL {
    MATCH (p)-[:knows]->(friend:Person)
    RETURN count(*) AS friendCount
  }
  RETURN name, friendCount
}
ELSE
  RETURN name, 0u AS friendCount
Każda gałąź ma swój własny lokalny zakres. Gałęzie rodzeństwa nie widzą zmiennych utworzonych przez inną gałąź, a tylko kolumny z ostatniej RETURN gałęzi wybranej gałęzi kontynuują się po warunkowym zaleceniu. Każda gałąź musi zwracać te same nazwy kolumn, a odpowiadające im typy wyników muszą być kompatybilne. Silnik zapytań zmusza kompatybilne typy do wspólnego typu wyjścia. Zwrócona kolumna rozgałęzienia może używać tej samej nazwy co kolumna przychodząca; wartość gałęzi zastępuje wartość przychodzącą w wyjściu warunkowym.
Zdania warunkowe różnią się od CASE wyrażeń. Graph obsługuje proste CASE <expression> WHEN <value>, ale nie CASE WHEN <predicate> wyszukiwane wyrażenia. Więcej informacji można znaleźć w artykule Wyrażenia warunkowe.
Zakres zmiennych i zaawansowana kontrola przepływu
Zmienne łączą dane między instrukcjami zapytań i umożliwiają przechodzenie złożonych grafów. Zrozumienie zaawansowanych reguł zakresu ułatwia pisanie zaawansowanych zapytań obejmujących wiele instrukcji.
Wzorce powiązań zmiennych i określania zakresu
-- Variables flow forward through subsequent statements
MATCH (p:Person)                                    -- Bind p
LET fullName = p.firstName || ' ' || p.lastName     -- Bind concatenation of p.firstName and p.lastName as fullName
FILTER fullName CONTAINS 'Smith'                    -- Filter for fullNames with “Smith” substring (p is still bound)
RETURN p.id, fullName                               -- Only return p.id and fullName (p is dropped from scope)
Ponowne użycie zmiennej dla sprzężeń między instrukcjami
-- Multi-statement joins using variable reuse
MATCH (p:Person)-[:workAt]->(:Company)          -- Find people with jobs
MATCH (p)-[:isLocatedIn]->(:City)               -- Same p: people with both job and residence
MATCH (p)-[:knows]->(friend:Person)             -- Same p: their social connections
RETURN *
Krytyczne reguły określania zakresu i ograniczenia
-- ✅ Backward references work
MATCH (p:Person)
LET adult = p.birthday < 20061231  -- Can reference p from previous statement
RETURN *

-- ❌ Forward references don't work
LET adult = p.birthday < 20061231  -- Error: p not yet defined
MATCH (p:Person)
RETURN *

-- ❌ Variables in same LET statement can't reference each other
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName,
    greeting = 'Hello, ' || name     -- Error: name not visible yet
RETURN *

-- ✅ Use separate statements for dependent variables
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName
LET greeting = 'Hello, ' || name     -- Works: name now available
RETURN *
Widoczność zmiennych w złożonych zapytaniach
-- Variables remain visible until overridden or query ends
MATCH (p:Person)                     -- p available from here
LET gender = p.gender                -- gender available from here
MATCH (p)-[:knows]->(e:Person)       -- p still refers to original person
                                     -- e is a new variable for the friend
RETURN p.firstName AS manager, e.firstName AS friend, gender
Ostrzeżenie
Zmienne w tej samej instrukcji nie mogą odwoływać się do siebie, z wyjątkiem wzorców grafów. Użyj oddzielnych instrukcji do tworzenia zmiennych zależnych.
Wiersze agregowane i elementy ścieżki
GQL obsługuje dwa konteksty agregacji:
-
Pionowa agregacja podsumowuje wiersze wejściowe, opcjonalnie podzielone na
GROUP BYzmienne. - Pozioma agregacja podsumowuje listę grupową ograniczoną wzorem krawędzi o zmiennej długości w obrębie jednej dopasowanej ścieżki.
MATCH (person:Person)-[:workAt]->(company:Company)
LET companyId = company.id, companyName = company.name
RETURN companyId, companyName, count(*) AS employeeCount
GROUP BY companyId, companyName
MATCH (:Person)-[connections:knows]->{1,4}(:Person)
RETURN count(connections) AS pathLength
Aby uzyskać zapytania grupowe, filtry specyficzne dla agregatów, agregaty kolekcji oraz trasowanie warunkowe, zobacz Filtruj i agreguj dane grafów. Pełne reguły wyników agregatu można znaleźć w artykule Funkcje agregowane.
Obsługa błędów zerowych i zapytań
Stosuj jawne testy zerowe, gdy brakujące wartości wymagają odrębnej obsługi:
MATCH (person:Person)
FILTER person.browserUsed IS NULL
RETURN person.firstName
Porównanie z nulową daje UNKNOWNwartość , której a nie FILTER zachowuje.
Używaj coalesce() , gdy potrzebujesz wartości awaryjnej.
Wyniki zapytań obejmują informacje o statusie sukcesu, ostrzeżenia, warunki bez danych, błędy korygowalne przez użytkownika oraz błędy systemowe. Użyj publicznego kodu statusowego dla szerokiego przepływu sterowania oraz kanonicznej diagnostyki GQLSTATUS dla konkretnego stanu. Zobacz wyniki i wyniki wykonania oraz odniesienie do kodów statusu GQL.
Słowa zastrzeżone
GQL rezerwuje niektóre słowa kluczowe, których nie można używać jako identyfikatorów, takich jak zmienne, nazwy właściwości lub nazwy etykiet. Aby uzyskać pełną listę, zobacz odwołanie do zarezerwowanych słów języka GQL .
Jeśli musisz użyć zarezerwowanych słów jako identyfikatorów, należy je użyć za pomocą backticks: `match`, `return`.
Aby uniknąć ucieczki od zastrzeżonych słów, użyj tej konwencji nazewnictwa:
- W przypadku identyfikatorów jedno wyrazów dołącz podkreślenie:
:Product_ - W przypadku identyfikatorów z wieloma wyrazami użyj camelCase lub PascalCase:
:MyEntity, ,:hasAttributetextColor
Dalsze kroki
- Skorzystaj z szybkiego startu lub tutorialu GQL , aby uzyskać praktyczne wprowadzenie.
- Użyj Write Common GQL queries do gotowych do adaptacji zadań grafowych.
- Do szczegółowego odniesienia używaj wzorców grafów GQL, wyrażeń GQL, predykatów i funkcji oraz wartości i typów wartości GQL .
- Użyj schematu projektowania grafu dla obsługiwanego workflow modelowania Fabric.