Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Mirroring w Microsoft Fabric ułatwia proces unikania złożonych operacji ETL (wyodrębnianie, transformacja, ładowanie) i integracji istniejących danych z resztą danych w Microsoft Fabric. Istniejące dane można stale replikować bezpośrednio do usługi OneLake firmy Fabric. Wewnątrz sieci szkieletowej można odblokować zaawansowane scenariusze analizy biznesowej, sztucznej inteligencji, inżynierii danych, nauki o danych i udostępniania danych.
Otwarcie replikacji umożliwia każdej aplikacji zapisywanie zmian danych bezpośrednio w zreplikowanej bazie danych w Fabric. Otwarte dublowanie zostało zaprojektowane tak, aby było rozszerzalne, konfigurowalne i otwarte. Jest to potężna funkcja, która rozszerza odwzorowanie w systemie Fabric na podstawie otwartego formatu tabeli Delta Lake.
Gdy dane trafią do OneLake w Fabric, otwarta replikacja upraszcza obsługę złożonych zmian danych, zapewniając, że wszystkie replikowane dane są stale aktualne i gotowe do analizy.
Aby zapoznać się z samouczkiem dotyczącym konfigurowania otwartych zwierciadlanych baz danych w Fabric, zobacz Tutorial: Konfigurowanie Microsoft Fabric otwartych zwierciadlanych baz danych.
Dlaczego warto używać funkcji otwartego mirroringu w Fabric?
Otwarte odbicie rozszerza funkcję Mirroring w Fabric na własne aplikacje lub istniejących dostawców danych, aby zapisać dane w lustrzanej bazie danych w OneLake w Fabric. Po wylądowaniu danych w strefie lądowania silnik replikacji lustrzanej zarządza złożonością zmian i konwertuje dane na Delta Parquet, w formacie gotowym do analizy. W usłudze OneLake dane mogą być analizowane i wykorzystywane przez wszystkie doświadczenia w usłudze Fabric.
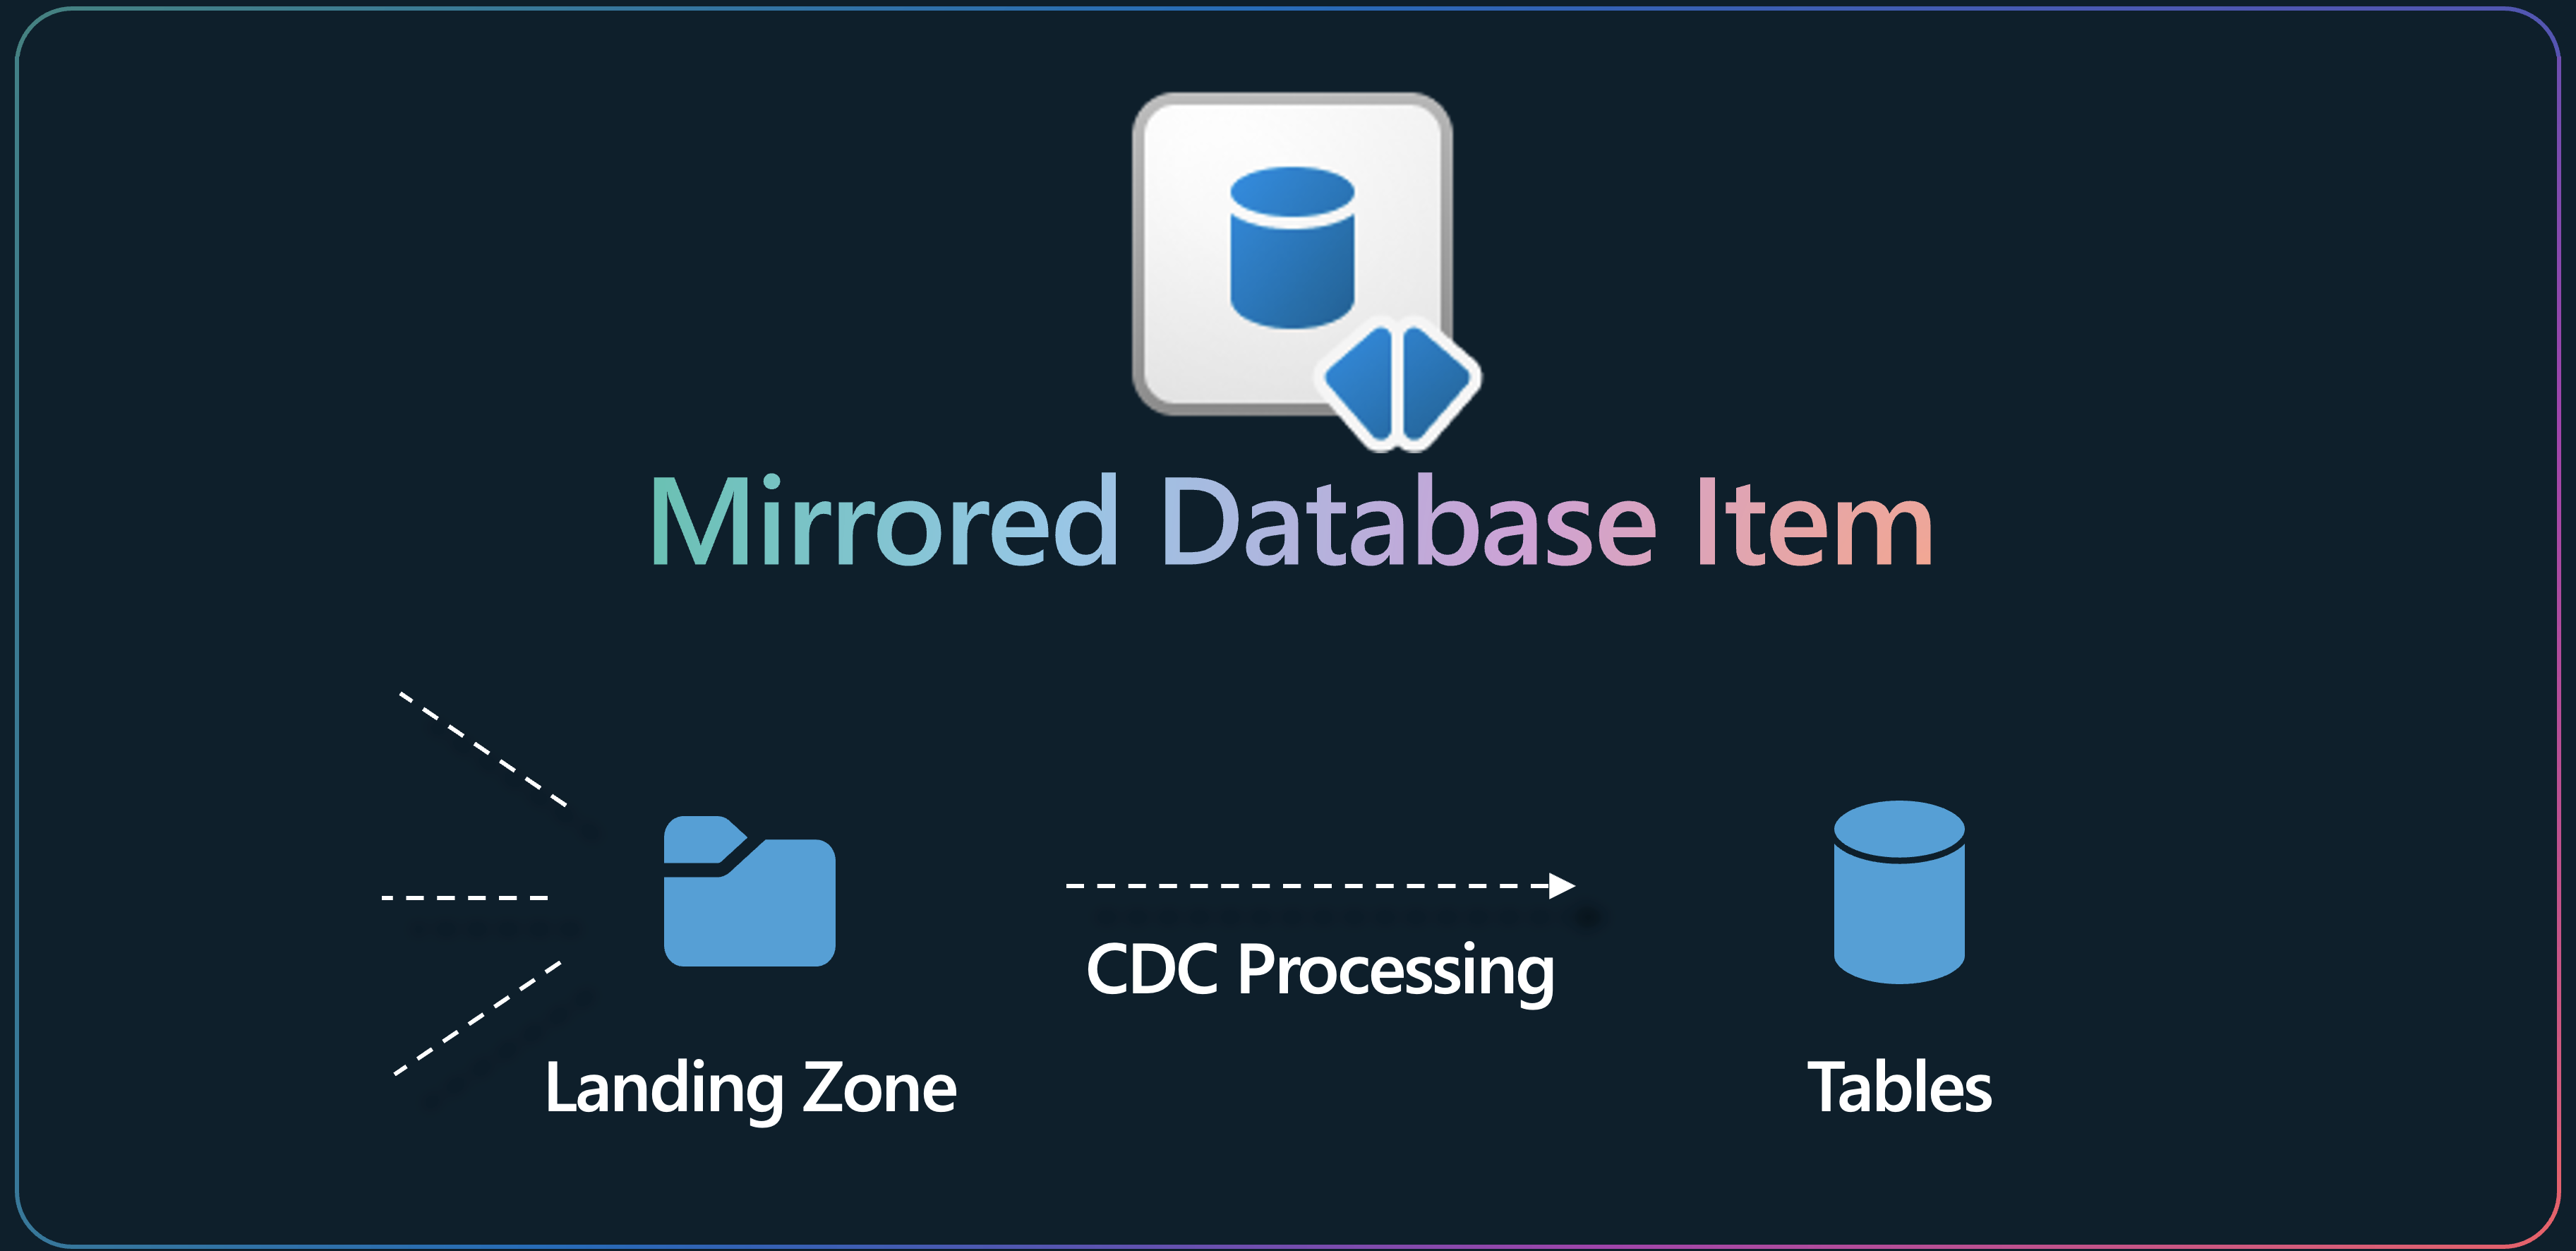
Otwarte odwzorowanie spełnia potrzeby replikacji danych, jeśli
- Użyj własnej aplikacji, aby zapisywać dane w otwartej strefie docelowej replikowania zgodnie z jej wymaganiami i formatami.
- Skorzystaj z jednego z naszych istniejących partnerów mirrorowania, aby pomóc w pozyskiwaniu danych.
Aby uzyskać wskazówki dotyczące niezawodnego publikowania plików, wykrywania, wydajności, odzyskiwania i zmian schematu, zobacz najlepsze praktyki usługi Open Mirroring.
Jakie doświadczenia analityczne są wbudowane?
Wszystkie typy zreplikowanych baz danych są elementem Fabrykowego Magazynu Danych, odrębnie od Magazynu oraz punktu końcowego analizy SQL.
Tworzenie kopii lustrzanej w obszarze roboczym Fabric tworzy te elementy:
- Element zmironizowanej bazy danych. Dublowanie zarządza replikacją danych do usługi OneLake i konwersją na format Delta Parquet oraz zarządza złożonością zmian w formacie gotowym do analizy. Umożliwia to wykonywanie scenariuszy podrzędnych, takich jak inżynieria danych, nauka o danych i nie tylko.
- Punkt końcowy analizy SQL
Każda otwarta dublowana baza danych ma automatycznie wygenerowany punkt końcowy analizy SQL , który zapewnia zaawansowane środowisko analityczne na podstawie tabel delty utworzonych przez proces dublowania. Użytkownicy mają dostęp do znanych poleceń języka T-SQL, które mogą definiować obiekty danych i wykonywać względem niego zapytania, ale nie manipulować danymi z punktu końcowego analizy SQL, ponieważ jest to kopia tylko do odczytu. Następujące akcje można wykonać w punkcie końcowym analizy SQL:
- Zapoznaj się z tabelami, które odwołują się do danych w tabelach usługi Delta Lake.
- Twórz zapytania i widoki bez kodowania oraz eksploruj dane wizualnie bez konieczności pisania ani jednej linii kodu.
- Twórz widoki SQL, wbudowane funkcje TVF (funkcje z wartościami tabel) i procedury składowane w celu hermetyzacji semantyki i logiki biznesowej w języku T-SQL.
- Zarządzanie uprawnieniami do obiektów.
- Wykonywanie zapytań o dane w innych magazynach i magazynach Lakehouse w tym samym obszarze roboczym.
Oprócz edytora zapytań SQL, Istnieje szeroki ekosystem narzędzi, który może wysyłać zapytania do punktu końcowego analizy SQL, w tym SQL Server Management Studio (SSMS), rozszerzenie MSSQL dla Visual Studio Code, a nawet GitHub Copilot.
Zagadnienia dotyczące kosztów otwartego dublowania
Zasoby obliczeniowe sieci szkieletowej używane do replikowania danych do usługi Fabric OneLake są bezpłatne. Koszt przechowywania w trybie dublowania jest bezpłatny do pewnego limitu, ustalonego na podstawie pojemności. Aby uzyskać więcej informacji, zobacz Koszt dublowania i Cennik Microsoft Fabric. Moc obliczeniowa na potrzeby wykonywania zapytań dotyczących danych przy użyciu języka SQL, narzędzia Power BI lub platformy Spark jest naliczana według regularnych stawek.