Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
I takt med att organisationer påskyndar sina digitala omvandlingsresor blir förmågan att hantera data effektivt en strategisk affärsnödvändighet. Med framväxten av AI-drivna applikationer och Copilot-drivna arbetsflöden genererar och konsumerar företag data i en aldrig tidigare skådad takt. Dessa data driver innovation, möjliggör anpassade upplevelser och stöder kritiskt beslutsfattande – men bara om de styrs och lagras på ett intelligent sätt.
För att stödja dessa föränderliga affärsbehov måste organisationer anta en proaktiv strategi för lagringshantering. Detta säkerställer att data som inte längre krävs för den dagliga verksamheten hanteras på ett ansvarsfullt sätt, vilket frigör kapacitet för arbetsbelastningar med högt värde, minskar driftsfriktionen och anpassar sig till efterlevnads- och revisionskrav.
Ur teknisk synvinkel förbättrar effektiv lagringshantering i Dataverse och Dynamics 365 systemprestanda, förbättrar kostnadseffektiviteten och säkerställer efterlevnad av långsiktiga bevarandeprinciper (LTR). Båda plattformarna erbjuder verktyg och automatiseringsfunktioner som gör det möjligt för organisationer att hantera lagring.
Genom att implementera de strategier som beskrivs i den här artikeln kan företag minska supportkostnaderna, effektivisera efterlevnaden och frigöra större värde från sina affärsprogram – vilket gör lagring från en begränsning till en konkurrensfördel.
Viktiga fördelar
Effektiv lagringshantering i Dataverse och Dynamics 365 ger flera viktiga fördelar som löser vanliga problem för kunderna och förbättrar den övergripande operativa effektiviteten.
Ökad efterlevnad av LTR: Effektiv lagringshantering säkerställer att data lagras i enlighet med LTR-policyer. Detta hjälper inte bara till att uppfylla regulatoriska krav, utan säkerställer också att kritiska data bevaras och är tillgängliga när det behövs.
Förbättrad prestanda: Genom att optimera lagringshanteringen kan organisationer avsevärt förbättra prestandan för sina system. Effektiv lagringsallokering och hantering minskar latensen och förbättrar hastigheten för datahämtning, vilket leder till smidigare och snabbare drift.
Ökad kostnadseffektivitet: Effektiv lagringshantering gör det möjligt för organisationer att fokusera på värdefulla data genom att effektivisera och rensa upp i sitt lagringslandskap. Genom att bara behålla det som är nödvändigt kan företag optimera sitt lagringsavtryck, vilket leder till smartare resursutnyttjande och kostnadseffektiv skalbarhet.
Bakgrund
I takt med att organisationer växer och digitaliserar mer av sin verksamhet ökar mängden affärsdata som lagras i system som Dataverse Dynamics 365 stadigt. Detta inkluderar inte bara aktiva transaktionsdata utan även historiska register som måste behållas för revision, regelgivning eller affärskontinuitet. Med tiden kan den här ackumuleringen leda till prestandaförsämring, ökade driftskostnader och stigande lagringskostnader, särskilt när data som inte längre används aktivt finns kvar på lagringsnivåer med höga prestanda.
En väldefinierad strategi för lagringshantering hjälper organisationer att hantera dessa utmaningar genom att identifiera data som kan arkiveras, rensas eller flyttas till billigare, läsoptimerad lagring. Detta är viktigt för efterlevnadsscenarier där data måste förbli oföränderliga, med låg åtkomst och skrivskyddade, till exempel ekonomiska poster, granskningsloggar eller regelarkiv. Att se till att sådana data lagras på ett kompatibelt sätt, utan att påverka prestandan hos livesystem, är ett viktigt krav för många företag.
Genom att använda de verktyg och strategier som finns tillgängliga på båda plattformarna kan organisationer få bättre insyn i sitt lagringsavtryck, minska onödig förbrukning och se till att efterlevnadskritiska data hanteras på rätt sätt.
Den här artikeln beskriver praktiska metoder för lagringshantering som hjälper kunderna att anpassa sina metoder för datalagring till affärs- och regelbehov. Detta förbättrar systemets prestanda, minskar driftskostnaderna och säkerställer att efterlevnadskraven uppfylls utan kompromisser.
Varför vi lagrar data
För att välja och optimera rätt datalagringsmönster för dina data är det värdefullt att reflektera över skälen och användningsområdena för vilka vi lagrar data.
Operativa data
Med en affärsapplikation är driftdata det som används för att spåra försäljning eller finansiella åtgärder eller åtgärder i försörjningskedjan.
Dessa data måste nås i realtid, vilket stöder kund- och interna operativa processer som registrerar detaljerade åtgärder som interaktioner med kunder, beställningar eller lageraktiviteter.
Med tiden kan driftdata gå från att användas aktivt till att användas sällan. Data kan behöva vara tillgängliga nästan i realtid, för att hjälpa en kund med en beställning eller i ett supportärende. Ta exempelvis följande scenarier:
- En kund lägger en order, medan en annan kund, som inte har interagerat med verksamheten på ett tag, lägger en order.
- Varje beställning som har lagts och är under leverans åtkoms ständigt. Det finns också beställningar som omfattas av en garantiperiod på tre år som kan behöva hänvisas till för support och eventuellt kräva återbetalning.
Detta kan leda till faser av behov av åtkomst till driftdata, till exempel:
- Mindre än ett år med aktivt använda data.
- Mindre än tre års data som används sällan.
- Mer än tre år där data inte längre är operativt åtkomliga.
Realtidskaraktären hos operativ lagring gör det relativt dyrt jämfört med annan lagring, så det är viktigt att känna igen när data behöver nås operativt och när de inte gör det för att definiera kvarhållningsstrategier.
Operativ integration
Som en specialiserad kategori av operativ användning kan data behöva replikeras mellan flera operativa system, inklusive mönster som:
- Bankverksamhet: Hantering av kundrelationer för kundinteraktioner i frontlinjen och replikering till flera banksystem. Du har till exempel transaktionskonton, kreditkort, bolån och kreditkontrollsystem.
- Tillverkning: Hantering av kundrelationer för ordermottagning i frontlinjen och system för hantering av företagsresurser för hantering av försörjningskedjan.
- Polisens larmhantering: System för kundrelationshantering för kontakter med medborgare och dispatchsystem för polismyndigheter erbjuder hantering av resursdisponering.
I dessa fall, även om varje system kan ha unika data som det spårar, finns det ofta gemensamma huvuddata som måste delas mellan systemen och hållas synkroniserade, vilket leder till integrationsbehov.
Granskningsdata
Ett företag har vanligtvis ett lagstadgat ansvar att behålla data under längre perioder – till exempel i genomsnitt sju år – för revisionsändamål, oavsett om de är interna eller externa, till exempel för att stödja finansiell revision, lagstadgad information eller bedrägerigranskning.
Dessa data omfattar vanligtvis både data som behövs för operativa ändamål och data som inte längre behövs, eftersom de gör det möjligt att granska datauppsättningen från en och samma plats.
Analysdata
Organisationer har ett behov av att granska och analysera tillståndet i sin verksamhet. De måste mäta och jämföra statistik över tid och spänna över flera eller alla delar av verksamheten.
De stora perioderna och bredden av data som denna analys kan ske över leder till behovet av att replikera driftdata till specialiserade analysverktyg. På så sätt undviker man att komplexa analyser påverkar driftsystemens prestanda, men det gör det också möjligt att analysera över datauppsättningar som går utöver den period för vilken data behövs operativt. Du kan till exempel behöva jämföra data över sju år, i stället för över ett till två år. Olika analysbehov kan dock behöva fullständiga datalagringsperioder eller bara sträcka sig över de data som lagras i operativsystem.
Analysdata möjliggör vanligtvis aggregering av data över flera delar av verksamheten och kombinerar data från flera system.
Flöde av data
Data av dessa typer flödar vanligtvis över tid från driftdata och sedan till transaktionsdata eller historiska data, som du ser i följande bild.
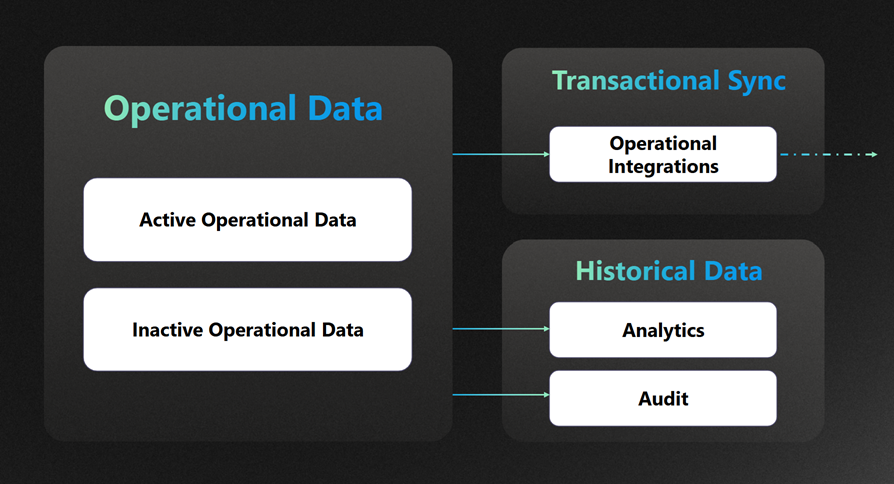
Olika typer av lagring
Dataverse Typer av lagring
Dataverse Organiserar lagringen i tre huvudkategorier, var och en med distinkta användningsmönster och faktureringskonsekvenser.
| Lagringstyp | Beskrivning | Vanliga användningsfall |
|---|---|---|
| Lagring av databaser | Lagrar strukturerad data i tabeller – standard och anpassade. | Affärsposter, metadata, relationer och konfigurationer |
| Fillagring | Lagrar bilagor och binära data. | E-postbilagor, bilder, dokument som laddats upp via Power Apps |
| Logglagring | Lagrar granskningsloggar och spårningsloggar för plugin-program. | Ändringsspårning, granskning, diagnostik och efterlevnad |
Lagringstyper för plattformen för ekonomi och drift
Lagring av ekonomi och drift hanteras separat, men integreras i allt högre grad i ekosystemet Power Platform . Den innehåller följande lagringstyper.
| Lagringstyp | Beskrivning | Vanliga användningsfall |
|---|---|---|
| Lagring av driftdatabas | Grundläggande transaktionsdata för ekonomi, försörjningskedja, personalfrågor med mera | Redovisningsposter, lager, kundordrar |
| Lagring för dokumenthantering | Binära stora objekt (blobar) som lagras i Azure Blob Storage | Fakturor, kvitton, skannade dokument |
| Telemetri- och diagnostikloggar | Systemloggar och telemetridata | Prestandaövervakning, problemdiagnostik. |
Scenarier för delad och integrerad lagring
Lagring med dubbelskrivning
- Tillåter synkronisering i realtid mellan Dataverse appar för ekonomi och drift.
- Kräver noggrann roll- och kapacitetshantering för att undvika duplicering eller överanvändning.
Långsiktig kvarhållning (LTR)
- Flyttar historiska data till en hanterad datasjö (MDL).
- Minskar användningen av primärlagring samtidigt som åtkomst för efterlevnad och analys bibehålls.
- Integreras med:
- Snabbsökning (Dataverse-inbyggd sökning)
- OneLake (Fabric-baserad analys)
- Synapse Link (anpassad dataanalys i datasjö)
Hur dina data växer över tid
I takt med att organisationer skalar upp sin användning av Dataverse och Dynamics 365 Finance and Operations-plattformen blir datatillväxt både ett tecken på framgång och en strategisk utmaning. Det som börjar som en avskalad, transaktionell datamängd kan snabbt utvecklas till ett komplext, mångskiktat datalandskap. I det här avsnittet utforskas fem viktiga drivkrafter för datatillväxt och deras konsekvenser för lagring, prestanda och styrning.
Använda informationslagerhantering på driftdata
För att få fram insikter från operativa system använder många organisationer Azure Synapse Link, OneLake eller dataexport för att replikera data från Dataverse och appar för ekonomi och drift till ett analyssystem. Även om detta stöder avancerad rapportering och AI-arbetsbelastningar, introducerar det också:
Redundant lagring över operativa och analytiska lager
Data dupliceras ofta mellan den operativa och den analytiska miljön. Den här redundansen ökar den totala lagringsförbrukningen och kan leda till högre kostnader, särskilt om historiska data behålls på obestämd tid i båda systemen.
Omkostnader för schemaduplicering och versionshantering
För att upprätthålla konsekvens mellan system måste organisationer replikera schemaändringar, till exempel nya fält och omdöpta kolumner, i både operativa och analytiska lager. Detta ökar komplexiteten i datastyrningen och ökar risken för schemaavvikelser, vilket kan bryta underordnade rapporter eller modeller.
Ökad lagring av historiska data för trendanalys
Analyssystem behåller vanligtvis data under längre perioder för att stödja trendanalys, prognoser och lagstadgad rapportering. Även om den här långsiktiga kvarhållningen är värdefull kan den leda till uppsvällda datauppsättningar om den inte hanteras med rätt arkiverings- och nivåindelningsstrategier.
Datalagerhantering är viktigt för analys, men utan livscykelprinciper kan det fördubbla eller tredubbla ditt lagringsfotavtryck.
Använda sökning i data
Funktioner som Dataverse sökning, Copilot-indexering och relevanssökning kräver indexering av stora mängder strukturerade och ostrukturerade data. Dessa index gör ofta följande:
Förbruka logg- och databaslagring
Sökindex lagras i både logg- och databaslagring. När fler tabeller och fält markeras som sökbara växer indexstorleken proportionellt. Detta kan avsevärt påverka den övergripande lagringsanvändningen, särskilt i miljöer med stora mängder poster eller frekventa schemaändringar.
Bestå även för oanvända eller föråldrade tabeller
Även om vissa tabeller är inaktuella eller inte längre används aktivt kan deras associerade sökindex finnas kvar om de inte uttryckligen tas bort. Detta leder till onödig lagringsförbrukning och kan komplicera kapacitetsplaneringen.
Dupliceras ofta i olika miljöer, till exempel utvecklings-, test- och produktionsmiljöer
Sökindex replikeras vanligtvis i utvecklings-, test- och produktionsmiljöer. Även om detta säkerställer ett konsekvent sökbeteende ökar det också lagringsbehovet, särskilt när miljöer klonas eller återskapas ofta.
Sökning förbättrar användbarheten och AI-beredskapen, men indexuppblåsthet är en tyst bidragsgivare till lagringsöverförbrukning.
Aktivera loggning av data
Granskningsloggar, plugin-spårningsloggar och telemetri är viktiga för efterlevnad, felsökning och övervakning. Observera dock följande punkter:
Logglagring växer linjärt med användning och antal användare.
Loggdata växer proportionellt med:
- Antalet användare och deras aktivitetsnivåer
- Volymen av transaktioner och integrationer
- Komplexiteten i affärslogik, till exempel plugin-program och arbetsflöden
I miljöer med hög användning kan detta leda till snabb expansion av loggtabeller, vilket förbrukar både databas- och logglagringskvoter.
Standardinställningarna för kvarhållning är ofta för generösa, till exempel 90 dagar eller mer.
Som standard behåller många loggningsfunktioner data under längre perioder, till exempel 90 dagar eller mer. Även om detta stöder långsiktig spårbarhet kan det resultera i onödig lagringsförbrukning, särskilt när loggar inte aktivt granskas eller exporteras.
Systemgenererade loggar faktureras till kunden i Dataverse.
I Dataverse räknas systemgenererade loggar, inklusive granskningsloggar och plugin-spårningsloggar, mot kundens lagringsberättigande. Det innebär att utan rätt rensnings- eller exportstrategier kan loggning direkt bidra till lagringsöverförbrukning och ökade licenskostnader.
Loggning är inte förhandlingsbart för reglerade branscher, men måste paras ihop med kvarhållnings- och exportstrategier, till exempel Azure Monitor eller Log Analytics.
Att ha flera kopior av produktionsmiljön
För att stödja utveckling, testning, utbildning och felsökning skapar kunder ofta sandbox-miljöer eller klonade miljöer. Varje kopia:
- Replikerar hela data- och indexavtrycket.
- Kan innehålla icke-uppenbara beroenden som sökindex, granskningsloggar och metadata.
- Rengörs sällan efter användning.
Miljöutbredning är en viktig drivkraft för lagringskostnader och komplexitet. Styrningspolicyer och automatisering är avgörande för begränsning.
Optimering av frågor om data
I takt med att datavolymerna växer och programmets svarstider blir avgörande implementerar kunder och ISV:er ofta olika frågeoptimeringstekniker för att förbättra prestanda i Dataverse Dynamics 365. Dessa strategier är särskilt vanliga i rapporterings-, analys- och integreringsintensiva scenarier.
För att förbättra prestanda skapar kunder och ISV:er ofta:
Anpassade index och materialiserade vyer
Dessa används för att påskynda frågekörningen genom att förberäkna kopplingar eller aggregeringar. De är användbara i scenarier som omfattar komplexa filter eller stora datamängder.
Avnormaliserade tabeller för rapportering
För att förenkla rapporteringen och minska frågekomplexiteten skapar utvecklare ofta tillplattade versioner av relationsdata. De här tabellerna minskar behovet av körningskopplingar och förbättrar instrumentpanelens prestanda.
Cachningsskikt eller aggregat
Data som används ofta är ibland föraggregerade eller cachelagrade i mellanliggande tabeller eller externa arkiv för att minska belastningen på den primära databasen.
Även om dessa förbättrar svarstiden, gör de också:
Öka användningen av lagringsutrymme
Varje optimeringslager introducerar fler datastrukturer, oavsett om det är en kopia av befintliga data i ett avnormaliserat format, en förberäknad vy eller en cachetabell. Dessa strukturer duplicerar ofta data som redan lagras någon annanstans, vilket leder till ett större övergripande lagringsfotavtryck. I miljöer med strikta lagringskvoter eller kostnadsbaserade licensieringsmodeller Dataverse kan detta snabbt eskalera till överförbrukning som kan undvikas.
Kan bli överblivna i takt med att appar utvecklas
I takt med att programmen utvecklas kan det hända att vissa optimeringsartefakter inte längre refereras till av aktiva rapporter, instrumentpaneler eller integreringar. Dessa överblivna objekt fortsätter att förbruka lagringsutrymme och kan till och med göra systemåtgärderna långsammare, till exempel under säkerhetskopieringar eller indexering, om de inte identifieras och tas bort. Utan regelbundna revisioner kan de ackumuleras obemärkt, vilket undergräver just de prestandavinster som de skapades för att stödja.
Frågeoptimering är viktigt för skalning men måste balanseras med lagringshygien och telemetridriven justering.
Index och deras inverkan på lagring
Index är viktiga för att förbättra frågeprestanda och använda snabb datahämtning i stora datamängder. I både Dataverse och Dynamics 365 appar för ekonomi och drift skapas automatiskt index för primärnycklar och fält som efterfrågas ofta, och andra anpassade index kan definieras för att stödja specifika affärsscenarier.
Index är viktiga för prestanda, men de har också en direkt inverkan på lagringsförbrukningen, som ofta underskattas under lösningsdesignen.
Så här förbrukar index lagringsutrymme
Fysisk duplicering av data: Varje index lagrar en kopia av de indexerade kolumnerna, tillsammans med pekare till motsvarande rader. Ju fler kolumner och rader som indexeras, desto större blir indexstorleken.
Tillväxt med datavolym: I takt med att den underliggande tabellen växer växer även indexet. I miljöer med höga transaktioner kan index växa snabbt, särskilt i stora, avnormaliserade tabeller eller de med frekventa infogningar och uppdateringar.
Flera index per tabell: Det är vanligt att en enskild tabell har flera index, till exempel för sökning, filtrering, sortering och kopplingar. Varje annat index lägger till det kumulativa lagringsfotavtrycket.
Sökindex i Dataverse: Funktioner som Dataverse sökning och Copilot-indexering skapar specialiserade index som sträcker sig över flera fält och tabeller. Dessa lagras i tabellen DataverseSearch och kan ta upp mycket utrymme, särskilt när de används i flera miljöer, till exempel utvecklings-, test- och produktionsmiljöer.
Systemgenererade index: Vissa index skapas automatiskt av plattformen, till exempel för uppslagsfält eller relationer. Dessa kan finnas kvar även om de associerade tabellerna är inaktuella, såvida de inte uttryckligen tas bort.
Konsekvenser för lagring
- Ökad databas- och logglagring: Index bidrar till både databas- och logglagringsanvändning, vilket kan påverka licenskostnaderna i Dataverse.
- Miljöduplicering: När miljöer kopieras eller uppdateras dupliceras alla index, vilket förstärker lagringsanvändningen i utvecklings-, test- och produktionsmiljöer.
- Underhållskostnader: Index måste uppdateras när data ändras, vilket kan öka skrivfördröjningen och resursförbrukningen.
Hur synkronisering på serversidan påverkar lagring
Serversynkronisering i Dataverse möjliggör sömlös integration av e-post, möten och uppgifter mellan Microsoft Exchange och Dataverse. Samtidigt som det förbättrar produktiviteten och automatiseringen, bidrar det också till lagringsförbrukningen på följande sätt.
- Skapa aktivitetspost: Varje synkroniserat e-postmeddelande eller avtalad tid genererar en aktivitetspost i Dataverse som innehåller metadata, brödtext och eventuellt bilagor.
- Lagring av bifogade filer: Om bilagor inte filtreras eller avlastas lagras de direkt i Dataverse, vilket ökar lagringsanvändningen.
- Efterlevnad och kvarhållning: Organisationer som använder serversynkronisering för efterlevnadsspårning kan behålla mer data än nödvändigt, vilket ytterligare ökar lagringen.
- Skyddat innehåll: Även Purview-skyddade e-postmeddelanden, även om de är begränsade i innehållets synlighet, genererar fortfarande platshållarposter som förbrukar utrymme.
För att hantera den här effekten bör företag implementera kvarhållningsprinciper, överväga att avlasta bilagor och övervaka aktivitetspostvolymer regelbundet.
Hur kan jag hantera det ständigt växande lagringsutrymmet?
Oavsett om du redan står inför lagringsöverförbrukning eller siktar på att ligga steget före dem, krävs det en medveten, policydriven metod för att hantera datatillväxt i Dataverse Dynamics 365 för ekonomi och drift. I det här avsnittet beskrivs två strategiska startpunkter: reaktiv reparation och proaktiv styrning.
Det finns två möjliga scenarier:
- Du vill proaktivt tillämpa bästa praxis för att hantera lagring och undvika höga kostnader i framtiden.
- Du befinner dig redan i en situation där det är nödvändigt att minska lagringsstorleken och kostnaden.
Tillämpa metodtips för att hantera lagringsstorlek och kostnader
Scenario 1: Du vill proaktivt tillämpa metodtips för att hantera lagring
Om du ännu inte är i krisläge är det nu dags att använda verktyg och tekniker för att hantera lagringen proaktivt.
Konfigurera analys för dina data
I takt med att organisationer växer ökar också behovet av att extrahera insikter från driftdata, utan att påverka prestandan för kärnverksamhetens program. Microsoft erbjuder flera sätt att tillåta analys av Dataverse och Dynamics 365 data för ekonomi och drift genom att integrera med din egen datasjö eller ditt eget lager.
Här är två kraftfulla alternativ att överväga:
Alternativ 1. Använd Azure Synapse Link – ta med din egen sjö
Azure Synapse Med Link kan du ansluta Dataverse direkt till din egen Azure Data Lake- eller Synapse-arbetsyta. Detta möjliggör replikering av driftdata i nära realtid till en analytisk miljö, utan att skriva komplexa ETL-pipelines.
Fördelar:
- Kör avancerade analyser och AI-modeller på data i realtid eller nära realtid.
- Undvik prestandapåverkan på dina produktionssystem.
- Använd välbekanta verktyg som T-SQL, Spark eller Power BI för rapportering.
Exempel på användningsfall: Ett detaljhandelsföretag använder Synapse Link för att analysera kundernas köpbeteende i olika regioner och kombinerar Dataverse data om kundrelationshantering med externa marknadsdata i sin egen sjö.
Alternativ 2. Använd OneLake – enhetlig analys med Microsoft Fabric
OneLake, som är en del av Microsoft Fabric, ger en enhetlig datasjöupplevelse där du kan lagra och analysera data från flera källor, inklusive Dataverse appar för ekonomi och drift, utan duplicering.
Fördelar:
- Centraliserad lagring för alla analytiska arbetsbelastningar.
- Inbyggd integrering med Power BI Synapse- och AI-tjänster.
- Förenklad styrning och säkerhet mellan datadomäner.
Exempel på användningsfall: Ett företag för finansiella tjänster använder OneLake för att konsolidera operativa data från appar för ekonomi och drift och Dataverse med externa ekonomiska indikatorer, vilket möjliggör riskmodellering i realtid och verkställande instrumentpaneler. På så sätt kan du frikoppla driftdata från dina kärnsystem och tillåta skalbar, kostnadseffektiv analys genom att exportera dessa data till sina egna analysmiljöer, utan att duplicera arbetsbelastningar eller påverka prestanda.
Verktyg och tekniker för att minska lagringen
Dataverse Erbjuder flera inbyggda verktyg och strategier för att hjälpa administratörer att hantera lagring effektivt och upprätthålla systemprestanda.
Dataverse
Hantera data med styrningsprinciper
- Börja med de miljöer och tabeller som förbrukar mest lagringsutrymme.
- Använd återkommande styrningsprinciper för förutsägbar datatillväxt i stället för att bara förlita dig på engångsrensning.
- Testa borttagnings- och kvarhållningsvillkor i en sandbox-miljö innan du använder dem i produktion.
- Granska principresultat och -fel regelbundet.
- Lägg till lagringskapacitet när nödvändiga data inte kan tas bort eller flyttas till långsiktig kvarhållning.
Rensning av miljö och data
- Ta bort oanvända miljöer: Du kan ta bort en miljö för att återställa lagringsutrymme och ta bort personligt identifierbar information (PII).
-
Massborttagningsjobb: Du kan ta bort följande data i grupp:
- Inaktuella data eller data som är irrelevanta för verksamheten.
- Onödiga test- och exempeldata.
- Data som felaktigt har importerats från andra system.
Fil- och tabelloptimering
- Minska fillagringen med avancerad sökning: I den här artikeln beskrivs 15 metoder för att hantera lagringsutrymmet bättre. Använd en eller flera av dessa metoder när du vill kontrollera din totala datalagringsanvändning. Du kan ta bort vissa kategorier av data när behovet uppstår, eller så kan du konfigurera att massborttagningsjobb ska utföras vid angivna intervaller. Du kan till exempel ta bort anteckningar, bifogade filer, importhistorik och andra data.
- Rensa poster från tabeller för systemuppgifter (AsyncOperationBase) och processloggar (WorkflowLogBase): Om din organisation använder arbetsflöden eller affärsprocessflöden mycket växer dessa tabeller (AsyncOperationBase, WorkflowLogBase) med tiden och blir så småningom tillräckligt stora för att introducera prestandaproblem och förbruka för mycket lagringsutrymme i organisationens databas. För WorkflowLogBase kan du konfigurera för att automatiskt ta bort slutförda arbetsflödesjobb i bakgrunden.
Långsiktig kvarhållning (LTR) och arkivering
- Dataarkivering: LTR: Dataverse stöder anpassade lagringspolicyer för att säkert behålla obegränsad data på lång sikt på ett kostnadseffektivt sätt. Även om Dataverse kan stödja din affärstillväxt utan någon begränsning för aktiva data, kan du överväga att flytta inaktiva data till Dataverses arkiv för långtidslagring.
- Rensa Dataverse-tabeller: Om du vill behålla datan men ta bort den från relationslagret går du till Långsiktig datalagring i Dataverse. Annars rensar du följande tabeller:
- ActivityPointerBase: Du kan följa stegen här för att rensa tabellen.
- AsyncOperationBase: Du kan följa stegen här för att rensa tabellen.
- msdyn_copilotinteraction: Du kan följa stegen här för att rensa tabellen.
- PrincipalObjectsAcces: Du kan följa stegen här för att rensa tabellen.
- Prenumerationsspårning: Du kan följa stegen här för att rensa upp tabellen.
Optimering av sökindex
- Minska Dataverse sökningen: Du kan minska lagringsstorleken genom att utföra alla steg i Dataverse kapacitetsbaserad lagringsinformation.
- Minska storleken på DataverseSearch-tabellen: DataverseSearch-tabellen är den kumulativa lagringen som används av sökindexet Dataverse . Den innehåller data från alla sökbara, hämtningsbara och filtrerade fält i de tabeller du har indexerat för miljön. Du kan minska tabellstorleken genom att ta bort sökkolumner, vykolumner och filtervillkor för en eller flera tabeller. Du kan inaktivera Dataverse sökning för att ta bort alla indexerade data.
Program för ekonomi och drift
Appar för ekonomi och drift erbjuder flexibla alternativ för att hantera lagring i produktions- och sandbox-miljöer.
Miljöledning
- Begränsa antalet fullständiga produktionskopior: Du kan minska den totala lagringsförbrukningen för appar för ekonomi och drift genom att ta bort fullständiga produktionskopior i sandbox-miljöer. Om du till exempel har fem kopior av produktionsmiljöer i en sandbox är din lagringsförbrukning summan av produktionen plus fem kopior av produktionsmiljöer i en sandbox.
- Trimma data i sandbox-miljöer: Genom att trimma data i en sandbox-miljö kan du minska det totala lagringsfotavtrycket. Du kan följa metoderna nedan för att rensa data i sandlådan.
- Återställningsprocessen utför en öppnings- och trimningsåtgärd
- Skriv T-SQL
- Skriv X++
- Utför en transaktionsfri kopiering mellan miljöer: Miljökopiering för appar för ekonomi och drift har traditionellt inneburit fullständig databasduplicering, inklusive konfiguration, huvuddata och transaktioner, vilket, även om det är användbart för felsökning, avsevärt ökar lagringsförbrukningen i både ekonomi och drift och Dataverse.
Anpassad rensning och logghantering
- Skriv anpassade rensningsrutiner efter behov: Du kan skriva anpassade rensningsrutiner efter behov av ditt företag för att rensa oönskade data.
- Undvik att lagra loggar: Du kan flytta SysDatabaseLog till en mindre transaktionsdatabas för att minska det totala lagringsfotavtrycket.
Arkivering och långsiktig kvarhållning
-
Dataarkivering: LTR: Appar för ekonomi och drift gör det möjligt för organisationer att uppnå följande fördelar genom arkivering:
- Skydda historiska, inaktiva programdata på lång sikt för att uppfylla revisions-, juridiska och regelmässiga krav.
- Minska storleken på programdatabasen och den kapacitet som förbrukas för att potentiellt förbättra programprestanda som är associerade med stora tabeller.
- Konfigurera och hantera arkivdata
- Anpassning av arkiv
- Konsolidering av lagertransaktioner
Inbyggda rensningsrutiner
- Rensningsrutiner: I Dynamics 365 Finance och Dynamics 365 Supply Chain Management finns rensningsrutiner tillgängliga i olika moduler. Rensningsrutiner ger en översikt över de rutiner som för närvarande är tillgängliga. När du har kopierat sandbox-databasen kör du dessa rensningsrutiner proaktivt för att ta bort onödiga tabeller, till exempel batchhistorik, loggar och transaktionshistorik för detaljhandeln. Ta bort föråldrade eller irrelevanta data.
- Arkivera kreditkortstransaktionsdata: Beskriver ett arkiveringsjobb Dynamics 365 Commerce som kan hjälpa till att frigöra utrymme i databasen genom att arkivera kreditkortsbetalningstoken.
Minska lagringsstorlek och kostnader
Scenario 2: Du befinner dig redan i en situation där det är nödvändigt att minska lagringsstorleken och kostnaden
Utvärdera vad som förbrukar lagringsutrymme
- Power Platform Använd administrationscentret och lagringsrapporterna för ekonomi och drift för att identifiera de mest krävande tabellerna, filtyperna och loggarna.
- Använd telemetri, om det är tillgängligt, för att attribuera användning till specifika appar, användare eller affärsenheter.
Prioritera kandidater för rensning
- Fokus på:
- Mellanlagringstabeller och integrationstabeller, till exempel dubbelskrivningsbuffertar
- Granskningsloggar: Behåll den i din egen lagring
- Oanvända miljöer eller sandlådor
- Överblivna metadata och sökindex
- Ta bort det du inte behöver, till exempel massborttagning
Använda Synapse Link och OneLake för analytisk rapportering
- Exportera analysdata till Synapse Link.
- Använd OneLake för att komma åt lagrade data och affärsdata för rapporterings- och analysändamål.
Tillämpa långsiktig lagring (LTR)
- Flytta historiska data till en hanterad datasjö (MDL) med hjälp av LTR-principer.
- Behåll sök- och analysåtkomst via Snabbsökning, Synapse Link eller OneLake.
Användningsfall
Användningsfall för lagringshantering i Dataverse och ekonomi- och driftmiljöer är avgörande för att optimera databasutrymmet, förbättra systemprestanda och uppfylla regelkrav. Nedan följer några typiska scenarier som visar hur dessa strategier kan tillämpas:
Hantera tillväxt av historiska data
- Scenario: Ett företag har varit live på Dynamics 365 i flera år och har samlat på sig stora volymer av historiska transaktioner och bilagor.
- Åtgärd: Implementera långsiktiga kvarhållningsstrategier för att behålla inaktiva data, minska storleken på den primära databasen och upprätthålla efterlevnad av granskningskraven.
Datalagring för regelefterlevnad
- Scenario: En reglerad branschkund måste behålla finansiella data eller kunddata i sju till tio år i ett manipuleringssäkert format.
- Åtgärd: Använd LTR för att behålla oföränderliga, skrivskyddade data i enlighet med juridiska och regulatoriska krav, samtidigt som verksamhetsdata hålls slimmade utan att kompromissa med analys- och rapporteringsmöjligheterna.
Optimering av sök- och Copilot-index
- Scenario: Dataverse Sök- och Copilot-indexering är aktiverat i alla miljöer, inklusive oanvända tabeller.
- Åtgärd: Granska sökbara fält och inaktivera indexering för tabeller med lågt värde eller inaktuella. Övervaka storleken på DataverseSearch-tabellen och optimera konfigurationerna för att minska logg- och databaslagringen.
Gransknings- och telemetrihantering
- Scenario: Plugin-spårningsloggar och granskningsloggar växer snabbt, förbrukar lagringsutrymme och påverkar prestanda.
- Åtgärd: Exportera loggar till externa system, till exempel Azure Monitor, och automatisera rensning av gamla poster för att upprätthålla synlighet utan uppsvälld lagring.
Integrering av datalager och analys
- Scenario: Organisationen replikerar driftdata till Azure Synapse eller OneLake för analys, vilket leder till duplicerad lagring.
- Åtgärd: Använd inkrementella exporter, tillämpa filter och undvik fullständig replikering av datauppsättningar för att minimera redundans samtidigt som omfattande insikter tillåts.
Minska överförbrukning av lagringsutrymme
- Scenario: En kund får ett meddelande om att överskrida sin Dataverse lagringskvot, vilket leder till oväntade kostnader.
- Åtgärd: Använd kapacitetsrapporter för att identifiera de mest krävande tabellerna, rensa föråldrade miljöer och ta bort oanvända bilagor eller loggar. Överväg att flytta kalla data – vanligtvis historiska eller sällan använda poster – till lagringsnivåer med lägre kostnad.
Optimera prestanda i stora tabeller
- Scenario: Affärskritiska processer blir långsammare på grund av stora tabeller.
- Åtgärd: Arkivera gamla poster, rensa systemuppgifter, till exempel AsyncOperationBase och WorkflowLogBase.
Hantering av miljöns livscykel
- Scenario: Utvecklings- och testmiljöer klonas från produktion, vilket duplicerar alla data och index.
- Åtgärd: Trimma sandbox-miljöer efter en uppdatering, inaktivera onödig sökindexering och ta bort testdata för att minska överflödig lagringsförbrukning. Ta bort oanvända sandbox-miljöer för att spara lagringsutrymme.
Fallstudier
Fallstudie 1: Minska överförbrukning av lagringsutrymme genom indexrensning
Kundprofil: Ett globalt tillverkningsföretag som använder Dynamics 365 för försörjningskedjan och appar för ekonomi och drift.
Utmaning: Kunden upplevde oväntade lagringsöverförbrukning och prestandaförsämring i produktionsmiljön. Undersökningen visade att flera anpassade index och materialiserade vyer, som skapades under den tidiga implementeringen, inte längre användes men fortfarande förbrukade betydande lagringsutrymme.
Lösning: Teamet genomförde en kvartalsvis granskning av alla anpassade index och tog bort de som inte refereras av aktiva frågor eller rapporter. De implementerade också en styrningsprincip för att granska nya indexbegäranden före distributionen.
Utfall:
- Minskad databaslagring med 28 %.
- Förbättrade frågeprestanda med 15 %.
- Undvek en beräknad $12,000 per år i andra lagringskostnader.
Fallstudie 2: Arkivering av historiska data för att uppfylla efterlevnads- och prestandamål
Kundprofil: Ett företag inom finansiella tjänster som använder Dataverse Dynamics 365 för kundregistrering och ärendehanteringsfunktioner.
Utmaning: Företaget behövde behålla kundregister i mer än sju år för att uppfylla lagstadgade krav, men den växande mängden inaktiva data saktade ner aktiva arbetsflöden och ökade lagringskostnaderna.
Lösning: Kunden implementerade en långsiktig kvarhållningsstrategi med hjälp av Dataverse arkiveringsfunktionerna. Inaktiva poster flyttades till en skrivskyddad, kostnadsoptimerad lagringsnivå, medan aktiva data fanns kvar i lagring med höga prestanda.
Resultat:
- Arkiverat över 1,2 miljoner poster.
- Minskad storlek på den primära databasen med 40 %.
- Upprätthöll fullständig granskning och efterlevnad av kvarhållningsprinciper.
Fallstudie 3: Effektivisera sökindex i olika miljöer
Kundprofil: En detaljhandelsorganisation med flera Dataverse miljöer, inklusive utvecklings-, test- och produktionsmiljöer, som stöder en Copilot-aktiverad lösning för hantering av kundrelationer.
Utmaning: Sökindex användes i alla miljöer, inklusive oanvända tabeller och testdata. Detta ledde till uppsvällda DataverseSearch-tabeller och onödig lagringsförbrukning.
Lösning: Teamet granskade sökbara fält och slutade använda indexering på icke-kritiska tabeller i utvecklings- och testmiljöer. De har också automatiserat rensning av index vid uppdatering av miljöer.
Resultat:
- Minskad lagring av sökindex med 35 %.
- Förbättrade uppdateringstider för miljön med 20 %.
- Sänkt övergripande användning av logg- och databaslagring.
Fallstudie 4: Använda dataexport för analys utan att duplicera lagring
Kundprofil: En vårdgivare som använder Dynamics 365 och Dataverse för patientengagemang och fakturering.
Utmaning: Analysteamet behövde åtkomst till driftdata för trendanalys och AI-modellering, men att duplicera data till ett separat lager ökade lagringskostnaderna och komplexiteten.
Lösning: Kunden använde Azure Synapse Link med inkrementell export och nivåindelad lagring i OneLake. De behöll endast viktiga analysdata och tillämpade kvarhållningsprinciper för att hantera historiskt djup.
Resultat:
- Möjliggjorde analys i realtid utan att påverka operativa system.
- Minskad redundant lagring med 45 %.
- Förbättrad styrning över livscykeln för analysdata.
Slutsats
Effektiv lagringshantering är avgörande för att upprätthålla systemprestanda och optimera resursutnyttjandet i Dynamics 365-miljöer. Rensningsrutinerna och arkiveringsjobben som beskrivs i den här artikeln ger robusta lösningar för att frigöra värdefullt databasutrymme och effektivisera åtgärderna. Genom att använda dessa verktyg som LTR och liknande tekniker kan kunder hantera vanliga lagringsutmaningar och skapa hållbara datahanteringsmetoder. Dessutom visar verkliga fallstudier effektiviteten av dessa metoder och ger insikter i deras praktiska tillämpningar. Genom att anta dessa strategier kan organisationer proaktivt hantera sina lagringsbehov och förbättra den övergripande effektiviteten.
Referenser
Rensning av förråd i Dataverse:
- Frigör lagringsutrymme
- Rensa poster från tabellerna System Job (AsyncOperationBase) och Process Log (WorkflowLogBase)
Rensa lagringsutrymme i finans och drift:
- Lagringskapacitet för ekonomi och drift
- Rensningsrutiner i Dynamics 365 Finance och Dynamics 365 Supply Chain Management
- Arkivera data för kreditkortstransaktion – handel
Lagringskapacitet: