Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Microsoft Fabric je analytické řešení typu vše v jednom pro podniky, které pokrývá vše od přesunu dat až po datové vědy, analýzy v reálném čase a business intelligence. Nabízí komplexní sadu služeb, včetně datového jezera, přípravy dat a integrace dat na jednom místě. Pro více informací viz Co je Fabric?
Tento kurz vás provede kompletním scénářem od získávání dat po spotřebu dat. Pomůže vám vybudovat základní porozumění platformě Fabric, včetně různých uživatelských zážitků a způsobu jejich integrace, stejně jako zkušeností profesionálních a amatérských (neprofesionálních) vývojářů při práci na této platformě. Tento kurz není určen jako referenční architektura, vyčerpávající seznam funkcí nebo doporučení konkrétních osvědčených postupů.
Kompletní scénář Lakehouse
Organizace tradičně vytvářejí moderní datové sklady pro potřeby transakčních a strukturovaných analýz dat. A data lakehousy pro potřeby analýzy velkých (částečně nebo nestrukturovaných) dat. Tyto dva systémy běžely paralelně, což vytvářelo informační izolace, duplikaci dat a zvyšovalo celkové náklady na vlastnictví.
Platforma Fabric se svým sjednocením úložišť dat a standardizací na formátu Delta Lake umožňuje odstranit datová sila, eliminovat duplikace dat a výrazně snížit celkové náklady na vlastnictví.
Díky flexibilitě, kterou nabízí Fabric, můžete implementovat architektury lakehouse nebo datového skladu nebo je kombinovat, abyste získali to nejlepší z obou s jednoduchou implementací. V tomto kurzu si vezmete jako příklad maloobchodní organizaci a od začátku do konce sestavíte její lakehouse. Používá architekturu medailonové architektury, ve které má bronzová vrstva nezpracovaná data, stříbrná vrstva má ověřená a deduplikovaná data a zlatá vrstva má vysoce rafinovaná data. Stejný přístup můžete využít k implementaci jezera pro jakoukoli organizaci z libovolného odvětví.
Tento kurz vysvětluje, jak vývojář fiktivní společnosti Wide World Importers z maloobchodní domény dokončí následující kroky:
Přihlaste se do svého účtu Power BI a přihlaste se k bezplatné zkušební verzi Fabric. Pokud nemáte licenci Power BI, zaregistrujte si bezplatnou licenci Fabric, abyste mohli spustit zkušební verzi Fabric.
Sestavte a implementujte kompletní lakehouse pro vaši organizaci:
- Vytvořte Fabric pracovní prostor.
- Vytvořte jezero.
- Ingestování dat, transformace dat a jejich načtení do jezera. Můžete rovněž prozkoumat OneLake, jednu kopii vašich dat v režimu Lakehouse a v režimu koncového bodu pro SQL Analytics.
- Připojte se ke svému lakehouse pomocí SQL analytics endpointu a vytvořte sémantický model a vytvořte report pro analýzu prodejních dat napříč různými dimenzemi.
- Můžete volitelně řídit a plánovat příjem a transformaci dat pomocí datového potrubí. Kanály zahrnují aktivity zaměřené na Lakehouse, jako je aktivita Údržba Lakehouse (k automatizaci údržby tabulek Delta pomocí OPTIMIZE a VACUUM) a aktivita Aktualizovat koncový bod analýz SQL (aby po načtení dat zůstal koncový bod analýz SQL synchronizovaný). Tvůrce výrazů kanálu zahrnuje také asistenci Copilota pro rychlejší a přesnější vytváření výrazů. Podrobnosti najdete v tématu Aktivita údržby Lakehouse.
Vyčistěte prostředky odstraněním pracovního prostoru a dalších položek.
Architektura
Následující obrázek znázorňuje komplexní architekturu lakehouse. Zahrnuté součásti jsou popsány v následujícím seznamu.

Zdroje dat: Prostředky infrastruktury umožňují rychlé a snadné připojení ke službám Azure Data Services a dalším cloudovým platformám a místním zdrojům dat pro efektivnější příjem dat.
Načítání dat: Přehledy pro vaši organizaci můžete rychle vytvářet pomocí více než 200 nativních konektorů. Tyto konektory jsou integrované do kanálu Fabric a využívají uživatelsky přívětivou transformaci dat pomocí toku dat. Kromě toho se s funkcí Zástupce v programu Fabric můžete připojit k existujícím datům, aniž byste je museli kopírovat nebo přesouvat. Klávesové zkratky OneLake můžou také odkazovat na datové produkty napříč tenanty prostřednictvím externího sdílení dat OneLake, které umožňují přístup k živým a řízeným provozním datům bez kopírování nebo sestavování kanálů ETL. Fabric také zahrnuje vysoce výkonné vektorizované nástroje pro čtení souborů pro běžné formáty, jako je CSV (s podporou pro JSON bude brzy přidána), aby se snížila latence při příjmu.
Přeměna a ukládání: Fabric standardizuje na formátu Delta Lake. To znamená, že všechny moduly Fabric mají přístup ke stejné datové sadě uložené ve OneLake a manipulovat s nimi bez duplikování dat. Jednotný model správy OneLake zajišťuje, že data přístupná prostřednictvím zástupců podléhají stejným zásadám zabezpečení a shody s předpisy jako data uložená místně, čímž poskytuje jednotnou verzi pravdy v celé organizaci. Tento systém úložiště poskytuje flexibilitu při sestavování jezer s využitím architektury medailonu nebo datové sítě v závislosti na požadavcích vaší organizace. Pro transformaci dat si můžete vybrat prostředí s nízkým kódem nebo bez kódu, které využívá kanály, toky dat nebo poznámkové bloky nebo Spark pro první prostředí s kódem. Tabulky Lakehouse také podporují optimalizace výkonu, jako je řazení Z a Liquid Clustering za účelem zlepšení výkonu dotazů a správy rozložení dat ve velkém měřítku. Materializovaná zobrazení lake jsou navíc k dispozici pro předkomputování a ukládání výsledků do mezipaměti nad daty lakehouse, což zrychluje opakovanou analýzu. Operacionalizace může zahrnovat automatizovanou údržbu tabulek Lakehouse Delta prostřednictvím aktivity Údržba Lakehouse a spuštění aktualizace koncového bodu analýzy SQL jako součást kroků po provedení načítání – podrobnosti najdete ve volitelném kroku orchestrace kanálů v přehledu výše uvedeného scénáře.
Využívání: Power BI může využívat data z Lakehouse pro vytváření sestav a vizualizaci. Každý Lakehouse má integrovaný koncový bod TDS, koncový bod analýzy SQL, který umožňuje snadné připojení a dotazování dat v tabulkách Lakehouse z jiných nástrojů pro vytváření sestav. Orchestrace kanálu může zahrnovat krok aktualizace koncového bodu Analýzy SQL Lakehouse, aby se zajistilo, že schéma a metadata jsou aktuální pro nástroje pro vytváření sestav po načtení dat. Podrobnosti najdete v kroku orchestrace volitelného kanálu ve výše uvedeném přehledu scénáře.
Prostřednictvím sdílení dat mezi tenanty mohou sestavy, sémantické modely a úlohy umělé inteligence a datových věd využívat sdílená data OneLake i napříč hranicemi organizací, což umožňuje spolupráci bez duplikování dat.
Ukázková datová sada
Tento kurz používá ukázkovou databázi WWI (Wide World Importers), kterou naimportujete do jezera v dalším kurzu. V případě kompletního scénáře lakehouse obsahuje datová sada dostatečná data pro prozkoumání možností škálování a výkonu platformy Fabric.
Wide World Importers (WWI) je velkoobchodní dovozce nového zboží a distributor provozující z oblasti San Francisco Bay. Jako velkoobchodník má WWI většinou zákazníky, kteří jsou společnosti přeprodávající fyzickým osobám. WWI prodává maloobchodním zákazníkům v celém USA včetně speciálních obchodů, supermarketů, výpočetních obchodů, turistických atrakcí a některých jednotlivců. WWI také prodává jiným velkoobchodníkům prostřednictvím sítě agentů, kteří podporují produkty jménem WWI. Další informace o profilu a provozu společnosti najdete v ukázkových databázích Wide World Importers pro Microsoft SQL.
Obecně platí, že data se přenesou z transakčních systémů nebo obchodních aplikací do jezera. Pro zjednodušení v tomto kurzu však použijete dimenzionální model, který poskytuje WWI jako počáteční zdroj dat. Data ingestujete do jezera a transformujete je prostřednictvím různých fází (bronzová, stříbrná a zlatá) architektury medailiónu.
Datový model
I když model WWI obsahuje mnoho tabulek faktů, v tomto kurzu se používá tabulka faktů Prodeje a její korelované dimenze. Následující příklad znázorňuje datový model WWI:

Tok dat a tok transformací
Jak je popsáno výše, tento kurz používá ukázková data ze vzorových dat WWI (Wide World Importers) k vytvoření kompletního jezera. V této implementaci jsou ukázková data uložená v účtu úložiště Dat Azure ve formátu souboru Parquet pro všechny tabulky. V reálných scénářích ale data obvykle pocházejí z různých zdrojů a v různých formátech.
Následující obrázek ukazuje zdroj, cíl a transformaci dat:

Zdroj dat: Zdrojová data jsou ve formátu souboru Parquet a v nedílné struktuře. Je uložená ve složce pro každou tabulku. V tomto kurzu nastavíte kanál pro příjem kompletních historických nebo jednorázových dat do jezera.
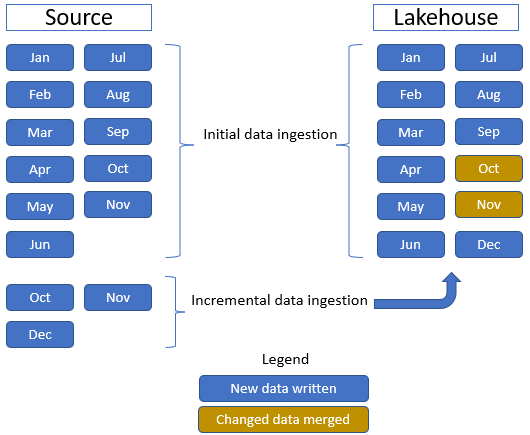
V tomto kurzu použijete tabulku faktů Prodej , která obsahuje jednu nadřazenou složku s historickými daty po dobu 11 měsíců (s jednou podsložkou pro každý měsíc) a jinou složku obsahující přírůstková data po dobu tří měsíců (jedna podsložka pro každý měsíc). Během počátečního nahrávání dat je do tabulky datového jezera ingestováno 11 měsíců dat. Po doručení přírůstkových dat se aktualizovaná data z října a listopadu sloučí s existujícími daty a nová prosincová data se zapíšou do tabulky lakehouse, jak je znázorněno na následujícím obrázku:
Lakehouse: V tomto tutoriálu vytvoříte lakehouse, vložíte data do sekce souborů lakehouse a poté vytvoříte tabulky Delta Lake v sekci Tabulky lakehouse.
Transformace: Pro přípravu a transformaci dat se tento kurz zabývá dvěma různými přístupy: poznámkové bloky a Spark pro prostředí pro první kód a kanály a toky dat pro prostředí s nízkým kódem nebo bez kódu. Nejnovější Fabric runtime zahrnuje nativní výkonový modul, který přináší významná vylepšení výkonu oproti open-source Sparku pro úlohy v poznámkových blocích a Spark workloadech. Tvůrce výrazů potrubí zahrnuje asistenta Copilot, který pomáhá při vytváření výrazů a logiky potrubí pro rychlejší a přesnější generování výrazů.
Spotřebovávat: Power BI může spotřebovávat data z lakehouse pro vytváření sestav a vizualizaci. Každý lakehouse má integrovaný koncový bod TDS, který se označuje jako koncový bod analýzy SQL pro snadné připojení a dotazování dat v tabulkách lakehouse z jiných nástrojů pro vytváření sestav. K přímému dotazování tabulek datového jezera Power BI můžete také použít Direct Lake přes OneLake bez nutnosti importu nebo specifického cyklu aktualizace sémantického modelu. Kromě toho můžete data zpřístupnit nástrojům pro vytváření sestav od jiných společností než Microsoft pomocí koncového bodu TDS/SQL Analytics pro připojení a spuštění dotazů SQL pro analýzu.
V případě úloh Spark SQL se klienti kompatibilní s rozhraním ODBC můžou připojit pomocí Microsoft ODBC Driver for Microsoft Fabric Data Engineering (Preview) s ověřováním Microsoft Entra ID (interaktivním, Azure CLI, služba principal, certifikátem nebo přístupovým tokenem).
