Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Azure Kubernetes Service (AKS)
Azure Front Door
Application Gateway Azure
Azure Container Registry
Pare-feu Azure
Cette architecture décrit comment exécuter plusieurs instances d’un cluster Azure Kubernetes Service (AKS) à travers plusieurs régions dans une configuration active/active et hautement disponible.
Cette architecture repose sur l’architecture de référence AKS, point de départ recommandé par Microsoft pour une infrastructure AKS. La référence AKS détaille des fonctionnalités infrastructurelles telles que Microsoft Entra Workload ID, les restrictions d’entrée et de sortie, les limites de ressources et d’autres configurations d’infrastructure AKS sécurisée. Le présent document ne traite pas de ces détails infrastructurels. Nous vous recommandons de vous familiariser avec la base de référence AKS avant de continuer avec le contenu multirégion.
Architecture

Téléchargez un fichier Visio de cette architecture.
Composants
De nombreux composants et services Azure sont utilisés dans cette architecture AKS multirégion. Seuls les composants uniques à cette architecture multi-cluster sont répertoriés ici. Pour le reste, veuillez consulter l’architecture de référence d’AKS.
- clusters AKS régionaux : plusieurs clusters AKS sont déployés, chacun dans une région Azure distincte. Pendant les opérations normales, Azure Front Door achemine le trafic réseau entre tous les clusters de toutes les régions. Si une région ou un cluster devient indisponible, Azure Front Door achemine le trafic vers un cluster, généralement dans une région la plus proche de l’utilisateur qui a émis la demande.
- Réseaux hub-spoke régionaux : Un réseau virtuel hub-spoke régional est déployé pour chaque instance AKS régionale. Azure Firewall Manager gère les stratégies de pare-feu dans toutes les régions.
- coffre de clés régional : Azure Key Vault est approvisionné dans chaque région. Les coffres de clés sont utilisés pour stocker les valeurs sensibles et les clés spécifiques au cluster AKS, ainsi que pour prendre en charge les services qui se trouvent dans cette région.
- Plusieurs espaces de travail de journal : les espaces de travail Log Analytics Régional sont utilisés pour stocker les métriques de mise en réseau régionales et les journaux de diagnostic. De plus, une instance partagée de Log Analytics permet de stocker les métriques et les journaux de diagnostic de toutes les instances d’AKS.
- Flotte AKS :Azure Kubernetes Fleet Manager est déployé pour coordonner les mises à jour des versions de cluster Kubernetes et les mises à jour de version d’image de nœud sur chacun des clusters AKS régionaux.
- Cluster Fleet Hub (géré par Microsoft) :si vous le souhaitez, un seul cluster Hub Azure Kubernetes Fleet Manager peut être déployé pour prendre en charge des fonctionnalités spécifiques des flottes, telles que la propagation de la charge de travail. Le cluster hub est une ressource Azure à étendue régionale qui permet de gérer la propagation de la charge de travail et l’équilibrage de charge sur plusieurs clusters membres. Il est préférable de déployer le cluster hub en tant que cluster de hub privé, qui doit être accessible à partir de clusters membres pour prendre en charge les signaux de pulsation et effectuer des processus de rapprochement de configuration.
- profil Azure Front Door global :azure Front Door est utilisé pour équilibrer la charge et acheminer le trafic vers une instance Azure Application Gateway régionale, qui se trouve devant chaque cluster AKS. Azure Front Door permet un routage global de couche 7, tous deux étant requis pour cette architecture.
- Registre de conteneurs global : les images conteneur de la charge de travail sont stockées dans un registre de conteneurs managé. Dans cette architecture, un seul registre de conteneurs Azure est utilisé pour toutes les instances de Kubernetes au sein du cluster. La géoréplication pour Azure Container Registry permet de répliquer des images dans les régions Azure sélectionnées et de fournir un accès continu aux images même si une région rencontre une panne.
Alternatives
Cette solution utilise Azure Kubernetes Fleet Manager. Les flottes permettent de gérer plusieurs clusters, en mettant l’accent sur la réduction de la surcharge opérationnelle jour 2 en fournissant un plan de gestion capable d’orchestrer des activités sur plusieurs clusters. Les avantages de Azure Kubernetes Fleet Manager augmentent à mesure que le nombre de clusters de votre flotte augmente.
Dans cette solution, la flotte orchestre les mises à jour des versions de Kubernetes sur plusieurs clusters, ainsi que les mises à jour des versions des images des nœuds. Ces fonctionnalités ne nécessitent pas de déploiement d’un cluster hub. Vous pouvez choisir que chaque cluster effectue indépendamment des mises à jour de version Kubernetes et d'images de nœud, ce qui ne nécessite pas de gestion de flotte. Toutefois, si vous le faites, les clusters sont susceptibles d’obtenir des mises à jour de version à différents moments et peuvent devenir difficiles à valider votre charge de travail et votre configuration avec plusieurs versions dans votre environnement de production simultanément.
Vous pouvez également utiliser une flotte pour la coordination du déploiement de charge de travail, ce qui nécessite l’ajout d’un cluster hub. Les déploiements de charges de travail sont abordés plus en détail plus loin dans cet article.
Modèles de conception
Cette architecture utilise deux modèles de conception cloud :
- Des géodes (nœuds géographiques), où n’importe quelle région peut traiter n’importe quelle requête.
- Des empreintes de déploiement, où plusieurs copies indépendantes d’une application ou d’un composant d’application sont déployées à partir d’une seule source, comme un modèle de déploiement.
Considérations sur le modèle Géode
Au moment de sélectionner les régions dans lesquelles chaque cluster AKS sera déployé, envisagez celles qui sont proches du consommateur de la charge de travail ou de vos clients. De même, envisagez d’utiliser la réplication interrégion. La réplique inter-régionale réplique de façon asynchrone les mêmes applications et données dans d’autres régions Azure pour assurer la protection en cas de récupération d’urgence. Même si votre cluster se développe jusqu’à s’étendre à plus de deux régions, continuez de planifier la réplication interrégion pour chaque paire de clusters AKS.
Dans chaque région, les nœuds des pools de nœuds AKS sont répartis sur plusieurs zones de disponibilité pour éviter les problèmes en raison de défaillances de zone. Les zones de disponibilité sont prises en charge dans de nombreuses régions. Pour plus d’informations sur AKS et les zones de disponibilité, notamment la liste des régions prises en charge, consultez Zones de disponibilité AKS.
Considérations relatives aux empreintes de déploiement
Lorsque vous gérez une solution AKS multirégion, vous déployez plusieurs clusters AKS dans plusieurs régions. Chacun de ces clusters est considéré comme une empreinte. En cas de panne régionale, ou si vous devez ajouter plus de capacité ou renforcer la présence régionale de vos clusters, vous devrez peut-être créer un nouveau stamp. Lors de la sélection d’un processus de création et de gestion des tampons de déploiement, il est important de prendre en compte les facteurs suivants :
- Sélectionnez une technologie compatible avec les définitions d’empreinte qui autorise une configuration généralisée. Par exemple, vous pourriez utiliser Bicep pour définir l’infrastructure en tant que code.
- Fournissez des valeurs spécifiques à l’instance à l’aide d’un mécanisme d’entrée pour le déploiement, par exemple des variables ou des fichiers de paramètres.
- Sélectionnez les outils qui permettent un déploiement flexible, renouvelable et idempotent.
- Dans une configuration d’empreinte de type actif/actif, tenez compte de la façon dont le trafic est équilibré entre chaque empreinte. Cette architecture utilise Azure Front Door pour l’équilibrage de charge global.
- Au fur et à mesure que des empreintes sont ajoutées et supprimées de la collection, tenez compte des problèmes de capacité et de coût.
- Déterminez comment gagner en visibilité de la collection de timbres et supervisez-la comme une seule unité.
Chacun de ces éléments est détaillé avec des conseils spécifiques dans les sections suivantes.
Considérations
Ces considérations implémentent les piliers d’Azure Well-Architected Framework qui est un ensemble de principes directeurs qui permettent d’améliorer la qualité d’une charge de travail. Pour plus d’informations, consultez Microsoft Azure Well-Architected Framework.
Déploiement et initialisation des clusters
Une empreinte de cluster multirégion se comporte comme un système, et non comme un ensemble de clusters indépendants. Concevez-le en conséquence :
- Utilisez le déploiement et la configuration pilotés par le code afin que chaque cluster soit aussi proche que possible.
- Planifiez la façon dont vous ajoutez et supprimez des clusters en tant que modifications de capacité ou de présence régionale.
- Comptez des pannes de zone de disponibilité, des défaillances régionales et des interruptions similaires dans votre conception.
Définition d’un cluster
Vous disposez de nombreuses options pour déployer un cluster Azure Kubernetes Service. Le portail Azure, les Azure CLI et les Azure PowerShell sont toutes des options décentes pour le déploiement de clusters AKS individuels ou non dissociés. Ces méthodes peuvent toutefois présenter des défis lorsque vous travaillez avec de nombreux clusters AKS étroitement couplés. Par exemple, l’utilisation du portail Azure peut entraîner des erreurs de configuration si certaines étapes sont manquantes ou si des options de configuration ne sont pas disponibles. Le déploiement et la configuration de nombreux clusters à l’aide du portail sont des processus qui demandent du temps. Ils doivent être effectués au moment opportun et mobilisent toute l’attention d’un ou de plusieurs ingénieurs. Si vous utilisez Azure CLI ou Azure PowerShell, vous pouvez construire un processus reproductible et automatisé à l’aide des outils en ligne de commande. Toutefois, il vous incombe d’intégrer dans ces scripts l’idempotence, la gestion des échecs de déploiement et la logique de reprise.
Lorsque vous travaillez avec plusieurs instances AKS, nous vous recommandons d’envisager l’infrastructure en tant que solutions de code, telles que Bicep ou Terraform. Les solutions Infrastructure as Code (IaC) fournissent un déploiement automatisé, évolutif et idempotent. Par exemple, vous pourriez utiliser un fichier Bicep pour les services partagés de la solution et un autre pour les clusters AKS et autres services régionaux. En utilisant l'infrastructure en tant que code, vous pouvez définir une empreinte de déploiement avec des configurations généralisées, telles que le réseau, l'autorisation et les diagnostics. Un fichier de paramètres de déploiement peut être fourni avec des valeurs spécifiques aux empreintes et aux régions. Avec une telle configuration, un seul modèle permet de déployer une empreinte quasiment identique dans n’importe quelle région.
Déploiement de cluster
Une fois que l’empreinte du cluster est définie, vous avez de nombreuses options pour déployer des empreintes individuelles ou multiples. Nous vous recommandons d’utiliser une technologie d’intégration continue moderne telle que GitHub Actions ou Azure Pipelines. Les solutions de déploiement basées sur l’intégration continue présentent les avantages suivants :
- Déploiements basés sur du code, qui permettent d’ajouter et de supprimer des empreintes en utilisant du code
- Fonctionnalités de test intégrées
- Environnement intégré et fonctionnalités de préproduction
- Solutions intégrées de gestion des secrets
- Intégration avec le contrôle de code source, pour le code d’application et les scripts de déploiement et les modèles
- Historique de déploiement et journalisation
- Fonctionnalités de contrôle d’accès et d’audit, qui permettent de contrôler qui peut apporter des modifications, et dans quelles conditions
À mesure que de nouvelles empreintes sont ajoutées ou supprimées dans le cluster global, le pipeline de déploiement doit être mis à jour pour rester cohérent. Une approche consiste à déployer les ressources de chaque région comme une étape individuelle au sein d’un workflow GitHub Actions. Cette configuration est simple, car chaque instance de cluster est clairement définie dans le pipeline de déploiement. Cette configuration présente quelques contraintes administratives liées à l’ajout et à la suppression de clusters dans le déploiement.
Une autre option consiste à créer une logique métier pour créer des clusters à partir d’une liste de lieux souhaités ou d’autres points de données indicateurs. Par exemple, le pipeline de déploiement peut contenir une liste de régions souhaitées. L’une des étapes du pipeline peut ensuite consister à parcourir cette liste en boucle, en déployant un cluster dans chaque région de la liste. L’inconvénient de cette configuration réside dans la complexité de la généralisation du déploiement et dans le fait que chaque empreinte de cluster n’est pas explicitement détaillée dans le pipeline de déploiement. L’avantage est que tout ajout ou toute suppression d’empreintes de cluster dans le pipeline se transforme en une simple mise à jour de la liste des régions souhaitées.
Après la création d’un cluster, il doit être inscrit dans la flotte en tant que cluster membre. Cette étape peut être effectuée en déployant une ressource Resource Manager de type Microsoft.ContainerService/fleets/members, qui fait référence à l’ID de ressource du cluster membre. Une fois que le cluster membre est inscrit dans la flotte, vous pouvez l’ajouter pour mettre à jour les exécutions et utiliser d’autres fonctionnalités de flotte que vous configurez.
La suppression d’un stamp de cluster du pipeline de déploiement ne met pas toujours les ressources du stamp hors service. Selon votre solution de déploiement et sa configuration, vous aurez peut-être besoin de passer par une étape supplémentaire pour désactiver les instances AKS et autres ressources Azure. Envisagez d’utiliser des piles de déploiement pour activer la gestion de cycle de vie complète des ressources Azure, notamment le nettoyage lorsque vous n’en avez plus besoin.
Démarrage de cluster
Après le déploiement de chaque empreinte ou instance de Kubernetes, les composants de cluster tels que les contrôleurs d’entrée, les solutions d’identité et les composants de charge de travail doivent être déployés et configurés. Vous devrez peut-être créer des espaces de noms Kubernetes, et vous devez également envisager d’appliquer des stratégies de sécurité, d’accès et de gouvernance au sein du cluster. Ces opérations sont appelées démarrage du cluster pour préparer les charges de travail qui seront déployées.
Comme pour le déploiement, les configurations de démarrage peuvent devenir difficiles à gérer manuellement sur plusieurs instances Kubernetes. Si vous utilisez un cluster hub avec Azure Kubernetes Fleet Manager, vous pouvez déployer une partie de la configuration de démarrage dans votre flotte, comme les espaces de noms. Toutefois, d’autres composants de démarrage nécessitent une approche de déploiement différente.
Vous devez envisager l’une des options suivantes pour appliquer à grande échelle la configuration d’amorçage et la politique associée :
GitOps : Au lieu de configurer manuellement des composants Kubernetes sur chaque cluster, utilisez des méthodes automatisées pour appliquer des configurations à un cluster Kubernetes. Ces configurations peuvent être vérifiées dans un référentiel source. Ce processus est souvent appelé GitOps. Les solutions GitOps populaires pour Kubernetes incluent Flux et Argo CD. Par exemple, l’extension Flux pour AKS permet de démarrer automatiquement les clusters immédiatement après leur déploiement.
GitOps fait l’objet d’une présentation détaillée dans l’architecture de référence d’AKS. Par l’utilisation d’une approche GitOps pour la configuration, vous garantissez que chaque instance de Kubernetes est configurée de manière similaire, sans effort particulier. L'emploi d'un processus de configuration simplifié devient d'autant plus important que la taille de votre flotte augmente.
Vous pouvez utiliser une approche GitOps pour déployer la configuration du cluster de base. Vous pouvez inscrire le cluster dans la flotte pour participer à des activités à l’échelle de la flotte telles que les déploiements de mise à niveau automatisés.
Vous pouvez également utiliser GitOps pour déployer vos charges de travail. Pour plus d’informations, consultez la section Déploiement de charge de travail plus loin dans cet article.
Azure Policy : à mesure que plusieurs instances Kubernetes sont ajoutées, l’avantage de la gouvernance, de la conformité et de la configuration basées sur des stratégies augmente. Les stratégies, et plus particulièrement celles d’Azure Policy, offrent une méthode centralisée et scalable de contrôle de cluster. Les avantages des stratégies AKS sont détaillés dans l’architecture de référence d’AKS.
Azure Policy doit être activé lors de la création des clusters AKS. Les initiatives doivent être assignées en mode Audit pour obtenir une visibilité sur la non-conformité. Vous pouvez également définir plus de politiques qui ne font pas partie des initiatives intégrées. Ces stratégies sont définies en mode Refus. Par exemple, vous pouvez créer une stratégie qui garantit que seules les images conteneur approuvées sont exécutées dans le cluster. Envisagez de créer vos propres initiatives personnalisées. Regroupez les stratégies applicables à votre charge de travail dans une seule affectation.
L’étendue de la stratégie fait référence à la cible de chaque stratégie et initiative de stratégie. Vous pourriez utiliser Bicep pour assigner des politiques au groupe de ressources dans lequel chaque cluster AKS est déployé. L’augmentation de l’empreinte du cluster global entraîne la création de nombreuses stratégies dupliquées. Vous pouvez également étendre les stratégies à un abonnement Azure ou à un groupe d’administration Azure. Cette méthode vous donne la possibilité d’appliquer un ensemble unique de stratégies à tous les clusters AKS dans l’étendue d’un abonnement ou à tous les abonnements trouvés sous un groupe d’administration.
Quand vous concevez une stratégie pour plusieurs clusters AKS, tenez compte des éléments suivants :
- Appliquez des stratégies qui devraient s'appliquer globalement à toutes les instances AKS à un groupe de gestion ou à un abonnement.
- Placez chaque cluster régional dans son propre groupe de ressources, ce qui permet aux stratégies spécifiques à la région de s'appliquer à ce groupe de ressources.
Pour obtenir des informations utiles pour établir une stratégie de gestion des politiques, consultez Organisation des ressources du Cloud Adoption Framework.
Enrôlement de flotte
Une fois qu’un cluster est déployé et configuré, vous l’inscrivez dans la flotte en tant que cluster membre. Chaque cluster membre peut être affecté à un groupe de mises à jour, qui peut être utilisé dans le cadre d’une stratégie de mise à jour pour déterminer où, dans une exécution de mise à jour, le cluster est mis à jour. Pour en savoir plus sur l’inscription de cluster, les groupes et les stratégies de mise à jour, consultez Définir des stratégies de mise à jour réutilisables à l’aide d’Azure Kubernetes Fleet Manager.
Déploiement de charge de travail
Chaque cluster AKS de votre architecture exécute des applications qui prennent en charge votre charge de travail. Il est important de planifier la façon dont vous allez déployer et mettre à niveau vos composants de charge de travail de manière sécurisée et contrôlée, et de maintenir la cohérence des versions d’application entre chaque cluster. Par conséquent, en plus de la configuration de l'instance AKS, tenez compte des charges de travail déployées dans chaque instance ou ensemble régional. Vos solutions de déploiement ou pipelines nécessitent une configuration pour prendre en charge chaque tampon régional. Au fur et à mesure que des empreintes sont ajoutées au cluster global, le processus de déploiement doit être suffisamment étendu ou flexible pour prendre en charge les nouvelles instances régionales.
Vous pouvez envisager plusieurs approches de déploiement, notamment :
Pipelines: Pour les scénarios qui n’ont que quelques clusters et relativement peu de déploiements simples, il est souvent préférable d’utiliser des pipelines de livraison continue (CD) dédiés légers.
Un seul pipeline déploie généralement une charge de travail sur un ou plusieurs clusters. Cette approche réduit la surcharge opérationnelle et reste gérable dans les environnements à faible échelle. Lorsque vous passez d’un cluster unique à un modèle à plusieurs clusters, vous pouvez faire évoluer les pipelines de déploiement que vous avez déjà en place.
Propagation des charges de travail dans Azure Kubernetes Fleet Manager : La propagation des charges de travail permet d’orchestrer les définitions de charges de travail dans plusieurs clusters membres à partir d’un plan de contrôle centralisé. Les flottes prennent en charge une approche fiable et évolutive des déploiements de charges de travail, ce qui permet un grand nombre de charges de travail et de clusters membres. Vous pouvez également créer des déploiements intermédiaires, qui appliquent des mises à jour à des clusters spécifiques avant d’autres. Pour plus d’informations, consultez Azure Placement intelligent des ressources Kubernetes Fleet Manager.
La propagation de la charge de travail nécessite l’utilisation d’un cluster hub, qui est un cluster AKS géré par Microsoft qui permet de suivre l’état attendu de vos clusters membres. Ce cluster hub est une ressource régionale qui fonctionne en tant que plan de contrôle et ne sert pas de trafic de charge de travail. Si une panne régionale affecte le cluster hub, les charges de travail qui s’exécutent déjà sur les clusters membres ne sont pas affectées, car chaque cluster membre conserve son propre plan de contrôle Kubernetes et son plan de données. Toutefois, de nouveaux placements, rapprochement de configuration et orchestration de mise à jour s’interrompent jusqu’à ce que le hub récupère.
Lorsque vous étendez votre flotte multirégion pour inclure des clusters où des charges de travail sont déjà déployées via des pipelines ou GitOps, utilisez la reprise en charge des charges de travail (version préliminaire) pour placer ces ressources existantes sous la gestion de la flotte sans les redéployer. Cette fonctionnalité vous permet d’adopter la propagation incrémentielle de la charge de travail de la flotte à mesure que vous ajoutez des tampons régionaux. Après la prise en charge, les mises à jour de charge de travail en cours transitent par le cluster hub comme toute autre ressource gérée par la flotte. Désaffectez ou reconfigurez le mécanisme de déploiement précédent (tel que Flux ou un pipeline CD) pour ces ressources afin d’éviter les conflits avec la réconciliation de l’agent membre de la flotte. Vous pouvez utiliser les déploiements automatisés (version préliminaire) pour connecter directement un référentiel GitHub au cluster hub afin de générer des images et de préparer des manifestes pour le placement.
GitOps : À mesure que votre infrastructure mûrit davantage, l’adoption d’une stratégie basée sur GitOps devient de plus en plus bénéfique. GitOps permet des mécanismes de déploiement déclaratifs, auditables et pull, offrant une scalabilité, une gouvernance et une collaboration d’équipe. La transition vers ce modèle est particulièrement recommandée lors de la gestion d’une grande flotte dynamique de clusters dans plusieurs régions.
Pour en savoir plus, consultez GitOps pour Azure Kubernetes Service.
Pour déterminer quelle approche est logique pour votre solution, tenez compte des questions suivantes :
- Attendez-vous que le nombre de clusters reste fixe ou augmente au fil du temps ? Si vous envisagez d’étendre le nombre de clusters ou si vous envisagez d’ajuster le nombre de clusters dynamiquement, il peut rapidement devenir difficile de gérer la configuration de chaque cluster dans vos pipelines de déploiement.
- Combien d’unités déployables devez-vous gérer ? Si vous n’avez que quelques applications monolithiques, vous devez uniquement coordonner quelques déploiements. Si vous utilisez une architecture de microservices distribuée, avez de nombreuses charges de travail, ou les deux, le nombre peut rapidement augmenter à des centaines d’unités déployables. La création d’un pipeline pour chaque déploiement peut devenir impossible et l’utilisation de la propagation de la charge de travail d’une flotte ou du déploiement de charge de travail basé sur GitOps peut devenir plus importante.
- Quels types de stratégies de déploiement avez-vous besoin ? Les stratégies courantes incluent les mises à jour progressives, les déploiements bleu-vert et les déploiements canary. Certaines approches de déploiement doivent permettre de « passer du temps » entre les déploiements, avec une surveillance étroite pour vérifier les régressions introduites par le déploiement. Évaluez chaque approche de déploiement pour déterminer si elle prend en charge vos besoins spécifiques.
- Dans quelles contraintes de sécurité réseau vos clusters opèrent-ils ? Azure Kubernetes Fleet Manager fonctionne sous une topologie de cluster hub-and-spoke, où les clusters membres conservent des connexions sortantes vers un cluster hub central pour la rapprochement des charges de travail et la surveillance des pulsations. Une stratégie basée sur GitOps nécessite que les clusters participants établissent un accès sortant à un référentiel Git. Lorsque vous utilisez des pipelines, l’agent de pipeline nécessite généralement une connectivité à chaque cluster pour effectuer des opérations de déploiement.
Quelle que soit la façon dont vous allez orchestrer vos déploiements, visez à généraliser chaque déploiement, par exemple avec un graphique Helm, pour vous assurer qu’une configuration de déploiement unique peut être utilisée sur plusieurs clusters (tampons). Réfléchissez également à la façon dont la journalisation des diagnostics d’application et le suivi distribué peuvent être configurés pour l’observabilité à l’échelle de l’application sur chacun de vos clusters.
Fiabilité
La fiabilité garantit que votre application peut respecter les engagements que vous prenez à vos clients. Pour plus d’informations, consultez la liste de vérification de la révision de conception pour la fiabilité.
Une motivation significative pour le choix d’une architecture Kubernetes multirégion est la disponibilité du service. En d’autres termes, si un service ou un composant de service n’est plus disponible dans une région, le trafic doit être routé vers une région où une autre instance de ce service reste disponible. Une architecture multirégion comprend de nombreux points d’échec différents. Dans cette section, chacun de ces points de défaillance potentiels est présenté.
Échecs de pods d’application
Un objet de déploiement Kubernetes permet de créer un ReplicaSet, qui gère plusieurs réplicas d’un pod. Si un pod n’est pas disponible, le trafic est routé entre les pods restants. Le ReplicaSet Kubernetes tente de maintenir opérationnels le nombre spécifié de réplicas. Si une instance tombe en panne, Kubernetes crée automatiquement une nouvelle instance. Les probes de vivacité peuvent être utilisées pour vérifier l’état de l’application ou du processus en cours d’exécution dans le pod. Si le service ne répond pas, la probe liveness supprime le pod, forçant ainsi le ReplicaSet à créer une autre instance.
Pour plus d’informations, consultez ReplicaSet Kubernetes.
Défaillances matérielles du centre de données
Une défaillance localisée peut parfois se produire. Par exemple, un seul rack de serveurs Azure peut être privé d'alimentation. Pour empêcher vos nœuds AKS de devenir un point de défaillance unique, utilisez les zones de disponibilité Azure. Par l’utilisation de zones de disponibilité, vous garantissez que les nœuds AKS d’une zone de disponibilité donnée sont physiquement séparés de ceux définis dans une autre zone de disponibilité.
Pour plus d’informations, consultez AKS et zones de disponibilité Azure.
Défaillances d'une région Azure
Quand une région entière cesse d’être disponible, les pods du cluster ne sont plus disponibles pour traiter les requêtes. Dans ce cas, Azure Front Door route l’ensemble du trafic vers les régions saines restantes. Les clusters et pods Kubernetes des régions saines continuent à traiter les requêtes.
Dans cette situation, veillez à compenser l’augmentation des requêtes et du trafic vers le cluster restant. Considérations importantes :
- Vérifiez que les ressources réseau et de calcul sont dimensionnées de manière optimale pour absorber toute augmentation soudaine du trafic due au basculement d'une région. Par exemple, lorsque vous utilisez Azure CNI, assurez-vous que vous disposez d’un sous-réseau suffisamment grand pour prendre en charge toutes les adresses IP pod pendant que le trafic est en cours de spiking.
- Utilisez l'autoscaler horizontal pour augmenter le nombre de réplicas de Pods afin de faire face à l'augmentation de la demande régionale.
- Utilisez l’Autoscaler de clusters AKS pour augmenter le nombre de nœuds d’instance Kubernetes afin de répondre à l’augmentation de la demande régionale.
Pour plus d’informations, consultez Horizontal Pod Autoscaler et l'autoscaler de cluster AKS.
Cette architecture utilise la propagation de charges de travail d’Azure Kubernetes Fleet Manager avec une stratégie de placement PickAll, qui maintient les mêmes définitions de charge de travail en cours d’exécution sur chaque cluster membre à tout moment. Cette stratégie fournit une redondance géographique pour vos charges de travail, car chaque cluster membre est une origine active capable de traiter les requêtes indépendamment. La flotte évalue les contraintes de placement au moment de la planification, et non en continu pendant l’exécution, de sorte qu’elle ne déplace pas les charges de travail hors d’un cluster défaillant. Lorsque la région défaillante se rétablit et que son cluster membre se reconnecte, l’agent du membre de la flotte ramène le cluster à l’état attendu défini sur le hub, sans nécessiter de redéploiement manuel. Si vous avez une architecture qui nécessite qu’un sous-ensemble de régions soit actif, envisagez d’utiliser la stratégie PickN avec des contraintes de répartition de topologie.
Topologie du réseau
À l’image de l’architecture de référence d’AKS, cette architecture utilise une topologie réseau hub-and-spoke. En plus des considérations spécifiées dans l’architecture de référence d’AKS, tenez compte des meilleures pratiques suivantes :
- Implémentez un ensemble de réseaux virtuels hub-spoke pour chaque instance AKS régionale. Dans chaque région, appairez chaque spoke au réseau virtuel hub.
- Routez tout le trafic sortant via une instance du Pare-feu Azure située dans chaque réseau hub régional. Utilisez des stratégies Azure Firewall Manager pour gérer les stratégies de pare-feu dans toutes les régions.
- Suivez le dimensionnement IP décrit dans l'architecture de référence d'AKS, et autorisez des adresses IP supplémentaires pour les opérations de mise à l’échelle de nœuds et de pods en cas de défaillance régionale dans une autre région et d'augmentation considérable du trafic vers les régions restantes.
Communication entre clusters
Cette architecture utilise Azure Front Door pour le trafic north-sud : acheminer les demandes de client externe vers des clusters régionaux. Si votre charge de travail nécessite également le trafic est-ouest - communication de service à service entre clusters régionaux - envisagez la mise en réseau inter-clusters de Fleet Manager (préversion). Cette fonctionnalité fournit un déploiement Cilium multicluster géré qui permet une communication directe de pod à pod entre les clusters et de publier des services accessibles à l’échelle mondiale à l’aide d’annotations Kubernetes. Ces deux mécanismes sont complémentaires : Azure Front Door gère l’entrée externe tandis que la mise en réseau entre clusters gère les dépendances internes entre clusters. Toutefois, si vos tampons sont entièrement autonomes sans dépendances de service inter-cluster, cette fonctionnalité n’est pas nécessaire.
Gestion du trafic
Avec l’architecture de référence d’AKS, le trafic de la charge de travail est routé directement vers une instance d’Azure Application Gateway, avant d’être transféré vers l’équilibreur de charge du backend et les ressources d’entrée AKS. Quand vous utilisez plusieurs clusters, les demandes des clients sont acheminées vers l’instance d’Azure Application Gateway par le biais d’une instance d’Azure Front Door.

Télécharger un fichier Visio de ce diagramme.
L’utilisateur envoie une requête à un nom de domaine (comme
https://contoso-web-a1bc2de3fh4ij5kl.z01.azurefd.net), qui est résolu avec le profil Azure Front Door. Cette requête est chiffrée à l’aide d’un certificat générique (*.azurefd.net) émis pour tous les sous-domaines d’Azure Front Door. Azure Front Door valide la requête par rapport aux stratégies Web Application Firewall, sélectionne l'origine la plus rapide (en fonction de l’intégrité et de la latence), et utilise le DNS public pour résoudre l’adresse IP d'origine (instance d’Azure Application Gateway).Azure Front Door transfère la requête à l’instance d’Application Gateway appropriée sélectionnée, qui sert de point d’entrée pour l’empreinte régionale. Le trafic circule sur Internet. Azure Front Door garantit le chiffrement du trafic vers l’origine.
Envisagez une méthode pour vous assurer que l’instance Application Gateway accepte uniquement le trafic de votre profil de Azure Front Door spécifique. Il existe une approche qui consiste à utiliser un groupe de sécurité réseau sur le sous-réseau qui contient Application Gateway. Les règles peuvent filtrer le trafic entrant (ou sortant) en fonction de propriétés telles que Source, Port et Destination. La propriété Source vous permet de définir une étiquette de service intégrée, qui indique les adresses IP d’une ressource Azure. Cette abstraction facilite la configuration et la maintenance de la règle ainsi que le suivi des adresses IP. En outre, envisagez d’utiliser l’en-tête
X-Azure-FDID, qu’Azure Front Door ajoute à la requête avant de l’envoyer à l’origine, pour vérifier que l'instance d'Application Gateway accepte uniquement le trafic provenant de l’instance Front Door. Pour plus d’informations sur les en-têtes Azure Front Door, consultez Prise en charge du protocole pour les en-têtes HTTP dans Azure Front Door.
Considérations relatives aux ressources partagées
Bien que le focus de ce scénario soit d’avoir plusieurs instances de Kubernetes réparties sur plusieurs régions Azure, il est logique de partager certaines ressources entre toutes les régions. Une des approches consiste à utiliser un seul fichier Bicep pour déployer toutes les ressources partagées, puis un autre pour déployer chaque « stamp » régional. Cette section décrit en détail chacune de ces ressources partagées ainsi que les considérations relatives à leur utilisation dans plusieurs instances d’AKS.
Registre de conteneurs
Azure Container Registry est utilisé dans cette architecture pour fournir des services d’images de conteneurs. Le cluster extrait des images de conteneur du registre. Tenez compte des éléments suivants lorsque vous travaillez avec Azure Container Registry dans un déploiement de cluster multirégion.
Disponibilité géographique
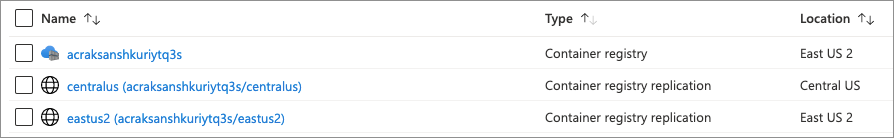
Positionnez un registre de conteneurs dans chaque région où un cluster AKS est déployé. Cette approche permet les opérations de réseau à faible latence, facilitant des transferts de calque d’image rapides et fiables. Si une réplique régionale devient défaillante, le basculement de Container Registry redirige automatiquement les extractions vers une réplique saine via son point de terminaison global (<registry>.azurecr.io), sans nécessiter de modifications de configuration côté AKS ou DNS. L’utilisation de la fonctionnalité de géoréplication d’Azure Container Registry vous permet de gérer un registre de conteneurs qui est automatiquement répliqué vers plusieurs régions.
Envisagez de créer un registre unique, avec des répliques dans chaque région Azure contenant des clusters. Pour plus d’informations sur la réplication d’Azure Container Registry, consultez la section Géoréplication dans Azure Container Registry.
Accès au cluster
Chaque cluster AKS nécessite un accès au registre de conteneurs pour pouvoir extraire des couches d’images conteneur. Il existe plusieurs façons d’établir l’accès à Azure Container Registry. Dans cette architecture, une identité managée est créée pour chaque cluster, à qui est ensuite accordé le rôle AcrPull sur le registre de conteneurs. Pour plus d’informations et de recommandations sur l’utilisation des identités managées afin d’accéder à Azure Container Registry, consultez l'architecture de référence d’AKS.
Cette configuration est définie dans le fichier Bicep d’empreinte de cluster pour qu’à chaque déploiement d’une nouvelle empreinte, un accès soit octroyé à la nouvelle instance d’AKS. Étant donné que le registre de conteneurs est une ressource partagée, assurez-vous que vos déploiements incluent l’ID de ressource du registre de conteneurs en tant que paramètre.
Azure Monitor
Lorsque vous concevez une solution de supervision pour une architecture multirégion, il est important de prendre en compte le couplage entre chaque tampon. Vous pourriez déployer un seul espace de travail Log Analytics, partagé par chaque cluster Kubernetes. Comme pour les autres ressources partagées, définissez votre empreinte régionale pour consommer les informations relatives au seul espace de travail Log Analytics partagé au niveau mondial, puis connectez chaque cluster régional à cet espace de travail partagé. Lorsque chaque cluster régional émet des journaux de diagnostic vers cet espace de travail Log Analytics unique, vous pouvez utiliser les données, ainsi que les métriques de ressources, pour générer des rapports et des tableaux de bord qui vous aident à comprendre comment votre solution multirégion entière s’exécute.
Azure Front Door - Service de passerelle réseau de Microsoft
Azure Front Door est utilisé pour équilibrer la charge et router le trafic vers chaque cluster AKS. Azure Front Door permet également le routage global de couche 7. Ces fonctionnalités sont requises pour ce scénario.
Configuration des clusters
À mesure que chaque instance d’AKS régionale est ajoutée, la passerelle Application Gateway déployée avec le cluster Kubernetes doit être inscrite en tant qu'origine dans Azure Front Door, ce qui la rend disponible au routage. Cette opération nécessite une mise à jour de votre infrastructure sous forme de ressources de code. Cette opération peut également être découplée de la configuration de déploiement, et managée en employant des outils tels qu’Azure CLI.
Certificats
Azure Front Door ne prend pas en charge les origines utilisant des certificats auto-signés, même dans des environnements de développement ou de test. Pour activer le trafic HTTPS, vous devez créer votre certificat TLS signé par une autorité de certification. Pour plus d’informations sur les autres autorités de certification que prend en charge Front Door, consultez l’article traitant des autorités de certification autorisées pour l’activation de connexions HTTPS personnalisées sur Azure Front Door.
Pour les tests, ou pour les clusters non destinés à la production, vous pourriez envisager d’utiliser Certbot pour créer un certificat Let’s Encrypt Authority X3 pour chacun des passerelles applicatives.
Durant la planification d’un cluster de production, utilisez la méthode privilégiée par votre organisation pour obtenir des certificats TLS.
Sécurité
La sécurité offre des garanties contre les attaques délibérées et l’abus de vos données et systèmes précieux. Pour plus d’informations, consultez liste de vérification pour la révision de conception concernant la sécurité.
Contrôle d’accès au cluster
Comme indiqué dans l’architecture de référence AKS, nous vous recommandons d’utiliser Microsoft Entra ID comme fournisseur d’identité pour vos clusters. Les groupes Microsoft Entra peuvent ensuite être utilisés pour contrôler l’accès aux ressources du cluster.
Quand vous gérez plusieurs clusters, vous devez choisir un schéma d’accès. Options disponibles :
- Créez un groupe d’accès global à l’échelle du cluster dont les membres peuvent accéder à tous les objets dans chaque instance de Kubernetes au sein du cluster. Cette option répond à des besoins d’administration minimaux. Toutefois, elle octroie des privilèges importants à n’importe quel membre du groupe.
- Créez pour chaque instance de Kubernetes un groupe d’accès individuel permettant d’octroyer l’accès aux objets d’une instance de cluster individuelle. Avec cette option, la surcharge d’administration augmente. Toutefois, elle fournit également un accès au cluster plus précis.
- Définissez des contrôles d’accès précis pour les types d’objet et les espaces de noms Kubernetes, puis mettez en corrélation les résultats avec une structure de groupe Microsoft Entra. Avec cette option, la surcharge d’administration augmente considérablement. Toutefois, elle fournit un accès précis à chaque cluster ainsi qu’aux espaces de noms et aux API Kubernetes présentes dans chaque cluster.
Pour l’accès administratif, envisagez de créer un groupe Microsoft Entra pour chaque région. Accordez à chaque groupe un accès complet à l'empreinte de cluster correspondante dans cette région. Les membres de chaque groupe ont ensuite un accès administratif aux clusters correspondants.
Pour plus d’informations sur la gestion de l’accès au cluster AKS avec Microsoft Entra ID, consultez Intégration Microsoft Entra AKS.
Sécurité de vos ressources de flotte
Lorsque vous utilisez une flotte pour centraliser les aspects de la gestion de votre cluster, il est important de protéger les ressources de la flotte pour éviter toute utilisation abusive. Les ressources de flotte utilisent le contrôle d’accès en fonction du rôle Azure (Azure RBAC) et vous pouvez accorder des autorisations de flotte à un ensemble restreint d’administrateurs. Suivez le principe du privilège minimum et accordez le moins d’accès possible à la ressource de flotte (le plan de contrôle de la flotte).
Si votre flotte utilise un cluster hub, tenez compte des recommandations supplémentaires suivantes :
- Évaluez les attributions de rôles que vous créez dans votre cluster hub (attributions de rôles de plan de données ). Ces attributions de rôles accordent l’accès aux ressources Kubernetes créées par la flotte. Attributions de rôles d’étendue à un espace de noms Kubernetes individuel si possible.
- Utilisez un cluster de hub privé pour restreindre la connectivité Internet. Toutefois, assurez-vous que votre architecture réseau permet aux clusters membres d’atteindre le cluster hub.
Données, état et cache
Lorsque vous utilisez un ensemble globalement distribué de clusters AKS, tenez compte de l’architecture de l’application, du processus ou d’autres charges de travail qui peuvent s’exécuter sur le cluster. Si les charges de travail basées sur l’état sont réparties entre les clusters, doivent-elles accéder à un entrepôt d'états ? Si un processus est recréé ailleurs dans le cluster à la suite d’une défaillance, la charge de travail ou le processus continue-t-il à avoir accès à un magasin d’états dépendant ou à une solution de mise en cache ? L’état peut être stocké de plusieurs façons. Toutefois, cela peut être difficile à gérer, même dans un seul cluster Kubernetes. La complexité augmente quand vous ajoutez plusieurs clusters de Kubernetes. En raison des problèmes de complexité et d’accès régionaux, envisagez de concevoir vos applications pour qu’elles utilisent un service de stockage d'état distribué à l’échelle mondiale.
La conception de cette architecture n’inclut pas de configuration pour les préoccupations liées à l’état. Si vous exécutez une même application logique sur plusieurs clusters AKS, concevez l’architecture de votre charge de travail de façon à utiliser un service de données distribué à l’échelle mondiale, par exemple Azure Cosmos DB. Azure Cosmos DB est un système de base de données mondialement distribué qui vous permet de lire et d’écrire des données à partir des réplicas locaux de votre base de données, le service Cosmos DB gérant la géoréplication pour vous. Pour plus d’informations, consultez Azure Cosmos DB.
Si votre charge de travail utilise une solution de mise en cache, veillez à concevoir vos services de mise en cache afin qu’ils restent fonctionnels même pendant les événements de basculement. Assurez-vous que la charge de travail elle-même est tolérante au basculement lié au cache et que les solutions de mise en cache sont déployées sur toutes les instances AKS régionales ou à proximité de celles-ci. Par exemple, utilisez Azure Redis managé avec la géoréplication active pour créer des réplicas dans chaque région que vous utilisez. Pour plus d’informations, consultez Configurer la géoréplication active pour les instances d’Azure Managed Redis.
Optimisation des coûts
L’optimisation des coûts consiste à examiner les moyens de réduire les dépenses inutiles et d’améliorer l’efficacité opérationnelle. Pour plus d’informations, consultez liste de vérification de la révision de conception pour l’optimisation des coûts.
Cette estimation de tarification Azure inclut uniquement les composants de cette architecture. Personnalisez-la pour qu’elle corresponde à votre utilisation. Le cluster fleet hub n'est pas inclus, car il s'agit d'un composant facultatif dont vous avez besoin uniquement pour des fonctionnalités spécifiques Azure Kubernetes Fleet Manager.
D’autres bonnes pratiques sont évoquées dans la section Optimisation des coûts de Microsoft Azure Well-Architected Framework, et l’article Optimiser les coûts décrit des options de configuration d’optimisation des coûts spécifiques.
Envisagez d’activer l’analyse des coûts AKS pour l’allocation granulaire des coûts de l’infrastructure de cluster par des constructions spécifiques à Kubernetes.
Excellence opérationnelle
L’excellence opérationnelle couvre les processus opérationnels qui déploient une application et la maintiennent en production. Pour plus d’informations, consultez la Liste de contrôle de l'examen de la conception pour l'excellence opérationnelle.
Lorsque vous utilisez un environnement multi-cluster avec une ressource de flotte, la surveillance devient plus difficile. De même, tenez compte de la façon dont vous coordonnerez les mises à jour des composants du cluster AKS.
Surveiller les clusters et charges de travail
L’examen manuel des tableaux de bord et des journaux d’activité peut devenir difficile à mesure que le nombre de clusters augmente. Vous pouvez donc envisager la façon dont vous agrégerez systématiquement les journaux et les métriques. Kubernetes Center dans le portail Azure fournit une interface unifiée entre les clusters AKS, Azure Kubernetes Fleet Manager et les espaces de noms gérés, ainsi que l’intégrité du cluster, les alertes de sécurité et les recommandations de mise à niveau en un seul endroit.
La surveillance Kubernetes dans Azure Monitor est l’outil recommandé pour surveiller et comprendre les performances et l’intégrité de vos charges de travail de cluster et de conteneur. Surveillance deKubernetes dans Azure Monitor utilise à la fois un espace de travail Log Analytics pour stocker les données de journal et Azure Monitor Metrics pour stocker des données de série chronologique numériques. Les métriques Prometheus peuvent également être collectées par Azure Monitor et les données peuvent être envoyées à Azure Monitor service managé pour Prometheus ou Azure Monitor Logs. Pour plus d’informations, consultez l’architecture de référence d’AKS.
Vous pouvez également configurer votre cluster AKS pour collecter et analyser les journaux des ressources à partir des composants du plan de contrôle AKS et les transférer vers un espace de travail Log Analytics.
Pour en savoir plus sur la configuration des espaces de travail Azure Monitor dans un environnement multi-cluster, consultez Azure Monitor.
Surveiller les opérations de la flotte
Lorsque Fleet Manager orchestre une exécution de mise à jour, vous pouvez surveiller la progression de l’exécution au fur et à mesure qu’elle progresse entre les clusters. Les données sont stockées dans Azure Resource Graph et peuvent être exportées vers Azure Monitor pour les alertes et le stockage.
Si vous choisissez d’utiliser Fleet Manager pour la propagation de la charge de travail, vous pouvez surveiller le déploiement à l’aide du portail Azure ou de kubectl.
Vous pouvez également collecter des journaux de ressources à partir de la ressource de flotte et les transférer vers un espace de travail Log Analytics.
Appliquer des mises à jour au sein de la flotte
Dans cette architecture de référence, Azure Kubernetes Fleet Manager applique les mises à jour des versions de Kubernetes et les mises à jour d’images de nœud dans votre flotte. Vous pouvez spécifier des stratégies de mise à niveau qui configurent la façon dont les mises à jour sont déployées sur vos clusters, et vous pouvez déclencher manuellement des mises à jour via des exécutions de mises à jour ou les automatiser avec des profils de mise à niveau automatique. Fleet Manager respecte les fenêtres de maintenance sur chaque cluster. Définissez donc les fenêtres de maintenance appropriées à la zone géographique et au fuseau horaire de chaque cluster.
En conservant la même version mineure Kubernetes dans votre flotte, vous pouvez simplifier la résolution des problèmes et valider votre charge de travail par rapport à une version unique avant de progresser. Considérez le canal de mise à niveau automatique TargetKubernetesVersion (préversion) pour épingler votre flotte à une version mineure spécifique lors de la réception des mises à jour correctives automatiques. Vous contrôlez quand la flotte avance. Ce canal s’intègre à AKS Long-Term Support (LTS) pour les charges de travail nécessitant un cycle de vie de support étendu.
Pour plus d’informations, consultez Mettre à jour Kubernetes et les images de nœud sur plusieurs clusters membres.
Cette architecture est mise à jour progressivement sur l’ensemble de la flotte. Un tampon régional à trafic inférieur dans la première phase de mise à jour sert de canari pour les empreintes de production restantes dans les étapes suivantes. Les portes d’approbation (préversion) entre les étapes fournissent un point de contrôle pour vérifier l’intégrité du cluster avant l’exécution. Les clusters qui ne parviennent pas à être mis à jour peuvent être ignorés afin que l’exécution continue pendant l’examen de l’échec indépendamment.
Étapes suivantes
- Zones de disponibilité AKS
- Gestionnaire de flotte Azure Kubernetes
- Géoréplication dans Azure Container Registry
- Régions Azure jumelées
Ressources associées
- Révision d’Azure Well-Architected Framework pour Azure Kubernetes Service (AKS)
- Architecture de référence pour un cluster Azure Kubernetes Service (AKS)
- Pipeline CI/CD pour les charges de travail basées sur des conteneurs
- Intégration AKS Microsoft Entra
- Documentation de Azure Front Door
- Documentation de Azure Cosmos DB