Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A következőkre vonatkozik:✅ SQL Analytics-végpont és Warehouse a Microsoft Fabricben
Note
Ez a cikk a Microsoft Fabric Data Warehouse-cikkek dimenziómodellezésének részét képezi. Ez a sorozat a Microsoft Fabric Warehouse-beli dimenziómodellezéssel kapcsolatos útmutatásra és tervezési ajánlott eljárásokra összpontosít.
Ez a cikk útmutatást és ajánlott eljárásokat tartalmaz dimenzió- és ténytáblák dimenziómodellbe való betöltéséhez. Gyakorlati útmutatást nyújt a Microsoft Fabric Warehouse-hoz, amely számos T-SQL-képességet támogat, például táblákat hozhat létre és adatokat kezelhet a táblákban. Így teljes mértékben szabályozhatja a dimenziómodell-táblák létrehozását és adatokkal való betöltését.
Note
Ebben a cikkben az adattárház kifejezés egy vállalati adattárházra utal, amely a kritikus fontosságú adatok átfogó integrációját biztosítja a szervezetben. Ezzel szemben az önálló kifejezésraktár egy Fabric Warehouse-ra utal, amely egy szolgáltatott szoftver (SaaS) relációs adatbázis, amelyet az adattárház implementálásához használhat. Az egyértelműség kedvéért ebben a cikkben az utóbbit Fabric Warehouse-ként említik.
Tip
Ha tapasztalatlan a dimenziómodellezésben, első lépésként tekintse meg ezt a cikksorozatot. Nem célja a dimenziómodellezés tervezésének teljes körű megvitatása. További információkért tekintse meg közvetlenül a széles körben elfogadott közzétett tartalmakat, például Ralph Kimball és mások által kiadott The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling (3. kiadás, 2013).
Dimenziómodell betöltése
A dimenziómodell betöltése magában foglalja a kinyerési, átalakítási és betöltési (ETL) folyamat rendszeres futtatását. Az ETL-folyamatok más folyamatok futtatását vezénylik, amelyek általában a forrásadatok átmeneti tárolásával, a dimenzióadatok szinkronizálásával, a sorok ténytáblákba való beszúrásával, valamint a naplózási adatok és hibák rögzítésével foglalkoznak.
Fabric Warehouse-megoldás esetén a Data Factoryt a Microsoft Fabricben használhatja az ETL-folyamat fejlesztéséhez és futtatásához. A folyamat képes a forrásadatok méretezési modelltáblákba való fel- és átalakítására és betöltésére.
Konkrétan a következőt teheti:
- Pipeline-ok segítségével munkafolyamatokat hozhat létre az ETL-folyamat irányításához. A folyamatok SQL-szkripteket, tárolt eljárásokat és egyebeket is végrehajthatnak.
- Adatfolyamok használatával alacsony kódszámú logikát fejleszthet több száz adatforrásból származó adatok betöltéséhez. Az adatfolyamok támogatják a több forrásból származó adatok kombinálását, az adatok átalakítását, majd egy célhelyre, például egy dimenziómodell-táblázatba való betöltését. Az adatfolyamok a már ismert Power Query-felülettel készülnek, amely számos Microsoft-termékben elérhető, például a Microsoft Excelben és a Power BI Desktopban.
Note
Az ETL-fejlesztés összetett lehet, és a fejlesztés kihívást jelenthet. A becslések szerint az adattárház-fejlesztési munka 60-80 százaléka az ETL-folyamatnak van szentelve.
Orchestration
Az ETL-folyamat általános munkafolyamata a következő:
- Igény szerint betölti az előkészítési táblákat.
- Dimenziótáblák feldolgozása.
- Ténytáblák feldolgozása.
- Igény szerint utófeldolgozási feladatokat is végrehajthat, például aktiválhatja a függő hálótartalom frissítését (például szemantikai modellt).
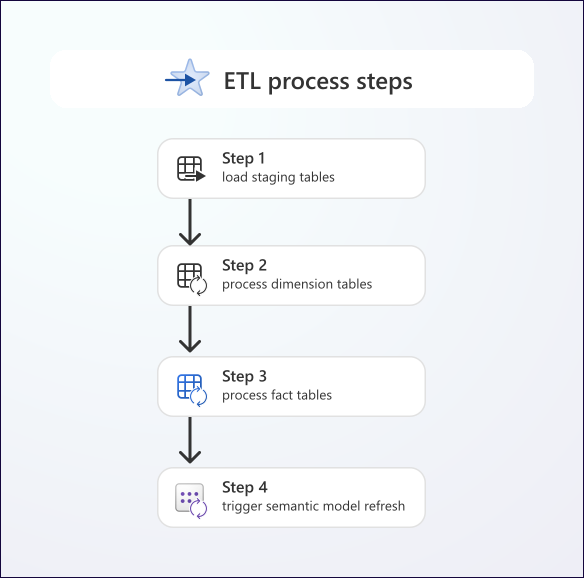
A dimenziótáblákat először fel kell dolgozni annak biztosítása érdekében, hogy az összes dimenziótagot tárolják, beleértve a forrásrendszerekhez a legutóbbi ETL-folyamat óta hozzáadottakat is. Ha függőségek vannak a dimenziók között, ahogyan a kimenő dimenziók esetében is, a dimenziótáblákat függőségi sorrendben kell feldolgozni. Egy ügyféldimenzió és egy szállító dimenzió által használt földrajzi dimenziót például a másik két dimenzió előtt kell feldolgozni.
A ténytáblák az összes dimenziótábla feldolgozása után feldolgozhatók.
Az összes dimenziós modelltábla feldolgozásakor aktiválhatja a függő szemantikai modellek frissítését. Az is jó ötlet, ha értesítést küld az érintett személyzetnek, hogy tájékoztassa őket az ETL-folyamat eredményéről.
Adatok szakaszba való előkészítése
Az átmeneti forrásadatok segíthetnek az adatok betöltésének és átalakításának követelményeinek támogatásában. Ez magában foglalja a forrásrendszer-adatok kinyerését és az előkészítési táblákba való betöltését, amelyeket az ETL-folyamat támogatásához hoz létre. Javasoljuk, hogy a forrásadatokat szakaszos állapotba helyezze, mert ezek a következőket tehetik:
- Minimalizálja az operatív rendszerekre gyakorolt hatást.
- Az ETL-feldolgozás segítésére és optimalizálására használható.
- Lehetővé teszi az ETL-folyamat újraindítását anélkül, hogy újra kellene betöltenie az adatokat a forrásrendszerekből.
Az előkészítési táblák adatai soha nem tehetők elérhetővé az üzleti felhasználók számára. Ez csak az ETL-folyamat szempontjából releváns.
Note
Ha az adatok egy Fabric Lakehouse-ban vannak tárolva, előfordulhat, hogy nem szükséges az adatok az adattárházban való szakaszba helyezése. Ha éremarchitektúrát implementál, az adatokat a bronz, ezüst vagy arany rétegből is kinyerheti.
Javasoljuk, hogy hozzon létre egy sémát a raktárban, esetleg elnevezve staging. Az átmeneti tábláknak a lehető legszorosabban kell hasonlítania a forrástáblákra az oszlopnevek és az adattípusok szempontjából. Az ETL-folyamat elején el kell távolítani az egyes táblák tartalmát.
TRUNCATE TABLE erre a célra támogatott.
Az előkészítési stratégia részeként adatvirtualizálási alternatívákat is fontolóra vehet. A következőket használhatja:
- Tükrözés, amely egy alacsony költségű és alacsony késésű kulcsrakész megoldás, amely lehetővé teszi az adatok replikáját a OneLake-ben. További információ: Miért érdemes tükrözést használni a Hálóban?
- OneLake-billentyűparancsok, amelyek más tárolási helyekre mutatnak, amelyek tartalmazhatják a forrásadatokat. A billentyűparancsok táblázatként használhatók a T-SQL-lekérdezésekben.
- PolyBase az SQL Serverben, amely az SQL Server adatvirtualizálási funkciója. A PolyBase lehetővé teszi, hogy a T-SQL-lekérdezések külső forrásokból származó adatokat csatlakoztassanak az SQL Server egy példányában lévő relációs táblákhoz.
- Adatvirtualizálás felügyelt Azure SQL-példánnyal, amellyel T-SQL-lekérdezéseket hajthat végre az Adatokat az Azure Data Lake Storage (ADLS) Gen2 vagy Az Azure Blob Storage általános adatformátumaiban tároló fájlokon, és összekapcsolásokkal kombinálhatja őket helyileg tárolt relációs adatokkal.
Adatok átalakítása
Előfordulhat, hogy a forrásadatok szerkezete nem hasonlít a dimenziómodell-táblák célstruktúráira. Az ETL-folyamatnak tehát át kell alakítania a forrásadatokat, hogy igazodjon a dimenziómodell-táblák szerkezetéhez.
Emellett az adattárháznak megtisztított és megfelelő adatokat kell szolgáltatnia, így előfordulhat, hogy a forrásadatokat át kell alakítani a minőség és a konzisztencia biztosítása érdekében.
Note
A szemét be- és kipakolásának fogalma minden bizonnyal az adattárházakra vonatkozik, ezért kerülje a szemét (alacsony minőségű) adatok betöltését a dimenziómodell-táblákba.
Íme néhány átalakítás, amelyet az ETL-folyamat végre tud hajtani.
- Adatok egyesítése: A különböző forrásokból származó adatok egyező kulcsok alapján integrálhatók (egyesíthetők). A termékadatok például különböző rendszerekben (például a gyártásban és a marketingben) vannak tárolva, mégis közös készletmegőrzési egységet (termékváltozatot) használnak. Az adatok akkor is hozzáfűzhetők, ha közös struktúrát használnak. Az értékesítési adatokat például több rendszerben tárolja a rendszer. Az egyes rendszerekből származó értékesítések egysége az összes értékesítési adat szuperhalmazát hozhatja létre.
- Adattípusok konvertálása: Az adattípusok átalakíthatók a dimenziómodell-táblákban meghatározottakká.
- Számítások: Számítások végezhetők a dimenziómodell-táblák értékeinek előállításához. Egy alkalmazotti dimenziótábla esetében például összefűzheti az utó- és vezetékneveket a teljes név létrehozásához. Egy másik példaként az értékesítési ténytáblában kiszámíthatja a bruttó értékesítési bevételt, amely az egységár és a mennyiség szorzata.
- Előzményváltozás észlelése és kezelése: A módosítás észlelhető és megfelelően tárolható a dimenziótáblákban. További információ: Korábbi változások kezelése a cikk későbbi részében.
- Adatok összesítése: Az aggregáció felhasználható a ténytáblázat dimenziójának csökkentésére és/vagy a tények részletességének növelésére. Az értékesítési ténytáblának például nem kell tárolnia az értékesítési rendelések számát. Ezért az összes dimenziókulcs alapján csoportosított összesített eredmény felhasználható a ténytábla adatainak tárolására.
Adatok betöltése
A hálóraktárban a következő adatbetöltési lehetőségek használatával tölthet be táblákat.
- COPY INTO (T-SQL): Ez a beállítás akkor hasznos, ha a forrásadatok parquet- vagy CSV-fájlokat tartalmaznak egy külső Azure-tárfiókban, például az ADLS Gen2-ben vagy az Azure Blob Storage-ban.
- Csővezetékek: Az ETL-folyamat vezénylése mellett a folyamatok olyan tevékenységeket is tartalmazhatnak, amelyek T-SQL-utasításokat futtatnak, kereséseket hajtanak végre, vagy adatokat másolnak egy adatforrásból egy célhelyre.
- Adatfolyamok: A folyamatok alternatívaként az adatfolyamok kód nélküli felületet biztosítanak az adatok átalakításához és tisztításához.
-
Raktárközi betöltés: Ha az adatok ugyanabban a munkaterületen vannak tárolva, a raktárközi betöltés lehetővé teszi a különböző raktár- vagy tóháztáblák összekapcsolását. Támogatja az olyan T-SQL-parancsokat, mint a
INSERT...SELECT,SELECT INTOésCREATE TABLE AS SELECT (CTAS). Ezek a parancsok különösen akkor hasznosak, ha adatokat szeretne átalakítani és betölteni az ugyanabban a munkaterületen lévő átmeneti táblákból. Ezek is set-alapú műveletek, amelyek valószínűleg a leghatékonyabb és leggyorsabb módja a dimenziós modelltáblák betöltésének.
Tip
Ezeknek az adatbetöltési lehetőségeknek az ajánlott eljárásokkal való teljes ismertetését lásd: Adatok betöltése a raktárba.
Logging
Az ETL-folyamatok általában dedikált monitorozást és karbantartást igényelnek. Ezért javasoljuk, hogy az ETL-folyamat eredményeit naplózza a nem dimenziós modelltáblákba a raktárban. Minden ETL-folyamathoz létre kell hoznia egy egyedi azonosítót, és minden művelet adatait naplóznia kell vele.
Fontolja meg a naplózást:
-
Az ETL-folyamat:
- Egyedi azonosító minden ETL-végrehajtáshoz
- Kezdési és befejezési idő
- Állapot (sikeres vagy sikertelen)
- Bármilyen hiba történt
-
Minden előkészítési és dimenziómodell-táblázat:
- Kezdési és befejezési idő
- Állapot (sikeres vagy sikertelen)
- Beszúrt, frissített és törölt sorok
- Utolsó táblasorok száma
- Bármilyen hiba történt
-
Egyéb műveletek:
- Szemantikai modell frissítési műveleteinek kezdési és befejezési időpontja
Tip
Létrehozhat egy szemantikai modellt, amely az ETL-folyamatok figyelésére és elemzésére van dedikáltan. A folyamat időtartama segíthet azonosítani azokat a szűk keresztmetszeteket, amelyek a felülvizsgálat és az optimalizálás előnyeit kihasználhatják. A sorok száma lehetővé teszi a növekményes terhelés méretének megértését minden alkalommal, amikor az ETL fut, és segít előrejelezni az adattárház jövőbeli méretét (és ha szükséges, a hálókapacitás felskálázását).
Dimenziótáblák feldolgozása
A dimenziótáblák feldolgozása magában foglalja az adattárház adatainak a forrásrendszerekkel való szinkronizálását. A forrásadatok először átalakítva és előkészítve lesznek a dimenziótáblába való betöltéshez. Ezek az adatok ezután az üzleti kulcsokhoz való csatlakozással egyeznek a meglévő dimenziótábla-adatokkal. Ezután meg lehet állapítani, hogy a forrásadatok új vagy módosított adatokat jelölnek-e. Ha a dimenziótábla lassan változó 1. dimenziótípust alkalmaz, a módosítások a meglévő dimenziótábla sorainak frissítésével történnek. Amikor a tábla az SCD 2. típusának változásait alkalmazza, a meglévő verzió lejárt, és egy új verzió lesz beszúrva.
Az alábbi ábra a dimenziótáblák feldolgozásához használt logikát mutatja be.
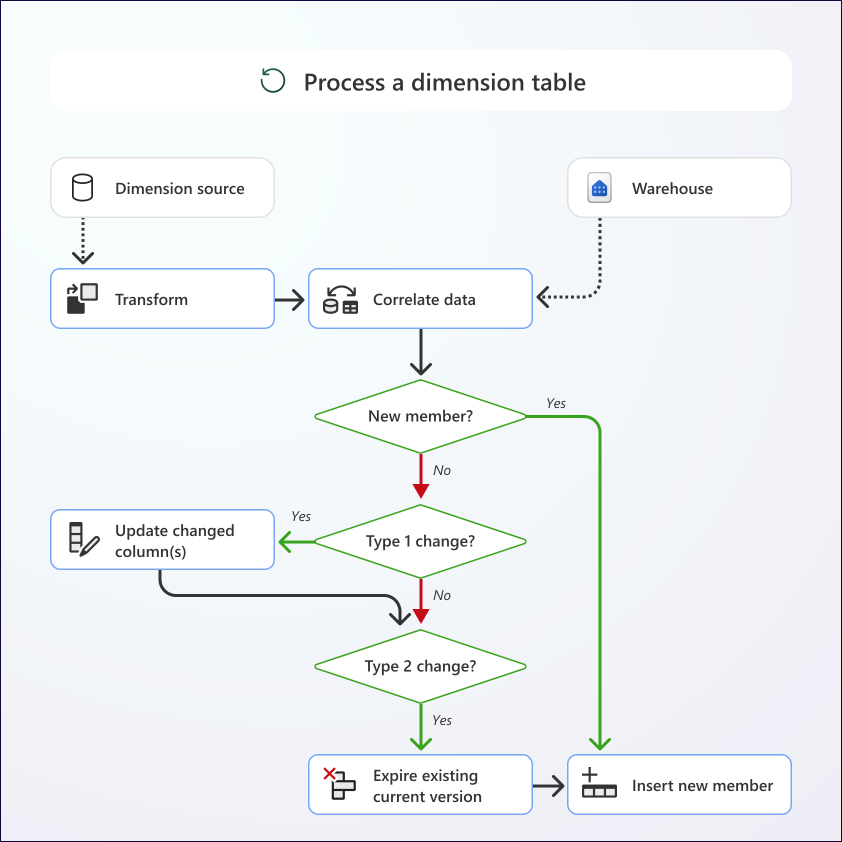
Fontolja meg a Product dimenziótábla folyamatát.
- Amikor új termékeket ad hozzá a forrásrendszerhez, a rendszer sorokat szúr be a
Productdimenziótáblába. - A termékek módosításakor a dimenziótábla meglévő sorai frissülnek vagy beszúródnak.
- Az 1. SCD-típus alkalmazásakor a rendszer frissíti a meglévő sorokat.
- Ha az SCD 2- es típust alkalmazza, a frissítések az aktuális sorverziók lejáratához , valamint az aktuális verziót jelképező új sorok beszúrásához lesznek beszúrva.
- A 3. SCD-típus alkalmazásakor az 1. SCD-típushoz hasonló folyamat történik, amely új sorok beszúrása nélkül frissíti a meglévő sorokat.
Helyettesítő kulcsok
Javasoljuk, hogy minden dimenziótábla rendelkezzen helyettesítő kulccsal, amely a lehető legkisebb egész adattípust használja. Az SQL Server-alapú környezetekben ezt tipikusan egy IDENTITY oszlop létrehozásával valósítják meg, míg a Fabric Data Warehouse-ban a IDENTITY oszlopok bizonyos korlátozásokkal állnak rendelkezésre. További információ: IDENTITY oszlopok és IDENTITY oszlopok használata helyettesítő kulcsok létrehozására a Fabric Data Warehouse-ban.
Important
Ha egy dimenziótábla automatikusan létrehozott helyettesítő kulcsokat tartalmaz, soha ne végezzen csonkolt és teljes újratöltést. Ez azért van, mert érvénytelenné tenné a dimenziót használó ténytáblákba betöltött adatokat. Ha a dimenziótábla támogatja a 2. típusú SCD-módosításokat , előfordulhat, hogy nem lehet újragenerálni az előzményverziókat.
Előzménymódosítás kezelése
Ha egy dimenziótáblának tárolnia kell az előzménymódosítást, lassan változó dimenziót (SCD) kell implementálnia.
Note
Ha a dimenziótábla sora egy kikövetkeztetett tag (amelyet egy ténybetöltési folyamat szúr be), a módosításokat scD-módosítás helyett késői érkezési dimenziórészletként kell kezelnie. Ebben az esetben a módosított attribútumokat frissíteni kell, és a tagjelölő kikövetkeztetett oszlopa a következőre FALSEvan állítva: .
Lehetséges, hogy egy dimenzió támogatja az SCD 1. és/vagy az SCD 2. típusú módosításait.
1. SCD-típus
Az 1. típusú SCD-módosítások észlelésekor használja az alábbi logikát.
- Frissítse a módosított attribútumokat.
- Ha a táblázat tartalmazza az utolsó módosítás dátumát , és oszlopokkal utoljára módosította , állítsa be a módosításokat megelőző aktuális dátumot és folyamatot.
SCD 2-es típus
A 2. típusú SCD-módosítások észlelésekor használja az alábbi logikát.
- Az aktuális verzió lejáratához állítsa a befejezési dátum érvényességi oszlopát az ETL feldolgozási dátumra (vagy a forrásrendszer megfelelő időbélyegére), és állítsa az aktuális jelzőt a következőre
FALSE. - Ha a táblázat tartalmazza az utolsó módosítás dátumát , és oszlopokkal utoljára módosította , állítsa be a módosításokat megelőző aktuális dátumot és folyamatot.
- Szúrja be azokat az új tagokat, amelyeknek a kezdő dátum érvényességi oszlopa a záró dátum érvényességi oszlopának értéke (a korábbi verzió frissítéséhez használatos), és az aktuális verziójelölő értéke
TRUEa következő. - Ha a táblázat tartalmazza a létrehozott dátumot és az oszlopok által létrehozott dátumot, állítsa be a beszúrásokat létrehozó aktuális dátumot és folyamatot.
SCD típus 3
Ha az SCD 3- típusú változásokat észlel, frissítse az attribútumokat az 1. SCD-típus feldolgozásához hasonló logikával.
Dimenziótag törlése
Ügyeljen arra, hogy a forrásadatok azt jelzik, hogy a dimenziótagok törölve lettek (vagy azért, mert nem kérték le őket a forrásrendszerből, vagy töröltként vannak megjelölve). Ne szinkronizálja a törléseket a dimenziótáblával, kivéve, ha a dimenziótagok hibásan lettek létrehozva, és nincsenek hozzájuk kapcsolódó tényrekordok.
A forrástörlések kezelésének megfelelő módja, ha helyreállítható törlésként rögzíti őket. A helyreállítható törlés egy dimenziótagot már nem aktívként vagy érvényesként jelöl meg. Az eset támogatásához a dimenziótáblának tartalmaznia kell egy logikai attribútumot a bit adattípusával, például IsDeleted. Frissítse ezt az oszlopot a törölt dimenziótagok esetében a következőre TRUE : (1). A dimenziótagok aktuális, legújabb verziója hasonló módon jelölhető meg logikai (bit) értékkel az IsCurrent oszlopokban.IsActive Minden jelentéskészítő lekérdezésnek és Power BI szemantikai modellnek szűrnie kell a helyreállítható törléseket tartalmazó rekordokat.
Dátumdimenzió
A naptár- és idődimenziók különleges esetek, mivel általában nem rendelkeznek forrásadatokkal. Ehelyett rögzített logikával jönnek létre.
A dátum dimenziótáblát minden új év elején be kell töltenie, hogy a sorokat egy adott évre kiterjesztse. Lehetnek más üzleti adatok is, például a pénzügyi év adatai, az ünnepnapok, a heti számok, amelyeket rendszeresen frissíteni kell.
Ha a dátum dimenziótáblája relatív eltolási attribútumokat tartalmaz, az ETL-folyamatot naponta kell futtatni az eltolás attribútumértékeinek frissítéséhez az aktuális dátum (ma) alapján.
Javasoljuk, hogy a dátum dimenziótáblájának kiterjesztésére vagy frissítésére vonatkozó logikát T-SQL-ben írja, és egy tárolt eljárásba ágyazza be.
Ténytáblák feldolgozása
A ténytáblák feldolgozásához szinkronizálni kell az adattárház adatait a forrásrendszer adataival. A forrásadatok először átalakítják és előkészítik a betöltést a ténytáblába. Ezután minden dimenziókulcs esetében egy keresés határozza meg a ténysorban tárolni kívánt helyettesítő kulcs értékét. Ha egy dimenzió támogatja a 2. típusú SCD-t, le kell kérni a dimenziótag aktuális verziójához tartozó helyettesítő kulcsot.
Note
A helyettesítő kulcs általában a dátum- és idődimenziók alapján számítható ki, mert a kulcsnak használnia YYYYMMDD vagy HHMM formáznia kell őket. További információ: Naptár és idő.
Ha egy dimenziókulcs-keresés sikertelen, az integritási problémát jelezhet a forrásrendszerrel kapcsolatban. Ebben az esetben a ténysort továbbra is be kell szúrni a ténytáblába. Az érvényes dimenziókulcsot továbbra is tárolni kell. Az egyik módszer egy speciális dimenziótag (például Ismeretlen) tárolása. Ehhez a megközelítéshez egy későbbi frissítés szükséges a valódi dimenziókulcs értékének megfelelő hozzárendeléséhez, ha ismert.
Important
Mivel a Fabric Warehouse nem kényszerít idegen kulcsokat, kritikus fontosságú, hogy az ETL-folyamat ellenőrizze az integritást, amikor adatokat tölt be ténytáblákba.
A természetes kulcs érvényességének megbízhatósága szempontjából fontos másik megközelítés egy új dimenziótag beszúrása, majd a helyettesítő kulcs értékének tárolása. További információkért lásd a szakasz későbbi szakaszában a késleltetett dimenziótagokat .
Az alábbi ábra a ténytáblák feldolgozásához használt logikát mutatja be.
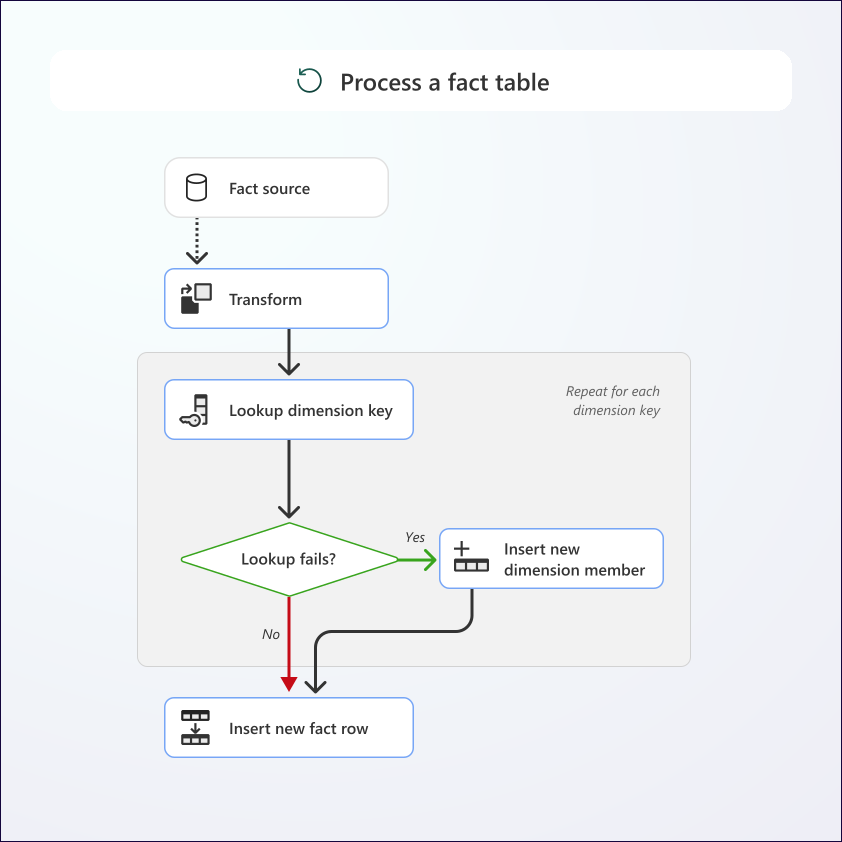
Amikor csak lehetséges, a ténytáblát növekményesen kell betölteni, ami azt jelenti, hogy a rendszer új tényeket észlel és beszúr. A növekményes terhelési stratégia méretezhetőbb, és a forrásrendszerek és a célrendszerek számítási feladatait is csökkenti.
Important
Különösen a nagy ténytáblák esetében, a ténytáblák csonkolási és újratöltési lehetőségének kell lennie. Ez a megközelítés költséges a folyamatidő, a számítási erőforrások és a forrásrendszerek esetleges zavarai szempontjából. Ez összetettséghez is hozzátartozik, ha a ténytábla méretei az SCD 2. típust alkalmazzák. Ennek az az oka, hogy a dimenziókulcs-kereséseket a dimenziótag-verziók érvényességi időszakán belül kell elvégezni.
Remélhetőleg a forrásrendszer-azonosítókra vagy időbélyegekre támaszkodva hatékonyan észlelheti az új tényeket. Ha például egy forrásrendszer megbízhatóan rögzíti a sorrendben lévő értékesítési rendeléseket, a lekért legújabb értékesítési rendelésszámot (más néven magas vízjelet) tárolhatja. A következő folyamat ezt az értékesítési rendelésszámot használhatja az újonnan létrehozott értékesítési rendelések lekéréséhez, és a következő folyamat által lekért legújabb értékesítési rendelésszámot is tárolhatja. Az is lehetséges, hogy egy létrehozási dátumoszlop segítségével megbízhatóan észlelhetők az új rendelések.
Ha nem tud a forrásrendszer adataira támaszkodni az új tények hatékony észleléséhez, előfordulhat, hogy a forrásrendszer képes növekményes terhelés végrehajtására. Az SQL Server és az Azure SQL Managed Instance például rendelkezik egy módosítási adatrögzítés (CDC) nevű szolgáltatással, amely nyomon követheti a táblák minden sorának változásait. Emellett az SQL Server, az Azure SQL Managed Instance és az Azure SQL Database rendelkezik egy változáskövetés nevű funkcióval, amely képes azonosítani a módosított sorokat. Ha engedélyezve van, segít hatékonyan észlelni az új vagy módosított adatokat bármely adatbázistáblában. Előfordulhat, hogy olyan eseményindítókat is hozzáadhat a relációs táblákhoz, amelyek a beszúrt, frissített vagy törölt táblarekordok kulcsait tárolják.
Végül előfordulhat, hogy attribútumok használatával összekapcsolhatja a forrásadatokat a ténytáblával. Például az értékesítési rendelés száma és az értékesítési rendeléssor száma. A nagy ténytáblák esetében azonban nagyon költséges művelet lehet az új, módosított vagy törölt tények észlelése. Az is problémás lehet, ha a forrásrendszer működési adatokat archivál.
Késleltetett dimenziótagok
Amikor egy ténybetöltési folyamat beszúr egy új dimenziótagot, az úgynevezett kikövetkeztetett tag. Ha például egy szálloda vendége bejelentkezik, a rendszer arra kéri őket, hogy csatlakozzanak a szállodalánchoz hűségtagként. A tagsági számot a rendszer azonnal kibocsátja, de előfordulhat, hogy a vendég adatai nem lesznek követve, amíg a vendég be nem küldi a papírmunkát (ha van ilyen).
A dimenziótagról csak a természetes kulcsa ismert. A ténybetöltési folyamatnak ismeretlen attribútumértékek használatával létre kell hoznia egy új dimenziótagot. Fontos, hogy a IsInferredMember a következőre kell állítaniaTRUE: . Így a késői érkezési adatok forrásaként a dimenzióbetöltési folyamat elvégezheti a szükséges frissítéseket a dimenziósoron. További információ: A korábbi változások kezelése ebben a cikkben.
Tényfrissítések vagy -törlések
Előfordulhat, hogy a tényadatok frissítésére vagy törlésére van szükség. Például egy értékesítési rendelés lemondásakor vagy a rendelés mennyiségének módosításakor. A ténytáblák betöltéséhez korábban ismertetett módon hatékonyan kell észlelnie a változásokat, és végre kell hajtania a tényadatok megfelelő módosításait. Ebben a példában a megszakított rendelés esetében az értékesítési rendelés állapota valószínűleg a Megnyitásról a Mégse értékre változik. A módosításhoz a tényadatok frissítése szükséges, nem pedig egy sor törlése . A mennyiségváltozáshoz szükség lenne a ténysor mennyiségi mértékének frissítésére. Ez a helyreállítható törlési stratégia megőrzi az előzményeket. A helyreállítható törlés már nem aktívként vagy érvényesként jelöl meg egy sort, és minden jelentéskészítő lekérdezésnek és Power BI szemantikai modellnek ki kell szűrnie a helyreállítható törléseket tartalmazó rekordokat.
A tényfrissítések vagy törlések előrejelezésekor attribútumokat (például értékesítési rendelésszámot és annak értékesítési rendeléssorszámát) kell tartalmaznia a ténytáblában a módosítandó ténysorok azonosításához. A hatékony módosítási műveletek támogatásához mindenképpen indexelje ezeket az oszlopokat.
Végül, ha a tényadatokat egy speciális dimenziótag (például Ismeretlen) használatával szúrták be, akkor rendszeres folyamatot kell futtatnia, amely lekéri az ilyen ténysorok aktuális forrásadatait, és frissíti a dimenziókulcsokat érvényes értékekre.
Kapcsolódó tartalom
További információ az adatok hálóraktárba való betöltéséről: