Agent BricksはAzure Databricksのエージェント開発者プラットフォームです。 それを使って、あなたのエージェント製品やワークフローを支えるエージェントを構築し展開しましょう。 Agent Bricksはコードを書く開発者向けに作られています。 どんなフレームワークやハーネスでも作られたエージェントを持ち込み、任意のモデルを選択できます。
Agent Bricksは本番エージェントを構築するためのコアワークフローをサポートしています:
-
エージェントをデプロイする: Agent Runtime は、あらゆるフレームワークやハーネスで構築されたステートフルまたはステートレスのエージェントをホストします。
DurableAgentServerAgentKitライブラリの一部であり、durable execution を追加することで、再起動やクラッシュが発生しても実行が維持されるようにします。 - コードを安全に実行する:エージェントは、セッション間でホームディレクトリが永続する隔離された環境である Databricks Sandboxでコードを実行します。
- エージェントに文脈を与える: マネージドエージェントメモリは、エージェントが以前の会話で学んだことを思い出せるようにし、応答をパーソナライズできるようにします。
- エージェントのデバッグとテスト: MLflowトレーシング はエージェントが行うすべてのステップを記録し、Unity Catalogでトレースを大規模に保存・管理できます。
Agent Bricks CLIは、これらのサービスに接続するエージェントコードをスキャフォールドします。 ローカルで反復(コードエージェントを含む)を行い、その後、エージェントのリソースを記録する宣言的agent.tomlファイルから大規模にデプロイできます。
Agent Bricksが他のAzure Databricks製品とどのように関係しているか:
- Genie Agents:Genie Agentsは、テーブルやドキュメント上で質問に答えるエージェントなど、コードなしでエージェントを作成するためのものです。 Agent Bricksは、自分でエージェントコードを書く開発者向けです。 カスタムエージェントはツールとしてジーニーエージェントを呼び出すことができます。
- Genie One: Genie Oneは、データに関する質問をしたり、ダッシュボードを閲覧したり、アプリを使用したりしたいビジネスユーザー向けで、コードを書くことなく利用できます。 Agent Bricksは、自分でエージェントを開発する開発者向けです。 カスタムエージェントは、あなたのビジネスの文脈を活用するためのツールとしてGenie Oneを呼び出せます。
- オムニジェント:オムニジェントは、コーディングエージェントなど複数のエージェントを構成・調整するメタハーネスです。 Omnigentを使ってカスタムエージェントを開発し、それをAgent Bricksでデプロイ・実行させることができます。
エージェントの構成要素
エージェントとは、リクエストを認識し、何をすべきかを決定し、目標を達成するために行動するAIシステムです。 単一のモデルコールとは異なり、エージェントはループを実行します。 モデルでリクエストについて推論し、情報収集や行動のためにツールを呼び出し、結果を観察し、応答できるまで繰り返します。
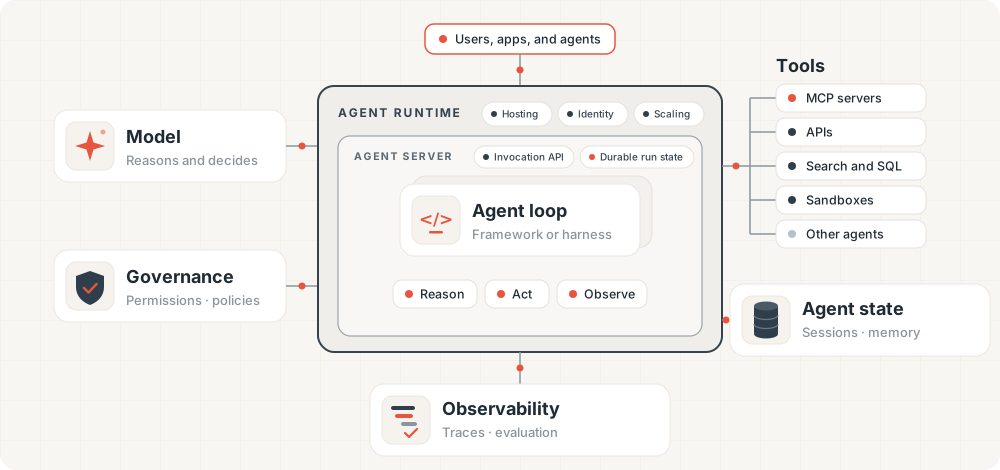
生産エージェントは通常、以下の構成要素を組み合わせます。
- フレームワークかハーネス:あなたのコード。 LangGraphやOpenAIエージェントSDKのようなフレームワークやハーネスで構築されたエージェントループに加え、エージェントの挙動を定義する命令やオーケストレーションロジック
- モデル:各ステップを推論し、次に取るべき行動を決定する大規模言語モデル(LLM)。
- ツール:エージェントがデータ(ビジネスデータを含む)を取得したり、他のシステムの状態を変更するために呼び出す関数です。 例としては、モデルコンテキストプロトコル(MCP)サーバー、API、エージェントが書くコードを実行するサンドボックスなどがあります。
- エージェントの状態:エージェントが管理しているもの。 エージェント状態には、現在のセッション(会話や進行中のタスク)と、エージェントがセッション間で学習し思い出すメモリが含まれます。
- エージェントサーバー:HTTPサーバーでエージェントループをラップするライブラリです。 クライアントが呼び出すAPIを公開し、クライアント接続を管理し、各実行の状態をランタイムストアに保持することで耐久性を確保します。
- エージェントランタイム:エージェントサーバーを動かし、ホスティング、アイデンティティ、スケーリングを管理するマネージドコンピュートです。
- 可観測性: エージェントが実行する各ステップを記録するトレースと、その出力が良好かどうかを測定する評価。
- ガバナンス:エージェントが使用できるモデル、ツール、データを制御するアイデンティティ、権限、ポリシー。
フレームワークまたはハーネス、エージェントサーバー、エージェントランタイムが一体としてエージェントのコンピュートスタックを形成します。 Azure Databricks でエージェントをデプロイするを参照してください。
本番環境でエージェントを構築する際の課題
プロトタイプエージェントは半日ほどでノートパソコンで動作できます。 実際のユーザー向けにエージェントを安定して運用するのは難しいです。 独自にエージェントを構築するチームは、エージェントを改善するよりもインフラの構築や運用に多くの時間を費やすことが多いです。 共通の課題は以下の5つの分野に分かれます。
- モデルアクセス:チームはフロンティアモデルとオープンモデルの中から選択し、コードを書き直さずにモデルを切り替えたりアップグレードしたりし、本番規模で十分な容量を確保しつつ、コストとアクセスをコントロールする必要があります。
- コンピューティング: エージェントは、トラフィックに応じてスケーリングし、再起動や障害を経ても長時間実行中の作業を維持し、各セッションを分離するコンピューティングを必要とします。 コードを書き実行するエージェントには、コードを実行するための安全な場所が必要です。
- 背景:エージェントは適切なタイミングで適切なデータを持っていると、より良い回答を出します。 それには、持続的な会話状態、セッション間で持続するメモリ、そしてデータのコピーや認証情報の共有なしにビジネスデータやツールへの安全なアクセスが必要です。
- 品質: エージェントはオープンエンドで非決定論的な出力を生み出すため、そのため、「良い」を定義し測定することは難しいです。 トレースと評価がなければ、チームは失敗をデバッグしたり、ステークホルダーに品質を証明したり、本番環境での回帰を見逃したりできません。
- ガバナンスと制御: エージェントはデータに基づいて行動し、外部サービスを呼び出します。 統一された権限、ポリシー、使用状況の追跡がなければ、組織はデータの漏洩、コンプライアンスのギャップ、不正使用、予期せぬコストのリスクを負います。 また、チームはエージェントを一つのモデルプロバイダーやクラウドに縛り付けることを避けたいと考えています。
エージェント・ブリックスがこれらの課題にどのように対処しているか
Agent Bricksは、スタックの各層に対して管理されたビルディングブロックを提供します。 コンポーネントは一つのアイデンティティとガバナンスモデルを共有し、連携して動作しますが、それぞれを個別に使うことも可能です。 フレームワーク、ハーネス、モデルの選択はそのまま保持できます。
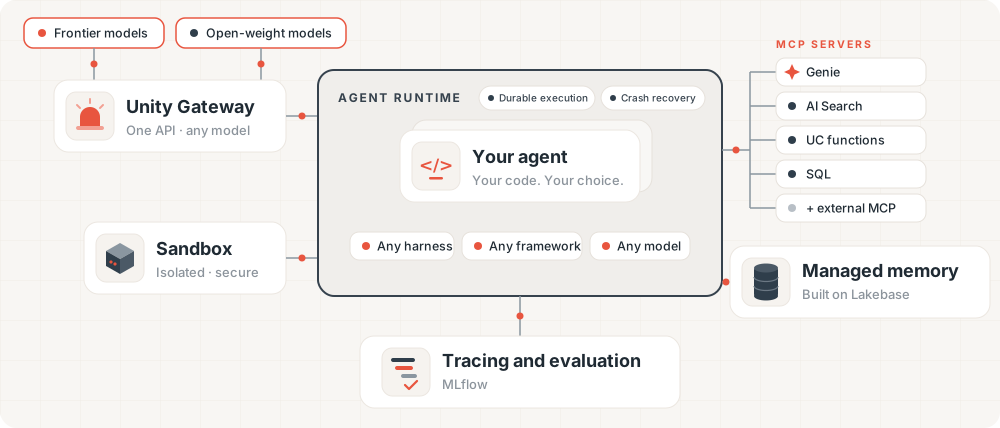
| 課題 | エージェントブリックスのコンポーネント |
|---|---|
| モデルアクセス | Unityゲートウェイ および Foundation Model API |
| Compute |
エージェントサーバー (DurableAgentServer)、 エージェントランタイム、Databricks サンドボックス |
| Context | マネージドエージェントのメモリ および マネージドエージェントセッション、 MCPサーバーとエージェントツール、 AIサーチ、 Genieエージェント |
| Quality | MLflowのトレーシング、評価、モニタリング |
| ガバナンスと制御 | Unity Catalog および Unity Gateway のポリシーに加え、あらゆるフレームワーク、ハーネス、モデルのサポート |
Agent Bricks CLIを使って始めましょう
Agent BricksのCLIは、空のディレクトリからデプロイ済みエージェントへのガイドパスを提供します。 フレームワークテンプレートからプロジェクトをスキャフォールドし、エージェントをローカルで実行し、モデルアクセス、メモリ、セッション、ツール、トレーシングが既に設定された状態で展開します。 宣言型 agent.toml ファイルは、エージェントが依存する管理リソースを記録します。 最初のエージェントを作るには、 Agent Bricksクイックスタートをご覧ください。
モデル
Unity Gatewayは、Azure DatabricksがFoundation Model APIsを通じてホストするモデルや外部プロバイダーのモデルを含む、フロンティアモデルおよびオープンモデル向けの単一のAPIをエージェントに提供します。 エージェントコードを変えずにモデルを切り替えられます。 Unity Gatewayはまた、エージェントが使用するMCPサーバーや スキル を管理し、通過するリクエストに対してレート制限、ガードレール、使用状況の追跡を適用します。
Compute
-
エージェントサーバー:
DurableAgentServerエージェントループをラップし、呼び出しAPIを提供し、同期、ストリーミング、バックグラウンド要求、永続的な実行状態、クラッシュリカバリを提供します。 Agent Bricks CLIで作成したエージェントはデフォルトでそれを使います。 -
エージェントランタイム: エージェントランタイム はDatabricks Apps上でエージェントサーバーを安定した、認証済みのエンドポイントで提供します。
agentbricks deployは、エージェントが必要とするリソースをプロビジョニングし、それらへのアクセス権を付与します。 デプロイされたエージェントをクエリするには、「Azure Databricksにデプロイされたエージェントのクエリ」をご覧ください。
- Databricks Sandbox: Databricks Sandbox は、エージェントが作成したコードを隔離された環境で実行するために呼び出すツールで、ガバナンスされたデータに対してスコープ付きアクセス権を持っています。
これらのレイヤーがどのように組み合わさっているかを知りたい方は、「Azure Databricksのエージェントをデプロイする」をご覧ください。
Context
- マネージドメモリとセッション:セッションは1つの会話やタスクの状態を保存し、メモリはエージェントが後の会話で思い出す事実や好みを保存します。 どちらもLakebaseが支援するマネージドストアで、どんなフレームワークでも対応できます。 エージェントのメモリとセッションを参照してください。
-
Genie Oneと組み合わせたビジネスコンテキスト: Genie One MCPサーバー は、エージェントに組織の統合ビジネスコンテキストを提供します。 エージェントが自然言語で質問をし、Genieはガバナントされたデータ全体で、Genie Ontologyを用いてビジネス用語、メトリック定義、テーブル間の関係を解釈してそれに答えます。 Unity Catalogの権限が適用されるため、エージェントはアクセス許可されたデータのみを照会できます。 Agent BricksのCLIプロジェクトに追加するには、
agentbricks tools add genie-oneを実行してください。 - ツールとMCPサーバー: エージェントを、Genieエージェント、AI Search、Unity Catalog関数、SQL 向けの Azure Databricks 管理 MCP サーバー、またはカスタムおよび外部の MCP サーバーに接続できます。 MCPsを参照してください。
- AI検索: Databricks AI Searchで、検索拡張生成(RAG)アプリケーション向けを含め、関連する非構造化コンテンツを取得できます。
- ビジネスデータ: エージェントを、組織が Unity Catalog ですでに管理しているテーブル、ファイル、Genieエージェントに基づかせます。
観測可能性と品質
Azure Databricks管理のMLflowは、エージェントに対してトレーシング、評価、監視を提供します。 MLflowトレーシング は、エージェントが開発および本番環境で行うすべてのステップを記録します。 評価は 組み込みのLLMジャッジ、カスタムスコアラー、専門家のフィードバックを用いて品質を測定し、本番監視はリグレッションを検出します。 トレースをUnity Catalogに保存し、大規模に分析することができます。 「エージェントの可観性と品質とは何か?」をご覧ください。
ガバナンスと制御
- 統一ガバナンス: Unity Catalogは、エージェントが使用するデータ、ツール、モデル、エージェントを権限とリネージで管理します。
- モデル、MCPサーバー、スキルに関するポリシー: Unity Gateway はモデル、MCPサーバー、スキルへのアクセスを管理し、ルーティングする呼び出しに対してガードレール、レート制限、使用状況の追跡を強制します。
- 選択肢:どんなフレームワークやハーネス、どんなモデルでも使い、エージェントを書き直さずにモデルを切り替える。
エージェント開発ライフサイクル
本番用エージェントの構築は反復的です。 以下のステップは典型的なライフサイクルを説明します。
- ユースケースと成功基準を定義する:エージェントが何をすべきか、誰が使うか、品質、コスト、レイテンシーの測定方法について合意しましょう。 早い段階で例のリクエストや期待される回答を集めましょう。
- 初期エージェントを作成する:最も単純な設計から始めましょう。 Unity Gatewayを通じてエージェントをモデル、MCPサーバー、スキルに接続し、ローカルで実行します。
- 品質を評価して反復する: トレースを使って挙動をデバッグし、実際のリクエストや専門家のフィードバックから評価データセットを構築し、プロンプト、ツール、モデルに対する各変更の影響を測定するために評価を実行します。
- デプロイ:エージェントサーバーをエージェントランタイムに展開し、必要なストア、ツール、権限を配置します。
- 生産環境でのモニタリングと改善:生産トレースやスコアラーで品質を監視し、ユーザーのフィードバックを収集し、学んだことを評価に反映させましょう。
Agent Bricks および Azure Databricks 上の他のエージェント オファリング
-
Genie One: ビジネスユーザー向けに、コードを記述することなく、自然言語でデータに関する質問をしたり、ダッシュボードを閲覧したり、アプリを使ったりできる Azure Databricks の体験です。 Agent Bricks を基に構築されたカスタムエージェントは、ツールとして Genie One を呼び出すことができます。 Agent BricksのCLIプロジェクトに追加するには、
agentbricks tools add genie-oneを実行してください。 - Genie Agents:テーブルやドキュメント上で質問に答えるエージェントをローコードで構築する方法です。 カスタムエージェントコードが不要なときはGenie Agentsを使いましょう。 カスタムエージェントはジーニーエージェントをツールとして呼ぶこともできます。
- オムニジェント: エージェントを組み合わせて連携させるためのメタハーネスで、例えばコーディングエージェントを組み合わせるなど。 Omnigentを使って、Agent Bricks上で動作するカスタムエージェントを開発できます。
- レガシーエージェントビルダー: Knowledge Assistant や Supervisor Agentなどの以前の製品は新規エージェントには推奨されていません。 「エージェントを構築する他の方法」をご覧ください。
その他のリソース
- Agent Bricksクイックスタート:Agent Bricks CLIを使って最初のエージェントをビルドし展開します。
- Azure Databricksでエージェントをデプロイする:エージェントのデプロイや提供方法を学びましょう。
- エージェントの可観測性と品質とは: エージェントを追跡、評価、監視しましょう。
- DatabricksにおけるAI:ユースケース、顧客、その他のリソース。
- エージェント・ブリックスFAQ:エージェント・ブリックスに関するよくある質問への回答。