Merk
Tilgang til denne siden krever autorisasjon. Du kan prøve å logge på eller endre kataloger.
Tilgang til denne siden krever autorisasjon. Du kan prøve å endre kataloger.
Etter hvert som organisasjoner akselererer sine digitale transformasjonsreiser, blir muligheten til å administrere data effektivt et strategisk forretningsimperativ. Med fremveksten av AI-drevne applikasjoner og Copilot-drevne arbeidsflyter, genererer og forbruker bedrifter data i enestående hastigheter. Disse dataene gir næring til innovasjon, gir tilpassede opplevelser og støtter kritisk beslutningstaking – men bare hvis de styres og lagres på en intelligent måte.
For å støtte disse utviklende forretningsbehovene må organisasjoner ta i bruk en proaktiv strategi for lagringsadministrasjon. Dette sikrer at data som ikke lenger er nødvendige for den daglige driften, håndteres på en ansvarlig måte, noe som frigjør kapasitet for arbeidsbelastninger av høy verdi, reduserer driftsfriksjon og tilpasser seg samsvars- og revisjonskrav.
Fra et teknisk synspunkt forbedrer effektiv lagringsadministrasjon i Dataverse Dynamics 365 systemytelsen, forbedrer kostnadseffektiviteten og sikrer overholdelse av policyer for langsiktig oppbevaring (LTR). Begge plattformene tilbyr verktøy og automatiseringsfunksjoner som gir organisasjoner mulighet til å administrere lagring.
Ved å implementere strategiene som er beskrevet i denne artikkelen, kan bedrifter redusere støttekostnader, effektivisere samsvar og frigjøre større verdi fra forretningsapplikasjonene sine – gjøre lagring fra en begrensning til et konkurransefortrinn.
Hovedfordeler
Effektiv lagringsadministrasjon i Dataverse Dynamics 365 gir flere viktige fordeler som adresserer vanlige kundeproblemer og forbedrer den generelle driftseffektiviteten.
Økt samsvar med LTR: Effektiv lagringsadministrasjon sikrer at data lagres i samsvar med LTR-policyer. Dette hjelper ikke bare med å oppfylle regulatoriske krav, men sikrer også at kritiske data bevares og er tilgjengelige når det er nødvendig.
Forbedret ytelse: Ved å optimalisere lagringsadministrasjonen kan organisasjoner forbedre ytelsen til systemene sine betydelig. Effektiv lagringstildeling og -administrasjon reduserer ventetiden og forbedrer hastigheten på datainnhenting, noe som fører til jevnere og raskere drift.
Øke kostnadseffektiviteten: Effektiv lagringsadministrasjon gir organisasjoner mulighet til å fokusere på verdifulle data ved å effektivisere og rydde opp i lagringslandskapet. Ved å beholde bare det som er nødvendig, kan bedrifter optimalisere lagringsfotavtrykket, noe som fører til smartere ressursutnyttelse og kostnadseffektiv skalerbarhet.
Bakgrunn
Etter hvert som organisasjoner vokser og digitaliserer mer av driften, øker volumet av forretningsdata som er lagret i systemer som Dataverse Dynamics 365 jevnt og trutt. Dette inkluderer ikke bare aktive, transaksjonsdata, men også historiske poster som må oppbevares for revisjons-, regulatoriske eller forretningskontinuitetsformål. Over tid kan denne akkumuleringen føre til ytelsesforringelse, økte driftskostnader og økende lagringskostnader – spesielt når data som ikke lenger brukes aktivt, forblir i lagringsnivåer med høy ytelse.
En veldefinert strategi for lagringsadministrasjon hjelper organisasjoner med å håndtere disse utfordringene ved å identifisere data som kan arkiveres, ryddes opp eller flyttes til rimeligere, leseoptimalisert lagring. Dette er viktig for samsvarsscenarier der data må forbli uforanderlige, med lav tilgang og skrivebeskyttet, for eksempel økonomiske poster, revisjonslogger eller forskriftsmessige registreringer. Å sikre at slike data oppbevares på en kompatibel måte, uten å påvirke ytelsen til live-systemer, er et sentralt krav for mange bedrifter.
Ved å bruke verktøyene og strategiene som er tilgjengelige på begge plattformene, kan organisasjoner få bedre innsyn i lagringsfotavtrykket, redusere unødvendig forbruk og sikre at samsvarskritiske data håndteres på riktig måte.
Denne artikkelen skisserer praktiske tilnærminger til lagringsadministrasjon som hjelper kunder med å tilpasse praksisen for dataoppbevaring til forretningsmessige og forskriftsmessige behov. Dette forbedrer systemytelsen, reduserer driftskostnadene og sikrer at samsvarsforpliktelsene oppfylles uten kompromisser.
Hvorfor vi lagrer data
For å velge og optimalisere riktig dataoppbevaringsmønster for dataene dine, er det verdifullt å reflektere over årsakene til og bruksområdene vi lagrer data for.
Operasjonelle data
Med en forretningsapplikasjon er operasjonelle data det som brukes til å spore salg eller økonomiske eller forsyningskjedehandlinger.
Disse dataene må nås i sanntid, og støtter kunde- og interne driftsprosesser som registrerer detaljerte handlinger, for eksempel samhandlinger med kunder, ordrer eller lageraktiviteter.
Over tid kan driftsdata gå fra å bli aktivt brukt til sjelden brukt. Dataene må kanskje være tilgjengelige i nær sanntid for å hjelpe en kunde med en ordre eller i en støttesak. Tenk deg for eksempel følgende scenarioer:
- En kunde legger inn en bestilling, mens en annen kunde, som ikke har samhandlet med virksomheten på en stund, legger inn en bestilling.
- Hver bestilling som er lagt inn og sendes, er konstant tilgjengelig. Det er også bestillinger som er under en garantiperiode på tre år som kanskje må refereres til for støtte og muligens kreve refusjon.
Dette kan føre til faser med operasjonelle datatilgangsbehov, for eksempel:
- Mindre enn ett år med aktivt brukte data.
- Mindre enn tre år med sjelden brukte data.
- Mer enn tre år der data ikke lenger er operativt tilgjengelig.
Sanntidsnaturen til operativ lagring gjør det relativt dyrt sammenlignet med annen lagring, så det er viktig å gjenkjenne når data må nås operativt og når de ikke gjør det for å definere oppbevaringsstrategier.
Operativ integrasjon
Som en spesialisert kategori for operativ bruk kan det være nødvendig å replikere data mellom flere operasjonelle systemer, inkludert mønstre som:
- Bank: Kunderelasjonsadministrasjon for kundeinteraksjoner i frontlinjen og replikering til flere banksystemer. Du har for eksempel brukskontoer, kredittkort, boliglån og kredittsjekksystemer.
- Produksjon: Kunderelasjonsstyring for frontlinjeordretaking og Enterprise Resource Management-system for forsyningskjedestyring.
- Politiets beredskapshåndtering: Kunderelasjonsstyring for innbyggerinteraksjoner og et utsendelsessystem for politiavdelinger tilbyr distribusjonsstyring.
I disse tilfellene, mens hvert system kan ha unike data det sporer, er det ofte vanlige stamdata som må deles mellom systemene og holdes synkronisert, noe som fører til integrasjonsbehov.
Spor endringer av data
En virksomhet har vanligvis regulatorisk ansvar for å oppbevare data i lengre perioder – for eksempel i syv år i gjennomsnitt – for revisjonsformål, enten interne eller eksterne, for eksempel støtte til finansiell revisjon, regulatorisk avsløring eller svindelgjennomgang.
Disse dataene vil vanligvis omfatte både data som trengs for driftsformål og data som ikke lenger er nødvendige, da de tillater gjennomgang på tvers av datasettet fra ett sted.
Analysedata
Organisasjoner har behov for å gjennomgå og analysere tilstanden til virksomheten sin. De må måle og sammenligne statistikk over tid, og spenner over flere eller alle deler av virksomheten.
De store periodene og bredden av data som denne analysen kan skje over, fører til behovet for å replikere operasjonelle data til spesialiserte analyseverktøy. Dette unngår at komplekse analyser påvirker ytelsen til driftssystemer, men tillater også analyse på tvers av datasett som går utover perioden der data er nødvendig operativt. Det kan for eksempel hende du må sammenligne data over sju år, i stedet for over ett til to år. Ulike analysebehov kan imidlertid trenge de fullstendige dataoppbevaringsperiodene eller bare spenne over dataene som er lagret i driftssystemer.
Analysedata gjør det vanligvis mulig å samle data på tvers av flere deler av virksomheten og kombinerer data fra flere systemer.
Flyt av data
Dataene av disse typene flyter vanligvis over tid fra driftsdata og deretter til transaksjonsdata eller historiske data, som vist i bildet nedenfor.
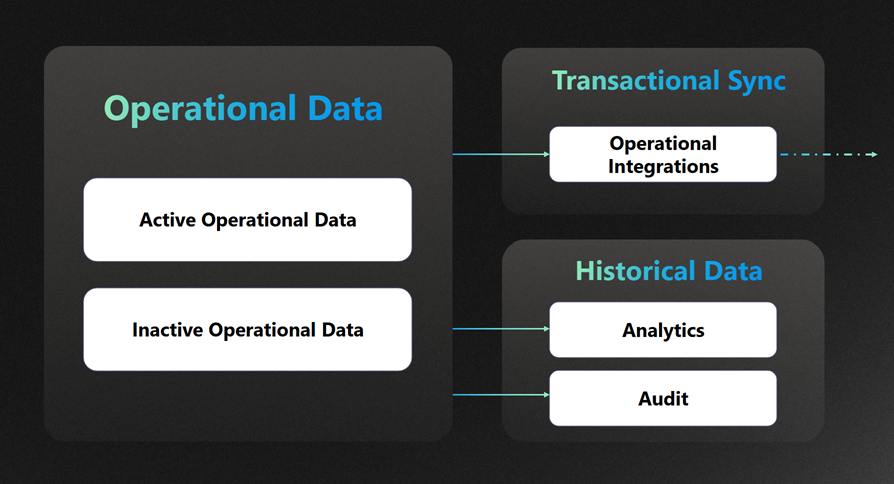
Ulike typer lagring
Dataverse lagringstyper
Dataverse Organiserer lagring i tre hovedkategorier, hver med distinkte bruksmønstre og faktureringsimplikasjoner.
| Lagringstype | Description | Vanlige brukstilfeller |
|---|---|---|
| Lagring av database | Lagrer strukturerte data i tabeller – standard og egendefinert. | Forretningsoppføringer, metadata, relasjoner og konfigurasjoner |
| Fillagring | Lagrer vedlegg og binære data. | E-postvedlegg, bilder, dokumenter lastet opp gjennom Power Apps |
| Lagring av logg | Lagrer revisjonslogger og sporingslogger for plugin-moduler. | Endringssporing, revisjon, diagnostikk og samsvar |
Lagringstyper for økonomi- og driftsplattform
Økonomi- og driftslagring administreres separat, men blir i økende grad integrert i økosystemet Power Platform . Den inkluderer følgende lagringstyper.
| Lagringstype | Description | Vanlige brukstilfeller |
|---|---|---|
| Driftsdatabaselagring | Kjernetransaksjonsdata for økonomi, forsyningskjede, menneskelige ressurser og mer | Reskontroposter, lagerbeholdning, kundeordrer |
| Lagring av dokumenthåndtering | Binære store objekter (blober) lagret i Azure Blob Storage | Fakturaer, kvitteringer, skannede dokumenter |
| Telemetri og diagnoselogger | Systemlogger og telemetridata | Ytelsesovervåking, problemdiagnostikk. |
Delte og integrerte lagringsscenarioer
Lagring med dobbel skriving
- Tillater sanntidssynkronisering mellom Dataverse økonomi- og driftsapper.
- Krever nøye rolle- og kapasitetsstyring for å unngå duplisering eller overforbruk.
Langsiktig oppbevaring (LTR)
- Flytter historiske data til en administrert datasjø (MDL).
- Reduserer bruken av primær lagring samtidig som samsvars- og analysetilgang opprettholdes.
- Integreres med:
- Hurtigsøk (Dataverse-opprinnelig søk)
- OneLake (strukturbasert analyse)
- Synapse Link (egendefinert innsjøanalyse)
Hvordan dataene dine vokser over tid
Etter hvert som organisasjoner skalerer bruken av Dataverse og Dynamics 365 Finance and Operations-plattformen, blir datavekst både et tegn på suksess og en strategisk utfordring. Det som begynner som et slankt, transaksjonelt datasett, kan raskt utvikle seg til et komplekst dataområde med flere lag. Denne delen utforsker fem viktige drivere for datavekst og deres implikasjoner for lagring, ytelse og styring.
Bruke datalagring på driftsdata
For å låse opp innsikt fra driftssystemer bruker Azure Synapse mange organisasjoner Link, OneLake eller dataeksport til å replikere data fra Dataverse og økonomi- og driftsapper til et analysesystem. Selv om dette støtter avansert rapportering og AI-arbeidsbelastninger, introduserer det også:
Redundant lagring på tvers av drifts- og analyselag
Data dupliseres ofte mellom drifts- og analysemiljøer. Denne redundansen øker det totale lagringsforbruket og kan føre til høyere kostnader, spesielt hvis historiske data beholdes på ubestemt tid i begge systemene.
Duplisering av skjemaer og versjonskontroll
For å opprettholde konsistens mellom systemer må organisasjoner replikere skjemaendringer – for eksempel nye felt og kolonner med nytt navn – på tvers av både drifts- og analyselag. Dette øker kompleksiteten i datastyringen og øker risikoen for skjemaavvik, som kan bryte nedstrøms rapporter eller modeller.
Økt oppbevaring av historiske data for trendanalyse
Analytiske systemer beholder vanligvis data i lengre perioder for å støtte trendanalyse, prognoser og regulatorisk rapportering. Selv om det er verdifullt, kan denne langsiktige oppbevaringen føre til oppblåste datasett hvis de ikke håndteres med riktige arkiverings- og lagdelingsstrategier.
Datalagring er avgjørende for analyse, men uten livssykluspolicyer kan det doble eller tredoble lagringsfotavtrykket ditt.
Bruke søk på dataene
Funksjoner som Dataverse søk, Copilot-indeksering og relevanssøk krever indeksering av store mengder strukturerte og ustrukturerte data. Disse indeksene gjør ofte:
Bruk logg- og databaselagring
Søkeindekser lagres i både logg- og databaselagring. Etter hvert som flere tabeller og felt merkes som søkbare, vokser indeksstørrelsen proporsjonalt. Dette kan ha betydelig innvirkning på den totale lagringsbruken, spesielt i miljøer med store mengder poster eller hyppige skjemaendringer.
Bevar også for ubrukte eller utdaterte tabeller
Selv når visse tabeller er avskrevet eller ikke lenger brukes aktivt, kan de tilknyttede søkeindeksene beholdes med mindre de eksplisitt fjernes. Dette fører til unødvendig lagringsforbruk og kan komplisere kapasitetsplanleggingen.
Dupliseres ofte på tvers av miljøer, for eksempel utviklings-, test- og produksjonsmiljøer
Søkeindekser replikeres vanligvis på tvers av utviklings-, test- og produksjonsmiljøer. Selv om dette sikrer konsekvent søkevirkemåte, multipliserer det også lagringsfotavtrykket, spesielt når miljøer klones eller oppdateres ofte.
Søk forbedrer brukervennligheten og AI-beredskapen, men indeksoppblåsthet er en stille bidragsyter til lagringsoverskudd.
Aktiver logging på dataene
Revisjonslogger, plugin-sporingslogger og telemetri er avgjørende for samsvar, feilsøking og overvåking. Vær imidlertid oppmerksom på følgende punkter:
Logglagring vokser lineært med bruk og antall brukere.
Loggdata vokser proporsjonalt med:
- Antall brukere og deres aktivitetsnivå
- Volumet av transaksjoner og integrasjoner
- Kompleksiteten i forretningslogikk, for eksempel plugin-moduler og arbeidsflyter
I miljøer med høy bruk kan dette føre til rask utvidelse av loggtabeller, noe som forbruker både database- og logglagringskvoter.
Oppbevaringsmislighold er ofte for sjenerøse, for eksempel 90 dager eller mer.
Som standard beholder mange loggingsfunksjoner data i lengre perioder, for eksempel 90 dager eller mer. Selv om dette støtter langsiktig sporbarhet, kan det føre til unødvendig lagringsforbruk, spesielt når logger ikke gjennomgås eller eksporteres aktivt.
Systemgenererte logger faktureres til kunden i Dataverse.
I Dataverse telles systemgenererte logger, inkludert revisjonslogger og sporingslogger for plugin-moduler, mot kundens lagringsrettigheter. Dette betyr at uten skikkelige oppryddings- eller eksportstrategier kan logging direkte bidra til lagringsoverskudd og økte lisenskostnader.
Logging er ikke omsettelig for regulerte bransjer, men må pares med oppbevarings- og eksportstrategier, for eksempel Azure Monitor eller Log Analytics.
Ha flere kopier av produksjonsmiljøet
For å støtte utvikling, testing, opplæring og feilsøking oppretter kunder ofte sandkassemiljøer eller klonede miljøer. Hvert eksemplar:
- Replikerer hele data- og indeksfotavtrykket.
- Kan inkludere ikke-åpenbare avhengigheter som søkeindekser, revisjonslogger og metadata.
- Blir sjelden ryddet opp etter bruk.
Miljøspredning er en viktig driver for lagringskostnader og kompleksitet. Styringspolitikk og automatisering er nøkkelen til begrensning.
Optimalisering av spørringer på dataene
Etter hvert som datavolumene vokser og programresponsen blir kritisk, implementerer kunder og uavhengige programvareleverandører ofte ulike spørringsoptimaliseringsteknikker for å forbedre ytelsen i Dataverse og Dynamics 365. Disse strategiene er spesielt vanlige i rapporterings-, analyse- og integrasjonstunge scenarioer.
For å forbedre ytelsen oppretter kunder og uavhengige programvareleverandører ofte:
Egendefinerte indekser og materialiserte visninger
Disse brukes til å akselerere spørringskjøring ved forhåndsberegning av sammenføyninger eller aggregasjoner. De er nyttige i scenarioer som involverer komplekse filtre eller store datasett.
Denormaliserte tabeller for rapportering
For å forenkle rapporteringen og redusere spørringskompleksiteten oppretter utviklere ofte sammenslåtte versjoner av relasjonsdata. Disse tabellene reduserer behovet for kjøretidskoblinger og forbedrer instrumentbordytelsen.
Hurtigbufferlag eller aggregater
Data som brukes ofte, blir noen ganger forhåndsaggregert eller bufret i mellomliggende tabeller eller eksterne lagre for å redusere belastningen på den primære databasen.
Selv om disse forbedrer responsen, gjør de også:
Øk lagringsbruken
Hvert optimaliseringslag introduserer flere datastrukturer, enten det er en kopi av eksisterende data i et denormalisert format, en forhåndsberegnet visning eller en hurtigbuffertabell. Disse strukturene dupliserer ofte data som allerede er lagret andre steder, noe som fører til et større totalt lagringsfotavtrykk. I miljøer med strenge lagringskvoter eller kostnadsbaserte lisensieringsmodeller, for eksempel Dataverse, kan dette raskt eskalere til unngåelige overforbruk.
Kan bli foreldreløse etter hvert som apper utvikler seg
Etter hvert som programmer utvikler seg, kan det hende at enkelte optimaliseringsartefakter ikke lenger refereres til av aktive rapporter, instrumentbord eller integrasjoner. Disse foreldreløse objektene fortsetter å bruke lagringsplass og kan til og med redusere systemoperasjoner, for eksempel under sikkerhetskopiering eller indeksering, hvis de ikke identifiseres og fjernes. Uten regelmessige revisjoner kan de akkumuleres ubemerket, og undergrave selve ytelsesgevinstene de ble opprettet for å støtte.
Spørringsoptimalisering er avgjørende for skalering, men må balanseres med lagringshygiene og telemetridrevet justering.
Indekser og deres innvirkning på lagring
Indekser er avgjørende for å forbedre spørringsytelsen og bruke rask datahenting i store datasett. I både Dataverse og Dynamics 365 Finance and Operations-apper opprettes indekser automatisk for primærnøkler og felt som ofte spørres, og andre egendefinerte indekser kan defineres for å støtte bestemte forretningsscenarioer.
Selv om indekser er avgjørende for ytelsen, har de også en direkte innvirkning på lagringsforbruket, som ofte undervurderes under løsningsutforming.
Hvordan indekser bruker lagringsplass
Fysisk duplisering av data: Hver indeks lagrer en kopi av de indekserte kolonnene, sammen med pekere til de tilsvarende radene. Jo flere kolonner og rader som indekseres, jo større blir indeksstørrelsen.
Vekst med datavolum: Etter hvert som den underliggende tabellen vokser, vokser også indeksen. I miljøer med høy transaksjon kan indekser vokse raskt, spesielt på store, denormaliserte tabeller eller de med hyppige innsettinger og oppdateringer.
Flere indekser per tabell: Det er vanlig at én enkelt tabell har flere indekser, for eksempel for søk, filtrering, sortering og sammenføyninger. Hver annen indeks legger til det kumulative lagringsfotavtrykket.
Søk etter indekser i Dataverse: Funksjoner som Dataverse søk og Copilot-indeksering oppretter spesialiserte indekser som strekker seg over flere felt og tabeller. Disse lagres i DataverseSearch-tabellen og kan bruke betydelig plass, spesielt når de brukes på tvers av flere miljøer, for eksempel utviklings-, test- og produksjonsmiljøer.
Systemgenererte indekser: Noen indekser opprettes automatisk av plattformen, for eksempel for oppslagsfelt eller relasjoner. Disse kan vedvare selv om de tilknyttede tabellene er avskrevet, med mindre de eksplisitt fjernes.
Konsekvenser for lagring
- Økt database- og logglagring: Indekser bidrar til både database- og logglagringsbruk, noe som kan påvirke lisensieringskostnadene i Dataverse.
- Duplisering av miljø: Når miljøer kopieres eller oppdateres, dupliseres alle indekser, noe som forsterker lagringsbruken på tvers av utviklings-, test- og produksjonsmiljøer.
- Vedlikeholdskostnader: Indekser må oppdateres etter hvert som data endres, noe som kan øke skriveventetiden og ressursforbruket.
Innvirkning på lagring av synkronisering på serversiden
Synkronisering på Dataverse serversiden tillater sømløs integrering av e-post, avtaler og oppgaver mellom Microsoft Exchange og Dataverse. Samtidig som det forbedrer produktiviteten og automatiseringen, bidrar det også til lagringsforbruket på følgende måter.
- Oppretting av aktivitetsoppføring: Hver synkroniserte e-post eller avtale genererer en aktivitetsoppføring i Dataverse, som inkluderer metadata, brødtekst og potensielt vedlegg.
- Vedleggslagring: Hvis vedlegg ikke filtreres eller avlastes, lagres de direkte i Dataverse, noe som øker lagringsbruken.
- Samsvar og oppbevaring: Organisasjoner som bruker synkronisering på serversiden for samsvarssporing, kan beholde mer data enn nødvendig, noe som øker lagringen ytterligere.
- Beskyttet innhold: Selv Purview-beskyttede e-postmeldinger, selv om de er begrenset i innholdssynlighet, genererer fortsatt plassholderoppføringer som bruker plass.
For å håndtere denne innvirkningen bør bedrifter implementere oppbevaringspolicyer, vurdere å laste ned vedlegg og overvåke aktivitetsregistreringsvolumer regelmessig.
Hvordan kan jeg administrere den stadig voksende lagringen?
Enten du allerede står overfor overskridelser av lagringskvoten eller ønsker å ligge i forkant av dem, krever håndtering av datavekst i Dataverse og Dynamics 365 Finance and Operations-plattformen en bevisst, regelstyrt tilnærming. Denne delen skisserer to strategiske inngangspunkter: reaktiv utbedring og proaktiv styring.
Det er to mulige scenarier:
- Du ønsker å bruke anbefalte fremgangsmåter proaktivt for å administrere lagring og unngå høye kostnader i fremtiden.
- Du er allerede i en situasjon der det er nødvendig å redusere lagringsstørrelse og kostnader.
Bruk anbefalte fremgangsmåter for å administrere lagringsstørrelse og -kostnader
Scenario 1: Du vil bruke anbefalte fremgangsmåter proaktivt for å administrere lagring
Hvis du ennå ikke er i krisemodus, er det nå på tide å bruke verktøy og teknikker for å administrere lagringen proaktivt.
Konfigurer analyseverktøy for dine data
Etter hvert som organisasjoner vokser, øker også behovet for å trekke ut innsikt fra driftsdata, uten å påvirke ytelsen til kjerneforretningsapplikasjoner. Microsoft tilbyr flere måter å tillate analyse av Dataverse og Dynamics 365 Finance and Operations-data på ved å integrere med din egen datasjø eller lager.
Her er to, kraftige alternativer å vurdere:
Alternativ 1. Bruk Azure Synapse Link – ta med egen innsjø
Azure Synapse Link lar deg koble Dataverse direkte til ditt eget Azure Data Lake- eller Synapse-arbeidsområde. Dette tillater replikering av driftsdata i nær sanntid til et analytisk miljø, uten å skrive komplekse ETL-pipeliner.
Fordeler:
- Kjør avanserte analyse- og AI-modeller på direkte eller nesten live data.
- Unngå ytelsespåvirkning på produksjonssystemene dine.
- Bruk kjente verktøy som T-SQL, Spark eller Power BI for rapportering.
Eksempel på brukstilfelle: Et detaljhandelsfirma bruker Synapse Link til å analysere kundekjøpsatferd på tvers av områder, og kombinerer Dataverse data om kunderelasjonsbehandling med eksterne markedsdata i sin egen innsjø.
Alternativ 2. Bruk OneLake – enhetlig analyse med Microsoft Fabric
OneLake, som er en del av Microsoft Fabric, gir en enhetlig datasjøopplevelse der du kan lagre og analysere data fra flere kilder, inkludert Dataverse økonomi- og driftsapper, uten duplisering.
Fordeler:
- Sentralisert lagring for alle analytiske arbeidsbelastninger.
- Opprinnelig integrasjon med Power BI Synapse- og AI-tjenester.
- Forenklet styring og sikkerhet på tvers av datadomener.
Eksempel på brukstilfelle: Et finanstjenestefirma bruker OneLake til å konsolidere driftsdata fra økonomi- og driftsapper og Dataverse med eksterne økonomiske indikatorer, noe som muliggjør sanntid, risikomodellering og lederdashbord. Ved å gjøre dette kan du koble driftsdata fra kjernesystemene og tillate skalerbar, kostnadseffektiv analyse ved å eksportere disse dataene til sine egne, analytiske miljøer, uten å duplisere arbeidsbelastninger eller påvirke ytelsen.
Verktøy og teknikker for å redusere lagringen
Dataverse Tilbyr flere innebygde verktøy og strategier for å hjelpe administratorer med å administrere lagring effektivt og opprettholde systemytelsen.
Dataverse
Behandle data med styringspolicyer
- Start med miljøene og tabellene som bruker mest lagringsplass.
- Bruk regelmessige styringspolicyer for forutsigbar datavekst i stedet for bare å stole på engangsopprydding.
- Test slettings- og oppbevaringskriterier i et sandkassemiljø før du bruker dem i produksjon.
- Se gjennom policyresultater og feil regelmessig.
- Legg til lagringskapasitet når nødvendige data ikke kan slettes eller flyttes til langsiktig oppbevaring.
Miljø- og dataopprydding
- Slett ubrukte miljøer: Du kan slette et miljø for å gjenopprette lagringsplass og fjerne personlig identifiserbar informasjon (PII).
-
Masseslettingsjobber: Du kan slette følgende data samtidig:
- Foreldede data eller data som er irrelevante for virksomheten.
- Unødvendige test- eller eksempeldata.
- Data som er feilaktig importert fra andre systemer.
Fil- og tabelloptimalisering
- Reduser fillagring ved hjelp av forhåndssøk: Denne artikkelen gir deg 15 metoder for å administrere lagringen din bedre. Bruk én eller flere av disse metodene til å styre den totale lagringsplassbruken. Du kan slette datakategorier når det trengs, eller du kan konfigurere masseslettingsjobber slik at de kjøres med angitte intervaller. Du kan for eksempel slette notater, vedlegg, importlogg og andre data.
- Rydd opp i oppføringer fra systemjobbtabeller (AsyncOperationBase) og prosessloggtabeller (WorkflowLogBase): Hvis organisasjonen bruker arbeidsflyter eller forretningsprosessflyter mye, vokser disse tabellene (AsyncOperationBase, WorkflowLogBase) over tid og blir til slutt store nok til å introdusere ytelsesproblemer og bruke for mye lagringsplass i organisasjonsdatabasen. For WorkflowLogBase kan du konfigurere automatisk sletting av fullførte bakgrunnsarbeidsflytjobber.
Langsiktig oppbevaring (LTR) og arkivering
- Dataarkivering: LTR: Dataverse støtter tilpassede oppbevaringspolicyer for sikker oppbevaring av ubegrensede data på lang sikt på en kostnadseffektiv måte. Selv om Dataverse det kan støtte forretningsvekst uten begrensning på aktive data, kan det være lurt å vurdere å flytte inaktive data til langtidsoppbevaringslageret Dataverse .
- Rydd opp i Dataverse tabeller: Hvis du vil beholde dataene, men fjerne dem fra relasjonslagringen, går du til Dataverse langsiktig dataoppbevaring. Ellers rydder du opp i følgende tabeller:
- ActivityPointerBase: Du kan følge fremgangsmåten her for å rydde opp i tabellen.
- AsyncOperationBase: Du kan følge trinnene her for å rydde opp i tabellen.
- msdyn_copilotinteraction: Du kan følge fremgangsmåten her for å rydde opp i tabellen.
- PrincipalObjectsAcces: Du kan følge trinnene her for å rydde opp i tabellen.
- Abonnementssporing: Du kan følge trinnene her for å rydde opp i tabellen.
Optimalisering av søkeindeks
- Reduser Dataverse søk: Du kan redusere lagringsstørrelsen ved å utføre alle trinnene i Dataverse kapasitetsbaserte lagringsdetaljer.
- Reduser størrelsen på DataverseSearch-tabellen: DataverseSearch-tabellen er den kumulative lagringen som brukes av søkeindeksen Dataverse . Den inkluderer dataene fra alle søkbare, hentingbare og filtrerbare felt i tabellene du har indeksert for miljøet. Du kan redusere tabellstørrelsen ved å fjerne søkekolonner, visningskolonner og filterbetingelser for én eller flere tabeller. Du kan deaktivere Dataverse-søk for å fjerne alle indekserte data.
Økonomi- og driftsapper
Økonomi- og driftsapper gir fleksible alternativer for administrasjon av lagring på tvers av produksjons- og sandkassemiljøer.
Miljøledelse
- Begrens antall fullstendige produksjonskopier: Du kan redusere det totale lagringsforbruket for økonomi- og driftsapper ved å fjerne fullstendige produksjonskopier i sandkassemiljøer. Hvis du for eksempel har fem kopier av produksjonsmiljøer i en sandkasse, er lagringsforbruket summen av produksjonen pluss fem kopier av produksjonsmiljøer i en sandkasse.
- Trimme data i sandkassemiljøer: Ved å trimme dataene i et sandkassemiljø kan du redusere det totale lagringsfotavtrykket. Du kan følge metodene nedenfor for å rense dataene i sandkassen.
- Gjenopprettingsprosessen gir en åpnings- og trimmingsutførelse
- Skriv T-SQL
- Skriv X++
- Utfør en transaksjonsfri kopi mellom miljøer: Miljøkopi for økonomi- og driftsapper har tradisjonelt involvert fullstendig databaseduplisering, inkludert konfigurasjon, hoveddata og transaksjoner, som, selv om det er nyttig for feilsøking, øker lagringsforbruket betydelig på tvers av både økonomi og drift og Dataverse.
Tilpasset opprydding og loggadministrasjon
- Skriv tilpassede oppryddingsrutiner etter behov: Du kan skrive tilpassede oppryddingsrutiner etter behov for bedriften din for å rense de uønskede dataene.
- Unngå å lagre logger: Du kan flytte SysDatabaseLog til en mindre transaksjonsdatabase for å redusere det totale lagringsfotavtrykket.
Arkivering og langtidsoppbevaring
-
Dataarkivering: LTR: Økonomi- og driftsapper gjør det mulig for organisasjoner å oppnå følgende fordeler gjennom arkivering:
- Sikre historiske, inaktive programdata på lang sikt for å oppfylle revisjons-, juridiske og forskriftsmessige krav.
- Reduser størrelsen på programdatabasen og kapasiteten som forbrukes, for potensielt å forbedre programytelsen som er knyttet til store tabeller.
- Konfigurere og administrere arkivdata
- Tilpasning av arkiv
- Konsolidering av lagertransaksjoner
Innebygde rydderutiner
- Oppryddingsrutiner: I Dynamics 365 Finance og Dynamics 365 Supply Chain Management oppryddingsrutiner er tilgjengelige i ulike moduler. Rydderutiner gir en oversikt over de rutinene som er tilgjengelige for øyeblikket. Når du har kopiert sandkassedatabasen, kjører du disse oppryddingsrutinene proaktivt for å fjerne unødvendige tabeller, for eksempel bunkehistorikk, logger og transaksjonshistorikk for detaljhandel. Slett utdaterte eller irrelevante data.
- Arkiver kredittkorttransaksjonsdata: Beskriver en arkiveringsjobb som Dynamics 365 Commerce kan bidra til å frigjøre plass i databasen ved å arkivere kredittkortbetalingstokener.
Reduser lagringsstørrelse og -kostnader
Scenario 2: Du er allerede i en situasjon der det er nødvendig å redusere lagringsstørrelse og -kostnader
Vurder hva som bruker lagringsplass
- Bruk administrasjonssenteret Power Platform og lagringsrapportene for økonomi og drift til å identifisere mest krevende tabeller, filtyper og logger.
- Bruk telemetri, hvis tilgjengelig, til å tilskrive bruk til bestemte apper, brukere eller forretningsenheter.
Prioriter oppryddingskandidater
- Fokus på:
- Oppsamlings- og integreringstabeller, for eksempel buffere for dobbel skriving
- Revisjonslogger: Oppbevar den i din egen lagring
- Ubrukte miljøer eller sandkasser
- Foreldreløse metadata og søkeindekser
- Slett det du ikke trenger, for eksempel massesletting
Bruk Synapse Link og OneLake for analytisk rapportering
- Eksporter de analytiske dataene til Synapse Link.
- Bruk OneLake til å få tilgang til de lagrede dataene og forretningsdataene for rapporterings- og analyseformål.
Bruk langtidsoppbevaring (LTR)
- Flytt historiske data til en administrert datasjø (MDL) ved hjelp av LTR-policyer.
- Oppretthold søke- og analysetilgang via Quick Find, Synapse Link eller OneLake.
Brukstilfeller
Brukstilfeller for lagringsadministrasjon i Dataverse økonomi- og driftsmiljøer er avgjørende for å optimalisere databaseplass, forbedre systemytelsen og oppfylle forskriftsmessige krav. Nedenfor er noen typiske scenarier som viser hvordan disse strategiene kan brukes:
Administrere vekst av historiske data
- Scenario: En bedrift har vært aktiv på Dynamics 365 i flere år og har akkumulert store mengder historiske transaksjoner og vedlegg.
- Handling: Implementer langsiktige oppbevaringsstrategier for å beholde inaktive data, redusere størrelsen på primærdatabasen og opprettholde samsvar med revisjonskrav.
Samsvarsdrevet dataoppbevaring
- Scenario: En regulert bransjekunde må beholde økonomiske data eller kundedata i syv til ti år i et manipulasjonssikkert format.
- Handling: Bruk LTR til å beholde uforanderlige, skrivebeskyttede data i samsvar med juridiske og forskriftsmessige krav, samtidig som forretningsdataene holdes slanke uten at det går på bekostning av analyse og rapportering.
Optimalisering av søke- og Copilot-indeks
- Scenario: Dataverse Søk og Copilot-indeksering er aktivert på tvers av alle miljøer, inkludert ubrukte tabeller.
- Handling: Overvåk søkbare felt og deaktiver indeksering for tabeller med lav verdi eller avskrevne tabeller. Overvåk størrelsen på DataverseSearch-tabellen, og optimaliser konfigurasjoner for å redusere logg- og databaselagring.
Revisjon og telemetriadministrasjon
- Scenario: Sporingslogger og overvåkingslogger for plugin-moduler vokser raskt, bruker lagring og påvirker ytelsen.
- Handling: Eksporter logger til eksterne systemer, for eksempel Azure Monitor, og automatiser opprydding av gamle oppføringer for å opprettholde synlighet uten oppblåst lagring.
Integrering av datalagring og analyse
- Scenario: Organisasjonen replikerer driftsdata til Azure Synapse eller OneLake for analyse, noe som fører til duplisert lagring.
- Handling: Bruk trinnvis eksport, bruk filtre og unngå fullstendig replikering av datasett for å minimere redundans samtidig som du tillater rik innsikt.
Redusere overforbruk av lagringsplass
- Scenario: En kunde mottar et varsel om overskridelse Dataverse av lagringskvoten, noe som fører til uventede kostnader.
- Handling: Bruk kapasitetsrapporter til å identifisere toppforbrukende tabeller, rydde opp i foreldede miljøer og fjerne ubrukte vedlegg eller logger. Vurder å flytte kalde data – vanligvis historiske eller sjelden brukte poster – til rimeligere lagringsnivåer.
Optimalisering av ytelse i store tabeller
- Scenario: Forretningskritiske prosesser blir tregere på grunn av store tabeller.
- Handling: Arkiver gamle poster, rydd opp i systemjobber, for eksempel AsyncOperationBase og WorkflowLogBase.
Administrasjon av miljølivssyklus
- Scenario: Utviklings- og testmiljøer klones fra produksjon, og dupliserer alle data og indekser.
- Handling: Trim sandkassemiljøer etter en oppdatering, deaktiver unødvendig søkeindeksering og fjern testdata for å redusere overflødig lagringsforbruk. Slett ubrukte sandkassemiljøer for å spare lagringsplass.
Kundehistorier
Casestudie 1: Redusere lagringsoverskudd gjennom indeksopprydding
Kundeprofil: Et globalt produksjonsfirma som bruker Dynamics 365 for forsyningskjede- og økonomi- og driftsapper.
Utfordring: Kunden opplevde uventede lagringsoverforbruk og ytelsesforringelse i produksjonsmiljøet. Undersøkelser avslørte at flere tilpassede indekser og materialiserte visninger, opprettet under tidlig implementering, ikke lenger var i bruk, men fortsatt brukte betydelig lagringsplass.
Løsning: Teamet gjennomførte en kvartalsvis revisjon av alle egendefinerte indekser og fjernet de som ikke refereres til av aktive spørringer eller rapporter. De implementerte også en styringspolicy for å gjennomgå nye indeksforespørsler før distribusjon.
Utfall:
- Redusert databaselagring med 28 %.
- Forbedret spørringsytelsen med 15 %.
- Unngikk en anslått $12,000 per år i andre lagringskostnader.
Casestudie 2: Arkivering av historiske data for å oppfylle samsvars- og ytelsesmål
Kundeprofil: Et finanstjenestefirma som bruker Dataverse Dynamics 365 for kundeinnføring og saksbehandlingsfunksjonalitet.
Utfordring: Firmaet trengte å beholde kundeposter i mer enn syv år for å oppfylle regulatoriske krav, men det økende volumet av inaktive data bremset aktive arbeidsflyter og økte lagringskostnadene.
Løsning: Kunden implementerte en langsiktig oppbevaringsstrategi ved hjelp av Dataverse arkiveringsfunksjonene. Inaktive poster ble flyttet til et skrivebeskyttet, kostnadsoptimalisert lagringsnivå, mens aktive data forble i lagring med høy ytelse.
Utfall:
- Arkiverte over 1,2 millioner poster.
- Reduserte størrelsen på primærdatabasen med 40 %.
- Opprettholdt full revisjonsevne og samsvar med oppbevaringspolicyer.
Casestudie 3: Effektivisere søkeindekser på tvers av miljøer
Kundeprofil: En detaljhandelsorganisasjon med flere Dataverse miljøer, inkludert utviklings-, test- og produksjonsmiljøer, som støtter en Copilot-aktivert løsning for kunderelasjonsadministrasjon.
Utfordring: Søkeindekser ble brukt på tvers av alle miljøer, inkludert ubrukte tabeller og testdata. Dette førte til oppblåste DataverseSearch-tabeller og unødvendig lagringsforbruk.
Løsning: Teamet gjennomgikk søkbare felt og sluttet å bruke indeksering på ikke-kritiske tabeller i utviklings- og testmiljøer. De automatiserte også indeksopprydding under miljøoppdateringer.
Utfall:
- Redusert lagring av søkeindeks med 35 %.
- Forbedrede oppdateringstider for miljøet med 20 %.
- Reduserte den totale bruken av logg- og databaselagring.
Casestudie 4: Bruk av dataeksport for analyse uten duplisering av lagring
Kundeprofil: En helsepersonell som bruker Dynamics 365 og Dataverse for pasientengasjement og fakturering.
Utfordring: Analyseteamet trengte tilgang til driftsdata for trendanalyse og AI-modellering, men duplisering av data til et eget lager økte lagringskostnadene og kompleksiteten.
Løsning: Kunden brukte Azure Synapse Link med trinnvis eksport og lagdelt lagring i OneLake. De beholdt bare viktige analytiske data og brukte oppbevaringspolicyer for å administrere historisk dybde.
Utfall:
- Aktiverte sanntidsanalyse uten å påvirke driftssystemene.
- Reduserte redundant lagring med 45 %.
- Forbedret styring over livssyklusen for analytiske data.
Konklusjon
Effektiv lagringsadministrasjon er avgjørende for å opprettholde systemytelsen og optimalisere ressursutnyttelsen i Dynamics 365-miljøer. Oppryddingsrutinene og arkiveringsjobbene som er beskrevet i denne artikkelen, gir robuste løsninger for å frigjøre verdifull databaseplass og effektivisere driften. Ved å bruke disse verktøyene som LTR og lignende teknikker, kan kunder løse vanlige lagringsutfordringer og skape bærekraftige databehandlingspraksiser. Videre demonstrerer virkelige casestudier effekten av disse tilnærmingene, og gir innsikt i deres praktiske anvendelser. Ved å ta i bruk disse strategiene kan organisasjoner proaktivt administrere lagringsbehovene sine og forbedre den generelle effektiviteten.
Referanser
Opprydding av lagring i Dataverse:
- Frigjør lagringsplass
- Rydd opp i poster fra tabellene Systemjobb (AsyncOperationBase) og Prosesslogg (WorkflowLogBase)
Lageropprydding i økonomi og drift:
- Lagringskapasitet for økonomi og drift
- Oppryddingsrutiner i Dynamics 365 Finance og Dynamics 365 Supply Chain Management
- Arkiver transaksjonsdata for kredittkort - Commerce
Lagringskapasitet: