Azure NetApp Files
Microsoft Fabric
Azure AI 搜尋服務
Microsoft Foundry
Azure Machine Learning
解決方案構想
本文說明解決方案概念。 您的雲端架構師可以使用本指南,協助視覺化此架構的一般實作的主要元件。 以本文為起點,設計符合您工作負載具體要求的完善解決方案。
此解決方案構想說明 Azure NetApp Files Object REST API 如何協助組織運用現有的企業檔案資料進行分析和 AI,而無需先將其複製到另一個物件儲存體。 Amazon S3 相容應用程式可支援文件搜尋與 AI 輔助分析,同時現有的 NFS 與 SMB 工作流程仍可存取該資料。 避免另行複製一份來源資料,可縮短分析工作負載導入所需的時間、降低重複儲存成本,並免除團隊原本必須建置、監控及進行疑難排解的同步管線。 來源資料儲存庫越少,也表示需要治理和保護的副本越少。 此方法支援漸進式現代化,無需組織替換現有的檔案式應用程式。
Architecture
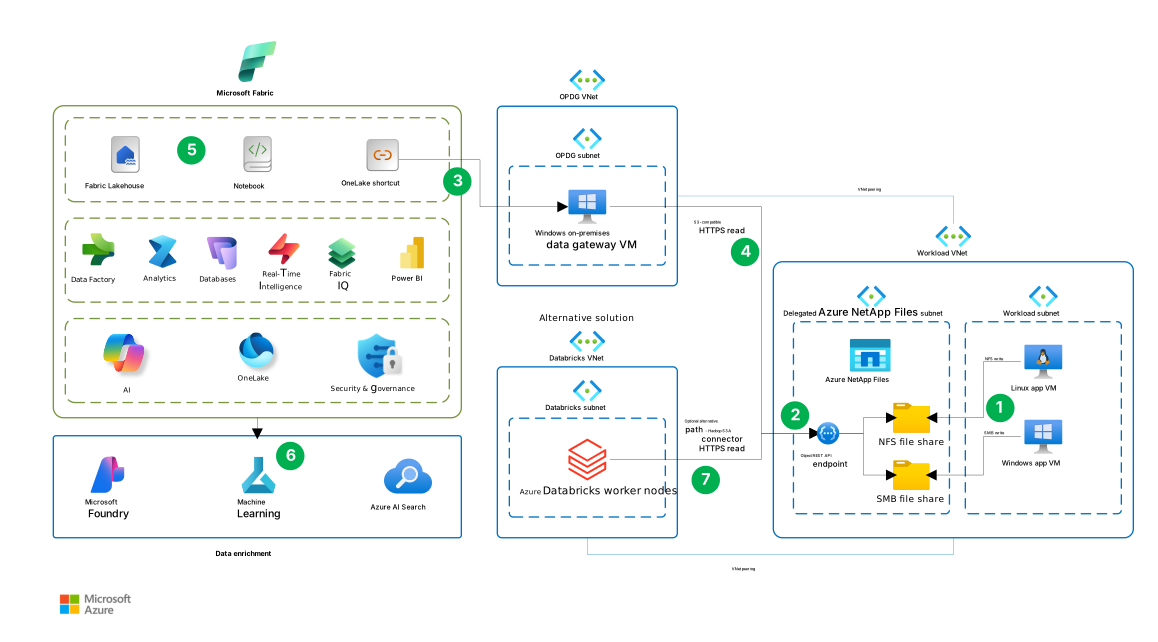
此架構著重於 Microsoft Fabric 透過 Object REST API 與 Azure NetApp Files 的整合。 圖中也顯示 Azure Databricks 作為相同 Azure NetApp Files 資料的替代分析取用端。 你不需要同時部署兩個平台。 既有應用程式仍持續透過 NFS 或 SMB 存取資料,具體方式視磁碟區組態及用戶端需求而定。
Azure Databricks 運算會使用 Hadoop S3A 連接器,透過與 S3 相容的要求來存取 Azure NetApp Files Object REST API 端點。 這個替代分析路徑不使用內部部署資料閘道或 Microsoft OneLake。
圖中的下游 AI 服務僅供示意。 他們的資料擷取整合未顯示。
下載此架構的 Visio 檔案 。
數據流
以下編號互動描述架構圖。 步驟 1 到 5 說明 Microsoft Fabric 的主要流程。 步驟 6 表示選用的下游資料增豐。 步驟 7 是替代的分析路徑,而非 Fabric 流程的延續。 標示為 HTTPS read 顯示指向物件 REST API 端點的箭頭;所請求的資料會回傳給消費者。
應用程式會寫入檔案資料。 在 Workload 子網路中,Linux 應用程式 VM 會寫入 NFS 檔案共用,而 Windows 應用程式 VM 會寫入 SMB 檔案共用。 Azure NetApp Files 在委派子網中同時托管兩個共用。
Object REST API 會提供檔案資料。 委派 ANF 子網中的端點提供對 Azure NetApp Files 磁碟區上已設定目錄的 S3 相容存取。 端點與 NFS 及 SMB 共享的連線代表對現有資料的存取,而非複製到獨立物件儲存。
Fabric 透過 OneLake 捷徑存取資料。 捷徑透過使用位於 OPDG(本地部署資料閘道)子網中的 Windows 內部部署資料閘道 VM 的連線,存取 Azure NetApp Files 資料。 OneLake捷徑連接到這個閘道。
閘道器從 Object REST API 讀取資料。 閘道器利用 OPDG VNet 與 Workload VNet 之間的對等連線來連接端點。 S3 相容的 HTTPS 讀取路徑將閘道器與端點連接,端點會存取 Fabric 參考的檔案資料。 關於連線需求,請參見 Connect OneLake to a Azure NetApp Files 卷。
Fabric 負責處理和分析這些資料。 支援的 Fabric 工作負載會透過捷徑取用資料。 例如,筆記本會讀取參考的檔案,並將衍生結果寫入湖屋資料表,用於分析與 Power BI 報告。 圖中的 Fabric 框顯示這些處理與分析能力。
可選的下游服務豐富資料。 Fabric 下方的箭頭會導向資料擴充群組,該群組包含 Microsoft Foundry、Azure Machine Learning 和 Azure AI 搜尋服務。 此步驟表示可選的後續處理流程。 圖中並未顯示連接這些服務所需的資料匯入或流程編排,而 OneLake 捷徑也不會建立這些整合。
或者,Azure Databricks 會直接讀取檔案中的資料。 Databricks 子網的工作節點使用 Hadoop S3A 連接器,透過對等虛擬網路向同一物件 REST API 端點發送 HTTPS 讀取請求。 此路徑會取代步驟 3 到 5 中的 Fabric 存取與處理路徑。 它不會經過內部部署資料閘道或 OneLake。
根據您打算如何取用資料,選擇捷徑位置:
- 現有相容的 Delta 表格。 在 lakehouse 的 Tables 區塊建立一個資料表捷徑,目標是完整的 Delta 資料表,包括其交易記錄檔。 Fabric 會將目標辨識為可透過 Spark 和 SQL 分析端點查詢的資料表,而來源資料仍保留在 Azure NetApp Files 上。
- 用於直接存取或處理的檔案。 在湖邊小屋的 檔案 區建立捷徑。 相容的工作負載除了文件之外,還可以讀取獨立存在的 Parquet、CSV 和 JSON 檔案,而無需先將來源檔案複製到 OneLake。 如果下游分析需要 Lakehouse 資料表,請在 OneLake 中將來源資料轉換為或載入至衍生 Delta 資料表。
獨立的 Parquet 檔案不會自動成為 Delta 表格。 檔案 中的捷 徑不會自動將目標登記為資料表。 欲了解更多資訊,請參閱 在 Lakehouse 中放置快捷方式的位置。
Components
以下元件支援以 Fabric 為核心的架構及可選的 Azure Databricks 替代方案。
Azure NetApp Files 是一個完全託管的檔案儲存服務,基於 NetApp 技術。 在此架構中,它儲存企業資料集,並透過 Object REST API 提供與 NFS、SMB 及 S3 相容的物件存取。 它同時提供快照與複寫功能。
Azure NetApp Files Object REST API 透過與 S3 相容的介面公開現有的檔案資料。 在此架構中,此架構可讓相容的分析與 AI 應用程式在不先建立獨立物件儲存副本的情況下存取資料。 介面支援部分 Amazon S3 操作。 在選擇此整合前,請確認 支援的操作 符合您應用程式的需求。
Microsoft Fabric 是一個整合資料流動、資料處理、資料擷取、轉換、透過 Real-Time Intelligence 的串流處理及報告建立的分析平台。 在此架構中,此架構提供分析平台,透過 OneLake 捷徑處理與分析來自 Azure NetApp Files 的資料。
OneLake 是 Fabric 的統一邏輯資料湖。 在此架構中,OneLake 捷徑可將所引用的 Azure NetApp Files 資料提供給支援的 Fabric 工作負載。
Azure 虛擬網路 在此架構中提供 Azure 資源之間的私有連接。 虛擬網路對等讓閘道虛擬機及可選的 Azure Databricks 運算能夠存取 Azure NetApp Files Object REST API 端點。
內部部署資料閘道會將 OneLake 捷徑連接到 Azure NetApp Files 貯體端點。 儘管名稱如此,在此架構中,閘道器以標準模式運行於支援 Windows 作業系統的 Azure 虛擬機上。 選擇符合 閘道安裝要求的映像檔。 Server Core 安裝和 Windows 容器不被支援。 閘道器透過 Azure 轉送 發起外撥連線,與 Fabric 通訊。 不需要從 Fabric 進行入站連線。 設定防火牆或代理伺服器,允許「調整本地資料閘道的通訊設定」中所述的對外端點。
Azure Databricks 是一個可選的替代分析平台,用於資料工程與機器學習工作負載。 其 Spark 工作使用設定為使用 Object REST API 端點的 Hadoop S3A 連接器,以存取 Azure NetApp Files 資料集,而非使用 Fabric 整合路徑。
Alternatives
此架構包含多個元件,您可以根據工作負載的功能與非功能需求,以其他 Azure 服務或方法取代。 請考慮以下替代方案及其取捨。
儲存體
在選擇 Azure Blob 儲存體 或 Azure NetApp Files 時,請考慮應用程式的協定需求與實際效能:
當用戶端可以使用 Blob 儲存體 REST API 或 NFS 3.0,且不需要 SMB 或 NFS 4.1 時,請選擇Blob 儲存體。 兩個介面都能存取相同的資料。 Blob 儲存體 NFS 3.0 存取路徑針對高吞吐量、讀取量大的連續工作負載進行優化,這類工作負載吞吐量比低延遲更重要。
當應用程式和分析工作負載需要透過 SMB 或 NFS 4.1 及相容 S3 的物件 REST API 存取相同檔案,或檔案應用程式需要低延遲隨機 I/O 時,請選擇 Azure NetApp Files。 對於已存在於 Azure NetApp Files 的資料,Object REST API 在不遷移原始應用程式或資料的情況下,新增了分析存取。
無論哪種方式,都需測量端到端延遲與吞吐量,並在來源應用程式與分析同時負載下進行。 NFS 或 SMB 效能並不能作為判定物件 REST API 或 Fabric 效能的依據,因此請根據工作負載的需求測試預期存取路徑。 比較總成本,包括應用程式變更、遷移,以及任何持續的重複與同步。 如需協定與工作負載比較,請參見「比較 Azure 儲存服務」。
Integration
Azure Databricks 作業可以使用 Hadoop S3A 連接器,透過 Object REST API 讀取 Azure NetApp Files 資料,無需 OneLake 或本地資料閘道。 設定 TLS 信任與安全儲存的認證資訊,並在依賴回寫前驗證必要的寫入操作。 如果你需要初始化腳本,請在支援的運算資源上使用存放在 Unity Catalog 卷中的叢集範圍腳本,並依照目前的 Azure Databricks 初始化指令碼指引。
案例細節
當同一資料集必須服務期望掛載檔案系統的應用程式,以及期望 S3 相容物件介面的分析或 AI 服務時,請使用此模式。
在虛擬機器或容器中執行的應用程式可以透過 NFS 或 SMB 繼續使用 Azure NetApp Files。 例如,它們可以使用現有的檔案存取程式碼、掛載的分享以及目錄結構。 Azure NetApp Files Object REST API 會將磁碟區的根目錄或子目錄對應到與 S3 相容的儲存桶,讓相容的物件用戶端能存取相同的底層檔案。
當你想為現有的檔案型工作負載加入分析或 AI 功能,而不必修改來源應用程式,使其改用物件儲存時,這種方法非常有用。 下游工作流程仍可依需求產生衍生資料,如轉換後的資料集、索引、嵌入與快取。
當檔案與物件用戶端存取相同資料時,請考慮身份、權限、鎖定及應用程式一致性要求的差異。 定義生產者如何在物件取用者處理之前,發出檔案或批次已完成的訊號。 生產者應在發出準備就緒訊號前完成撰寫並關閉檔案,並在消費者處理時保持檔案不變。 測試此交接對中斷寫入和處理重試。
身份與授權模型在不同存取方式間也有所不同。 原始的每位使用者檔案權限不會自動沿用到 Fabric。 為目標使用者設定 Fabric 權限,並確保物件 REST API 所使用的身份只能存取所需的原始資料。 如需詳細資訊,請參閱 安全性。
當消費者需要不同存取層級時,可以將目錄映射到不同的桶。 資料分類、保留、下游授權及衍生資料治理仍是工作負載的責任。 欲了解更多資訊,請參閱 建立儲存貯體。
潛在應用情境
此架構可支援需要分析已存於 Azure NetApp Files 中的結構化或非結構化資料的工作負載。 以下範例說明 Fabric 如何以不同方式消費這些資料。
文件處理
應用程式可以透過使用 NFS 或 SMB 將文件、影像或其他非結構化檔案儲存到 Azure NetApp Files。 Fabric 筆記本可透過 OneLake 捷徑讀取已完成處理的檔案,並將其內容傳送至文件處理服務(如 Azure 文件智慧)進行擷取。 將產生的結構化資料儲存在資料湖倉資料表中,以便驗證、分析及報告。
有關整合指引,請參見 透過 SynapseML 整合文件智慧。
數據分析
應用程式可以將結構化資料,如 CSV 或 Parquet 檔案,寫入 Azure NetApp Files 共享。 Fabric 筆記本可透過 OneLake 捷徑讀取已完成的檔案,與其他 lakehouse 資料合併,並將衍生結果寫入 lakehouse 表格。
此模式可支援工程與品質分析、感測器-資料分析及營運報告等情境,而無需原始應用程式改變檔案儲存方式。
對於現有相容的 Delta 資料集,請在 lakehouse 的 Tables 區建立一個 OneLake 捷徑,使其指向完整的 Delta 資料表,包括其交易記錄。 Fabric 就能將目標識別為資料表,來源資料則可保留在 Azure NetApp Files 中。 欲了解更多資訊,請參閱 Lakehouse 中如何放置快捷方式。
AI 搜尋與檢索
儲存在 Azure NetApp Files 的文件也能作為 AI 工作負載的來源內容。 例如,處理工作流程可以透過 OneLake 捷徑讀取文件,並用來建立用於檢索增強生成(RAG)的 Azure AI 搜尋服務 索引。
搜尋索引及任何嵌入皆為衍生資料,與原始檔案分開儲存。 設計工作流程,讓已建立索引的內容隨來源的更新、重新命名和刪除而保持同步。 同時在檢索已索引內容時也要執行適當的存取控制,因為原始的 SMB 和 NFS 權限不會自動變成每位使用者的搜尋權限。
同樣的模式也可以延伸到其他 AI 工作負載。 例如,Fabric 筆記本可以從原始檔案準備資料集,並將這些資料儲存在 OneLake 中,供 Azure Machine Learning 使用。 關於整合選項與限制,請參見「整合 OneLake 與 Azure Machine Learning」。
Considerations
這些考量實現了 Azure Well-Architected 框架的支柱,這是一套指導原則,用以提升工作負載的品質。 如需詳細資訊,請參閱 Well-Architected Framework。 如需進一步指引,請參閱 適用於 Azure NetApp Files 的 Well-Architected Framework 建議。
Reliability
可靠性有助於確保您的應用程式可以符合您對客戶的承諾。 欲了解更多資訊,請參閱 可靠性設計審查清單。
Azure NetApp Files 運行於由 ONTAP 驅動的容錯裸機機群,並提供 高可用性 SLA。 為了加強對可用區或區域故障的防護,您可以選擇設定跨可用區或跨區域複寫。 此複寫為非同步,需由客戶主動容錯移轉至目的磁碟區。 選擇複製選項,並依照你工作負載的復原目標來排程。 欲了解更多資訊,請參閱 Azure NetApp Files 可靠性。
共用一個資料集也使得儲存可用性成為檔案應用和分析的共同相依因素。 這些儲存能力並未建立閘道器、索引管線或取用應用程式的端對端可用性。 將復原目標與整個工作負載(包括閘道器、下游處理及衍生資料)對齊。
單一閘道虛擬機是 Fabric 整合路徑的單一故障點。 對於業務關鍵工作負載,至少將兩個閘道成員部署在不同的虛擬機器上,並組成 閘道叢集。 確保每個成員都能存取 Object REST API 端點,並建立所需的對外連線。 測試當閘道成員無法使用時,工作負載的行為。
- 透過節省空間的時間點快照支援檔案與磁碟區的恢復。 團隊可以還原單一檔案、將整個磁碟區還原,或在意外刪除、資料損毀或分析程序失敗後,從復原點建立新的磁碟區。 關於可用的復原操作,請參見 Azure NetApp Files 快照式資料保護。
安全性
安全性可提供針對蓄意攻擊和濫用寶貴數據和系統的保證。 欲了解更多資訊,請參閱 安全性設計審查清單。
維持較少的原始資料副本可以減少需要保護的儲存庫數量。 Azure NetApp Files 會對靜態資料進行加密,而 Object REST API 則使用 TLS 來保護傳輸中的資料。 檔案存取權限依所使用的協定而定:
SMB 與 NFS 用戶端持續使用其現有的認證與授權模型。 現有的 NTFS 存取控制清單(ACL)、NFS 權限及身分對應規則對這些用戶端仍然有效。
物件 REST API 用戶端透過使用 S3 存取金鑰進行身分驗證。 桶權限定義了用戶端在映射目錄中是否擁有唯讀或可讀寫存取權限。 物件請求不包含個別 SMB、NFS 或下游使用者的身份。 Azure NetApp Files 會以儲存貯體中設定的模擬檔案系統身分執行所有物件操作。 現有的檔案權限和 ACL 只會依據該身分進行評估。
模擬的檔案系統身分是 NFS 磁碟區的使用者 ID(UID)與群組 ID(GID),而 SMB 磁碟區則是使用者帳號。 雙協定卷會使用與其所設定安全性樣式相符的身分識別類型。 此身份決定檔案存取權限。 S3 存取金鑰用於驗證物件客戶端的身分。 欲了解更多資訊,請參閱物件 REST API 安全性與權限。
OneLake S3 相容的捷徑透過存取金鑰 ID 和秘密存取金鑰來驗證儲存桶。 來源 NTFS ACL、NFS 權限及個別檔案擁有者身份不會被複製或映射到 OneLake。 Fabric 使用者可透過 OneLake 與 Fabric 權限獲得授權。 他們只能透過儲存貯體及其冒充身分,存取經由 Shortcut/捷徑公開的內容,但 OneLake 並不強制執行原始的每位使用者檔案權限。 基於 Microsoft Entra 的 OAuth、服務主體帳戶和 RoleArn 不支援這種捷徑類型。
例如,如果 Fabric 權限允許存取,且貯體所模擬的身分可讀取該文件,Fabric 使用者即使其個人 SMB 帳戶無法直接讀取該文件,也可能仍可透過捷徑讀取該文件。 在開放目錄存取前,請確認目標 Fabric 受眾已被授權存取其內容。
設定 bucket 的模擬身分,僅保留工作負載所需的來源權限。 限制捷徑方式和 Lakehouse 的存取權限。 使用 以 Azure Key Vault 為基礎的憑證工作流程與認證資訊儲存來管理 TLS 憑證和 S3 存取金鑰。 定義並測試一個輪替程序,協調憑證與認證資料的變更,以及對 Fabric 連線及其他取用端的更新。 產生新的儲存貯體憑證會立即使現有的憑證組合失效,因此在更新用戶端並驗證輪替後的存取權時,請做好中斷準備。
如果你使用自簽 TLS 憑證,請確保每個閘道主機都信任它。 欲了解更多資訊,請參閱 OneLake 閘道必要條件。
安全性與合規性取決於儲存、存取及下游服務的配置。 將下游處理及衍生資料納入治理與合規範疇。 GDPR和HIPAA等要求適用於整個工作負載(如適用)。 欲了解更多資訊,請參閱 物件 REST API 安全性與權限 ,以及 在 OneLake 中建立與 Amazon S3 相容的捷徑。
成本優化
成本優化著重於減少不必要的費用,並提升營運效率的方式。 欲了解更多資訊,請參閱成本優化設計審查清單。
避免獨立的原始資料複製,可以降低重複儲存與同步成本。 將這些節省與 Azure NetApp Files 的容量與效能成本、閘道運算、Fabric 容量,以及下游處理與儲存進行平衡。
此範例價格預估包含一個 1-TiB Azure NetApp Files 標準容量池、一台用於本地資料閘道的 Windows D8s_v5 虛擬機、兩顆 128 GiB 的 P10 管理硬碟、一個具有公用 IP 位址及輸出資料處理功能的 NAT 閘道、Fabric F2 容量,以及 100 GB 的原生 OneLake 儲存體。
單一閘道配置不具高可用性。 可選的 AI 搜尋、嵌入服務及 Azure Databricks 費用不包含在內。 根據工作負載的容量、網路和可用性需求調整資源。
冷層存取: 將非作用中資料區塊(包括快照資料)分層至較低成本的儲存體,同時保留檔案與物件存取權。 評估擷取費用、延遲及服務層級特定吞吐量變化,並對照工作負載的存取模式評估。
服務水準與適宜規模:選擇符合資料集容量與吞吐量需求的 Azure NetApp Files 服務等級。 彈性服務層級允許你獨立配置池容量與吞吐量。 隨著需求變化檢視可計費池容量與吞吐量,以避免持續過度配置。
卓越營運
卓越營運管理涵蓋部署應用程式的過程,並確保其在生產環境中持續運行。 欲了解更多資訊,請參閱營運卓越的設計審核清單。
OneLake 捷徑透過避免使用維護供分析使用的獨立原始資料副本的管線,來降低營運複雜度。 不需要另外設置獨立的複製管線,團隊也就無須排定複製作業、處理傳輸失敗後的復原作業,或在例行作業中比對來源資料與複製後的資料。
原始碼-應用程式與分析團隊必須協調共享 Azure NetApp Files 資料集的變更與事件回應。 明確指派監控、失敗處理,以及 物件 REST API 的認證資訊與憑證管理的責任歸屬。
監控儲存、閘道及 Fabric 效能,以識別限制並調整容量或吞吐量:
使用 Azure 監視器 追蹤磁碟區的讀寫吞吐量、讀寫 IOPS、其他 IOPS、平均讀寫延遲、容量消耗,以及已達到吞吐量限制指標。 針對持續延遲增加、重複的 QoS 限制及容量閾值發出警示,而非僅針對個別尖峰;Azure NetApp Files 的指標會以不同區間彙整,且儲存延遲並不包含所有用戶端 REST 元件。
將儲存指標與用戶端量測值建立關聯,例如請求延遲百分位數、物件大小、並行性、重試次數、HTTP 狀態碼、CPU、記憶體及網路吞吐量。 這樣做可將磁碟吞吐量限制與運算客戶端容量不足、SDK 設定效率低落、小型物件開銷或網路距離區分開來。
監控每個閘道虛擬機器的 CPU、記憶體、可用磁碟空間和網路吞吐量,以及閘道錯誤與工作負載完成時間。 根據代表性工作負載測試中設定的閾值,針對持續的資源壓力與低磁碟空間設定警示。 在排除錯誤或存取緩慢時 ,請使用閘道診斷日誌 。 請分別監控虛擬機器和網路,因為閘道診斷無法提供完整的基礎設施涵蓋範圍。
使用 Fabric 容量計量應用程式監控 Fabric 容量使用率和節流情況。 為負責的管理員設定 容量使用通知 。 將容量使用量與閘道器及儲存測量相關聯,以判斷延遲源自來源資料存取還是 Fabric 處理,然後才改變容量。
效能效率
效能效率是指工作負載能夠有效率地調整以符合使用者需求。 有關詳細資訊,請參閱效能效率的設計審核清單。
Azure NetApp Files 可同時支援對延遲敏感的 NFS 或 SMB 應用程式,以及使用相同資料集的、與 S3 相容的分析或 AI 取用端。 將來源資料保留在同一磁碟區中,可省去原本會延遲索引、訓練或批次處理,並耗用用戶端、網路及目的端儲存體頻寬的複製階段。
支援的 Azure NetApp Files 服務層級的亞毫秒儲存延遲,與 NFS 和 SMB 工作負載最為直接相關。 它並不保證 HTTPS 物件 REST API 請求的端對端延遲。 在設定延遲目標前,先以代表性物件與並行性來基準測試 S3 相容的存取路徑。
儲存容量: 請根據檔案應用程式與物件取用者的合併需求來規劃吞吐量。 自動服務品質(QoS)將磁碟區吞吐量與磁碟區配額綁定。 手動 QoS 允許在池的吞吐量預算中進行獨立配置. 在調整效能前,先先對代表性工作負載做基準測試。
閘道大小調整:請根據透過 OneLake 捷徑存取 Azure NetApp Files 的工作負載所產生的總體需求,調整閘道虛擬機器的大小。 先以 閘道規模調整與擴展指引 作為起點。 使用具代表性的資料量,並透過快捷方式進行並行存取,以驗證容量規劃。 衡量閘道的 CPU、記憶體和網路吞吐量,以及工作負載完成時間,以判斷是否應增加虛擬機器資源或加入閘道成員。
Fabric 容量大小:為合併的處理與報告工作負載(包括 Power BI)規劃 Fabric 容量大小。 請依照 Fabric 容量規劃指南中的指引估算初始容量,使用具代表性的試點進行測試,並根據實際測得的使用率與節流情況調整容量。
將運算資源部署在靠近磁碟區的位置,適當規劃用戶端網路容量,並使用實際工作負載進行測試。 提高平行度,並針對循序分析使用足夠大的請求,但當延遲或錯誤增加時,應限制並行度上限。 對於 NFS 或 SMB,請驗證掛載、協定及應用程式設定。 針對 REST,請確認是否支援用戶端所需的 API 作業,並測試連線重複使用、上傳行為、重試機制及物件列舉。
在同時負載下驗證端對端吞吐量與延遲,並在分析需求與來源應用效能需求間取得平衡。
Contributors
本文由 Microsoft 維護。 以下貢獻者撰寫了這篇文章。
主要作者:
其他貢獻者:
- 希瑟·格蘭迪 |資深解決方案工程師,Microsoft 資料平台
若要查看非公開的 LinkedIn 個人檔案,請登入 LinkedIn。
下一步
- Azure NetApp Files 的物件 REST API 簡介
- 將 OneLake 連線至 Azure NetApp Files 磁碟區
- Azure Databricks 中的初始化指令碼
- 將 OneLake 與 Azure Machine Learning 整合